

Bonjour à tous ! Je suis développeur backend, je crée des microservices en Java + Spring. Je travaille dans une des équipes de développement de produits internes chez Tinkoff.
Dans notre équipe, la question de l'optimisation des requêtes dans les SGBD se pose souvent. On souhaite toujours un peu plus de rapidité, mais il n'est pas toujours possible de se contenter d'indices bien construits — il faut parfois chercher des solutions alternatives. Lors de l'une de mes explorations sur le web à la recherche d'optimisations raisonnables pour travailler avec des bases de données, j'ai trouvé , auteur du livre SQL Performance Explained. C'est le genre de blog rare où l'on peut lire tous les articles à la suite.
Je souhaite traduire pour vous un petit article de Markus. On peut l'appeler dans une certaine mesure un manifeste, qui vise à attirer l'attention sur un problème ancien, mais toujours d'actualité, concernant la performance des opérations offset selon la norme SQL.
Dans certains endroits, je compléterai l'auteur avec des explications et des remarques. Tous ces endroits seront marqués comme « remarque » pour plus de clarté.
Introduction rapide
Je pense que beaucoup savent à quel point il peut être problématique et lent de travailler avec des sélections paginées via offset. Mais saviez-vous qu'il est assez simple de le remplacer par une construction plus performante ?
Ainsi, le mot clé offset indique à la base de données de passer les n premières entrées dans la requête. Cependant, la base doit toujours lire ces n premières entrées sur le disque, et ce dans l'ordre spécifié (remarque : appliquer le tri si défini), et seulement après cela, il sera possible de retourner les entrées à partir de n + 1 et au-delà. Ce qui est intéressant, c'est que le problème ne réside pas dans la mise en œuvre spécifique du SGBD, mais dans la définition initiale selon la norme :
…les lignes sont d'abord triées selon la <clause order by> puis limitées en abandonnant le nombre de lignes spécifié dans la <clause result offset> depuis le début…
-SQL:2016, Partie 2, 4.15.3 Tables dérivées (remarque : actuellement la norme la plus utilisée)
Le point clé ici est que l'offset prend un seul paramètre — le nombre d'enregistrements à ignorer, et c'est tout. En suivant cette définition, le SGBD ne peut que récupérer tous les enregistrements, puis abandonner les inutiles. Évidemment, une telle définition de l'offset oblige à effectuer un travail supplémentaire. Et il n'est même pas important qu'il s'agisse de SQL ou de NoSQL.
Encore un peu de douleur
Les problèmes d'offset ne s'arrêtent pas là, et voilà pourquoi. Si une nouvelle entrée est insérée entre la lecture de deux pages de données à partir du disque, que se passe-t-il dans ce cas ?
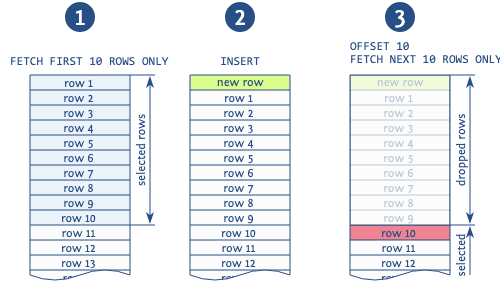
Lorsque l'offset est utilisé pour sauter des enregistrements des pages précédentes, dans le cas d'une insertion d'un nouvel enregistrement entre les opérations de lecture de pages différentes, vous obtiendrez très probablement des doublons (note : cela est possible lorsque nous lisons page par page en utilisant la clause order by, alors un nouvel enregistrement peut entrer en milieu de notre résultat).
L'illustration montre clairement cette situation. La base lit les 10 premiers enregistrements, après quoi un nouvel enregistrement est inséré, décalant tous les enregistrements lus d'un chiffre. Ensuite, la base récupère une nouvelle page des 10 enregistrements suivants et commence non pas à la 11e, comme elle le devrait, mais à la 10e, dupliquant cet enregistrement. Il existe d'autres anomalies liées à l'utilisation de cette expression, mais celle-ci est la plus courante.
Comme nous l'avons déjà déterminé, ce n'est pas un problème d'un SGBD spécifique ou de ses implémentations. Le problème réside dans la définition de la pagination selon le standard SQL. Nous disons au SGBD quelle page récupérer ou combien d'enregistrements ignorer. La base ne peut tout simplement pas optimiser cette requête, car il n'y a pas assez d'informations à ce sujet.
Il convient également de préciser que ce n'est pas un problème lié à un mot-clé spécifique, mais plutôt à la sémantique de la requête. Il existe encore plusieurs syntaxes identiques en termes de problème :
- Le mot-clé offset, comme mentionné précédemment.
- La construction composée de deux mots-clés limit [offset] (bien que limit en soi ne soit pas si mauvais).
- Filtrage par les bornes inférieures, basé sur la numérotation des lignes (par exemple, row_number(), rownum, etc.).
Toutes ces expressions disent simplement combien de lignes doivent être ignorées, sans aucune information ou contexte supplémentaire.
Plus loin dans cet article, le mot-clé offset est utilisé comme une généralisation de toutes ces variantes.
Une vie sans OFFSET
Imaginez maintenant à quoi ressemblerait notre monde sans tous ces problèmes. Il s'avère que vivre sans offset n'est pas si compliqué : nous pouvons sélectionner uniquement les lignes que nous n'avons pas encore vues (note : c'est-à-dire celles qui n'étaient pas sur la page précédente), en utilisant une condition dans le where.
Dans ce cas, nous partons du fait que les sélections sont exécutées sur un ensemble ordonné (le bon vieux order by). Étant donné que nous avons un ensemble ordonné, nous pouvons utiliser un filtre assez simple pour ne récupérer que les données qui se trouvent après le dernier enregistrement de la page précédente :
    SELECT ...
    FROM ...
    WHERE ...
    AND id < ?last_seen_id
    ORDER BY id DESC
    FETCH FIRST 10 ROWS ONLY
Et voilà le principe de cette approche. Bien sûr, lorsque vous triez par plusieurs colonnes, cela devient plus intéressant, mais l'idée reste la même. Il est important de noter que cette construction est applicable dans de nombreux -solutions.
Cette approche s'appelle la méthode seek ou pagination par jeu de clés. Elle résout le problème des résultats flottants (note : la situation avec les enregistrements entre les lectures de pages, décrite précédemment) et, bien sûr, ce que nous aimons tous, elle fonctionne plus rapidement et de manière plus stable que l'offset classique. La stabilité réside dans le fait que le temps de traitement de la requête n'augmente pas proportionnellement au numéro de la table demandée (note : si vous souhaitez en savoir plus sur le fonctionnement des différentes approches de pagination, vous pouvez . Vous y trouverez également des benchmarks comparatifs sur les différentes méthodes).
Une des diapositives , la pagination par clés n'est bien sûr pas omnipotente — elle a ses limites. La plus significative est qu'elle n'a pas la capacité de lire des pages aléatoires (note : non séquentiellement). Cependant, à l'ère du défilement infini (note : sur le front-end), ce n'est pas un si gros problème. Indiquer le numéro de page pour un clic est de toute façon une mauvaise solution lors de la conception de l'UI (note : c'est l'avis de l'auteur de l'article).
Et qu'en est-il des outils ?
La pagination par clés ne convient souvent pas en raison d'un manque de soutien instrumental pour cette méthode. La plupart des outils de développement, y compris divers frameworks, ne permettent pas de choisir la méthode de pagination qui sera utilisée.
La situation est aggravée par le fait que la méthode décrite nécessite un soutien continu dans les technologies utilisées — allant de la base de données à l'exécution des requêtes AJAX dans le navigateur lors du défilement infini. Au lieu d'indiquer uniquement le numéro de page, il faudra maintenant spécifier un ensemble de clés pour toutes les pages à la fois.
Cependant, le nombre de frameworks prenant en charge la pagination par clés augmente progressivement. Voici ce qui existe à ce jour :
- pour Java ;
- pour Ruby ;
- et pour Django ;
- pour Python ;
- — API de critères pour les implémentations JPA ;
- pour Perl ;
- , мапер для Node.js .
(Remarque : certains liens ont été retirés car, au moment de la traduction, certaines bibliothèques n'avaient pas été mises à jour depuis 2017—2018. Si cela vous intéresse, vous pouvez consulter la source.)
C'est précisément à ce stade que votre aide est nécessaire. Si vous développez ou maintenez un framework qui utilise d'une manière ou d'une autre la pagination, je vous demande, je vous implore de fournir un support natif pour la pagination par clés. Si vous avez des questions ou avez besoin d'aide, je serais ravi de vous aider (, , ) (remarque : d'après mon expérience avec Markus, je peux dire qu'il est vraiment enthousiaste à l'idée de promouvoir ce sujet).
Si vous utilisez des solutions prêtes à l'emploi qui, selon vous, méritent un support de pagination par clés, n'hésitez pas à créer une demande ou même à proposer une solution prête à l'emploi, si possible. Vous pouvez également faire référence à cet article dans le lien.
Conclusion
La raison pour laquelle un approche aussi simple et utile que la pagination par clés est peu répandue n'est pas qu'elle est difficile à mettre en œuvre techniquement ou nécessite des efforts considérables. La principale raison est que beaucoup de gens sont habitués à voir et à travailler avec l'offset — cette approche est dictée par la norme elle-même.
En conséquence, peu de personnes envisagent de changer leur approche de la pagination, ce qui rend également le soutien par les frameworks et bibliothèques peu développés. Donc, si vous êtes en phase avec l'idée et l'objectif de la pagination sans offset, aidez à la promouvoir !
Source :
Auteur : Markus Winand
Source : habr.com
