

Bonjour Habr ! Je vous présente la traduction de l'article des auteurs Burak Yavuz, Brenner Heintz et Denny Lee, préparé en vue du lancement du cours d'OTUS.
Les données, tout comme notre expérience, s'accumulent et se développent constamment. Pour ne pas rester en arrière, nos modèles mentaux du monde doivent s'adapter aux nouvelles données, certaines d'entre elles contenant de nouvelles dimensions - de nouvelles façons d'observer des choses dont nous n'avions pas auparavant connaissance. Ces modèles mentaux ne diffèrent guère des schémas de tables qui définissent comment nous classifions et traitons les nouvelles informations.
Cela nous amène à la question de la gestion des schémas. À mesure que les besoins et les exigences des entreprises évoluent avec le temps, la structure de vos données change également. Delta Lake permet d'introduire facilement de nouvelles dimensions lors de la modification des données. Les utilisateurs ont accès à une sémantique simple pour gérer les schémas de leurs tables. Ces outils incluent l'application forcée des schémas (Schema Enforcement), qui protège les utilisateurs d'une contamination accidentelle de leurs tables par des erreurs ou des données inutiles, ainsi que l'évolution des schémas (Schema Evolution), qui permet d'ajouter automatiquement de nouvelles colonnes avec des données précieuses aux emplacements appropriés. Dans cet article, nous allons approfondir l'utilisation de ces outils.
Compréhension des schémas de table
Chaque DataFrame dans Apache Spark contient un schéma qui définit la forme des données, tels que les types de données, les colonnes et les métadonnées. Avec Delta Lake, le schéma de la table est conservé au format JSON dans le journal des transactions.
Qu'est-ce que l'application forcée des schémas ?
L'application forcée des schémas (Schema Enforcement), également connue sous le nom de validation des schémas (Schema Validation), est un mécanisme de protection dans Delta Lake qui garantit la qualité des données en rejetant les enregistrements qui ne correspondent pas au schéma de la table. Tout comme une hôtesse à la réception d'un restaurant populaire qui n'accepte que les réservations, elle vérifie si chaque colonne de données saisie dans la table figure sur la liste des colonnes attendues (en d'autres termes, si chacune d'elles a une « réservation »), et rejette tous les enregistrements avec des colonnes qui ne figurent pas sur cette liste.
Comment fonctionne l'application forcée des schémas ?
Delta Lake utilise un contrôle de schéma lors de l'écriture, ce qui signifie que toutes les nouvelles entrées dans la table sont vérifiées pour leur compatibilité avec le schéma de la table cible au moment de l'écriture. Si le schéma n'est pas compatible, Delta Lake annule complètement la transaction (les données ne sont pas écrites) et génère une exception pour informer l'utilisateur de l'incompatibilité.
Pour déterminer la compatibilité d'une entrée avec la table, Delta Lake utilise les règles suivantes. DataFrame à écrire :
- ne peut pas contenir des colonnes supplémentaires qui ne figurent pas dans le schéma de la table cible. En revanche, il est acceptable que les données entrantes ne contiennent pas toutes les colonnes de la table — ces colonnes se verront simplement attribuer des valeurs nulles.
- ne peut pas avoir des types de données de colonnes qui diffèrent de ceux des colonnes de la table cible. Si une colonne de la table cible contient des données de type StringType, mais que la colonne correspondante dans le DataFrame contient des données de type IntegerType, l'application forcée du schéma générera une exception et empêchera l'opération d'écriture.
- ne peut pas contenir des noms de colonnes qui ne diffèrent que par la casse. Cela signifie que vous ne pouvez pas avoir des colonnes nommées ‘Foo’ et ‘foo’ définies dans une même table. Bien que Spark puisse fonctionner en mode sensible ou non sensible à la casse (par défaut) pour les noms, Delta Lake conserve la casse, mais est insensible lors du stockage du schéma. Parquet est sensible à la casse lors de la stockage et de la récupération de l'information des colonnes. Pour éviter d'éventuelles erreurs, des corruptions de données ou des pertes de données (ce dont nous avons personnellement été témoins chez Databricks), nous avons décidé d'ajouter cette restriction.
Pour illustrer cela, examinons ce qui se passe dans le code ci-dessous lorsque nous tentons d'ajouter certaines colonnes nouvellement générées à une table Delta Lake qui n'est pas encore configurée pour les accepter.
# Сгенерируем DataFrame ссуд, который мы добавим в нашу таблицу Delta Lake
loans = sql("""
            SELECT addr_state, CAST(rand(10)*count as bigint) AS count,
            CAST(rand(10) * 10000 * count AS double) AS amount
            FROM loan_by_state_delta
            """)

# Вывести исходную схему DataFrame
original_loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)

# Вывести новую схему DataFrame
loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)
  |-- amount: double (nullable = true) # new column

# Попытка добавить новый DataFrame (с новым столбцом) в существующую таблицу
loans.write.format("delta")
           .mode("append")
           .save(DELTALAKE_PATH)

Returns:

A schema mismatch detected when writing to the Delta table.

To enable schema migration, please set:
'.option("mergeSchema", "true")'

Table schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)

Data schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)
-- amount: double (nullable = true)

If Table ACLs are enabled, these options will be ignored. Please use the ALTER TABLE command for changing the schema.
Au lieu d'ajouter automatiquement de nouvelles colonnes, Delta Lake impose le schéma et arrête l'écriture. Pour aider à identifier quelle colonne (ou lesquelles) sont à l'origine de l'incompatibilité, Spark affiche les deux schémas de la trace de pile pour comparaison.
Quel est l'avantage d'une application de schéma forcée ?
Puisque l'application stricte du schéma représente un contrôle rigoureux, elle constitue un excellent outil pour servir de passerelle à un ensemble de données propre, entièrement transformé, prêt pour la production ou la consommation. En général, elle s'applique aux tables qui fournissent directement des données :
- Aux algorithmes d'apprentissage automatique
- Aux tableaux de bord BI
- À l'analyse des données et aux outils de visualisation
- À tout système de production nécessitant des schémas sémantiques strictement structurés et typés.
Pour préparer vos données à cette barrière finale, de nombreux utilisateurs adoptent une architecture simple de « multi-hop » qui apporte progressivement de la structure à leurs tables. Pour en savoir plus à ce sujet, vous pouvez consulter l'article
Évidemment, l'application stricte du schéma peut être utilisée à n'importe quel endroit de votre pipeline, mais gardez à l'esprit que l'écriture en continu dans une table peut être frustrante, par exemple, si vous oubliez que vous avez ajouté une colonne supplémentaire dans les données d'entrée.
Prévention de l'éclatement des données
À ce stade, vous pourriez vous demander pourquoi un tel engouement ? Après tout, parfois une erreur inattendue de « non-conformité du schéma » peut vous faire trébucher dans votre flux de travail, surtout si vous êtes novice avec Delta Lake. Pourquoi ne pas simplement laisser le schéma évoluer comme il faut pour que je puisse enregistrer mon DataFrame, quoi qu'il arrive ?
Comme le dit un vieux dicton, « une once de prévention vaut une livre de guérison ». À un certain moment, si vous ne vous occupez pas d'appliquer votre schéma, des problèmes de compatibilité des types de données pointeront leur vilain nez — des sources de données brutes apparemment homogènes peuvent contenir des cas limites, des colonnes corrompues, des mappings mal formés ou d'autres horreurs qui hantent vos cauchemars. La meilleure approche consiste à arrêter ces ennemis aux portes — grâce à l'application stricte du schéma — et à les affronter à la lumière, plutôt que plus tard, lorsqu'ils commenceront à rôder dans les profondeurs obscures de votre code de travail.
L'application forcée du schéma assure que la structure de votre table ne changera pas, sauf si vous validez vous-même un changement. Cela prévient la « dilution » des données, qui peut se produire lorsque de nouvelles colonnes sont ajoutées si souvent que des tables auparavant précieuses et compactes perdent leur signification et leur utilité à cause d'un excès de données. En vous encourageant à être intentionnel, à établir des normes élevées et à attendre une grande qualité, l'application forcée du schéma remplit exactement son rôle - vous aider à rester honnête et à garder vos tables nettes.
Si, après un examen approfondi, vous décidez que vous souhaitez réellement doit ajouter une nouvelle colonne, pas de problème, voici un correctif en une ligne. La solution est l'évolution du schéma !
Qu'est-ce que l'évolution du schéma ?
L'évolution du schéma est une fonctionnalité qui permet aux utilisateurs de modifier facilement la structure actuelle d'une table en fonction des données qui changent au fil du temps. Elle est le plus souvent utilisée lors de l'ajout ou de la réécriture d'opérations pour adapter automatiquement le schéma à l'inclusion d'une ou plusieurs nouvelles colonnes.
Comment fonctionne l'évolution du schéma ?
En suivant l'exemple de la section précédente, les développeurs peuvent facilement utiliser l'évolution du schéma pour ajouter de nouvelles colonnes qui ont été préalablement rejetées en raison d'un non-respect du schéma. L'évolution du schéma est activée en ajoutant .option('mergeSchema', 'true') à votre commande Spark .write ou .writeStream.
# Добавьте параметр mergeSchema
loans.write.format("delta")
           .option("mergeSchema", "true")
           .mode("append")
           .save(DELTALAKE_SILVER_PATH)
Pour voir le diagramme, exécutez la requête SQL Spark suivante
# Создайте график с новым столбцом, чтобы подтвердить, что запись прошла успешно
%sql
SELECT addr_state, sum(`amount`) AS amount
FROM loan_by_state_delta
GROUP BY addr_state
ORDER BY sum(`amount`)
DESC LIMIT 10 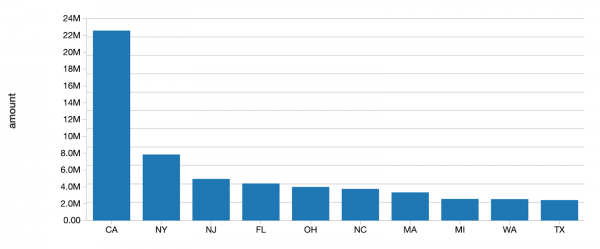
Alternativement, vous pouvez définir cette option pour toute la session Spark en ajoutant spark.databricks.delta.schema.autoMerge = True dans la configuration Spark. Mais utilisez-le avec précaution, car l'application forcée du schéma ne vous avertira plus des incohérences involontaires avec le schéma.
En ajoutant le paramètre à la requête mergeSchema, toutes les colonnes présentes dans le DataFrame mais absentes de la table cible sont automatiquement ajoutées à la fin du schéma dans le cadre de la transaction d'écriture. Des champs imbriqués peuvent également être ajoutés, et ils seront également ajoutés à la fin des colonnes correspondantes de la structure.
Les ingénieurs et les scientifiques peuvent utiliser cette option pour ajouter de nouvelles colonnes (peut-être une métrique récemment suivie ou une colonne des ventes de ce mois-ci) à leurs tableaux de production en apprentissage automatique existants, sans perturber les modèles existants basés sur les anciennes colonnes.
Les types de modifications de schéma suivants sont autorisés dans le cadre de l'évolution du schéma lors de l'ajout ou de la réécriture d'une table :
- Ajout de nouvelles colonnes (c'est le scénario le plus courant)
- Changement de types de données de NullType -> tout autre type ou élévation de ByteType -> ShortType -> IntegerType
D'autres modifications non autorisées dans le cadre de l'évolution du schéma nécessitent que le schéma et les données soient réécrits en ajoutant .option("overwriteSchema", "true"). Par exemple, dans le cas où la colonne « Foo » était initialement un entier, et que le nouveau schéma serait d'un type de données chaîne, alors tous les fichiers Parquet (données) devraient être réécrits. Ces modifications comprennent :
- la suppression d'une colonne
- le changement de type de données d'une colonne existante (sur place)
- le renommage des colonnes qui ne diffèrent que par leur casse (par exemple, « Foo » et « foo »)
Enfin, avec la prochaine version de Spark 3.0, le DDL explicite (en utilisant ALTER TABLE) sera entièrement supporté, permettant aux utilisateurs d'effectuer les opérations suivantes sur les schémas de table :
- ajout de colonnes
- changement de commentaires sur les colonnes
- configuration des propriétés de la table définissant le comportement de la table, par exemple, la définition de la durée de conservation du journal des transactions.
Quel est l'avantage de l'évolution du schéma ?
L'évolution du schéma peut être utilisée chaque fois que vous prévoyez modifier le schéma de votre table (contrairement aux cas où vous avez accidentellement ajouté des colonnes à votre DataFrame qui ne devraient pas y être). C'est le moyen le plus simple de migrer votre schéma, car il ajoute automatiquement les bons noms de colonnes et types de données sans besoin de les déclarer explicitement.
Conclusion
L'application forcée du schéma rejette toute nouvelle colonne ou autre modification de schéma qui n'est pas compatible avec votre table. En établissant et en maintenant ces normes élevées, les analystes et les ingénieurs peuvent s'appuyer sur le fait que leurs données ont un niveau d'intégrité exceptionnel, leur permettant de réfléchir clairement et de prendre des décisions commerciales plus efficaces.
D'un autre côté, l'évolution du schéma complète l'application forcée, simplifiant les modifications automatiques du schéma. En fin de compte, cela ne doit pas être compliqué — ajouter une colonne.
L'application forcée du schéma est le yang, tandis que l'évolution du schéma est le yin. Lorsqu'elles sont utilisées ensemble, ces fonctionnalités simplifient plus que jamais la suppression du bruit et l'ajustement du signal.
Nous tenons également à remercier Mukul Murti et Pranav Anand pour leur contribution à cet article.
D'autres articles de cette série :
Articles connexes
Source : habr.com
