

TL;DR : Il y a quatre ans, j'ai quitté Google avec l'idée d'un nouvel outil pour la surveillance des serveurs. L'idée était de réunir en un seul service des fonctionnalités généralement isolées. et d'analyse des journaux, de collecte de métriques, et d'un tableau de bord. Un des principes est que le service doit être véritablement rapide, permettant aux DevOps de travailler facilement, de manière interactive et agréable. Cela nécessite le traitement d'ensembles de données de plusieurs gigaoctets en une fraction de seconde, sans dépasser le budget. Les outils existants pour travailler avec les journaux sont souvent lents et maladroits, c'est donc un bon défi : concevoir un outil pour offrir aux utilisateurs une nouvelle expérience.
Cet article décrit comment nous, chez Scalyr, avons résolu ce problème en appliquant des méthodes de l'ancienne école, une approche de force brute, éliminant les couches inutiles et évitant les structures de données complexes. Ces leçons peuvent être appliquées à vos propres défis d'ingénierie.
La force de l'ancienne école
L'analyse des journaux commence généralement par la recherche : trouver tous les messages correspondant à un certain modèle. Chez Scalyr, cela représente des dizaines ou des centaines de gigaoctets de journaux provenant de plusieurs serveurs. Les approches modernes impliquent généralement la construction d'une structure de données complexe optimisée pour la recherche. Bien sûr, j'ai vu cela chez Google, où ils sont plutôt bons dans ce domaine. Mais nous avons opté pour une approche beaucoup plus brute : le balayage linéaire des journaux. Et cela a fonctionné - nous fournissons une interface de recherche nettement plus rapide que celle de nos concurrents (voir l'animation à la fin).
La clé de cette découverte a été de réaliser que les processeurs modernes sont en réalité très rapides pour des opérations simples et directes. Il est facile de l'oublier dans des systèmes complexes et multilayers, qui dépendent de la vitesse I/O et des opérations réseau, et ces systèmes sont aujourd'hui très répandus. Ainsi, nous avons conçu un design qui minimise le nombre de couches et de déchets inutiles. Avec plusieurs processeurs et serveurs en parallèle, la vitesse de recherche atteint 1 To par seconde.
Principales conclusions de cet article :
- La recherche brute est une approche tout à fait viable pour résoudre des problèmes réels à grande échelle.
- La méthode de la force brute est une technique de conception, et non une solution miracle. Comme toute méthode, elle est mieux adaptée à certains problèmes qu'à d'autres, et peut être mise en œuvre de manière efficace ou inefficace.
- La force brute est particulièrement efficace pour atteindre en phase stable) est la performance.
- L'utilisation efficace de la force brute nécessite une optimisation du code et une allocation adéquate de ressources en temps opportun. Elle est appropriée si vos serveurs sont soumis à une forte charge, sans lien avec les utilisateurs, tandis que les opérations des utilisateurs restent prioritaires.
- La performance dépend de la conception de l'ensemble du système et non seulement de l'algorithme de la boucle interne.
(Cet article traite de la recherche de données en mémoire. Dans la plupart des cas, lorsque l'utilisateur effectue une recherche dans les journaux, les serveurs Scalyr les ont déjà mis en cache. Dans l'article suivant, nous discuterons de la recherche dans les journaux non mis en cache. Les mêmes principes s'appliquent : code efficace, méthode de force brute avec des ressources de calcul importantes).
La méthode de la force brute
Traditionnellement, la recherche dans un grand ensemble de données se fait par le biais d'un index de mots-clés. En ce qui concerne les journaux de serveur, cela signifie rechercher chaque mot unique dans le journal. Pour chaque mot, il faut établir une liste de toutes les occurrences. Cela permet de trouver facilement tous les messages contenant ce mot, par exemple 'error', 'firefox' ou 'transaction_16851951' — il suffit de consulter l'index.
J'ai utilisé cette approche chez Google, et cela a bien fonctionné. Mais chez Scalyr, nous recherchons dans les journaux octet par octet.
Pourquoi ? D'un point de vue algorithmique abstrait, les index de mots-clés sont bien plus efficaces que la recherche brute. Cependant, nous ne vendons pas des algorithmes, nous vendons de la performance. Et la performance ne dépend pas uniquement des algorithmes, mais aussi de l'ingénierie systémique. Nous devons prendre en compte tout : le volume de données, le type de recherche, le matériel disponible et le contexte logiciel. Nous avons décidé que, pour notre problème particulier, une option comme 'grep' convient mieux qu'un index.
Les index sont excellents, mais ils ont des limitations. Trouver un mot unique est facile. Mais rechercher des messages contenant plusieurs mots, comme 'googlebot' et '404', est déjà beaucoup plus compliqué. La recherche d'une phrase telle que 'exception non interceptée' nécessite un index plus volumineux, qui enregistre non seulement tous les messages contenant ce mot, mais aussi l'emplacement spécifique du mot.
La véritable difficulté apparaît lorsque vous ne recherchez pas des mots. Supposons que vous souhaitiez voir combien de trafic provient des bots. La première pensée est de chercher dans les journaux avec le mot 'bot'. Ainsi, vous trouverez certains bots : Googlebot, Bingbot et bien d'autres. Mais ici, 'bot' n'est pas un mot, mais une partie de celui-ci. Si vous cherchez 'bot' dans l'index, nous ne trouverons pas les messages contenant le mot 'Googlebot'. Si nous vérifions chaque mot de l'index et que nous analysons ensuite l'index avec les mots-clés trouvés, la recherche sera considérablement ralentie. En conséquence, certains programmes de traitement de journaux n'autorisent pas la recherche par parties de mots ou, dans le meilleur des cas, permettent d'utiliser une syntaxe spéciale avec une performance inférieure. Nous souhaitons éviter cela.
Un autre problème est la ponctuation. Vous voulez trouver toutes les requêtes de 50.168.29.7? Что насчёт отладки логов, содержащих [error]? Индексы обычно пропускают пунктуацию.
Enfin, les ingénieurs aiment les outils puissants, et parfois un problème ne peut être résolu qu'avec une expression régulière. L'index des mots-clés n'est pas très adapté pour cela.
De plus, les index sont complexes. Chaque message doit être ajouté à plusieurs listes de mots-clés. Ces listes doivent être maintenues en un format facilement consultable. Les requêtes avec des phrases, des morceaux de mots ou des expressions régulières doivent être traduites en opérations avec plusieurs listes, et les résultats doivent être analysés et combinés pour obtenir un ensemble de résultats. Dans le cadre d'un service multijoueur à grande échelle, cette complexité crée des problèmes de performance qui ne sont pas visibles lors de l'analyse des algorithmes.
Les index de mots-clés occupent également beaucoup d'espace, et le stockage est le principal poste de dépenses dans le système de gestion des journaux.
D'un autre côté, chaque recherche peut nécessiter beaucoup de puissance de calcul. Nos utilisateurs apprécient la recherche à grande vitesse pour des requêtes uniques, mais ces requêtes sont relativement rares. Pour les requêtes de recherche typiques, par exemple pour le tableau de bord, nous utilisons des techniques spéciales (nous les décrirons dans l'article suivant). D'autres requêtes sont suffisamment rares pour que nous ne traitions souvent qu'une seule à la fois. Mais cela ne signifie pas que nos serveurs ne sont pas occupés : ils sont chargés de recevoir, d'analyser et de compresser de nouveaux messages, d'évaluer les alertes, de compresser les anciennes données, et ainsi de suite. Ainsi, nous avons une réserve assez substantielle de processeurs qui peuvent être mobilisés pour exécuter des requêtes.
La force brute fonctionne si vous avez un problème brut (et beaucoup de puissance).
La force brute fonctionne le mieux sur des tâches simples avec de petites boucles internes. Vous pouvez souvent optimiser la boucle interne pour atteindre des vitesses très élevées. Si le code est complexe, il est beaucoup plus difficile de l'optimiser.
Au départ, notre code de recherche avait une boucle interne assez grande. Nous stockons les messages sur des pages de 4K ; chaque page contient certains messages (en UTF-8) et des métadonnées pour chaque message. Les métadonnées sont une structure dans laquelle sont encodés la longueur de la valeur, l'ID interne du message et d'autres champs. La boucle de recherche était la suivante :
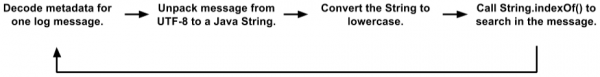
C'est une version simplifiée par rapport au code réel. Mais même ici, on voit plusieurs allocations d'objets, des copies de données et des appels de fonction. La JVM optimise assez bien les appels de fonction et alloue des objets éphémères, donc ce code fonctionnait mieux que ce que nous méritions. Pendant les tests, les clients l'ont utilisé avec un certain succès. Mais finalement, nous sommes passés à un nouveau niveau.
(Vous vous demandez peut-être pourquoi nous stockons les messages dans un format tel que des pages de 4K, avec du texte et des métadonnées, au lieu de travailler directement avec les journaux. Il y a de nombreuses raisons, qui se résument au fait que le moteur Scalyr est plus semblable à une base de données distribuée qu'à un système de fichiers. La recherche textuelle est souvent associée à des filtres de type SGBD sur des champs après l'analyse des journaux. Nous pouvons rechercher simultanément dans des milliers de journaux à la fois, et les simples fichiers texte ne conviennent pas à notre gestion des données transactionnelle, répliquée et distribuée).
Au départ, il semblait que ce type de code n'était pas très adapté à l'optimisation par méthode de force brute. Le "vrai travail" dans String.indexOf() n'était même pas dominant dans le profil CPU. En d'autres termes, l'optimisation de cette méthode seule n'apporterait pas d'effet significatif.
Nous avons donc stocké les métadonnées au début de chaque page, et le texte de tous les messages en UTF-8 est empaqueté à l'autre extrémité. Profitant de cela, nous avons réécrit la boucle pour rechercher sur toute la page :
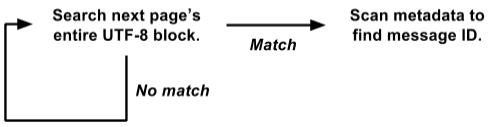
Cette version fonctionne directement sur la vue raw byte[] et effectue une recherche de tous les messages sur la page 4K entière.
C'est beaucoup plus facile à optimiser pour la méthode de force brute. La boucle de recherche interne est appelée simultanément pour toute la page 4K, et non séparément pour chaque message. Il n'y a ni copie de données, ni allocation d'objets. De plus, des opérations plus complexes sur les métadonnées ne sont appelées qu'en cas de résultat positif, et non pour chaque message. Ainsi, nous avons éliminé une tonne de frais généraux, et la charge restante est concentrée dans une petite boucle de recherche interne, qui est bien adaptée pour une optimisation ultérieure.
Notre véritable algorithme de recherche est basé sur . Il ressemble à l'algorithme de Boyer-Moore avec un décalage d'environ la longueur de la chaîne de recherche à chaque étape. La principale différence est qu'il vérifie deux octets à la fois pour minimiser les faux positifs.
Notre implémentation nécessite que pour chaque recherche, une table de recherche de 64K soit créée, mais cela est insignifiant comparé aux gigaoctets de données dans lesquelles nous recherchons. La boucle interne traite plusieurs gigaoctets par seconde sur un seul cœur. En pratique, la performance stable est d'environ 1,25 Go par seconde sur chaque cœur, et il y a un potentiel d'amélioration. Nous pouvons éliminer certaines surcharges en dehors de la boucle interne, et nous prévoyons d'expérimenter la boucle interne en C au lieu de Java.
Exploiter la puissance
Nous avons discuté de la possibilité de réaliser la recherche dans les journaux de manière "brute", mais quelle est la "puissance" dont nous disposons ? Pas mal.
1 cœur: lorsqu'elle est utilisée correctement, un cœur moderne de processeur est déjà assez puissant en soi.
8 cœurs: actuellement, nous travaillons sur des serveurs Amazon hi1.4xlarge et i2.4xlarge SSD, chacun avec 8 cœurs (16 threads). Comme mentionné précédemment, ces cœurs sont généralement occupés par des opérations de fond. Lorsque l'utilisateur effectue une recherche, les opérations de fond sont suspendues, libérant tous les 8 cœurs pour la recherche. La recherche est normalement terminée en une fraction de seconde, après quoi le travail de fond reprend (le programme de régulation garantit que le flot des requêtes de recherche ne perturbe pas les opérations de fond importantes).
16 cœurs: pour la fiabilité, nous organisons les serveurs en groupes maître/esclave. Chaque maître a un serveur SSD et un EBS à sa charge. Si le serveur principal tombe, le serveur SSD prend immédiatement sa place. La plupart du temps, le maître et l'esclave fonctionnent normalement, de sorte que chaque bloc de données est accessible pour les recherches sur deux serveurs différents (le serveur EBS de l'esclave a un processeur faible, donc nous ne le considérons pas). Nous répartissons la tâche entre eux, donc nous avons au total 16 cœurs disponibles.
Beaucoup de cœurs: dans un avenir proche, nous répartirons les données sur les serveurs de manière à ce que tous participent au traitement de chaque requête non triviale. Chaque cœur sera utilisé. [Remarque : nous avons mis en œuvre un plan et augmenté la vitesse de recherche à 1 To/s, voir la remarque à la fin de l'article].
La simplicité assure la fiabilité
Un autre avantage de la méthode de la force brute est sa performance assez stable. En général, la recherche est peu sensible aux détails de la tâche et à l'ensemble de données (je pense que c'est pour cela qu'on l'appelle « brute »).
L'index des mots-clés peut parfois donner des résultats incroyablement rapides, tandis que d'autres fois, ce n'est pas le cas. Supposons que vous ayez 50 Go de journaux, dans lesquels le terme ‘customer_5987235982’ apparaît exactement trois fois. Une recherche sur ce terme se fera immédiatement en examinant trois emplacements dans l'index. Mais une recherche complexe avec des caractères génériques peut scanner des milliers de mots-clés et prendre beaucoup de temps.
D'autre part, la recherche par force brute pour toute requête s'exécute à une vitesse plus ou moins constante. La recherche de longs mots est meilleure, mais même la recherche d'un seul caractère se fait assez rapidement.
La simplicité de la méthode de force brute signifie que sa performance est proche du maximum théorique. Il y a moins de risques de surcharge de disque imprévue, de conflits de verrouillage, de poursuites de pointeur, et de milliers d'autres raisons d'échec. Je viens de jeter un œil sur les requêtes effectuées par les utilisateurs de Scalyr la semaine dernière sur notre serveur le plus chargé. Il y a eu 14 000 requêtes. Seulement huit d'entre elles ont pris plus d'une seconde ; 99 % ont été exécutées en moins de 111 millisecondes (si vous n'avez pas utilisé d'outils d'analyse de journaux, croyez-moi : c'est rapide).
Une performance stable et fiable est essentielle pour l'expérience utilisateur du service. Si celui-ci ralentit par intermittence, les utilisateurs le percevront comme peu fiable et seront réticents à l'utiliser.
Recherche dans les journaux en action
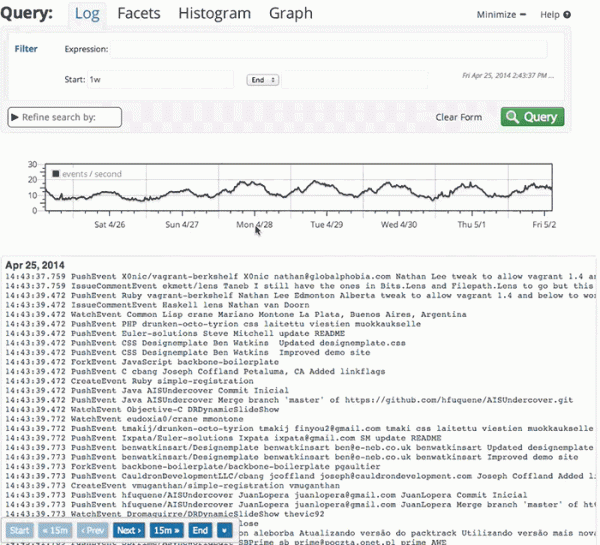
Voici une petite animation qui montre la recherche Scalyr en action. Nous avons un compte démo dans lequel nous importons chaque événement de chaque dépôt public sur Github. Dans cette démonstration, j'examine les données d'une semaine : environ 600 Mo de journaux bruts.
La vidéo a été enregistrée en direct, sans préparation spéciale, depuis mon bureau (à environ 5000 kilomètres du serveur). Les performances que vous allez voir sont en grande partie dues à , ainsi qu'à un backend rapide et fiable. Chaque fois qu'il y a une pause sans indication de ‘loading’, c'est moi qui fais une pause pour que vous puissiez lire ce que je m'apprête à cliquer.
En conclusion
Lors du traitement de grandes quantités de données, il est important de choisir un bon algorithme, mais « bon » ne signifie pas « extravagant ». Réfléchissez à la façon dont votre code fonctionnera dans la pratique. Certaines considérations qui peuvent être cruciales dans le monde réel échappent à l'analyse théorique des algorithmes. Des algorithmes plus simples sont plus faciles à optimiser et sont plus stables dans des situations limites.
Pensez également au contexte dans lequel le code sera exécuté. Dans notre cas, des serveurs suffisamment puissants sont nécessaires pour gérer les tâches en arrière-plan. Les utilisateurs initient relativement rarement une recherche, c’est pourquoi nous pouvons emprunter un groupe de serveurs pour la courte durée nécessaire à chaque recherche.
Avec une méthode de force brute, nous avons mis en place une recherche rapide, fiable et flexible sur un ensemble de journaux. Nous espérons que ces idées seront utiles pour vos projets.
Modification : le titre et le texte ont été modifiés de « Recherche à la vitesse de 20 Go par seconde » à « Recherche à la vitesse de 1 To par seconde », afin de refléter l'augmentation des performances au cours des dernières années. Cette augmentation de vitesse est principalement liée au changement de type et de nombre de serveurs EC2 que nous déployons aujourd'hui pour servir une clientèle croissante. Des changements sont à venir, qui permettront une autre amélioration significative de l'efficacité, et nous sommes impatients de pouvoir en parler.
Source : habr.com
