

Suite de la traduction d'un petit livre :
«Understanding Message Brokers»,
auteur : Jakub Korab, éditeur : O’Reilly Media, Inc., date de publication : juin 2017, ISBN : 9781492049296.
Partie traduite précédente :
CHAPITRE 3
Kafka
Kafka a été développé chez LinkedIn pour contourner certaines limitations des courtiers de messages traditionnels et éviter la nécessité de configurer plusieurs courtiers de messages pour différentes interactions « point à point », ce qui est décrit dans ce livre dans la section « Scalabilité verticale et horizontale » à la page 28. Les scénarios d'utilisation chez LinkedIn reposaient principalement sur l'absorption unidirectionnelle de très grands volumes de données, telles que les clics sur les pages et les journaux d'accès, tout en permettant à plusieurs systèmes d'utiliser ces données sans affecter la performance des producteurs ou d'autres consommateurs. En fait, la raison d'être de Kafka est de permettre une telle architecture d'échange de messages comme décrit par le Universal Data Pipeline.
Compte tenu de cet objectif final, d'autres exigences ont naturellement émergé. Kafka doit :
- Être extrêmement rapide
- Offrir une grande capacité de traitement des messages
- Supporter les modèles « Éditeur-Abonné » et « Point à Point »
- Ne pas ralentir avec l'ajout de consommateurs. Par exemple, la performance des files d'attente et des sujets dans ActiveMQ se dégrade avec l'augmentation du nombre de consommateurs à destination
- Être évolutif horizontalement ; si un courtier qui conserve des messages ne peut activer qu'à la vitesse maximale du disque, il est judicieux de dépasser une seule instance de courtier pour améliorer la performance
- Isoler l'accès au stockage et à la récupération des messages
Pour atteindre tout cela, Kafka a adopté une architecture qui a redéfini les rôles et responsabilités des clients et des courtiers en messages. Le modèle JMS est très centré sur le courtier, où il est responsable de la diffusion des messages, tandis que les clients doivent seulement se soucier de l'envoi et de la réception des messages. Kafka, en revanche, est axé sur le client, ce qui signifie que le client prend en charge de nombreuses fonctions traditionnelles du courtier, telles que la distribution équitable des messages pertinents parmi les consommateurs, recevant en échange un courtier extrêmement rapide et évolutif. Pour les personnes ayant travaillé avec des systèmes de messagerie traditionnels, travailler avec Kafka nécessite des changements fondamentaux dans leur perspective.
Cette direction d'ingénierie a conduit à la création d'une infrastructure de messagerie capable d'augmenter de plusieurs ordres de grandeur la capacité par rapport à un courtier classique. Comme nous le verrons, cette approche est accompagnée de compromis qui signifient que Kafka n'est pas adapté à certains types de charges de travail et de logiciels établis.
Modèle unifié de destinataire
Pour répondre aux exigences décrites ci-dessus, Kafka a combiné la messagerie de type « publication-abonnement » et « point à point » dans un seul type de destinataire — topic. Cela déroute les personnes ayant travaillé avec des systèmes de messagerie où le terme « topic » se réfère à un mécanisme de diffusion, d'où (du topic) la lecture n'est pas fiable (is nondurable). Les topics de Kafka doivent être considérés comme un type hybride de destinataire, conformément à la définition donnée dans l'introduction de ce livre.
Dans le reste de ce chapitre, sauf indication contraire explicite, le terme « topic » fera référence à un topic Kafka.
Pour comprendre pleinement comment les topics se comportent et quelles garanties ils offrent, nous devons d'abord examiner comment ils sont implémentés dans Kafka.
Chaque topic dans Kafka a son propre journal.
Les producteurs qui envoient des messages sur Kafka ajoutent à ce journal, tandis que les consommateurs lisent le journal à l'aide de pointeurs qui avancent constamment. Périodiquement, Kafka supprime les parties les plus anciennes du journal, que les messages dans ces sections aient été lus ou non. L'élément central de la conception de Kafka est que le courtier ne se soucie pas de savoir si les messages ont été lus ou non — c'est la responsabilité du client.
Les termes « journal » et « pointeur » ne figurent pas dans . Ces termes bien connus sont utilisés ici pour faciliter la compréhension.
Ce modèle est complètement différent de celui d'ActiveMQ, où les messages de toutes les files d'attente sont stockés dans un seul journal et où le courtier marque les messages comme supprimés après qu'ils ont été lus.
Approfondissons maintenant un peu plus et examinons le journal du sujet plus en détail.
Le journal Kafka est composé de plusieurs partitions (). Kafka garantit un ordre strict dans chaque partition. Cela signifie que les messages écrits dans une partition dans un certain ordre seront lus dans le même ordre. Chaque partition est implémentée sous la forme d'un fichier journal roulant (rolling) qui contient un sous-ensemble (subset) de tous les messages envoyés au sujet par ses producteurs. Le sujet créé contient par défaut une partition. L'idée des partitions est le concept central de Kafka pour l'évolutivité horizontale.
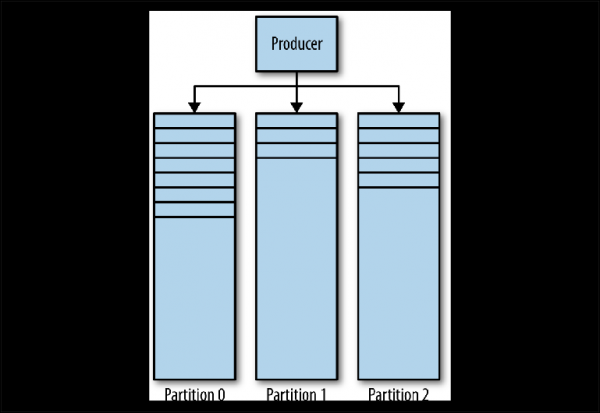
Figure 3-1. Partitions Kafka
Lorsqu'un producteur envoie un message à un sujet Kafka, il décide de la partition dans laquelle envoyer le message. Nous examinerons cela plus en détail plus tard.
Lecture des messages
Le client qui souhaite lire les messages gère un pointeur nommé groupe de consommateurs (consumer group), qui pointe vers le décalage (offset) du message dans la partition. Le décalage est une position avec un numéro croissant, qui commence à 0 au début de la partition. Ce groupe de consommateurs, auquel on fait référence dans l'API via un identifiant group_id défini par l'utilisateur, correspond à un seul consommateur logique ou système..
La plupart des systèmes utilisant la messagerie lisent les données de l'expéditeur via plusieurs instances et flux pour le traitement parallèle des messages. Ainsi, il y aura généralement de nombreuses instances de consommateurs partageant le même groupe de consommateurs.
Le problème de lecture peut être présenté comme suit :
- Un topic a plusieurs partitions
- De nombreux groupes de consommateurs peuvent utiliser le même topic en même temps
- Un groupe de consommateurs peut avoir plusieurs instances distinctes
C'est un problème non trivial de « plusieurs à plusieurs ». Pour comprendre comment Kafka gère les relations entre les groupes de consommateurs, les instances de consommateurs et les partitions, examinons plusieurs scénarios de lecture qui se compliquent progressivement.
Consommateurs et groupes de consommateurs
Prenons comme point de départ un topic avec une seule partition ().
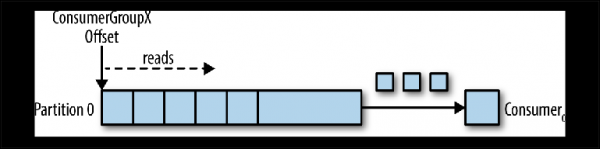
Figure 3-2. Un consommateur lit à partir de la partition
Lorsqu'une instance de consommateur se connecte à ce topic avec son propre group_id, une partition est assignée pour la lecture ainsi qu'un offset dans cette partition. La position de cet offset est configurée dans le client, comme un pointeur vers la dernière position (le message le plus récent) ou la première position (le message le plus ancien). Le consommateur demande (poll) les messages du topic, ce qui entraîne leur lecture séquentielle dans le journal.
La position de l'offset est régulièrement commise à Kafka et sauvegardée comme des messages dans le topic interne _consumer_offsets. Les messages lus ne sont pas supprimés, contrairement à un broker classique, et le client peut faire avancer (rewind) l'offset pour retraiter les messages déjà consultés.
Lorsqu'un deuxième consommateur logique se connecte, utilisant un autre group_id, il gère un deuxième pointeur qui est indépendant du premier (). Ainsi, le topic Kafka fonctionne comme une file d'attente où il existe un consommateur et, comme un topic classique de publication-abonnement (pub-sub), auquel plusieurs consommateurs sont abonnés, avec l'avantage supplémentaire que tous les messages sont conservés et peuvent être traités plusieurs fois.
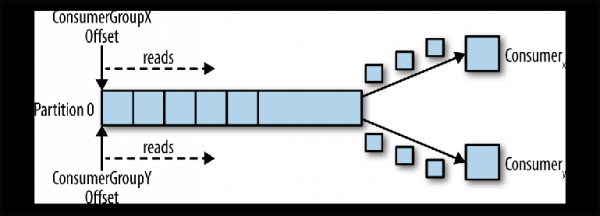
Figure 3-3. Deux consommateurs dans différents groupes de consommateurs lisent à partir d'une seule partition
Consommateurs dans le groupe de consommateurs
Lorsqu'une instance de consommateur lit des données à partir d'une partition, elle contrôle entièrement le pointeur et traite les messages comme décrit dans la section précédente.
Si plusieurs instances de consommateurs se sont connectées avec le même group_id à un sujet avec une seule partition, le contrôle du pointeur sera transféré à l'instance qui s'est connectée en dernier, et à partir de ce moment, elle recevra tous les messages ().
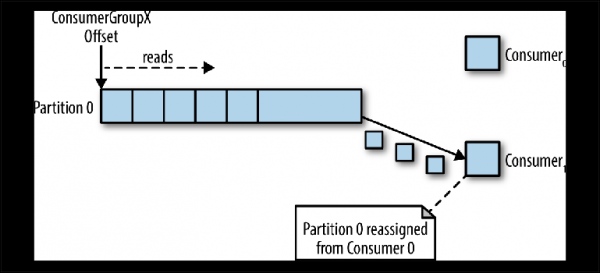
Figure 3-4. Deux consommateurs dans le même groupe de consommateurs lisent à partir d'une seule partition
Ce mode de traitement, où le nombre d'instances de consommateurs dépasse le nombre de partitions, peut être considéré comme une forme de consommateur monopolistique. Cela peut être utile si vous avez besoin d'une clusterisation « active-passive » (ou « chaude-tiède ») de vos instances de consommateurs, bien que le fonctionnement parallèle de plusieurs consommateurs (« active-active » ou « chaude-chaude ») soit beaucoup plus typique que des consommateurs en attente.
Comportement de distribution des messages tel que décrit ci-dessus peut surprendre par rapport à celui d'une file JMS classique. Dans ce modèle, les messages envoyés dans la file seront distribués de manière équitable entre deux consommateurs.
Le plus souvent, lorsque nous créons plusieurs instances de consommateurs, nous le faisons soit pour le traitement parallèle des messages, soit pour augmenter la vitesse de lecture, soit pour améliorer la résilience du processus de lecture. Comme seule une instance de consommateur peut lire des données d'une partition à la fois, comment cela est-il réalisé dans Kafka ?
Une façon de le faire est d'utiliser une instance de consommateur pour lire tous les messages et les transmettre à un pool de threads. Bien que cette approche augmente la capacité de traitement, elle complique la logique des consommateurs et ne contribue pas à la résilience du système de lecture. Si une instance de consommateur échoue en raison d'une panne de courant ou d'un événement similaire, la lecture s'arrête.
La manière canonique de résoudre ce problème dans Kafka est d'utiliser unOplus grand nombre de partitions.
Partitionnement
Les partitions sont le principal mécanisme permettant de paralléliser la lecture et d'évoluer le sujet au-delà de la capacité d'un seul broker. Pour mieux comprendre cela, examinons la situation où un sujet a deux partitions et un consommateur s'abonne à ce sujet ().
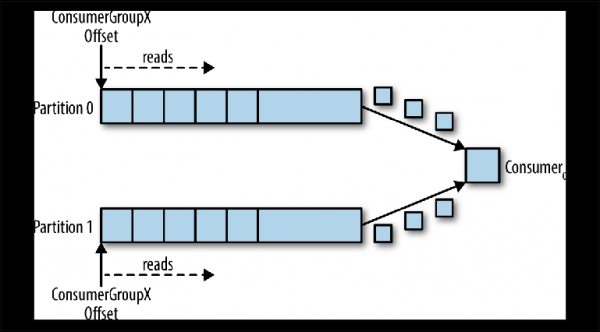
Figure 3-5. Un consommateur lit plusieurs partitions
Dans ce scénario, le consommateur obtient le contrôle des pointeurs correspondant à son group_id dans les deux partitions et commence à lire les messages des deux partitions.
Lorsqu'un consommateur supplémentaire est ajouté à ce sujet pour le même group_id, Kafka réaffecte (reallocate) l'une des partitions du premier au deuxième consommateur. Ainsi, chaque instance de consommateur lira à partir d'une seule partition du sujet ().
Pour assurer le traitement des messages en parallèle dans 20 threads, vous aurez besoin d'au moins 20 partitions. Si le nombre de partitions est inférieur, vous aurez des consommateurs qui n'auront rien à traiter, comme décrit précédemment dans la discussion sur les consommateurs monopolistes.
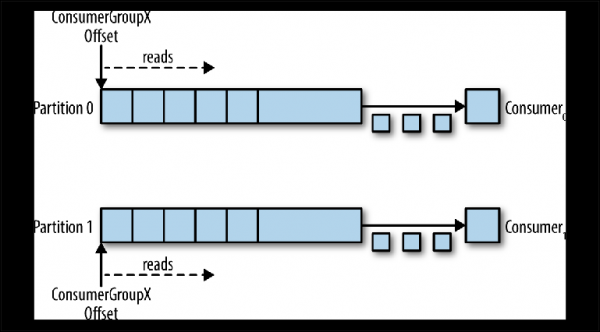
Figure 3-6. Deux consommateurs dans le même groupe de consommateurs lisent dans des partitions différentes
Ce schéma réduit considérablement la complexité de gestion du broker Kafka par rapport à la distribution des messages requise pour prendre en charge une file d'attente JMS. Il n'est pas nécessaire de se soucier des points suivants :
- Quel consommateur doit recevoir le prochain message basé sur une distribution cyclique (round-robin), la capacité actuelle des buffers de prélecture ou les messages précédents (comme pour les groupes de messages JMS).
- Quels messages ont été envoyés à quels consommateurs et doivent-ils être livrés à nouveau en cas d'échec.
Tout ce que le broker Kafka doit faire est de transmettre les messages au consommateur de manière séquentielle lorsque ce dernier les demande.
Cependant, les exigences de parallélisation de la lecture et de renvoi des messages échoués ne disparaissent pas — la responsabilité leur incombe simplement au client. Cela signifie qu'elles doivent être prises en compte dans votre code.
Envoi de messages
La responsabilité de décider à quelle partition envoyer un message incombe au producteur de ce message. Pour comprendre le mécanisme par lequel cela est fait, il faut d'abord examiner ce que nous envoyons réellement.
Alors que dans JMS, nous utilisons une structure de message avec des métadonnées (en-têtes et propriétés) et un corps contenant la charge utile (payload), dans Kafka, un message est une paire « clé-valeur ». La charge utile du message est envoyée en tant que valeur (value). La clé, en revanche, est principalement utilisée pour le partitionnement et doit contenir une clé spécifique à la logique métier, afin de placer les messages liés dans la même partition.
Dans le Chapitre 2, nous avons discuté du scénario des paris en ligne, où les événements liés doivent être traités dans l'ordre par un seul consommateur :
- Le compte utilisateur est configuré.
- L'argent est crédité sur le compte.
- Un pari est placé, ce qui retire de l'argent du compte.
Si chaque événement représente un message envoyé au topic, alors dans ce cas, la clé naturelle serait l'identifiant du compte.
Lorsque le message est envoyé à l'aide de l'API Kafka Producer, il est transmis à la fonction de partitionnement, qui, en tenant compte du message et de l'état actuel du cluster Kafka, renvoie l'identifiant de la partition dans laquelle le message doit être envoyé. Cette fonction est implémentée en Java via l'interface Partitioner.
Cette interface se présente comme suit :
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
L'implémentation de Partitioner pour déterminer la partition utilise par défaut un algorithme de hachage de clé (general-purpose hashing algorithm over the key) ou un rond-robin (round-robin), si aucune clé n'est spécifiée. Cette valeur par défaut fonctionne bien dans la plupart des cas. Cependant, à l'avenir, vous voudrez peut-être écrire votre propre.
Écriture de votre propre stratégie de partitionnement
Examinons un exemple où vous souhaitez envoyer des métadonnées avec la charge utile du message. La charge utile dans notre exemple est une instruction pour effectuer un dépôt sur un compte de jeu. L'instruction est ce que nous aimerions garantir de ne pas modifier lors de la transmission et nous voulons être sûrs que seule une systeme de confiance peut initier cette instruction. Dans ce cas, les systèmes émetteur et récepteur conviennent d'utiliser une signature pour vérifier l'authenticité du message.
Dans un JMS standard, nous définissons simplement la propriété « signature du message » et l’ajoutons au message. Cependant, Kafka ne nous fournit pas de mécanisme pour transmettre des métadonnées — seulement une clé et une valeur.
Puisque la valeur est la charge utile d’un virement bancaire (bank transfer payload), dont nous souhaitons préserver l'intégrité, nous n'avons d'autre choix que de définir une structure de données à utiliser dans la clé. En supposant que nous avons besoin d'un identifiant de compte pour le partitionnement, car tous les messages relatifs au compte doivent être traités dans l'ordre, nous allons imaginer la structure JSON suivante :
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Puisque la valeur de la signature variera en fonction de la charge utile, la stratégie de hachage par défaut de l'interface Partitioner ne regroupant pas de manière fiable les messages associés. Par conséquent, nous devrons écrire notre propre stratégie qui analysera cette clé et partitionnera la valeur accountId.
Kafka inclut des sommes de contrôle pour détecter la corruption des messages dans le stockage et dispose d'un ensemble complet de fonctionnalités de sécurité. Cependant, des exigences spécifiques au secteur, telles que celles mentionnées ci-dessus, peuvent parfois survenir.
Une stratégie de partitionnement personnalisée doit garantir que tous les messages associés se retrouvent dans une seule partition. Bien que cela semble simple, cette exigence peut être compliquée par l'importance de l'ordre des messages associés et le nombre fixe de partitions dans le sujet.
Le nombre de partitions dans un sujet peut évoluer avec le temps, car elles peuvent être ajoutées si le trafic dépasse les attentes initiales. Ainsi, les clés des messages peuvent être liées à la partition à laquelle elles ont été initialement envoyées, impliquant une partie de l'état qui doit être répartie entre les instances du producteur.
Un autre facteur à prendre en compte est l'uniformité de la répartition des messages entre les partitions. En général, les clés ne sont pas réparties uniformément parmi les messages, et les fonctions de hachage ne garantissent pas une répartition équitable des messages pour un petit ensemble de clés.
Il est important de noter que, quelle que soit la manière dont vous choisissez de séparer les messages, le séparateur lui-même devra peut-être être utilisé à nouveau.
Considérons l'exigence de réplication des données entre des clusters Kafka situés dans différents emplacements géographiques. Pour cette raison, Kafka est fourni avec un outil en ligne de commande appelé MirrorMaker, qui est utilisé pour lire les messages d'un cluster et les transférer à un autre.
MirrorMaker doit comprendre les clés du sujet à répliquer afin de maintenir l'ordre relatif entre les messages lors de la réplication entre les clusters, car le nombre de partitions pour ce sujet peut ne pas correspondre entre les deux clusters.
Les stratégies de partitionnement personnalisées sont relativement rares, car le hachage par défaut ou le round-robin fonctionnent avec succès dans la plupart des scénarios. Cependant, si vous avez besoin de garanties strictes d'ordre ou si vous devez extraire des métadonnées des charges utiles, alors le partitionnement est quelque chose que vous devriez examiner de plus près.
Les avantages de scalabilité et de performance de Kafka sont dus au transfert de certaines responsabilités traditionnelles du courtier au client. Dans ce cas, la décision est prise de répartir les messages potentiellement liés entre plusieurs consommateurs fonctionnant en parallèle.
Les courtiers JMS doivent également faire face à de telles exigences. Il est intéressant de noter que le mécanisme d'envoi de messages liés au même consommateur, réalisé via les groupes de messages JMS (une variante de la stratégie de répartition de charge sticky load balancing (SLB)), nécessite également que l'expéditeur marque les messages comme liés. Dans le cas de JMS, le courtier est chargé d'envoyer ce groupe de messages liés à un consommateur parmi plusieurs et de transférer la propriété du groupe si le consommateur tombe en panne.
Accords sur le producteur
Le partitionnement n'est pas le seul élément à prendre en compte lors de l'envoi de messages. Examinons les méthodes send() de la classe Producer dans l'API Java :
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Il convient de noter dès le départ que les deux méthodes renvoient un Future, ce qui indique que l'opération d'envoi ne s'exécute pas immédiatement. En conséquence, le message (ProducerRecord) est enregistré dans le tampon d'envoi pour chaque partition active et transmis au courtier par un fil d'arrière-plan dans la bibliothèque cliente Kafka. Bien que cela rende le processus incroyablement rapide, cela signifie qu'une application mal écrite peut perdre des messages si son processus est arrêté.
Comme toujours, il existe un moyen de rendre l'opération d'envoi plus fiable au détriment de la performance. La taille de ce tampon peut être définie à 0, et le flux de l'application d'envoi sera contraint d'attendre que la transmission du message au courtier soit terminée, comme suit :
RecordMetadata metadata = producer.send(record).get();À nouveau sur la lecture des messages
La lecture des messages présente des complexités supplémentaires sur lesquelles il convient de réfléchir. Contrairement à l'API JMS, qui peut lancer un écouteur de messages en réponse à la réception d'un message, l'interface Consumer Kafka ne fait que sonder (polling). Examinons plus en détail la méthode poll (), utilisée à cette fin :
ConsumerRecords poll(long timeout);La valeur renvoyée par la méthode est une structure conteneur contenant plusieurs objets ConsumerRecord provenant potentiellement de plusieurs partitions. ConsumerRecord est en soi un objet contenant une paire clé-valeur avec des métadonnées correspondantes, telles que la partition d'où il a été obtenu.
Comme discuté au Chapitre 2, nous devons constamment garder à l'esprit ce qui arrive aux messages après leur traitement réussi ou échoué, par exemple, si le client ne peut pas traiter le message ou s'il se termine. Dans JMS, cela était géré par le mode d'accusé de réception. Le courtier supprimera soit le message traité avec succès, soit le re-livreront s'il n'a pas été traité ou a échoué (à condition que des transactions aient été utilisées).
Kafka fonctionne de manière complètement différente. Les messages ne sont pas supprimés chez le courtier après avoir été lus, et la responsabilité de ce qui se passe en cas d'échec incombe au code de lecture lui-même.
Comme nous l'avons déjà mentionné, un groupe de consommateurs est lié à un décalage dans le journal. La position dans le journal liée à ce décalage correspond au message suivant qui sera émis en réponse à poll ()Le moment crucial lors de la lecture est celui où ce décalage augmente.
Pour revenir au modèle de lecture examiné précédemment, le traitement du message se déroule en trois étapes :
- Extraire le message à lire.
- Traiter le message.
- Confirmer le message.
Le consommateur Kafka est livré avec une option de configuration enable.auto.commit. C'est un paramètre souvent utilisé par défaut, comme cela est généralement le cas avec les paramètres contenant le mot « auto ».
Avant Kafka 0.10, un client utilisant ce paramètre envoyait le décalage du dernier message lu lors de l'appel suivant poll () après le traitement. Cela signifiait que tout message déjà extrait pouvait être traité à nouveau si le client l'avait déjà traité mais avait été détruit de manière inattendue avant l'appel. poll (). Comme le courtier ne conserve aucun état concernant le nombre de fois qu'un message a été lu, le prochain consommateur qui extrait ce message ne saura pas qu'il s'est passé quelque chose de mauvais. Ce comportement était pseudo-transactionnel. Le décalage était seulement validé en cas de traitement réussi du message, mais si le client échouait, le courtier envoyait à nouveau le même message à un autre client. Ce comportement correspondait à la garantie de livraison des messages «au moins une fois«.
Avec Kafka 0.10, le code du client a été modifié de manière à ce que le commit soit périodiquement déclenché par la bibliothèque cliente, conformément au paramètre auto.commit.interval.ms. Ce comportement se situe quelque part entre les modes JMS AUTO_ACKNOWLEDGE et DUPS_OK_ACKNOWLEDGE. Lors de l'utilisation de l'auto-commit, les messages pouvaient être confirmés indépendamment de leur traitement réel — cela pouvait se produire en cas de consommateur lent. Si le consommateur échouait, les messages étaient extraits par le prochain consommateur, en commençant par la position engagée, ce qui pouvait entraîner un oubli de message. Dans ce cas, Kafka ne perdait pas de messages, le code de lecture simplement ne les traitait pas.
Ce mode a les mêmes perspectives que dans la version 0.9 : les messages peuvent être traités, mais en cas de panne, le décalage peut ne pas être engagé, ce qui peut potentiellement entraîner une duplication de la livraison. Plus vous extrayez de messages en exécutant poll (), plus ce problème est important.
Comme discuté dans la section « Lecture des messages de la file d'attente » à la page 21, il n'existe pas de concept de livraison unique de message dans le système de messagerie, si l'on tient compte des modes de panne.
Dans Kafka, il existe deux manières d'engager (committer) un offset : automatiquement et manuellement. Dans les deux cas, les messages peuvent être traités plusieurs fois, si un message a été traité mais qu'il y a eu une panne avant le commit. Vous pouvez également ne pas traiter un message du tout, si le commit a été effectué en arrière-plan et que votre code a été terminé avant qu'il ne commence le traitement (peut-être dans Kafka 0.9 et les versions antérieures).
Vous pouvez gérer le processus de commit d'offset manuellement dans l'API du consommateur Kafka en définissant le paramètre enable.auto.commit à false et en appelant explicitement l'une des méthodes suivantes :
void commitSync();
void commitAsync();
Si vous souhaitez traiter un message « au moins une fois », vous devez engager l'offset manuellement avec commitSync (), en exécutant cette commande immédiatement après le traitement des messages.
Ces méthodes ne permettent pas d'accuser réception (acknowledged) des messages avant qu'ils ne soient traités, mais elles ne font rien pour éviter le potentiel de double traitement, tout en créant une illusion de transactionnalité. Il n'y a pas de transactions dans Kafka. Le client ne peut pas faire ce qui suit :
- Revenir automatiquement (roll back) un message échoué. Les consommateurs doivent gérer eux-mêmes les exceptions dues aux charges problématiques et aux déconnexions du backend, car ils ne peuvent pas compter sur la remise de messages par le courtier.
- Envoyer des messages vers plusieurs topics dans le cadre d'une seule opération atomique. Comme nous le verrons bientôt, le contrôle sur différents topics et partitions peut se trouver sur différentes machines dans le cluster Kafka, qui ne coordonnent pas les transactions lors de l'envoi. Au moment de la rédaction de cet article, des travaux ont été réalisés pour rendre cela possible avec KIP-98.
- Lier la lecture d'un message d'un topic à l'envoi d'un autre message vers un autre topic. Encore une fois, l'architecture de Kafka repose sur de nombreuses machines indépendantes fonctionnant comme un seul bus et aucune tentative n'est faite pour le cacher. Par exemple, il n'existe pas de composants API qui permettraient de lier Consommateur et Producteur dans la transaction. Dans JMS, cela est assuré par l'objet Session, à partir duquel sont créés MessageProducers et MessageConsumers.
Si nous ne pouvons pas compter sur des transactions, comment pouvons-nous garantir une sémantique plus proche de celle fournie par les systèmes de messagerie traditionnels ?
S'il y a une possibilité que le décalage du consommateur puisse augmenter avant que le message soit traité, par exemple, lors d'une défaillance du consommateur, alors le consommateur n'a aucun moyen de savoir si son groupe de consommateurs a manqué des messages lorsque la partition lui est assignée. Ainsi, l'une des stratégies consiste à remonter (rewind) le décalage à la position précédente. L'API du consommateur Kafka fournit les méthodes suivantes à cet effet :
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Méthode seek () peut être utilisé avec la méthode
offsetsForTimes (Map timestampsToSearch) pour revenir à un état à un moment précis dans le passé.
Implicitement, l'utilisation de cette approche signifie qu'il est très probable que certains messages, qui ont été traités auparavant, seront lus et traités à nouveau. Pour éviter cela, nous pouvons utiliser une lecture idempotente, comme décrit au Chapitre 4, pour suivre les messages déjà vus et exclure les doublons.
En alternative, le code de votre consommateur peut être simple si la perte ou la duplication de messages est acceptable. Lorsque nous examinons les cas d'utilisation pour lesquels Kafka est généralement utilisé, comme le traitement des événements de journaux, des métriques, le suivi des clics, etc., nous comprenons que la perte de messages individuels est peu susceptible d'avoir un impact significatif sur les applications environnantes. Dans ces cas, les valeurs par défaut sont tout à fait acceptables. En revanche, si votre application doit gérer des paiements, vous devez prêter une attention particulière à chaque message individuel. Tout dépend du contexte.
Des observations personnelles montrent qu'à mesure que l'intensité des messages augmente, la valeur de chaque message individuel diminue. Les messages en grande quantité deviennent généralement précieux lorsqu'ils sont considérés sous forme agrégée.
Haute disponibilité (High Availability)
L'approche de Kafka en matière de haute disponibilité diffère considérablement de celle d'ActiveMQ. Kafka est conçu sur la base de clusters évolutifs horizontalement, où toutes les instances de courtier acceptent et distribuent les messages simultanément.
Un cluster Kafka se compose de plusieurs instances de courtiers fonctionnant sur différents serveurs. Kafka a été conçu pour fonctionner sur du matériel autonome standard, où chaque nœud dispose de son propre stockage dédié. L'utilisation de stockages en réseau (SAN) n'est pas recommandée, car plusieurs nœuds de calcul peuvent rivaliser pour des intervalles de temps de stockage et créer des conflits.ÎLes intervalles de stockage et créer des conflits.
Kafka est un système constamment actif. De nombreux grands utilisateurs de Kafka ne mettent jamais hors tension leurs clusters et le logiciel garantit toujours des mises à jour par redémarrages séquentiels. Cela est réalisé en garantissant la compatibilité avec la version précédente pour les messages et les interactions entre courtiers.
Les courtiers sont connectés au cluster de serveurs , qui agit comme un registre des données de configuration et est utilisé pour coordonner les rôles de chaque courtier. ZooKeeper lui-même est un système distribué qui assure une haute disponibilité grâce à la réplication des informations en établissant un quorum..
Dans un cas de base, un topic est créé dans le cluster Kafka avec les propriétés suivantes :
- Le nombre de partitions. Comme discuté plus tôt, la valeur exacte utilisée ici dépend du niveau de lecture parallèle souhaité.
- Le facteur de réplication définit combien d'instances de courtier dans le cluster doivent contenir les journaux pour cette partition.
En utilisant ZooKeeper pour la coordination, Kafka essaie de répartir équitablement les nouvelles partitions entre les courtiers dans le cluster. Cela est fait par un des courtiers qui joue le rôle de contrôleur.
Au runtime , pour chaque partition de topic, le contrôleur attribue aux courtiers des rôles de leader (leader, maître) et suiveurs. (followers, esclaves, subordonnés). Le courtier agissant en tant que leader pour cette partition est responsable de la réception de tous les messages envoyés par les producteurs et de la diffusion des messages aux consommateurs. Lors de l'envoi de messages dans la partition du sujet, ceux-ci sont répliqués sur tous les nœuds du courtier qui agissent en tant que suiveurs pour cette partition. Chaque nœud contenant des journaux pour la partition est appelé réplique. Un courtier peut agir en tant que leader pour certaines partitions et en tant que suiveur pour d'autres.
Le suiveur contenant tous les messages stockés chez le leader est appelé réplique synchronisée (réplique en état synchronisé, in-sync replica). Si le courtier agissant en tant que leader pour la partition se déconnecte, tout courtier qui est dans un état à jour ou synchronisé pour cette partition peut prendre le rôle de leader. C'est une conception d'une grande robustesse.
Une partie de la configuration du producteur est le paramètre acks, qui détermine combien de répliques doivent confirmer (acknowledge) la réception d'un message avant que le flux de l'application ne continue à envoyer : 0, 1 ou tous. Si une valeur est spécifiée tout, alors, lors de la réception d'un message, le leader enverra une confirmation (confirmation) au producteur dès qu'il recevra les confirmations (acknowledgements) de l'écriture de plusieurs répliques (y compris la sienne), déterminées par la configuration du sujet min.insync.replicas (par défaut 1). Si un message ne peut pas être répliqué avec succès, le producteur déclenchera une exception pour l'application (NotEnoughReplicas ou NotEnoughReplicasAfterAppend).
Dans une configuration typique, un sujet est créé avec un coefficient de réplication de 3 (1 leader, 2 suiveurs pour chaque partition) et le paramètre min.insync.replicas est défini sur 2. Dans ce cas, le cluster permettra à l'un des courtiers gérant la partition du sujet de se déconnecter sans affecter les applications clientes.
Cela nous ramène au compromis déjà connu entre performance et fiabilité. La réplication se fait par le biais d'un temps d'attente supplémentaire pour les accusés de réception (acknowledgments) des suiveurs. Cependant, comme elle s'effectue en parallèle, la réplication sur au moins trois nœuds a une performance équivalente à celle de deux (en ignorant l'augmentation de l'utilisation de la bande passante réseau).
En utilisant ce schéma de réplication, Kafka évite habilement la nécessité de garantir l'écriture physique de chaque message sur le disque via l'opération sync (). Chaque message envoyé par le producteur sera enregistré dans le journal de partition, mais comme discuté dans le Chapitre 2, l'écriture dans le fichier est initialement effectuée dans le tampon du système d'exploitation. Si ce message est répliqué sur une autre instance de Kafka et se trouve en mémoire, la perte du leader ne signifie pas que le message lui-même a été perdu — une réplique synchronisée peut le prendre en charge.
L'abandon de la nécessité d'effectuer l'opération sync () signifie que Kafka peut accepter des messages à la vitesse à laquelle il peut les écrire en mémoire. Et inversement, plus longtemps il est possible d'éviter le vidage (flushing) de la mémoire sur le disque, mieux c'est. Pour cette raison, il n'est pas rare que les courtiers Kafka se voient attribuer 64 Go de mémoire ou plus. Une telle utilisation de la mémoire signifie qu'une instance de Kafka peut facilement fonctionner à des vitesses plusieurs milliers de fois plus rapides qu'un courtier de messages traditionnel.
Kafka peut également être configuré pour appliquer l'opération sync () à des lots de messages. Comme tout dans Kafka est orienté vers le traitement par lots, cela fonctionne en réalité assez bien pour de nombreux scénarios d'utilisation et constitue un outil utile pour les utilisateurs qui exigent des garanties très solides. Une grande partie de la performance pure de Kafka est liée aux messages qui sont envoyés au courtier sous forme de paquets et à la manière dont ces messages sont lus à partir du courtier en blocs séquentiels via (opérations (avec des opérations où la tâche de copie de données d'une zone mémoire à une autre n'est pas effectuée). Cela représente un gain significatif en termes de performance et de ressources, et c'est possible uniquement grâce à l'utilisation de la structure de données en journal sous-jacente, qui définit le schéma de partition.)
Dans un cluster Kafka, il est possible d'obtenir une performance bien supérieure à celle d'un broker Kafka unique, car les partitions du topic peuvent être mises à l'échelle horizontalement sur de nombreuses machines distinctes.
Résultats
Dans ce chapitre, nous avons examiné comment l'architecture Kafka repense les relations entre clients et brokers pour offrir un pipeline de messagerie incroyablement résilient, avec une bande passante plusieurs fois supérieure à celle d'un broker de messages traditionnel. Nous avons discuté des fonctionnalités qu'elle utilise pour atteindre cet objectif et avons brièvement passé en revue l'architecture des applications qui fournissent cette fonctionnalité. Dans le chapitre suivant, nous aborderons les défis courants que les applications de messagerie doivent résoudre et discuterons des stratégies pour les surmonter. Nous conclurons le chapitre en dessinant des réflexions sur les technologies de messagerie en général, afin que vous puissiez évaluer leur pertinence pour vos scénarios d'utilisation.
Partie traduite précédente :
Traduction effectuée par :
À suivre...
Seuls les utilisateurs enregistrés peuvent participer au sondage. , s'il vous plaît.
Kafka est-il utilisé dans votre organisation ?
Oui
Non
Utilisé auparavant, mais plus maintenant
Nous prévoyons d'utiliser
38 utilisateurs ont voté. 8 utilisateurs se sont abstenu.
Source : habr.com
