

L'effet de gonflement des tables et des index (bloat) est bien connu et n'existe pas seulement dans Postgres. Il existe des moyens de le combattre « en boîte » comme VACUUM FULL ou CLUSTER, mais ceux-ci bloquent les tables pendant le fonctionnement et ne peuvent donc pas toujours être utilisés.
Cet article contiendra un peu de théorie sur la façon dont le bloat survient, comment y faire face, sur les contraintes différées et sur les problèmes qu'elles apportent dans l'utilisation de l'extension pg_repack.
Cet article est basé sur à PgConf.Russia 2020.
Pourquoi le bloat se produit-il ?
La base de Postgres repose sur un modèle multi-version (). Son principe est que chaque ligne d'une table peut avoir plusieurs versions, chaque transaction voyant une seule de ces versions, mais pas nécessairement la même. Cela permet à plusieurs transactions de fonctionner simultanément sans interférer les unes avec les autres.
Il est évident que toutes ces versions doivent être stockées. Postgres fonctionne avec la mémoire par page, et une page est le plus petit volume de données qui peut être lu depuis le disque ou écrit. Regardons un petit exemple pour comprendre comment cela se passe.
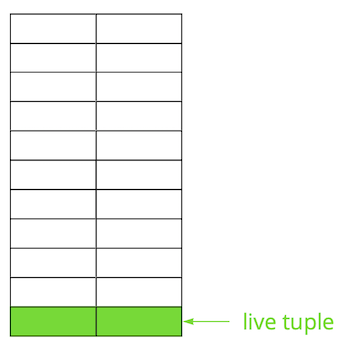
Supposons que nous avons une table à laquelle nous avons ajouté plusieurs enregistrements. Dans la première page du fichier où la table est stockée, de nouvelles données apparaissent. Ce sont des versions vivantes des lignes, accessibles à d'autres transactions après validation (pour simplifier, considérons le niveau d'isolement Read Committed).
Ensuite, nous avons mis à jour l'un des enregistrements, marquant ainsi l'ancienne version comme obsolète.
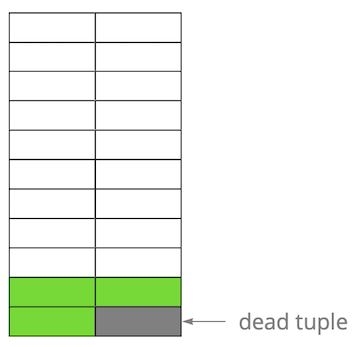
Pas à pas, en mettant à jour et en supprimant des versions de lignes, nous avons créé une page où environ la moitié des données se composent de « déchets ». Ces données ne sont visibles par aucune transaction.
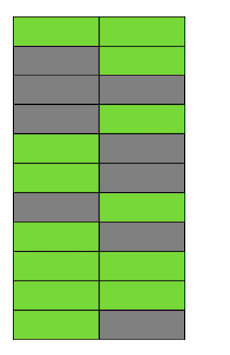
Il existe un mécanisme dans Postgres , qui nettoie les versions obsolètes et libère de l'espace pour les nouvelles données. Mais s'il est configuré de manière pas suffisamment agressive ou occupé à travailler sur d'autres tables, alors les « données indésirables » restent, et nous sommes contraints d'utiliser des pages supplémentaires pour les nouvelles données.
Ainsi, dans notre exemple, à un moment donné, la table se composera de quatre pages, mais il n'y aura que la moitié de données vivantes. En conséquence, lors de l'accès à la table, nous lirons beaucoup plus de données que nécessaire.
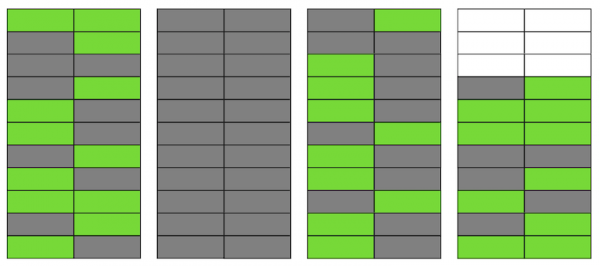
Même si VACUUM supprime toutes les versions obsolètes des lignes, la situation ne s'améliorera pas radicalement. Nous aurons de l'espace libre sur les pages ou même des pages entières pour de nouvelles lignes, mais nous continuerons à lire plus de données que nécessaire.
D'ailleurs, si une page complètement vide (la deuxième dans notre exemple) se retrouvait à la fin du fichier, VACUUM pourrait la couper. Mais elle est actuellement au milieu, donc rien ne peut être fait avec elle.
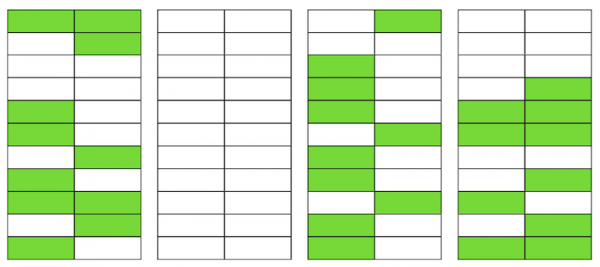
Lorsque le nombre de ces pages vides ou fortement dégarnies devient important, ce qu'on appelle le bloat, cela commence à affecter les performances.
La mécanique de création de bloat dans les tables est décrite ci-dessus. Dans les index, cela se produit de manière similaire.
Est-ce que j'ai du bloat ?
Il existe plusieurs façons de déterminer si vous avez du bloat. L'idée de la première consiste à utiliser les statistiques internes de Postgres, qui contiennent des informations approximatives sur le nombre de lignes dans les tables, le nombre de lignes « vivantes », etc. Vous pouvez trouver de nombreuses variations de scripts prêts à l'emploi sur Internet. Nous nous sommes basés sur PostgreSQL Experts, qui peut évaluer le bloat des tables ainsi que le bloat des index btree. D'après notre expérience, sa marge d'erreur est de 10 à 20%.
Une autre méthode consiste à utiliser l'extension , qui permet d'examiner le contenu des pages et d'obtenir à la fois une estimation et une valeur précise du bloat. Mais dans ce dernier cas, il faudra scanner l'ensemble de la table.
Une faible valeur de bloat, jusqu'à 20%, est considérée comme acceptable. Elle peut être considérée comme l'analogue du fillfactor pour et . À partir de 50 % et plus, des problèmes de performance peuvent survenir.
Moyens de lutter contre le bloat
Postgres propose plusieurs méthodes pour lutter contre le bloat « en standard », mais celles-ci ne conviennent pas toujours à tout le monde.
Configurer AUTOVACUUM pour éviter l'apparition de bloat. Pour être plus précis, afin qu'il reste à un niveau acceptable pour vous. Cela peut sembler être un conseil de 'capitaine', mais en réalité, ce n'est pas toujours facile à atteindre. Par exemple, si vous êtes en pleine période de développement avec des modifications régulières de schéma de données ou si une migration de données est en cours. En conséquence, votre profil de charge peut changer fréquemment et, en général, il peut varier d'une table à l'autre. Ainsi, vous devez constamment travailler un peu en avance et adapter AUTOVACUUM au profil changeant de chaque table. Mais il est évident que cela n'est pas simple.
Une autre raison courante pour laquelle AUTOVACUUM n'arrive pas à traiter les tables est la présence de transactions longues qui l'empêchent de nettoyer les données car elles sont accessibles à ces transactions. La recommandation ici est également évidente : se débarrasser des transactions 'pendantes' et minimiser le temps des transactions actives. Mais si la charge de votre application est un hybride OLAP et OLTP, vous pouvez avoir simultanément de nombreuses mises à jour fréquentes et de courtes requêtes, ainsi que des opérations longues, par exemple la génération d'un rapport. Dans une telle situation, il peut être judicieux de répartir la charge sur différentes bases afin d'affiner le réglage de chacune d'elles.
Un autre exemple : même si le profil est homogène, mais que la base de données est soumise à une très forte charge, même le VACUUM le plus agressif peut ne pas suffire, et le bloat peut continuer à se développer. L'échelle (verticale ou horizontale) est la seule solution.
Comment agir dans une situation où vous avez configuré AUTOVACUUM, mais le bloat continue d'augmenter.
Commande VACUUM FULL reconstruit le contenu des tables et des index, ne laissant que les données actuelles. Pour éliminer le bloat, il fonctionne parfaitement, mais pendant son exécution, il prend un verrou exclusif sur la table (AccessExclusiveLock), ce qui empêche l'exécution des requêtes sur cette table, même les sélections. Si vous pouvez vous permettre d'arrêter votre service ou une partie de celui-ci pendant un certain temps (de quelques dizaines de minutes à plusieurs heures selon la taille de la base de données et de votre matériel), alors cette option est la meilleure. Malheureusement, nous n'avons pas le temps d'exécuter VACUUM FULL pendant la maintenance prévue, donc cette méthode ne nous convient pas.
Commande CLUSTER Elle réorganise également le contenu des tables, tout comme VACUUM FULL, tout en permettant de spécifier un index selon lequel les données seront physiquement ordonnées sur le disque (mais pour les nouvelles lignes, cet ordre n'est pas garanti à l'avenir). Dans certaines situations, c'est une bonne optimisation pour plusieurs requêtes – lorsque plusieurs enregistrements sont lus par l'index. Le désavantage de cette commande est le même que celui de VACUUM FULL – elle bloque la table pendant son exécution.
Commande REINDEX est similaire aux deux précédentes, mais effectue la reconstruction d'un index spécifique ou de tous les index de la table. Les verrouillages sont légèrement plus faibles : un ShareLock sur la table (empêche les modifications, mais autorise les sélections) et un AccessExclusiveLock sur l'index reconstruit (bloque les requêtes utilisant cet index). Cependant, dans la version 12 de Postgres, un paramètre est apparu , qui permet de reconstruire l'index sans bloquer l'ajout, la modification ou la suppression parallèle des enregistrements.
Dans les versions antérieures de Postgres, il est possible d'obtenir un résultat similaire à REINDEX CONCURRENTLY en utilisant . Cela permet de créer un index sans verrouillage strict (ShareUpdateExclusiveLock, qui ne gêne pas les requêtes parallèles), puis de remplacer l'ancien index par le nouveau et de supprimer l'ancien index. Cela permet d'éliminer le bloat des index sans interférer avec le fonctionnement de votre application. Il est important de noter qu'en reconstruisant les index, il y aura une charge supplémentaire sur le sous-système de disque.
Ainsi, s'il existe des moyens pour le bloat des index d'être éliminé "à chaud", ce n'est pas le cas pour les tables. Diverses extensions externes interviennent alors : (anciennement pg_reorg), , et d'autres. Dans cet article, je ne vais pas les comparer et je vais parler uniquement de pg_repack, que nous utilisons après quelques adaptations.
Comment pg_repack fonctionne
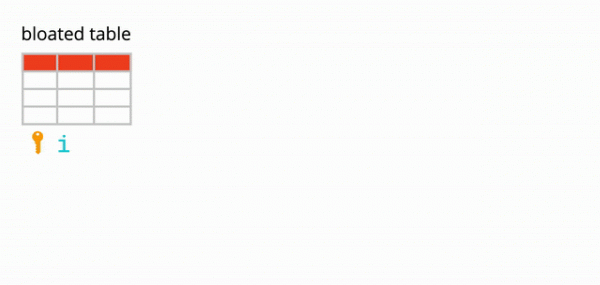
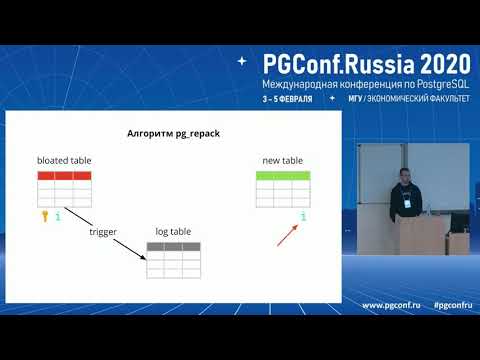
Supposons que nous ayons une table tout à fait ordinaire – avec des index, des contraintes et, malheureusement, avec du bloat. La première étape de pg_repack consiste à créer une table de log pour stocker les données sur toutes les modifications lors de l'exécution. Un trigger va répliquer ces modifications pour chaque insert, update et delete. Ensuite, une table est créée, similaire à la structure d'origine, mais sans index ni contraintes, afin de ne pas ralentir le processus d'insertion des données.
Ensuite, pg_repack déplace les données de l'ancienne table vers une nouvelle table, filtrant automatiquement toutes les lignes obsolètes, puis crée des index pour la nouvelle table. Pendant l'exécution de toutes ces opérations, les modifications s'accumulent dans la table de log.
La prochaine étape consiste à transférer les modifications vers la nouvelle table. Le transfert se fait en plusieurs itérations, et lorsque la table de log contient moins de 20 enregistrements, pg_repack prend un verrou strict, déplace les dernières données et remplace l'ancienne table par la nouvelle dans les tables système de Postgres. C'est le seul et très court moment où vous ne pourrez pas travailler avec la table. Après cela, l'ancienne table et la table de log sont supprimées, libérant de l'espace dans le système de fichiers. Le processus est terminé.
En théorie, tout semble parfait, mais qu'en est-il en pratique ? Nous avons testé pg_repack sans charge et sous charge, vérifiant son fonctionnement en cas d'arrêt prématuré (en d'autres termes, via Ctrl+C). Tous les tests ont été positifs.
Nous sommes allés en production - et là, tout ne s'est pas déroulé comme prévu.
Le premier déploiement en production
Sur le premier cluster, nous avons reçu une erreur de violation de contrainte unique :
$ ./pg_repack -t tablename -o id
INFO: nouveau conditionnement de la table "tablename"
ERREUR : la requête a échoué :
    ERREUR : la valeur de clé dupliquée viole la contrainte unique "index_16508"
DÉTAIL :  La clé (id, index)=(100500, 42) existe déjà.
Cette contrainte avait un nom auto-généré index_16508 – elle a été créée par pg_repack. D'après les attributs qui la composent, nous avons identifié "notre" contrainte correspondante. Le problème était que ce n'était pas tout à fait une contrainte ordinaire, mais une contrainte différée (), c'est-à-dire que sa vérification est effectuée plus tard que la commande SQL, ce qui entraîne des conséquences inattendues.
Contraintes différées : à quoi elles servent et comment elles fonctionnent
Un peu de théorie sur les contraintes différées.
Prenons un exemple simple : nous avons une table de référence des voitures avec deux attributs – le nom et l'ordre de la voiture dans la référence.
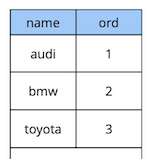
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Supposons que nous ayons besoin d'échanger la première et la deuxième voiture. Une solution "directe" consisterait à mettre à jour la première valeur avec la deuxième, et la deuxième avec la première :
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Mais en exécutant ce code, nous allons inévitablement rencontrer une violation de contrainte, car l'ordre des valeurs dans la table est unique :
[23305] ERREUR : la valeur de clé dupliquée viole la contrainte d'unicité "uk_cars"
Détail : la clé (ord)=(2) existe déjà.
Comment faire autrement ? Première option : ajouter une substitution de valeur pour un ordre qui n'existe certainement pas dans la table, par exemple "-1". En programmation, cela s'appelle "l'échange de valeurs de deux variables via une troisième". Le seul inconvénient de cette méthode est une mise à jour supplémentaire.
Deuxième option : restructurer la table pour utiliser un type de données flottant pour la valeur d'ordre au lieu d'entiers. Ainsi, lors de la mise à jour d'une valeur de 1, par exemple, à 2.5, le premier enregistrement se placera automatiquement entre le deuxième et le troisième. Cette solution fonctionne, mais elle présente deux limitations. Premièrement, elle ne convient pas si la valeur est utilisée quelque part dans l'interface. Deuxièmement, selon la précision du type de données, vous aurez un nombre limité d'insertion possible avant de devoir recalculer les valeurs de tous les enregistrements.
Troisième option : rendre la contrainte différée, afin qu'elle soit vérifiée uniquement au moment du commit :
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Étant donné que la logique de notre requête initiale garantit qu'au moment du commit, toutes les valeurs sont uniques, elle s'exécutera avec succès.
L'exemple ci-dessus, bien que très synthétique, illustre l'idée. Dans notre application, nous utilisons des contraintes différées pour implémenter une logique qui gère les conflits lorsque plusieurs utilisateurs travaillent simultanément sur des objets widgets partagés sur un tableau. L'utilisation de telles contraintes nous permet de simplifier un peu le code applicatif.
En général, selon le type de contrainte dans Postgres, il existe trois niveaux de granularité pour leur vérification : au niveau de la ligne, de la transaction et de l'expression.
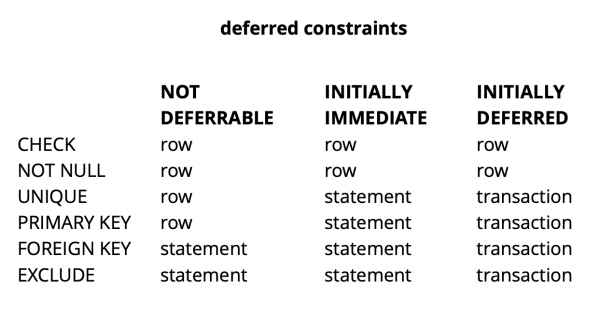
Source :
CHECK et NOT NULL sont toujours vérifiés au niveau de la ligne, pour les autres contraintes, comme le montre le tableau, il existe différentes options. Vous pouvez en lire plus. .
En résumé, les contraintes différées rendent le code plus lisible et réduisent le nombre de commandes dans certaines situations. Cependant, cela complique le processus de débogage, car le moment où l'erreur se produit et le moment où vous en êtes informé sont décalés dans le temps. Un autre problème potentiel est lié au fait que le planificateur ne peut pas toujours établir un plan optimal si une contrainte différée est impliquée dans la requête.
Amélioration de pg_repack
Nous avons compris ce que sont les contraintes différées, mais comment se rattachent-elles à notre problème ? Rappelons l'erreur que nous avons reçue précédemment :
$ ./pg_repack -t tablename -o id
INFO: nouveau conditionnement de la table "tablename"
ERREUR : la requête a échoué :
    ERREUR : la valeur de clé dupliquée viole la contrainte unique "index_16508"
DÉTAIL :  La clé (id, index)=(100500, 42) existe déjà.
Elle se produit au moment de la copie des données de la table de journal vers la nouvelle table. Cela semble étrange, étant donné que les données de la table de journal sont validées en même temps que celles de la table source. Si elles respectent les contraintes de la table source, comment peuvent-elles enfreindre les mêmes contraintes dans la nouvelle ?
Il est apparu que la racine du problème se cache dans l'étape précédente du processus pg_repack, où seuls les index sont créés, mais pas les contraintes : il y avait une contrainte d'unicité dans l'ancienne table, et dans la nouvelle, un index unique a été créé à sa place.
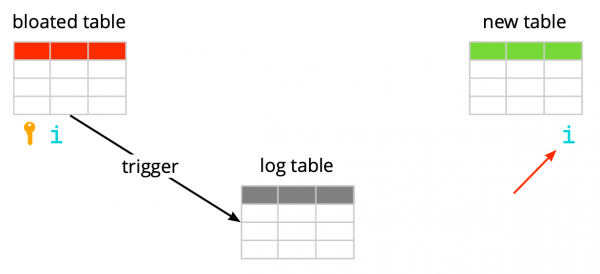
Il est important de noter que si la contrainte est ordinaire et non différée, l'index unique créé en son lieu et place équivaut à cette contrainte, car les contraintes uniques dans Postgres sont mises en œuvre par la création d'un index unique. Mais dans le cas d'une contrainte différée, le comportement n'est pas le même, car un index ne peut pas être différé et est toujours vérifié au moment de l'exécution de la commande SQL.
Ainsi, la nature du problème réside dans le fait que la vérification est "différée" : dans la table source, elle se produit au moment de la validation, tandis que dans la nouvelle, elle se produit au moment de l'exécution de la commande SQL. Cela signifie que nous devons garantir que les vérifications s'effectuent de la même manière dans les deux cas : soit toujours de manière différée, soit toujours immédiatement.
Alors, quelles idées avons-nous eues ?
Créer un index, similaire à deferred
La première idée était de réaliser les deux vérifications en mode immédiat. Cela peut entraîner quelques faux positifs dans les déclenchements de la contrainte, mais s'il y en a peu, cela ne devrait pas affecter l'expérience des utilisateurs, car de tels conflits sont considérés comme normaux. Ils surviennent, par exemple, lorsque deux utilisateurs tentent de modifier simultanément le même widget, et le client du deuxième utilisateur n'a pas le temps d'être informé que le widget a déjà été verrouillé pour modification par le premier utilisateur. Dans cette situation, le serveur refuse la demande du deuxième utilisateur, et son client annule les modifications et verrouille le widget. Un peu plus tard, lorsque le premier utilisateur a terminé la modification, le deuxième sera informé que le widget n'est plus verrouillé et pourra répéter son action.
Pour que les vérifications soient toujours en mode urgent, nous avons créé un nouvel index, similaire à la contrainte de retard originale :
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- exécuter pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
Dans l'environnement de test, nous avons rencontré quelques erreurs attendues. Succès ! Nous avons à nouveau lancé pg_repack en production et obtenu 5 erreurs sur le premier cluster en une heure de fonctionnement. C'est un résultat acceptable. Cependant, sur le deuxième cluster, le nombre d'erreurs a considérablement augmenté et nous avons dû arrêter pg_repack.
Pourquoi cela s'est-il produit ? La probabilité d'occurrence d'une erreur dépend du nombre d'utilisateurs qui travaillent simultanément sur les mêmes widgets. Apparemment, à ce moment-là, les données stockées sur le premier cluster avaient beaucoup moins de modifications concurrentes que sur les autres, c'est-à-dire que nous avons simplement eu de la "chance".
L'idée n'a pas fonctionné. À ce moment-là, nous avons envisagé deux autres solutions : réécrire notre code applicatif pour renoncer aux contraintes de retard, ou "apprendre" à pg_repack à travailler avec elles. Nous avons choisi la deuxième option.
Remplacer les index de la nouvelle table par des contraintes de retard de la table d'origine.
L'objectif de l'amélioration était évident : si la table d'origine a une contrainte de retard, alors pour la nouvelle, il faut créer une telle contrainte et non un index.
Pour vérifier nos modifications, nous avons écrit un simple test :
- une table avec une contrainte de retard et une entrée ;
- nous insérons en boucle des données qui entrent en conflit avec l'entrée existante ;
- nous faisons une mise à jour – les données ne sont plus en conflit;
- nous commettons les modifications.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
La version originale de pg_repack échouait toujours lors du premier insert, la version améliorée fonctionnait sans erreur. Excellent.
Nous allons en production et nous recevons à nouveau une erreur à la même phase de copie des données de la table de log dans la nouvelle :
$ ./pg_repack -t tablename -o id
INFO: nouveau conditionnement de la table "tablename"
ERREUR : la requête a échoué :
    ERREUR : la valeur de clé dupliquée viole la contrainte unique "index_16508"
DÉTAIL :  La clé (id, index)=(100500, 42) existe déjà.
Situation classique : tout fonctionne dans les environnements de test, mais en production – rien ?!
APPLY_COUNT et la jonction de deux lots
Nous avons commencé à analyser le code littéralement ligne par ligne et avons découvert un point important : le transfert des données de la table de log vers la nouvelle se fait par lots, la constante APPLY_COUNT indiquait la taille du lot :
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* il pourrait encore y avoir des tuples, répéter. */
...
}
Le problème est que les données de la transaction originale, dans laquelle plusieurs opérations peuvent potentiellement enfreindre la contrainte, lors de leur transfert peuvent se retrouver à la jonction de deux lots – la moitié des commandes sera validée dans le premier lot, et l'autre moitié dans le second. Et là, c'est une question de chance : si les commandes dans le premier lot ne violent rien, alors tout va bien, mais si elles violent quelque chose – une erreur se produit.
APPLY_COUNT est égal à 1000 enregistrements, ce qui explique pourquoi nos tests réussissaient – ils ne couvraient pas le cas de la "jonction des lots". Nous avons utilisé deux commandes – insert et update, donc exactement 500 transactions de deux commandes étaient toujours incluses dans le lot et nous n'avons pas rencontré de problèmes. Après l'ajout d'un deuxième update, notre correction a cessé de fonctionner :
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- un autre update
    COMMIT;
  END;
END LOOP;
Ainsi, la prochaine tâche consiste à garantir que les données de la table d'origine, qui étaient modifiées dans une transaction, soient également transférées vers la nouvelle table dans le cadre d'une seule transaction.
Abandon du batching
Et nous avions à nouveau deux options. La première : abandonner complètement le découpage en lots et effectuer le transfert des données en une seule transaction. L'avantage de cette solution était sa simplicité : les modifications de code requises étaient minimales (soit dit en passant, dans les anciennes versions, pg_reorg fonctionnait de cette manière). Mais il y a un problème — nous créons une transaction longue, et cela, comme mentionné précédemment, représente une menace de nouveau bloat.
La deuxième solution est plus complexe, mais probablement plus correcte : créer dans la table de log une colonne avec l'identifiant de la transaction qui a ajouté des données dans la table. Ainsi, lors de la copie des données, nous pourrons les regrouper par cet attribut et garantir que les modifications associées seront transférées ensemble. Le lot sera composé de plusieurs transactions (ou une grande) et sa taille variera en fonction du nombre de modifications apportées dans ces transactions. Il est important de noter que, puisque les données de différentes transactions entrent dans la table de log de manière aléatoire, il ne sera plus possible de les lire de façon séquentielle comme auparavant. Le seqscan à chaque requête avec filtrage par tx_id est trop coûteux, il faut un index, mais cela ralentira également la méthode en raison des frais généraux liés à sa mise à jour. En résumé, comme toujours, il faut sacrifier quelque chose.
Donc, nous avons décidé de commencer par la première option, qui est la plus simple. Tout d'abord, il était nécessaire de déterminer si une transaction longue serait réellement un problème. Puisque le transfert principal des données de l'ancienne table vers la nouvelle se fait également dans une longue transaction, la question s'est transformée en "dans quelle mesure allons-nous augmenter cette transaction ?" La durée de la première transaction dépend principalement de la taille de la table. La durée de la nouvelle dépend de la quantité de modifications qui s'accumule dans la table pendant le transfert des données, c'est-à-dire de l'intensité de la charge. L'exécution de pg_repack a eu lieu pendant la charge minimale sur le service, et le volume de modifications était incomparablement faible par rapport au volume initial de la table. Nous avons décidé que nous pouvions négliger le temps de la nouvelle transaction (en moyenne, cela représente 1h et 2-3 minutes).
Les expériences ont été positives. Le lancement en production aussi. Pour la clarté, une image avec la taille d'une des bases après l'exécution :
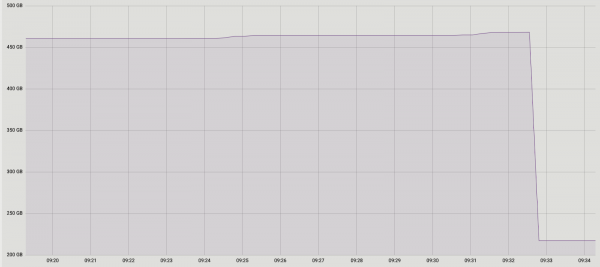
Comme cette solution nous convenait parfaitement, nous n'avons pas essayé de mettre en œuvre une seconde, mais nous envisageons la possibilité d'en discuter avec les développeurs de l'extension. Notre amélioration actuelle n'est malheureusement pas encore prête à être publiée, car nous avons résolu le problème uniquement avec des contraintes différées uniques, et pour un patch complet, il est nécessaire d'ajouter la prise en charge d'autres types. Nous espérons pouvoir le faire à l'avenir.
Il est possible que vous vous demandiez pourquoi nous nous sommes impliqués dans cette histoire de mise à jour de pg_repack, et pourquoi nous n'avons pas simplement utilisé ses alternatives ? À un moment donné, nous avons également pensé à cela, mais notre expérience positive antérieure avec celui-ci, sur des tables sans contraintes différées, nous a motivés à essayer de comprendre la nature du problème et à le corriger. De plus, l'utilisation d'autres solutions nécessite également du temps pour effectuer des tests, c'est pourquoi nous avons décidé d'abord d'essayer de résoudre le problème en lui-même, et si nous comprenons que nous ne pourrons pas le faire dans un délai raisonnable, alors nous commencerons à considérer des alternatives.
Conclusions
Ce que nous pouvons recommander sur la base de notre propre expérience :
- Surveillez votre bloat. Sur la base des données de surveillance, vous pourrez évaluer la bonne configuration de l'autovacuum.
- Configurez l'AUTOVACUUM pour maintenir le bloat à un niveau acceptable.
- Si malgré tout le bloat augmente et que vous ne pouvez pas le maîtriser avec des outils ‘out of the box’, n'hésitez pas à utiliser des extensions externes. L'essentiel est de bien les tester.
- N'ayez pas peur d'adapter des solutions externes à vos besoins - cela peut parfois être plus efficace et même plus simple que de modifier votre propre code.
Source : habr.com
