

Excellente fin de semaine à tous ! Il reste de moins en moins de temps avant le lancement du cours. , c'est pourquoi aujourd'hui nous partageons la traduction d'un autre matériel utile sur le sujet.
En cours de développement un travail impressionnant a été réalisé pour améliorer le partitionnement des tables. Partitionnement des tables — c'est une fonctionnalité qui existe dans PostgreSQL depuis suffisamment longtemps, mais qui, pour ainsi dire, n'était pas vraiment présente avant la version 10, où elle est devenue une fonctionnalité très utile. Auparavant, nous avions déclaré que l'héritage des tables était notre mise en œuvre du partitionnement, et c'est vrai. Cependant, cette méthode vous obligeait à faire une grande partie du travail manuellement. Par exemple, si vous vouliez que les tuples soient insérés dans les sections pendant les INSERT, vous deviez configurer des déclencheurs pour le faire pour vous. Le partitionnement par héritage était très lent et difficile à développer pour ajouter des fonctionnalités supplémentaires.
Dans PostgreSQL 10, nous avons vu naître le "partitionnement déclaratif" — une fonctionnalité destinée à résoudre de nombreux problèmes qui étaient insolubles avec l'ancienne méthode d'héritage. Cela a conduit à l'émergence d'un outil beaucoup plus puissant permettant de diviser les données horizontalement !
Comparaison des fonctionnalités
Dans PostgreSQL 11, un ensemble impressionnant de nouvelles fonctionnalités est apparu, qui aide à améliorer les performances et à rendre les tables partitionnées plus transparentes pour les applications.
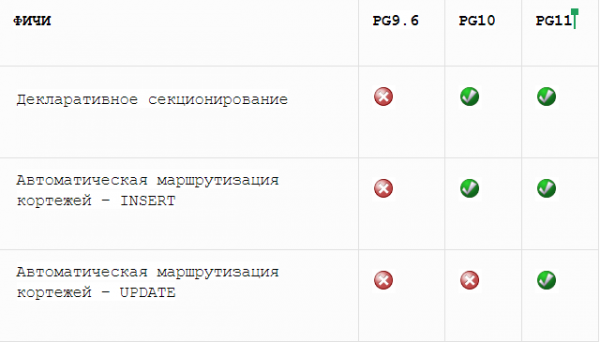
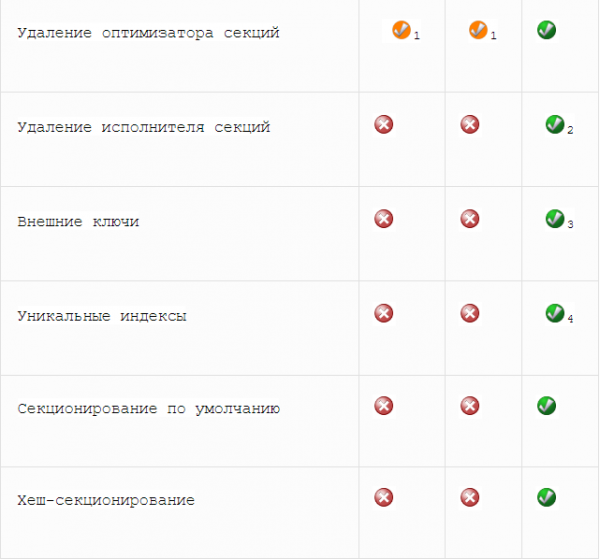
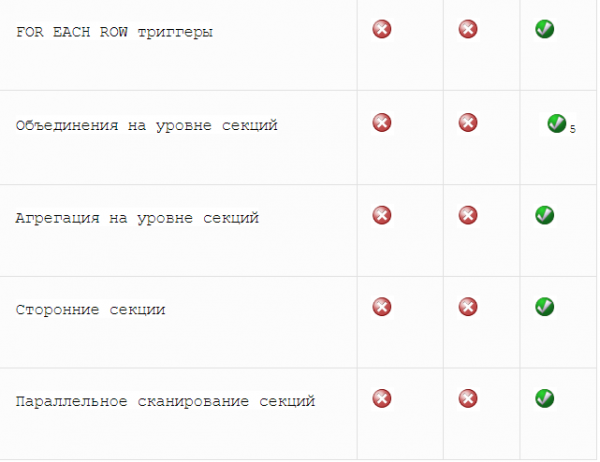
1. Utilisation d'exceptions de contrainte
2. Ajoute uniquement des nœuds
3. Seulement pour des tables partitionnées, faisant référence à une non-partitionnée
4. Les index doivent contenir toutes les colonnes clés de la section
5. Les contraintes sur les sections des deux côtés doivent correspondre
Performance
Ici, nous avons également de bonnes nouvelles ! Une nouvelle méthode a été ajoutée . Cet nouvel algorithme peut déterminer les sections appropriées en parcourant la condition de la requête OÙ. L'algorithme précédent, quant à lui, vérifiait chaque section pour déterminer si elle pouvait répondre à la condition OÙ. Cela entraînait une augmentation supplémentaire du temps de planification à mesure que le nombre de sections augmentait.
Dans la version 9.6, avec le partitionnement basé sur l'héritage, le routage des tuples dans les sections s'effectuait généralement en écrivant une fonction déclencheur contenant une série d'opérateurs IF pour insérer le tuple dans la bonne section. Ces fonctions pouvaient être très lentes à exécuter. Avec le partitionnement déclaratif ajouté dans la version 10, cela fonctionne désormais beaucoup plus rapidement.
En utilisant une table partitionnée avec 100 sections, nous pouvons évaluer les performances du chargement de 10 millions de lignes dans une table avec 1 colonne BIGINT et 5 colonnes INT.
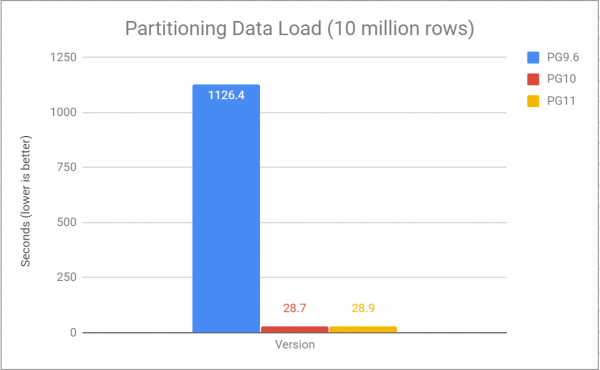
Les performances de la requête sur cette table pour rechercher un enregistrement indexé et effectuer des DML pour manipuler un enregistrement (en utilisant uniquement 1 processeur) :
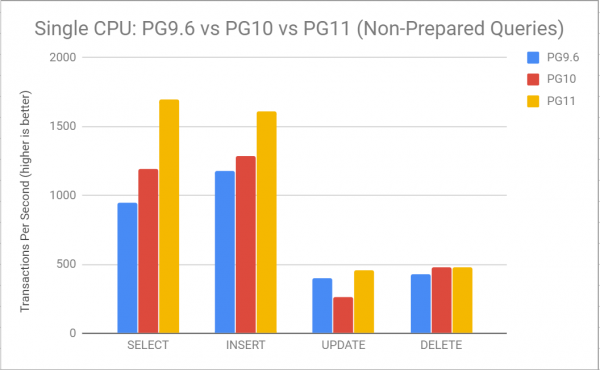
Ici, nous voyons que les performances de chaque opération ont considérablement augmenté après PG 9.6. Les requêtes SELECT sont beaucoup meilleures, en particulier celles capables d'exclure de nombreuses sections lors de la planification des requêtes. Cela signifie que le planificateur peut éviter une grande partie du travail qu'il devait effectuer auparavant. Par exemple, il n'est plus nécessaire de construire des chemins pour les sections inutiles.
Conclusion
Le partitionnement de tables devient une fonctionnalité très puissante dans PostgreSQL. Il permet de fournir rapidement des données en ligne et de les transférer hors ligne, sans attendre la fin d'opérations DML massives et lentes.Cela signifie également que les données connexes peuvent être stockées ensemble, ce qui permet d'accéder aux données nécessaires de manière beaucoup plus efficace. Les améliorations apportées dans cette version n'auraient pas été possibles sans les développeurs, évaluateurs et commetteurs qui ont travaillé sans relâche sur toutes ces fonctionnalités.
Merci à eux tous ! PostgreSQL 11 a l'air tout simplement fantastique !
Voici un article court, mais plutôt intéressant. N'hésitez pas à partager vos commentaires, et n'oubliez pas de vous inscrire à , dans le cadre duquel le programme du cours sera détaillé.
Source : habr.com
