

— un mécanisme très puissant et pratique, si les mêmes opérations sont effectuées «en profondeur» sur des données liées. Mais la récursion incontrôlée est maléfique, car elle peut mener soit à une exécution infinie du processus, soit (ce qui arrive plus souvent) à «l'épuisement» de toute la mémoire disponible.
Les SGBD fonctionnent selon les mêmes principes — "ils m'ont dit de creuser, je creuse". Votre requête peut non seulement ralentir les processus voisins en occupant constamment les ressources du processeur, mais aussi «faire tomber» toute la base de données, en «avalant» toute la mémoire disponible. Par conséquent, la protection contre la récursion infinie est la responsabilité du développeur lui-même.
Avec PostgreSQL, la possibilité d'utiliser des requêtes récursives via est apparue à des temps immémoriaux depuis la version 8.4, mais il est encore courant de rencontrer des requêtes «sans défense» potentiellement vulnérables. Comment se prémunir contre ce genre de problèmes ?
Ne pas écrire de requêtes récursives
Mais écrire des requêtes non récursives. Cordialement, Votre C.O.
En réalité, PostgreSQL offre une quantité suffisante de fonctionnalités qui peuvent être exploitées pour ne appliquer la récursion.
Utiliser une approche fondamentalement différente du problème
Parfois, il suffit de regarder le problème «sous un autre angle». Un exemple de cette situation a été abordé dans l'article — la multiplication d'un ensemble de nombres sans utiliser de fonctions d'agrégation personnalisées :
WITH RECURSIVE src AS (
  SELECT '{2,3,5,7,11,13,17,19}'::integer[] arr
)
, T(i, val) AS (
  SELECT
    1::bigint
  , 1
UNION ALL
  SELECT
    i + 1
  , val * arr[i]
  FROM
    T
  , src
  WHERE
    i <= array_length(arr, 1)
)
SELECT
  val
FROM
  T
ORDER BY -- sélection du résultat final
  i DESC
LIMIT 1;
Une telle requête peut être remplacée par celle des connaisseurs en mathématiques :
WITH src AS (
  SELECT unnest('{2,3,5,7,11,13,17,19}'::integer[]) prime
)
SELECT
  exp(sum(ln(prime)))::integer val
FROM
  src;
Utiliser generate_series au lieu de boucles
Supposons que nous devons générer tous les préfixes possibles pour la chaîne 'abcdefgh':
WITH RECURSIVE T AS (
  SELECT 'abcdefgh' str
UNION ALL
  SELECT
    substr(str, 1, length(str) - 1)
  FROM
    T
  WHERE
    length(str) > 1
)
TABLE T;
Est-ce vraiment nécessaire d'utiliser la récursion ici ? Si nous utilisons LATERAL et generate_series, alors même pas besoin de CTE :
SELECT
  substr(str, 1, ln) str
FROM
  (VALUES('abcdefgh')) T(str)
, LATERAL(
    SELECT generate_series(length(str), 1, -1) ln
  ) X;
Changer la structure de la BDD
Par exemple, vous avez une table de messages de forum avec des relations sur qui a répondu à qui ou un fil dans :
CRÉER TABLE message(
  message_id
    uuid
      CLÉ PRIMAIRE
, reply_to
    uuid
      RÉFÉRENCES message
, body
    text
);
CRÉER INDEX SUR message(reply_to); 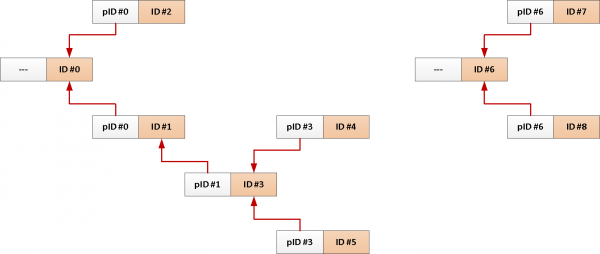
Voici un exemple de requête type pour charger tous les messages sur un même sujet :
AVEC RÉCURSIF T COMME (
  SÉLECTIONNER
    *
  DE
    message
  OÙ
    message_id = $1
UNION TOUT
  SÉLECTIONNER
    m.*
  DE
    T
  REJOINDRE
    message m
      ON m.reply_to = T.message_id
)
TABLE T;
Étant donné que nous avons toujours besoin de tous les messages associés au message racine, pourquoi ne pas ajouter son identifiant à chaque enregistrement automatiquement ?
-- ajoutons un champ pour l'identifiant commun du sujet et un index dessus
ALTER TABLE message
  AJOUTER COLONNE theme_id uuid;
CRÉER INDEX SUR message(theme_id);

-- initialiser l'identifiant du sujet dans le déclencheur lors de l'insertion
CRÉER OU REMPLACER FONCTION ins() RENVOIE TRIGGER AS $$
DÉBUT
  NOUVEAU.theme_id = CAS
    QUAND NOUVEAU.reply_to EST NULL ALORS NOUVEAU.message_id -- prenons depuis l'événement de départ
    SINON ( -- ou depuis le message auquel nous répondons
      SÉLECTIONNER
        theme_id
      DE
        message
      OÙ
        message_id = NOUVEAU.reply_to
    )
  FIN;
  RETOURNER NOUVEAU;
FIN;
$$ LANGUE plpgsql;

CRÉER DÉCLENCHEUR ins AVANT INSERTION
  SUR message
    POUR CHAQUE LIGNE
EXÉCUTER PROCÉDURE ins(); 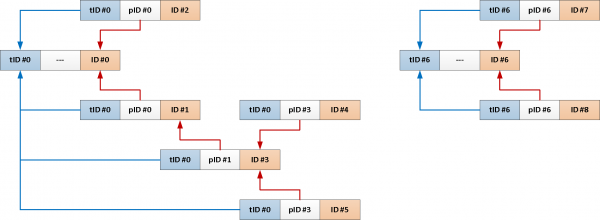
Notre requête récursive se réduit donc à ceci :
SÉLECTIONNER
  *
DE
  message
OÙ
  theme_id = $1;
Utiliser des « limites » applicatives
Si nous ne sommes pas en mesure de modifier la structure de la base de données pour diverses raisons, examinons ce sur quoi nous pouvons nous appuyer pour éviter qu'une erreur dans les données n'entraîne une exécution récursive infinie.
Compteur de « profondeur » de récursion
Il suffit d'augmenter le compteur de un à chaque étape de la récursion jusqu'à atteindre une limite que nous considérons manifestement inappropriée :
AVEC RÉCURSIF T COMME (
  SÉLECTIONNER
    0 i
  ...
UNION TOUT
  SÉLECTIONNER
    i + 1
  ...
  OÙ
    T.i < 64 -- limite
)
Pour : En cas de boucle infinie, nous ne ferons pas plus que la limite d'itérations « en profondeur » spécifiée.
Contre : Il n'y a aucune garantie que nous ne traiterons pas plusieurs fois le même enregistrement — par exemple, à la profondeur 15 et 25, et ainsi de suite chaque +10. De plus, personne ne garantit quoi que ce soit pour le « large ».
Formellement, cette récursion ne sera pas infinie, mais si à chaque étape, le nombre d'enregistrements augmente exponentiellement, nous savons tous comment cela finit…
Gardien du « chemin »
Nous enregistrons successivement tous les identifiants d'objets rencontrés sur notre chemin de récursion dans un tableau qui représente le « chemin » unique jusqu'à celui-ci :
AVEC RÉCURSIF T COMME (
  SÉLECTIONNER
    ARRAY[id] chemin
  ...
UNION TOUT
  SÉLECTIONNER
    chemin || id
  ...
  OÙ
    id  TOUS(T.chemin) -- ne correspond à aucun de
)
Pour : S'il y a un cycle dans les données, nous ne traiterons absolument pas la même entrée plusieurs fois dans le même chemin.
Contre : Mais en même temps, nous pouvons parcourir, littéralement, toutes les entrées sans jamais nous répéter.
Limite de la longueur du chemin
Pour éviter la situation de « errance » de la récursion à une profondeur indéterminée, nous pouvons combiner les deux méthodes précédentes. Ou, si nous ne souhaitons pas conserver des champs supplémentaires, compléter la condition de continuation de la récursion par une évaluation de la longueur du chemin :
WITH RECURSIVE T AS (
  SELECT
    ARRAY[id] path
  ...
UNION ALL
  SELECT
    path || id
  ...
  WHERE
    id  ALL(T.path) AND
    array_length(T.path, 1) < 10
)
Choisissez la méthode qui vous plaît !
Source : habr.com
