

En SQL, vous décrivez « ce » que vous souhaitez obtenir, plutôt que « comment » cela doit être exécuté. Ainsi, le problème de développer des requêtes SQL « telles qu'elles sont entendues » prend une place particulière, au même titre que .
Aujourd'hui, à travers des exemples très simples, voyons à quoi cela peut conduire dans le contexte de l'utilisation de GROUP/DISTINCT et LIMIT avec eux.
Imaginez que vous ayez écrit dans la requête « d'abord, combinez ces tables, puis supprimez tous les doublons, il ne devrait rester qu'un seul exemplaire par clé » — c'est exactement ainsi que cela fonctionnera, même si la jointure n'était pas nécessaire.
Et parfois, c'est de la chance et cela « fonctionne simplement », parfois cela a un impact désagréable sur les performances, et parfois cela donne des effets absolument inattendus du point de vue du développeur.
Eh bien, peut-être pas si spectaculaires, mais...
« Le couple parfait » : JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
C'est assez évident que l'on voulait sélectionner des enregistrements X pour lesquels il existe des enregistrements Y associés remplissant la condition en cours. Nous avons écrit une requête à travers JOIN — avons obtenu certaines valeurs pk plusieurs fois (juste autant que le nombre d'enregistrements correspondants dans Y). Comment éliminer cela ? Bien sûr DISTINCT!
C'est particulièrement « réjouissant » quand pour chaque enregistrement X, on trouve plusieurs centaines d'enregistrements Y associés, et qu'ensuite on élimine héroïquement les doublons...
Comment corriger cela ? Pour commencer, il faut réaliser que la tâche peut être modifiée en « sélectionner des enregistrements X pour lesquels il y a AU MOINS UN enregistrement Y associé remplissant la condition » — puisque nous n'avons rien besoin de l'enregistrement Y lui-même.
EXISTS imbriqué
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Certaines versions de PostgreSQL comprennent qu'il suffit de trouver le premier enregistrement trouvé dans EXISTS, les versions plus anciennes, non. C'est pourquoi je préfère toujours indiquer LIMIT 1 à l'intérieur soient « vrais », mais.
JOINTURE LATERALE
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Cette même option permet, si nécessaire, de renvoyer instantanément certaines données de l'enregistrement Y associé trouvé. Une option similaire a été examinée dans l'article .
« Pourquoi payer plus » : DISTINCT [ON] + LIMIT 1
Un avantage supplémentaire de ces transformations de requête est la possibilité de limiter facilement le parcours des enregistrements, si vous n'en avez besoin que d'un ou de plusieurs, comme dans le cas suivant :
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Maintenant, lisons la requête et essayons de comprendre ce que la base de données est censée faire :
- nous lions les tables
- nous unique à X.pk
- parmi les enregistrements restants, nous en choisissons un
Alors qu'avons-nous obtenu ? «Un enregistrement» parmi les unique — et si nous prenons celui-ci parmi les non-uniques, le résultat changera-t-il ?.. «Et s'il n'y a pas de différence, pourquoi payer plus ?»
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- ici, vous pouvez insérer des conditions appropriées
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Et un sujet tout aussi valable avec GROUP BY + LIMIT 1.
«Je ne veux que demander» : GROUP implicite + LIMIT
Des choses similaires se rencontrent lors de différentes vérifications de non-vacuité de table ou CTE pendant l'exécution de la requête :
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Les fonctions agrégées (count/min/max/sum/...) s'exécutent avec succès sur tout l'ensemble, même sans indication explicite et ne doit pas contenir. Mais avec LIMIT elles ne s'entendent pas très bien.
Le développeur peut penser «si des enregistrements existent, il ne me faut pas plus de LIMIT». Mais il ne faut pas faire cela ! Parce que pour la base, c'est :
- comptez ce qu'ils veulent renvoyez autant de lignes que demandé
- Selon les conditions cibles, il serait approprié d'effectuer l'un des remplacements :
(count + LIMIT 1) = 0
NOT EXISTS(LIMIT 1)sur(count + LIMIT 1) > 0EXISTS(LIMIT 1)surcount >= N(SELECT count(*) FROM (... LIMIT N))sur«Combien peser en grammes» : DISTINCT + LIMIT
SELECT DISTINCT pk FROM X LIMIT $1
Un développeur naïf pourrait sincèrement penser que l'exécution de la requête s'arrêtera,dès que nous trouvons les $1 premières valeurs différentes qui se présentent À l'avenir, cela pourrait fonctionner grâce à un nouveau nœud.
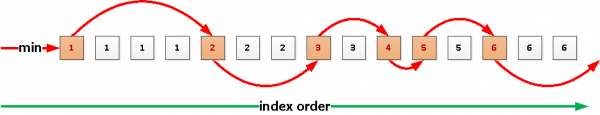
Index Skip Scan , dont la mise en œuvre est actuellement en cours, mais pour l'instant — ce n'est pas le cas.Pour l'instant, d'abord
tous les enregistrements seront extraits , uniques, et seulement à partir de ceux-ci, le nombre demandé sera retourné. C'est particulièrement triste lorsque nous voulions quelque chose comme, mais il y avait des dizaines de milliers d'enregistrements dans la table... $1 = 4Pour ne pas pleurer pour rien, utilisons la requête récursive
«DISTINCT pour les pauvres» de PostgreSQL Wiki :
Source : habr.com
