

Aujourd'hui, il n'y aura aucun cas compliqué ni d'algorithmes complexes en SQL. Tout sera très simple, au niveau de Capitaine Évidence — faisons. la consultation du journal des événements en triant par date.
Donc, voici une table dans la base de données events, et elle a un champ ts — exactement l'heure à laquelle nous voulons afficher ces enregistrements de manière ordonnée :
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
Il est clair que nous aurons là-bas plus d'une dizaine d'enregistrements, donc nous aurons besoin d'une sorte de pagination.
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
Ce n'est même pas une blague — c'est rare, mais ça arrive dans la nature. Parfois, après avoir travaillé avec un ORM, il peut être difficile de revenir à un travail "direct" avec SQL.
Mais passons à des problèmes plus courants et moins évidents.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - enregistrements par page, $1 - début de la page
D'où vient ce nombre 26 ? C'est le nombre approximatif d'enregistrements pour remplir un écran. Plus précisément, 25 enregistrements affichés, plus 1, signalant qu'il y a encore quelque chose dans le résultat et qu'il serait judicieux de continuer.
Bien sûr, cette valeur peut ne pas être "encodée" dans le corps de la requête, mais être transmise en tant que paramètre. Mais dans ce cas, le planificateur PostgreSQL ne pourra pas se baser sur la connaissance qu'il devrait y avoir relativement peu d'enregistrements, et optera facilement pour un plan inefficace.
Et tant que dans l'interface de l'application, la consultation du journal des événements est réalisée comme une navigation entre "pages" visuelles, personne ne remarque rien de suspect pendant longtemps. Juste jusqu'à ce que, dans la lutte pour le confort UI/UX, on décide de transformer l'interface en "scroll infini" — c'est-à-dire que tous les enregistrements du journal s'affichent dans une liste continue que l'utilisateur peut faire défiler vers le haut ou vers le bas.
Et là, lors d'un nouveau test, vous êtes pris sur la duplication des enregistrements dans le journal. Pourquoi, alors qu'il existe un bon index sur la table (ts), que votre requête utilise?
C'est précisément parce que vous n'avez pas pris en compte que ts n'est pas une clé unique dans cette table. En fait, les valeurs ne sont pas uniques., comme pour tout «temps» dans des conditions réelles — c'est pourquoi la même entrée dans deux requêtes voisines peut facilement «sauter» d'une page à l'autre en raison d'un autre ordre final dans le cadre du tri de la même valeur clé.
En réalité, il y a aussi un deuxième problème, qui est beaucoup plus difficile à détecter — certaines entrées ne seront pas du tout affichées ! En effet, les entrées «dupliquées» ont pris la place de quelqu'un d'autre. Une explication détaillée avec de belles images peut être Élargissons l'index .
Un développeur astucieux comprend — il faut rendre la clé de l'index unique, et le moyen le plus simple est de l'élargir avec un champ d'ores et déjà unique qui convient parfaitement comme PK :
CREATE UNIQUE INDEX ON events(ts DESC, id DESC);
Et la requête mute :SELECT ... ORDER BY ts DESC, id DESC LIMIT 26 OFFSET $1;
Un certain temps plus tard, votre DBA arrive et "se réjouit" que vos requêtes#2. Переход на «курсоры»
chargent le serveur avec leurs OFFSET exorbitants la navigation à partir de la dernière valeur affichée . Votre requête mute à nouveau :SELECT ... WHERE (ts, id) < ($1, $2) -- les dernières valeurs reçues lors de l'étape précédente ORDER BY ts DESC, id DESC LIMIT 26;
Vous avez soupiré de soulagement, jusqu'à ce que survienne…Parce qu'un jour, votre DBA a lu
#3. Чистка индексов
un article sur la recherche d'index inefficaces un timestamp «non dernier» — ce n’est pas bon . Et il est revenu vous voir — cette fois avec l'idée que cet index devrait tout de même redevenir(ts DESC) Mais que faire avec le problème initial de «saut» d'entrées entre les pages ?.. Tout est simple — il faut choisir des blocs avec un nombre d'entrées non fixe !.
En vérité, qui nous interdit de lire «pas exactement 26», mais «au moins 26» ? Par exemple, afin que dans le bloc suivant se retrouvent
des entrées avec des valeurs manifestement différentes — alors il n'y aurait pas de problème de «saut» d'entrées entre les blocs ! ts Voici comment y parvenir :
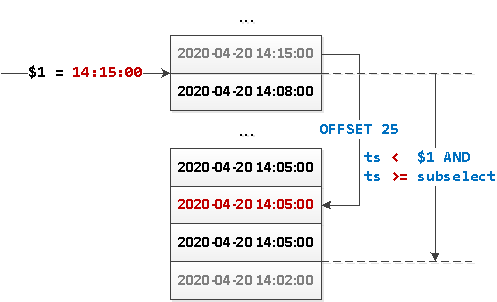
SELECT ... WHERE ts = coalesce(( SELECT ts FROM events WHERE ts < $1 ORDER BY ts DESC LIMIT 1 OFFSET 25 ), '-infinity') ORDER BY ts DESC;
Que se passe-t-il ici en fait ?On descend de 25 entrées et on obtient la valeur «limite»
- S'il n'y a plus rien, on remplace la valeur NULL par
ts. - -infinity
On soustrait tout le segment de valeurs entre la valeur obtenue. - et le paramètre $1 transmis depuis l'interface (la précédente valeur «dernière» affichée).
tsи переданным из интерфейса параметром $1 (предыдущим «последним» отрисованным значением). - Si un bloc revient avec moins de 26 enregistrements, c'est le dernier.
Ou la même chose en image :
Puisque nous avons maintenant un échantillon qui n'a pas de « début » défini, rien ne nous empêche donc de « dérouler » cette requête dans l'autre sens et de mettre en œuvre un chargement dynamique des blocs de données depuis un « point d'ancrage » dans les deux sens — à la fois vers le bas et vers le haut.
Remarque
- Oui, dans ce cas, nous accédons à l'index deux fois, mais tout « proprement par l'index ». Donc, la requête imbriquée ne produira qu'un seul Index Only Scan supplémentaire.
- Il est assez évident que cette méthode ne peut être utilisée que lorsque vos valeurs
tspeuvent ne se croiser que par hasard, et qu'elles sont peu nombreuses. Cependant, si votre cas typique est « un million d'enregistrements à 00:00:00.000 », ce n'est pas à faire. En d'autres termes, il vaut mieux ne pas permettre un tel cas. Mais si c'est le cas, utilisez l'option avec l'index étendu.
Source : habr.com
