

Il arrive régulièrement que le développeur ait besoin de transmettre au requête un ensemble de paramètres ou même un échantillon entier en entrée. Parfois, des solutions très étranges à ce problème apparaissent.
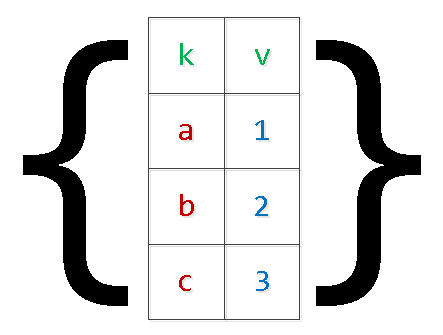
Adoptons une approche « à l'envers » et voyons ce qu'il ne faut pas faire, pourquoi cela et comment faire mieux.
L'insertion directe de valeurs dans le corps de la requête
ressemble généralement à ceci :
query = "SELECT * FROM tbl WHERE id = " + value… ou comme ceci :
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)Pour ce mode, il existe suffisamment de choses dites, écrites et :
Presque toujours, cela mène à un chemin direct vers des injections SQL et une charge excessive sur la logique métier, qui doit « coller » la chaîne de votre requête.
Cet approche n'est en partie justifiée que dans le cas où il est nécessaire d'utiliser le partitionnement dans les versions PostgreSQL 10 et inférieures pour obtenir un plan plus efficace. Dans ces versions, la liste des sections à scanner est déterminée sans tenir compte des paramètres transmis, uniquement en fonction du corps de la requête.
$n-arguments
Utilisation des paramètres — c'est bien, cela permet d'utiliser , réduisant la charge tant sur la logique métier (la chaîne de requête est formée et transmise une seule fois) que sur le serveur de base de données (il n'est pas nécessaire de reparser et de planifier pour chaque instance de la requête).
Un nombre variable d'arguments
Des problèmes nous attendront lorsque nous voudrons transmettre un nombre d'arguments inconnu à l'avance :
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Si nous laissons la requête sous cette forme, cela nous protègera des injections potentielles, mais entraînera néanmoins la nécessité de coller/analyser la requête pour chaque variante selon le nombre d'arguments.C'est déjà mieux que de le faire chaque fois, mais nous pourrions nous en passer.
Il suffit de transmettre un seul paramètre contenant une représentation sérialisée de tableau:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'La seule différence est la nécessité de convertir explicitement l'argument au type de tableau requis. Mais cela ne pose pas de problème, car nous savons déjà où nous nous dirigeons.
Transmission d'un échantillon (matrice)
C'est généralement des variantes de transmission d'ensembles de données pour insertion dans la base « en une seule requête » :
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...En plus des problèmes mentionnés ci-dessus d'« assemblage » de requête, cela peut également nous conduire à out of memory et la chute du serveur. La raison est simple : pour les arguments PG, la mémoire supplémentaire est réservée, tandis que le nombre d'enregistrements dans l'ensemble est limité uniquement par les souhaits applicatifs de la logique métier. Dans des cas particulièrement extrêmes, j'ai dû constater que les arguments « numérotés » surpassent 9000 $ — ne faites pas ça.
Réécrivons la requête en appliquant déjà une « sérialisation à deux niveaux »:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Oui, dans le cas de valeurs « complexes » à l'intérieur du tableau, elles doivent être entourées de guillemets.
Il est évident qu'avec cette méthode, on peut « déplier » une sélection avec un nombre arbitraire de champs.
unnest, unnest, …
De temps en temps, on rencontre des variantes qui consistent à transmettre plutôt que « un tableau de tableaux » plusieurs « tableaux de colonnes », dont j'ai parlé :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Avec cette méthode, en se trompant dans la génération de listes de valeurs pour différentes colonnes, il est très facile d'obtenir des résultats totalement inattendus, qui dépendent en outre de la version du serveur :
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
À partir de la version 9.3, PostgreSQL a introduit des fonctions complètes pour travailler avec le type json. Donc, si vous définissez les paramètres d'entrée dans le navigateur, vous pouvez directement y former un objet json pour la requête SQL:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Pour les versions précédentes, cette même méthode peut être utilisée pour each(hstore), mais un « repli correct » avec l'échappement d'objets complexes dans hstore peut causer des problèmes.
json_populate_recordset
Si vous savez à l'avance que les données provenant du tableau json « d'entrée » iront pour alimenter une certaine table, vous pouvez économiser considérablement sur le « déreferencement » des champs et leur conversion aux types nécessaires, en utilisant la fonction json_populate_recordset :
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
Et cette fonction « dépliera » simplement le tableau d'objets fourni dans une sélection, sans se fier au format de la table :
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
TABLE TEMPORAIRE
Mais si le volume de données dans la sélection transmise est très grand, alors le placer dans un seul paramètre sérialisé est lourd, et parfois même impossible, car cela nécessite une allocation unique d'un grand volume de mémoirePar exemple, vous devez collecter de manière prolongée un grand ensemble de données d'événements depuis un système externe, puis vous souhaitez les traiter d'un coup côté base de données.
Dans ce cas, la meilleure solution consiste à utiliser :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- répéter de nombreuses fois
...
-- ici, nous faisons quelque chose d'utile avec l'ensemble de cette table
Cette méthode est particulièrement pour le transfert occasionnel de gros volumes des données.
En ce qui concerne la description de la structure de vos données, une table temporaire ne se différencie d'une "normale" que par un seul critère dans la table système pg_class, et dans pg_type, pg_depend, pg_attribute, pg_attrdef, … — il n'est pas vraiment différent.
Ainsi, dans les systèmes web ayant un grand nombre de connexions de courte durée, pour chacune d'elles, une telle table générera de nouveaux enregistrements système à chaque fois, qui sont supprimés lorsque la connexion à la base de données est fermée. En conséquence, une utilisation non contrôlée de la TEMP TABLE entraîne un "gonflement" des tables dans pg_catalog et ralentit de nombreuses opérations qui les utilisent.
Bien sûr, cela peut être combattu avec l'aide de passages périodiques de VACUUM FULL à travers les tables du catalogue système.
Variables de session
Supposons que le traitement des données du cas précédent soit suffisamment complexe pour une seule requête SQL, mais que nous souhaitions le faire assez souvent. C'est-à-dire que nous voulons utiliser un traitement procédural dans , mais utiliser le passage de données via des tables temporaires serait trop coûteux.
Utiliser des paramètres $n pour les passer dans un bloc anonyme ne sera pas non plus possible. Pour cela, les variables de session et la fonction current_setting.
Jusqu'à la version 9.2, il était nécessaire de configurer au préalable custom_variable_classes pour les "propres" variables de session. Dans les versions actuelles, on peut écrire à peu près comme ceci :
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
Dans d'autres langages procéduraux supportés, on peut trouver d'autres solutions.
Vous connaissez d'autres méthodes ? Partagez-les dans les commentaires !
Source : habr.com
