

Des milliers de managers des bureaux de vente à travers le pays enregistrent dans dix mille contacts chaque jour — des faits de communication avec des clients potentiels ou déjà en relation avec nous. Pour cela, il faut d'abord trouver ce client, et de préférence très rapidement. Cela se fait le plus souvent par le nom.
Il n'est donc pas surprenant qu'en examinant encore une fois les requêtes "lourdes" sur l'une des bases de données les plus sollicitées — notre propre , j'ai trouvé "en tête" une requête pour la recherche "rapide" par nom pour les fiches d'organisations.
De plus, une enquête plus approfondie a révélé un exemple intéressant d'abord d'optimisation, puis de dégradation des performances de la requête lors de son développement successif par plusieurs équipes, chacune agissant uniquement avec les meilleures intentions.
0 : que voulait l'utilisateur
 [KDPV ]
Que signifie généralement un "search rapide" par nom pour l'utilisateur ? Cela ne se traduit presque jamais par une véritable recherche par sous-chaîne, comme ... LIKE '%rose%' — car alors les résultats incluraient non seulement 'Roselie' et 'Magasin Rose', mais aussi 'Grose' et même 'Maison de Grands-Morose'.
L'utilisateur sous-entend, à un niveau pratique, que vous lui fournirez une recherche par le début du mot dans le nom et montrerez plus pertinent ce qui commence par ce qui a été saisi. Et vous le ferez pratiquement instantanément — lors de la saisie par sous-chaîne.
1 : limitons la tâche
Et encore moins, l'utilisateur ne saisira spécifiquement pas 'rose magasin', pour que chaque mot nécessite une recherche de préfixe. Non, il est beaucoup plus simple pour l'utilisateur de réagir à la suggestion rapide pour le dernier mot, plutôt que de "ne pas finir" les précédents — regardez comment cela fonctionne avec n'importe quel moteur de recherche.
En général, bien formuler les exigences de la tâche — c'est plus de la moitié de la solution. Parfois, une analyse attentive d'un use case .
Que fait donc le développeur abstrait ?
1.0 : moteur de recherche externe
Oh, la recherche c'est compliqué, je n'ai vraiment pas envie de m'en occuper — donnons cela à devops ! Qu'ils nous déploient un système de recherche externe relativement à BD : Sphinx, ElasticSearch,…
Une option fonctionnelle, bien que laborieuse en termes de synchronisation et d'efficacité des changements. Mais ce n'est pas notre cas, car la recherche est effectuée pour chaque client uniquement dans le cadre des données de son compte. Et les données sont suffisamment variables - si à l'instant un manager a ajouté une carte 'Magasin Rose', dans 5 à 10 secondes, il peut déjà se souvenir qu'il a oublié d'indiquer l'email et vouloir la retrouver et la corriger.
Donc, faisons une recherche « directement dans la base ». Heureusement, PostgreSQL nous permet de le faire, et pas d'une seule manière - nous allons les examiner.
1.1 : « sous-chaîne » honnête
Accrochons-nous au mot « sous-chaîne ». Car il existe un excellent ! Mais ensuite, il sera nécessaire de bien trier.
Essayons de prendre pour la simplicité de la modélisation une table comme celle-ci :
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
Nous y incorporons 7,8 millions d'enregistrements d'organisations réelles et nous indexons :
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Nous allons rechercher pour le premier sous-ensemble :
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'rose')
ORDER BY
  lower(name) ~ ('^' || 'rose') DESC -- en premier "ceux qui commencent par"
, lower(name) -- le reste par ordre alphabétique
LIMIT 10;
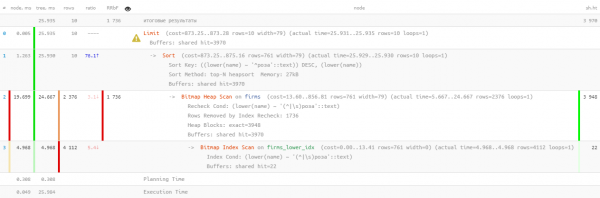
Eh bien, c'est… 26 ms, 31 Mo de données lues et plus de 1,7 K d'enregistrements filtrés - pour 10 recherchés. Les frais généraux sont trop élevés, ne peut-on pas faire plus efficacement ?
1.2 : recherche dans le texte ? c'est une FTS !
En effet, PostgreSQL offre un très puissant (Full Text Search), y compris la possibilité de recherche par préfixe. Une excellente option, il n'est même pas nécessaire d'installer des extensions ! Essayons :
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rose:*')
ORDER BY
lower(name) ~ ('^' || 'rose') DESC
, lower(name)
LIMIT 10; 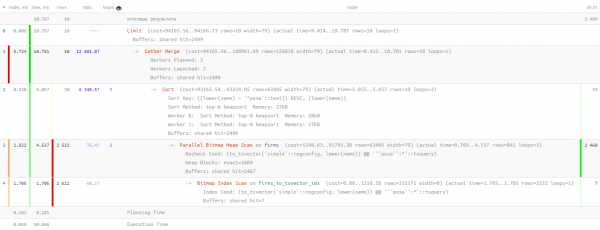
Ici, la parallélisation de l'exécution de la requête nous a un peu aidés, réduisant le temps de moitié à 11 ms. Et nous avons dû lire 1,5 fois moins - seulement 20 Mo. Là, moins c'est mieux, car plus nous lisons de volume, plus il y a de chances d'obtenir un cache miss, et chaque page de données lue de plus depuis le disque est un frein potentiel pour la requête.
1.3 : mais tout de même LIKE ?
La requête précédente est bonne, mais si elle est exécutée des centaines de milliers de fois par jour, cela s'accumulera déjà 2 To lectures de données. Au mieux, depuis la mémoire, mais si ça ne marche pas, depuis le disque. Alors, essayons de le rendre plus petit.
Rappelons que l'utilisateur souhaite voir d'abord «ceux qui commencent par ...». Après tout, c'est du pur à l'aide de text_pattern_ops! Et seulement si nous n'avons «pas assez» de 10 enregistrements recherchés, il faudra les lire avec une recherche FTS :
CREATE INDEX ON firms(lower(name) text_pattern_ops);SELECT
*
FROM
firms
WHERE
lower(name) LIKE ('rose' || '%')
LIMIT 10; 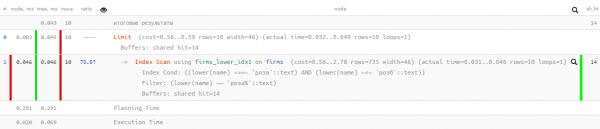
Excellentes performances — seulement 0.05ms et un peu plus de 100Ko lu ! Mais nous avons oublié le tri par nom, afin que l'utilisateur ne se perde pas dans les résultats :
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rose' || '%')
ORDER BY
  lower(name)
LIMIT 10; 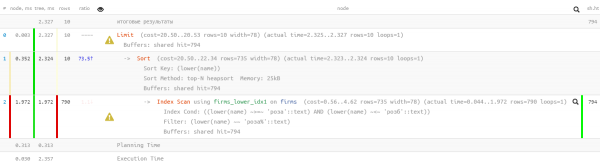
Oh, ce n'est déjà plus si beau — il semble qu'il y ait un index, mais le tri passe à côté... C'est déjà beaucoup plus efficace que l'option précédente, mais...
1.4 : «affiner à la main»
Mais il existe un index qui permet de faire des recherches par plage et de bien utiliser le tri — un btree ordinaire!
CREATE INDEX ON firms(lower(name));Cependant, la requête devra être «construite manuellement» :
SELECT
  *
FROM
  firms
WHERE
  lower(name) >= 'rose' AND
  lower(name) <= ('rose' || chr(65535)) -- pour UTF8, pour un octet - chr(255)
ORDER BY
   lower(name)
LIMIT 10; 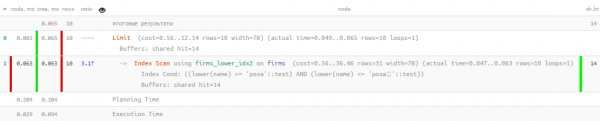
Parfait — le tri fonctionne et la consommation des ressources reste «microscopique» , mille fois plus efficace qu'un «FTS pur»! Il reste à rassembler en une seule requête :
(
  SELECT
    *
  FROM
    firms
  WHERE
    lower(name) >= 'rose' AND
    lower(name) <= ('rose' || chr(65535)) -- pour UTF8, pour les encodages à un octet - chr(255)
  ORDER BY
     lower(name)
  LIMIT 10
)
UNION ALL
(
  SELECT
    *
  FROM
    firms
  WHERE
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rose:*') AND
    lower(name) NOT LIKE ('rose' || '%') -- «commençant par» nous l'avons déjà trouvé ci-dessus
  ORDER BY
    lower(name) ~ ('^' || 'rose') DESC -- utilisons le même tri pour ne PAS utiliser l'index btree
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Je ferai remarquer que la deuxième sous-requête s'exécute uniquement si la première a retourné moins que prévu dernier LIMIT du nombre de lignes. J'ai déjà écrit à propos de cette méthode d'optimisation des requêtes .
Eh bien, nous avons maintenant à la fois btree et gin sur la table, mais statistiquement il s'avère que moins de 10 % des requêtes atteignent l'exécution du deuxième bloc. Cela signifie qu'avec ces contraintes typiques connues à l'avance pour la tâche, nous avons pu réduire la consommation totale des ressources du serveur presque de mille fois !
1.5* : nous ferons sans la lime
Au-dessus LIKE nous nous sommes heurtés à un mauvais tri. Mais on peut « le remettre sur le droit chemin » en utilisant l'opérateur USING :
Par défaut, cela implique
ASC. De plus, on peut spécifier le nom d'un opérateur de tri particulier dans la clauseUSING. L'opérateur de tri doit être un membre de la famille des opérateurs B-arbre « inférieur » ou « supérieur ».ASCgénéralement équivalent àUSING <etDESCgénéralement équivalent àUSING >.
Dans notre cas, « inférieur » signifie ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rose' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 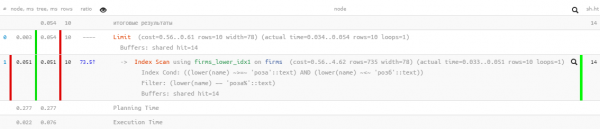
2: comment les requêtes « s’oxydent »
Maintenant, nous laissons notre requête « infuser » pendant six mois à un an, et nous découvrons avec étonnement qu'elle est à nouveau « en haut » avec des indicateurs cumulés de « stockage » de mémoire quotidienne (buffers shared hit) dans 5,5 To — c'est-à-dire encore plus que ce qu'il y avait au départ.
Non, bien sûr, notre entreprise a également progressé, et la charge a augmenté, mais pas à ce point ! Cela signifie qu'il y a quelque chose de louche ici — cherchons à comprendre.
2.1: la naissance du pagination
À un moment donné, une autre équipe de développeurs a voulu faire en sorte qu'à partir d'une recherche rapide en sous-texte, on puisse « sauter » vers le registre avec les mêmes résultats mais étendus. Et quel registre sans navigation par pages ? Enclenchons cela !
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Désormais, on pouvait afficher sans contrainte pour le développeur le registre des résultats de recherche avec un chargement « par pages ».
Bien sûr, en réalité, pour chaque page de données suivante, il faut lire de plus en plus (tout de la fois précédente que nous écartons, plus le « morceau » nécessaire) — ce qui est manifestement un antipattern. Et il aurait été préférable de démarrer la recherche à l'itération suivante à partir de la clé enregistrée dans l'interface, mais cela sera pour une autre fois.
2.2: envie d'exotisme
À un certain moment, le développeur a eu envie de diversifier l'échantillon résultant avec des données d'une autre table, ce qui a amené toute la requête précédente à être envoyée dans un CTE :
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- une requête vers la table liée
FROM
  q
LIMIT 10 OFFSET ;
Et même ainsi — pas mal, car la sous-requête est calculée seulement pour 10 enregistrements retournés, si ce n'était pour ...
2.3: DISTINCT, absurde et impitoyable
Au cours de ce processus d'évolution, dans le deuxième sous-requête a été perdu NOT LIKE la condition. On comprend que après cela, UNION ALL a commencé à retourner certaines entrées deux fois — d'abord trouvé par le début de la chaîne, puis à nouveau — par le début du premier mot de cette chaîne. En théorie, tous les enregistrements de la deuxième sous-requête pouvaient correspondre aux enregistrements de la première.
Que fait le développeur au lieu de rechercher la cause?.. Pas de problème!
- doublons la taille des échantillons originaux
- appliquons DISTINCT, afin d'obtenir uniquement un exemplaire de chaque ligne
WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Ainsi, il est clair que le résultat, au final, est exactement le même, mais la probabilité de « passer à côté » dans la 2ème sous-requête CTE a considérablement augmenté, et même sans cela, est clairement plus lisible.
Mais ce n'est pas le plus triste. Puisque le développeur a demandé de sélectionner DISTINCT non pas par des champs spécifiques, mais sur tous les champs les enregistrements, alors le champ sub_query — le résultat de la sous-requête — y est également automatiquement inclus. Maintenant, pour exécuter DISTINCT, la base a dû exécuter déjà pas 10 sous-requêtes, mais toutes + 10!
2.4 : la coopération avant tout !
C'est ainsi que les développeurs vivaient — pas de soucis, car dans le registre, « ajuster » à des valeurs significatives de N, avec un ralentissement chronique de l'obtention de chaque « page » suivante, le patience de l'utilisateur ne suffisait clairement pas.
Jusqu'à ce que des développeurs d'un autre département viennent les voir, et souhaitent utiliser cette méthode si pratique pour une recherche itérative — c'est-à-dire prendre un morceau d'un échantillon, filtrer par des conditions supplémentaires, afficher le résultat, puis le morceau suivant (ce que nous atteignons dans notre cas en augmentant N), et ainsi de suite jusqu'à ce que nous remplissions l'écran.
En général, dans l'exemple capturé N a atteint des valeurs proches de 17K, et au total, au cours de la journée, pas moins de 4K de ces requêtes ont été exécutées « en chaîne ». Les dernières d'entre elles scannaient déjà à 1 Go de mémoire à chaque itération…
Au total
Source : habr.com
