

Les caractéristiques du fonctionnement des mécanismes internes de PostgreSQL lui permettent d'être très rapide dans certaines situations et « pas tellement » dans d'autres. Aujourd'hui, nous allons nous concentrer sur un exemple classique de conflit entre le fonctionnement d'un SGBD et ce que fait le développeur avec. UPDATE vs principes MVCC.
Un résumé de :
Lorsqu'une ligne est modifiée par la commande UPDATE, ce sont en fait deux opérations qui s'exécutent : DELETE et INSERT. Dans la version actuelle de la ligne xmax est défini comme le numéro de la transaction qui a effectué l'UPDATE. Ensuite, une version est sortie nouvelle version de la même ligne est créée ; sa valeur xmin est identique à xmax de l'ancienne version.
Après un certain temps, une fois que cette transaction est terminée, l'ancienne ou la nouvelle version, selon le cas, sera considérée comme COMMIT/ROLLBACK, reconnue comme « tuples morts » (dead tuples) lors de l'itération VACUUM à travers la table et supprimée.
Mais cela ne se produira pas tout de suite, tandis que les problèmes avec les « morts » peuvent survenir très rapidement — lors de mises à jour multiples ou dans une grande table, et un peu plus tard, on peut se retrouver dans une situation où même .
#1: I Like To Move It
Supposons que votre méthode de logique métier fonctionne, et soudainement, vous réalisez qu'il faut mettre à jour le champ X dans un certain enregistrement :
UPDATE tbl SET X = WHERE pk = $1;Puis, au fil de l'exécution, il s'avère qu'il faut aussi mettre à jour le champ Y :
UPDATE tbl SET Y = WHERE pk = $1;… et puis aussi Z — pourquoi s'en priver ?
UPDATE tbl SET Z = WHERE pk = $1;Combien de versions de cet enregistrement avons-nous maintenant dans la base ? Ah, 4 ! D'entre elles, une est actuelle, et 3 devront être nettoyées par vous [auto]VACUUM.
Ne faites pas ça ! Utilisez la mise à jour de tous les champs dans une seule requête. — presque toujours, la logique de fonctionnement de la méthode peut être changée comme suit :
UPDATE tbl SET X = , Y = , Z = WHERE pk = $1;#2: Use IS DISTINCT FROM, Luke!
Ainsi, vous avez finalement décidé (lors de l'application d'un script ou d'un convertisseur, par exemple). Et le script contient quelque chose comme :
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2;Ce type de requête est assez fréquent et presque toujours pas pour remplir un nouveau champ vide, mais pour corriger des erreurs dans les données. Cependant, la validité des données existantes n'est absolument pas prise en compte — et c'est dommage ! Autrement dit, l'enregistrement est réécrit, même si ce qui s'y trouvait était exactement ce qu'il fallait — pourquoi faire ça ? Corrigeons :
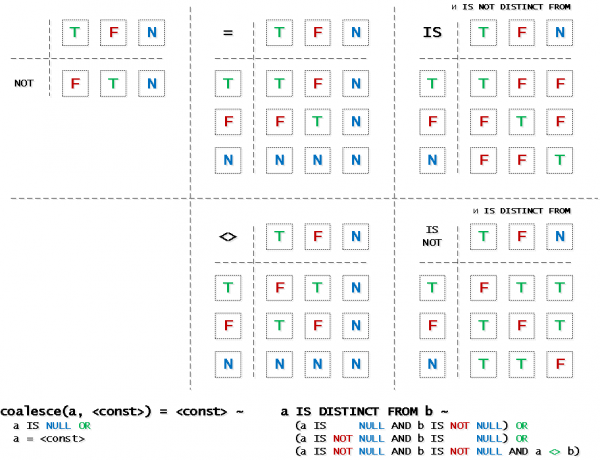
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2 AND X IS DISTINCT FROM ; Beaucoup ne sont pas au courant de l'existence d'un tel opérateur remarquable, voici donc une aide-mémoire à propos de IS DISTINCT FROM et d'autres opérateurs logiques en aide :
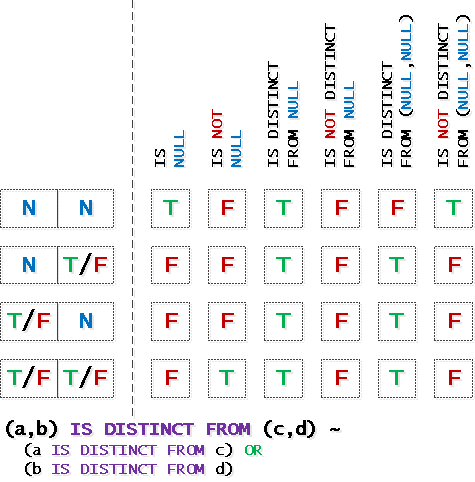
… et un peu sur les opérations sur des expressions complexes : ROW()-expressions :
#3: А я милого узнаю по… блокировке
Deux processus parallèles identiques sont lancés , chacun essayant de marquer l'enregistrement comme étant « en cours » :UPDATE tbl SET processing = TRUE WHERE pk = $1 ;
Même si ces processus effectuent des tâches indépendantes l'un de l'autre, dans le cadre d'un même ID, la deuxième requête sera « verrouillée » pendant que la première transaction se termine.Solution n°1
: le problème est réduit à ce qui précède.Ajoutons simplement à nouveau
UPDATE tbl SET processing = TRUE WHERE pk = $1 AND processing IS DISTINCT FROM TRUE ; IS DISTINCT FROM:
Ainsi, la deuxième requête ne changera rien dans la base, car tout est déjà « comme il faut » — il n'y aura donc pas de blocage. Ensuite, le fait de ne pas trouver l'enregistrement est géré dans l'algorithme applicatif.Solution n°2
: verrous consultatifsUn grand sujet pour un article à part entière, où l'on peut lire sur
les façons d'utilisation et les « pièges » des verrous recommandés .
: appels sans [b]serrerVous devez absolument avoir
un fonctionnement simultané sur le même enregistrement Les caractéristiques de fonctionnement des mécanismes internes de PostgreSQL lui permettent d'être très rapide dans certaines situations et « pas très » dans d'autres.? Или вы все-таки накосячили с алгоритмами вызовов бизнес-логики со стороны клиента, например? А если подумать?..
Source : habr.com
