

Nous continuons notre série d'articles consacrés à l'exploration de méthodes peu connues pour améliorer les performances des requêtes « apparemment simples » sur PostgreSQL :
Ne pensez pas que je n'aime pas tellement les JOIN… 🙂
Mais souvent, sans lui, la requête est sensiblement plus performante qu'avec lui. Aujourd'hui, nous allons donc essayer de nous débarrasser du JOIN gourmand en ressources — à l'aide d'un dictionnaire.
À partir de PostgreSQL 12, certaines des situations décrites ci-dessous peuvent se reproduire légèrement différemment en raison de . Ce comportement peut être restauré à l'ancien en spécifiant la clé
MATERIALIZED.
Beaucoup de « faits » sur un dictionnaire limité
Prenons une tâche d'application tout à fait réelle : il faut afficher la liste ou des tâches actives avec les expéditeurs :
25.01 | Ivanov I.I. | Préparer la description d'un nouvel algorithme.
22.01 | Ivanov I.I. | Écrire un article sur Habrahabr : la vie sans JOIN.
20.01 | Petrov P.P. | Aider à optimiser la requête.
18.01 | Ivanov I.I. | Écrire un article sur Habrahabr : JOIN en tenant compte de la répartition des données.
16.01 | Petrov P.P. | Aider à optimiser la requête.
Dans un monde abstrait, les auteurs des tâches devraient être répartis uniformément parmi tous les employés de notre organisation, mais en réalité les tâches proviennent, en général, d'un nombre assez limité de personnes — « de la direction » en haut de la hiérarchie ou « des voisins » des départements adjacents (analystes, designers, marketing, …).
Supposons que dans notre organisation de 1000 personnes, seules 20 auteurs (souvent même moins) assignent des tâches à chaque exécuteur spécifique et , pour accélérer la requête « traditionnelle ».
Générateur de script
-- employés
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- tâches avec répartition spécifiée
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Affichons les 100 dernières tâches pour un exécutant spécifique :
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 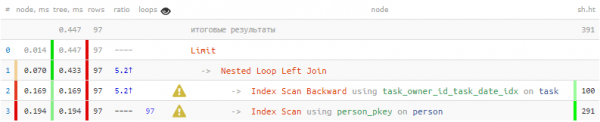
Il en résulte qu'un seul image provenant d'un registre lent peut bloquer le déploiement 1/3 du temps total et 3/4 des lectures des pages de données ont été consacrées uniquement à rechercher l'auteur 100 fois — pour chaque tâche affichée. Mais nous savons que parmi cette centaine il y a seulement 20 différents — ne pourrions-nous pas utiliser cette connaissance ?
dictionnaire hstore
Utilisons pour générer un «dictionnaire» clé-valeur :
CREATE EXTENSION hstoreDans le dictionnaire, il nous suffit d'insérer l'ID de l'auteur et son nom, afin de pouvoir extraire par cette clé :
-- formons la sélection cible
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- formons le dictionnaire pour les valeurs uniques
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- obtenons les valeurs associées du dictionnaire
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> key
FROM
T; 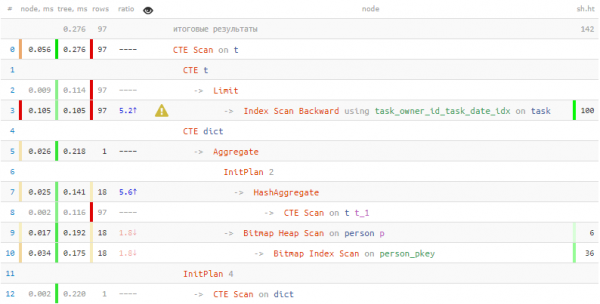
Le temps consacré à obtenir des informations sur les personnes a été diminué de 2 fois moins de temps et 7 fois moins de données lues! En plus de «dictionnariser», ces résultats nous ont également été aidés par l'extraction massive d'enregistrements de la table en un seul passage grâce à = ANY(ARRAY(...)).
Enregistrements de la table : sérialisation et désérialisation
Mais que faire si nous devons conserver dans le dictionnaire non un seul champ de texte, mais un enregistrement entier ? Dans ce cas, la capacité de PostgreSQL à traiter un enregistrement de table comme une valeur unique nous sera utile:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- magie #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- magie #2
FROM
  T;
Analysons ce qui s'est vraiment passé ici :
- Nous avons pris p comme alias pour l'enregistrement complet de la table person et les avons rassemblés dans un tableau.
- Cet tableau d'enregistrements a été casté en un tableau de chaînes de caractères (person[]::text[]), afin de l'intégrer dans un dictionnaire hstore comme tableau de valeurs.
- Lors de la récupération d'un enregistrement lié, nous l'avons extrait du dictionnaire par clé sous forme de chaîne de caractères.
- Nous devons transformer ce texte en une valeur de type table person (pour chaque table, un type portant le même nom est automatiquement créé).
- Nous avons "déplié" l'enregistrement typé en colonnes en utilisant
(...).*.
le dictionnaire json
Mais une astuce comme celle que nous avons appliquée ci-dessus ne fonctionnera pas s'il n'y a pas de type de table correspondant pour effectuer le "cast". La même situation se produira si, en tant que source de données pour la sérialisation, nous essayons d'utiliser une chaîne CTE, au lieu d'une table "réelle"..
Dans ce cas, nous serons aidés par :
...
, p AS ( -- ceci est déjà un CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- maintenant c'est déjà json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- et à l'intérieur json pour chaque ligne
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- extrait du dictionnaire comme json
      ) AS j(name text, birth_date date) -- rempli la structure dont nous avons besoin
  ) j;
Il convient de noter que lors de la description de la structure cible, nous pouvons énumérer non pas tous les champs de la chaîne source, mais seulement ceux dont nous avons vraiment besoin. Cependant, si nous avons une table "native", il est préférable d'utiliser la fonction json_populate_record.
L'accès au dictionnaire se fait toujours une fois, mais les coûts de [dé]sérialisation json sont suffisamment élevés, donc cette méthode doit être utilisée uniquement dans certains cas, lorsque le "scan" CTE honnête montre de moins bons résultats.
Testons les performances
Ainsi, nous avons obtenu deux façons de sérialiser des données dans un dictionnaire — hstore / json_object. En outre, les tableaux de clés et de valeurs eux-mêmes peuvent également être générés de deux manières, avec une conversion interne ou externe en texte : array_agg(i::text) / array_agg(i)::text[].
Vérifions l'efficacité de différents types de sérialisation sur un exemple purement synthétique — sérialisons différentes quantités de clés:
WITH dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Script d'évaluation : sérialisation
AVEC T COMME (
  SÉLECTIONNEZ
    *
  , (
      SÉLECTIONNEZ
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::réel et
      À PARTIR DE
        (
          SÉLECTIONNEZ
            array_agg(el) ea
          À PARTIR DE
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              expliquer analyser
              AVEC dict COMME (
                SÉLECTIONNEZ
                  hstore(
                    array_agg(i::texte)
                  , array_agg(i::texte)
                  )
                À PARTIR DE
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABLE dict
            $$) T(el texte)
        ) T
    ) et
  À PARTIR DE
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  COMMANDER PAR
    1, 2
)
SÉLECTIONNEZ
  v
, avg(et)::numérique(32,3)
DE
  T
GROUPE PAR
  1
COMMANDER PAR
1; 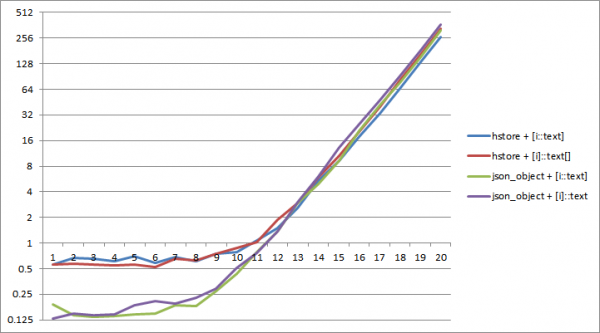
Sur PostgreSQL 11, jusqu'à une taille de dictionnaire d'environ 2^12 clés La sérialisation en json prend moins de temps. Dans ce cas, la combinaison de json_object et de la conversion de types "internes" est la plus efficace array_agg(i::texte).
Essayons maintenant de lire la valeur de chaque clé 8 fois — après tout, si on ne consulte pas le dictionnaire, pourquoi en avoir un ?
Script d'évaluation : lecture du dictionnaire
AVEC T COMME (
  SÉLECTIONNEZ
    *
  , (
      SÉLECTIONNEZ
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::réel et
      À PARTIR DE
        (
          SÉLECTIONNEZ
            array_agg(el) ea
          À PARTIR DE
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              expliquer analyser
              AVEC dict COMME (
                SÉLECTIONNEZ
                  json_object(
                    array_agg(i::texte)
                  , array_agg(i::texte)
                  )
                À PARTIR DE
                  generate_series(1, $$ || (1 < (i % ($$ || (1 << v) || $$) + 1)::texte
              À PARTIR DE
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el texte)
        ) T
    ) et
  À PARTIR DE
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  COMMANDER PAR
    1, 2
)
SÉLECTIONNEZ
  v
, avg(et)::numérique(32,3)
DE
  T
GROUPE PAR
  1
COMMANDER PAR
1; 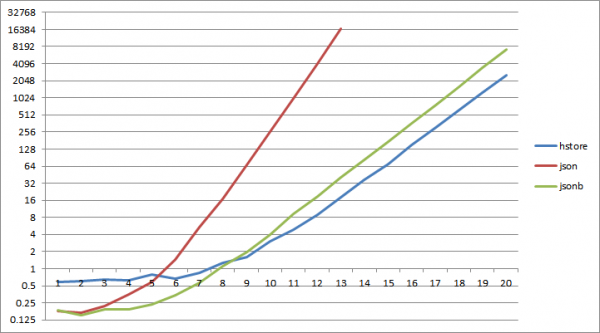
Et… déjà environ avec 2^6 clés, la lecture du dictionnaire json commence à être nettement plus lente par rapport à la lecture depuis hstore, la même chose pour jsonb se produit à 2^9.
Conclusions finales :
- si vous devez faire UN JOIN avec des enregistrements répétitifs il vaut mieux utiliser la "dictionnarisation" de la table
- si votre dictionnaire est censé être petit et que vous le lirez peu vous pouvez utiliser json[b]
- dans tous les autres cas hstore + array_agg(i::texte) sera plus efficace
Source : habr.com
