

Un grand nombre d'applications d'entreprise et de systèmes de virtualisation disposent de leurs propres mécanismes pour établir des solutions de haute disponibilité. En particulier, Oracle RAC (Oracle Real Application Cluster) est un cluster composé de deux serveurs de bases de données Oracle ou plus, travaillant ensemble pour équilibrer la charge et garantir la haute disponibilité au niveau serveur/application. Pour fonctionner dans ce mode, un stockage commun est nécessaire, généralement fourni par un système de stockage.
Comme nous l'avons déjà abordé dans l'un de nos , le système de stockage, malgré la présence de composants redondants (y compris les contrôleurs), présente néanmoins des points de défaillance – principalement sous la forme d'un ensemble unique de données. Par conséquent, pour construire une solution Oracle avec des exigences de fiabilité élevées, le schéma « N serveurs – un système de stockage » doit être complexifié.
Tout d'abord, il est bien sûr nécessaire de déterminer quels risques nous essayons d'éviter. Dans le cadre de cet article, nous n'examinerons pas la protection contre les menaces telles que « un météore a frappé ». Ainsi, la construction d'une solution de récupération après sinistre géographiquement dispersée restera le sujet de l'un de nos prochains articles. Ici, nous allons nous concentrer sur la solution de récupération après sinistre Cross-Rack, où la protection est mise en place au niveau des armoires de serveurs. Ces armoires peuvent se trouver dans une seule pièce ou dans différentes pièces, mais généralement au sein d'un même bâtiment.
Ces armoires doivent contenir tout l'équipement et les logiciels nécessaires pour garantir le fonctionnement des bases de données Oracle, indépendamment de l'état du "voisin". En d'autres termes, en utilisant une solution de récupération après sinistre Cross-Rack, nous excluons les risques en cas de défaillance :
- Serveurs d'applications Oracle
- Systèmes de stockage
- Systèmes de commutation
- Panne totale de tout l'équipement dans l'armoire :
- Défaillance de l'alimentation
- Défaillance du système de refroidissement
- Facteurs externes (humains, naturels, etc.)
La duplication des serveurs Oracle implique le principe même du fonctionnement d'Oracle RAC et se réalise par le biais de l'application. La duplication des moyens de commutation ne pose également pas de problème. Cependant, la duplication du système de stockage est beaucoup plus complexe.
La solution la plus simple consiste à répliquer les données d'un stockage principal vers un stockage de secours. En mode synchrone ou asynchrone, selon les capacités du stockage. En cas de réplication asynchrone, la question de la cohérence des données par rapport à Oracle se pose immédiatement. Mais même s'il existe une intégration logicielle avec l'application, il faudra dans tous les cas l'intervention des administrateurs en mode manuel pour basculer le cluster vers le stockage de secours en cas de défaillance du stockage principal.
Une solution plus complexe consiste à utiliser des « virtualisateurs » de stockage logiciels et/ou matériels, qui éliminent les problèmes de cohérence et d'intervention manuelle. Cependant, la complexité de déploiement et la gestion ultérieure, ainsi que le coût assez élevé de ces solutions, découragent beaucoup.
Pour des scénarios comme la récupération après sinistre Cross-Rack, la solution All Flash AccelStor NeoSapphire™ est parfaitement adaptée. en utilisant une architecture Shared-Nothing. Ce modèle représente un système de stockage à deux nœuds utilisant sa propre technologie FlexiRemap® pour travailler avec des puces flash. Grâce à NeoSapphire™ H710 peut offrir une performance allant jusqu'à 600K IOPS@4K en écriture aléatoire et plus de 1M IOPS@4K en lecture aléatoire, ce qui est inatteignable avec des systèmes de stockage basés sur RAID classiques.
Mais la caractéristique principale de NeoSapphire™ H710 est l'exécution de deux nœuds sous forme de boîtiers séparés, chacun ayant sa propre copie des données. La synchronisation des nœuds se fait via une interface externe InfiniBand. Grâce à cette architecture, il est possible de répartir les nœuds sur différentes localisations jusqu'à 100m, assurant ainsi une solution de récupération après sinistre Cross-Rack. Les deux nœuds fonctionnent entièrement en mode synchrone. Du côté des hôtes, H710 apparaît comme un système de stockage à double contrôleur ordinaire. Par conséquent, aucune option logicielle ou matérielle supplémentaire et aucune configuration particulièrement complexe ne sont nécessaires.
Si l'on compare toutes les solutions de récupération après sinistre Cross-Rack décrites ci-dessus, la solution d'AccelStor se démarque nettement des autres :
AccelStor NeoSapphire™ Architecture Shared Nothing
Virtualisateur de stockage logiciel ou matériel
Solution basée sur la réplication
Disponibilité
Défaillance du serveur
Aucun temps d'arrêt
Aucun temps d'arrêt
Aucun temps d'arrêt
Défaillance du switch
Aucun temps d'arrêt
Aucun temps d'arrêt
Aucun temps d'arrêt
Défaillance du système de stockage
Aucun temps d'arrêt
Aucun temps d'arrêt
Temps d'arrêt
Défaillance de tout le rack
Aucun temps d'arrêt
Aucun temps d'arrêt
Temps d'arrêt
Coût et complexité
Coût de la solution
Faible*
Élevée
Élevée
Complexité de déploiement
Faible
Élevée
Élevée
*AccelStor NeoSapphire™ est une solution All Flash qui n'est pas vraiment à un prix dérisoire, surtout avec une capacité doublée. Cependant, en comparant le coût final de cette solution avec d'autres vendeurs, son prix peut être considéré comme bas.
La topologie de connexion des serveurs d'applications et des nœuds du système All Flash sera la suivante :
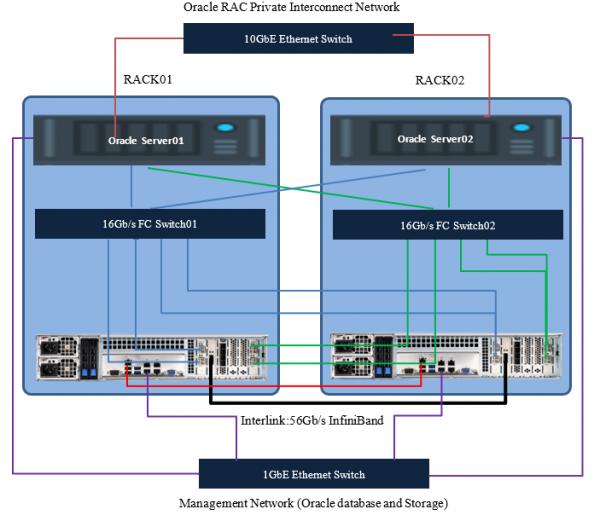
Lors de la planification de la topologie, il est fortement recommandé de dupliquer les commutateurs de gestion et d'interconnexion des serveurs.
Ce qui suit concernera la connexion via Fibre Channel. Dans le cas de l'utilisation d'iSCSI, ce sera la même chose, avec des ajustements selon les types de commutateurs utilisés et quelques paramètres différents du système.
Travail préparatoire sur le système
Équipement et logiciels utilisés
Spécifications des serveurs et des commutateurs
Composants
Description
Serveurs Oracle Database 11g
Deux
Système d'exploitation du serveur
Oracle Linux
Version de la base de données Oracle
11g (RAC)
Processeurs par serveur
Deux processeurs Intel® Xeon® E5-2667 v2 à 16 cœurs à 3,30 GHz
Mémoire physique par serveur
128 Go
Réseau FC
FC 16Gb/s avec multipathing
FC HBA
Emulex Lpe-16002B
Ports publics 1GbE dédiés à la gestion de clusters
Adaptateur ethernet Intel RJ45
Commutateur FC 16Gb/s
Brocade 6505
Ports privés 10GbE dédiés à la synchronisation des données
Intel X520
Spécification du système AccelStor NeoSapphire™ All Flash
Composants
Description
Système de stockage
Modèle de haute disponibilité NeoSapphire™ : H710
Version de l'image
4.0.1
Nombre total de disques
48
Taille du disque
1,92 To
Type de disque
SSD
Ports cibles FC
16 ports 16 Gb (8 par nœud)
Ports de gestion
Le câble ethernet 1GbE connecté aux hôtes via un commutateur ethernet
Port de cœur
Le câble ethernet 1GbE connecté entre deux nœuds de stockage
Port de synchronisation des données
Câble InfiniBand 56Gb/s
Avant d'utiliser le système, il doit être initialisé. Par défaut, l'adresse de gestion des deux nœuds est identique (192.168.1.1). Il faut se connecter successivement à chacun d'eux et attribuer de nouvelles (et différentes) adresses de gestion, et configurer la synchronisation de l'heure, après quoi les ports de gestion pourront être connectés à un réseau commun. Ensuite, les nœuds seront regroupés en paire HA en attribuant des sous-réseaux pour les connexions Interlink.
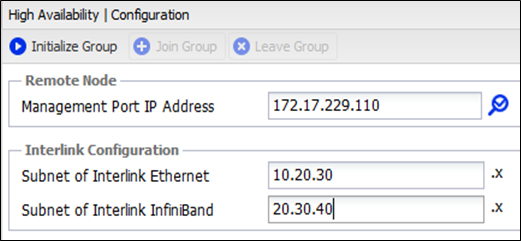
Après l'initialisation, le système peut être géré à partir de n'importe quel nœud.
Ensuite, nous créons les volumes nécessaires et les publions pour les serveurs d'applications.
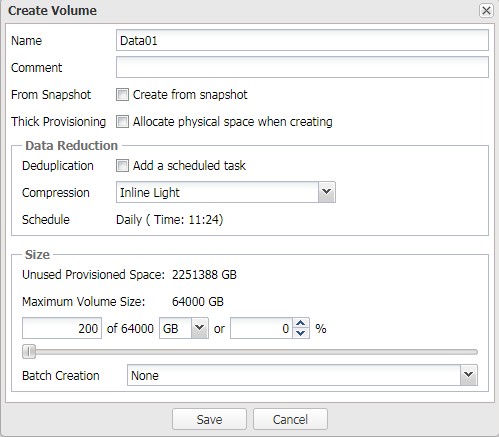
Il est fortement recommandé de créer plusieurs volumes pour Oracle ASM, car cela augmentera le nombre de cibles pour les serveurs, ce qui améliorera au final les performances globales (plus de détails sur les files d'attente dans un autre) ).
Configuration de test
Nom du volume de stockage
Taille du volume
Data01
200Go
Data02
200Go
Data03
200Go
Data04
200Go
Data05
200Go
Data06
200Go
Data07
200Go
Data08
200Go
Data09
200Go
Data10
200Go
Grid01
1 Go
Grid02
1 Go
Grid03
1 Go
Grid04
1 Go
Grid05
1 Go
Grid06
1 Go
Redo01
100Go
Redo02
100Go
Redo03
100Go
Redo04
100Go
Redo05
100Go
Redo06
100Go
Redo07
100Go
Redo08
100Go
Redo09
100Go
Redo10
100Go
Quelques explications concernant les modes de fonctionnement du tableau et les processus en cours lors de situations exceptionnelles
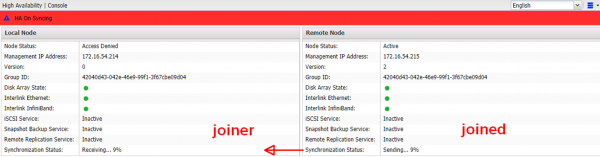
Chaque nœud de l’ensemble de données a un paramètre « numéro de version ». Après l'initialisation initiale, il est identique et égal à 1. Si pour une raison quelconque le numéro de version est différent, il y a toujours synchronisation des données de la version la plus élevée vers la plus basse, après quoi le numéro de la version la plus basse est aligné, c'est-à-dire que cela signifie que les copies sont identiques. Les raisons pour lesquelles les versions peuvent être différentes :
- Redémarrage planifié de l'un des nœuds
- Panne d'un des nœuds en raison d'une coupure soudaine (alimentation, surchauffe, etc.).
- Interruption de la connexion InfiniBand sans possibilité de synchronisation
- Panne d'un des nœuds en raison de la corruption des données. Ici, il faudra créer un nouveau groupe HA et synchroniser complètement l’ensemble de données.
Dans tous les cas, le nœud resté en ligne augmente son numéro de version de 1, afin qu'après la restauration de la connexion, il puisse synchroniser son ensemble de données avec son partenaire.
S'il y a interruption de la connexion par le lien Ethernet, alors Heartbeat passe temporairement à InfiniBand et revient dans les 10 secondes lors de sa restauration.
Configuration des hôtes
Pour garantir la tolérance aux pannes et augmenter les performances, il est nécessaire d'activer le support MPIO pour le tableau. Pour cela, il faut ajouter des lignes dans le fichier /etc/multipath.conf, puis redémarrer le service multipath
Texte cachédevices {
device {
vendor «AStor»
path_grouping_policy «group_by_prio»
path_selector «queue-length 0»
path_checker «tur»
features «0»
hardware_handler «0»
prio «const»
failback immediate
fast_io_fail_tmo 5
dev_loss_tmo 60
user_friendly_names yes
detect_prio yes
rr_min_io_rq 1
no_path_retry 0
}
}
Ensuite, pour qu'ASM fonctionne avec MPIO via ASMLib, il faut modifier le fichier /etc/sysconfig/oracleasm puis exécuter /etc/init.d/oracleasm scandisks
Texte caché
# ORACLEASM_SCANORDER: Matching patterns to order disk scanning
ORACLEASM_SCANORDER=«dm»
# ORACLEASM_SCANEXCLUDE: Matching patterns to exclude disks from scan
ORACLEASM_SCANEXCLUDE=«sd»
Remarque
Si vous ne souhaitez pas utiliser ASMLib, vous pouvez utiliser des règles UDEV, qui sont la base d'ASMLib.
À partir de la version 12.1.0.2, l'option Oracle Database est disponible pour l'installation en tant que partie du logiciel ASMFD.
Il est impératif de s'assurer que les disques créés pour Oracle ASM soient bien alignés par rapport à la taille de bloc avec laquelle le tableau fonctionne physiquement (4K). Sinon, des problèmes de performance peuvent survenir. Par conséquent, il est nécessaire de créer des volumes avec les paramètres appropriés :
parted /dev/mapper/device-name mklabel gpt mkpart primary 2048s 100% align-check optimal 1
Distribution des bases de données sur les volumes créés pour notre configuration de test
Nom du volume de stockage
Taille du volume
Cartographie des LUNs de volume
Détails du dispositif de volume ASM
Taille de l'unité d'allocation
Data01
200Go
Mapper tous les volumes de stockage au système de stockage sur tous les ports de données
Redondance : Normale
Nom : DGDATA
Objectif : Fichiers de données
4 Mo
Data02
200Go
Data03
200Go
Data04
200Go
Data05
200Go
Data06
200Go
Data07
200Go
Data08
200Go
Data09
200Go
Data10
200Go
Grid01
1 Go
Redondance : Normale
Nom : DGGRID1
Objectif : Grille : CRS et vote
4 Mo
Grid02
1 Go
Grid03
1 Go
Grid04
1 Go
Redondance : Normale
Nom : DGGRID2
Objectif : Grille : CRS et vote
4 Mo
Grid05
1 Go
Grid06
1 Go
Redo01
100Go
Redondance : Normale
Nom : DGREDO1
Objectif : Journal de redo du fil 1
4 Mo
Redo02
100Go
Redo03
100Go
Redo04
100Go
Redo05
100Go
Redo06
100Go
Redondance : Normale
Nom : DGREDO2
Objectif : Journal de redo du fil 2
4 Mo
Redo07
100Go
Redo08
100Go
Redo09
100Go
Redo10
100Go
Configurations de la base de données
- Taille de bloc = 8K
- Espace d'échange = 16 Go
- Désactiver AMM (Gestion automatique de la mémoire)
- Désactiver les pages énormes transparentes
Autres paramètres
# vi /etc/sysctl.conf
✓ fs.aio-max-nr = 1048576
✓ fs.file-max = 6815744
✓ kernel.shmmax 103079215104
✓ kernel.shmall 31457280
✓ kernel.shmmn 4096
✓ kernel.sem = 250 32000 100 128
✓ net.ipv4.ip_local_port_range = 9000 65500
✓ net.core.rmem_default = 262144
✓ net.core.rmem_max = 4194304
✓ net.core.wmem_default = 262144
✓ net.core.wmem_max = 1048586
✓ vm.swappiness=10
✓ vm.min_free_kbytes=524288 # ne pas définir cela si vous utilisez Linux x86
✓ vm.vfs_cache_pressure=200
✓ vm.nr_hugepages = 57000
# vi /etc/security/limits.conf
✓ grid soft nproc 2047
✓ grid hard nproc 16384
✓ grid soft nofile 1024
✓ grid hard nofile 65536
✓ grid soft stack 10240
✓ grid hard stack 32768
✓ oracle soft nproc 2047
✓ oracle hard nproc 16384
✓ oracle soft nofile 1024
✓ oracle hard nofile 65536
✓ oracle soft stack 10240
✓ oracle hard stack 32768
✓ soft memlock 120795954
✓ hard memlock 120795954
sqlplus “/as sysdba”
alter system set processes=2000 scope=spfile;
alter system set open_cursors=2000 scope=spfile;
alter system set session_cached_cursors=300 scope=spfile;
alter system set db_files=8192 scope=spfile;
Test de tolérance aux pannes
Pour démontrer, HammerDB a été utilisé pour émuler une charge OLTP. Configuration de HammerDB :
Nombre d'entrepôts
256
Transactions totales par utilisateur
1000000000000
Utilisateurs virtuels
256
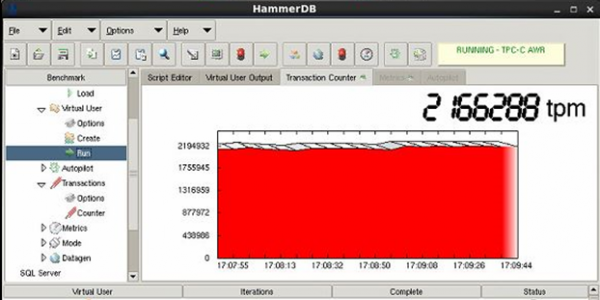
Le résultat obtenu était de 2,1 M TPM, ce qui est loin de la limite de performance du tableau , mais représente le « plafond » de la configuration matérielle actuelle des serveurs (surtout à cause des processeurs) et de leur nombre. L'objectif de ce test est tout de même de démontrer la tolérance aux pannes de la solution dans son ensemble, et non d'atteindre des performances maximales. Nous nous baserons donc simplement sur ce chiffre.
Test de panne de l'un des nœuds
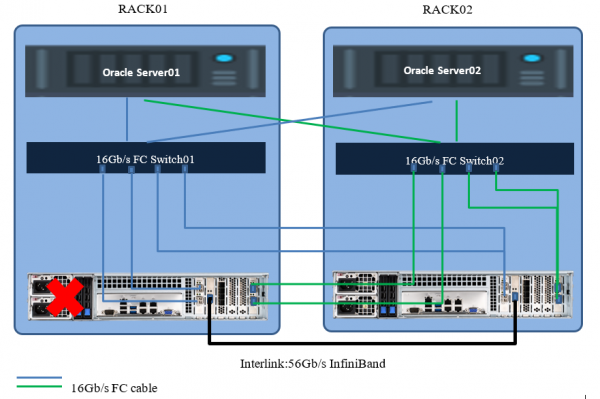
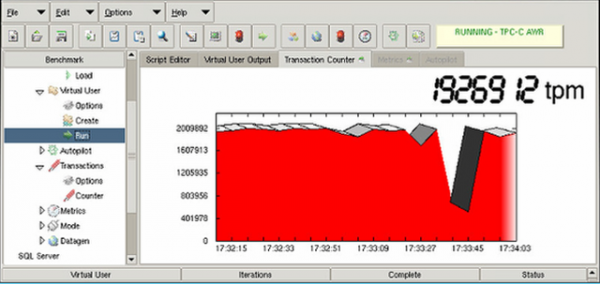
Les hôtes ont perdu une partie des chemins vers le stockage, continuant à fonctionner via les chemins restants avec le deuxième nœud. La performance a chuté pendant quelques secondes en raison de la reconstruction des chemins, puis est revenue à des niveaux normaux. Aucun temps d'arrêt n'a eu lieu.
Test de panne de l'armoire avec tout l'équipement
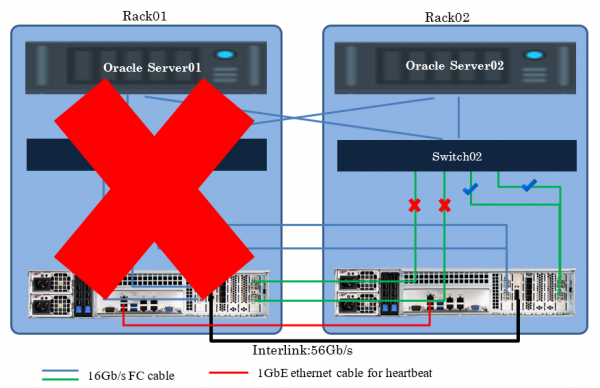
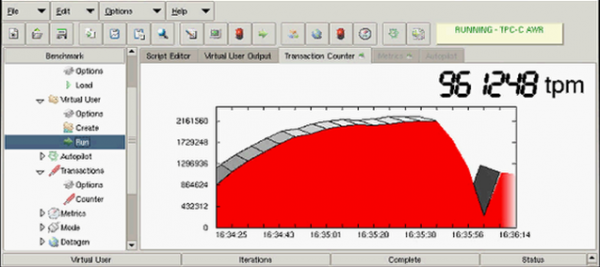
Dans ce cas, la performance a également chuté pendant quelques secondes en raison de la reconstruction des chemins, puis est revenue à la moitié de la valeur initiale. Le résultat a été réduit de moitié par rapport à l'initial en raison de l'exclusion d'un serveur d'application. Aucun temps d'arrêt n'a eu lieu non plus.
Si vous avez besoin de mettre en œuvre une solution de récupération de désastre Cross-Rack pour Oracle à un coût raisonnable et avec peu d'efforts de déploiement/administration, alors la collaboration entre Oracle RAC et l'architecture sera l'une des meilleures options. Au lieu d'Oracle RAC, n'importe quel autre logiciel permettant la virtualisation des clusters, les mêmes SGBD ou systèmes de virtualisation, par exemple, pourrait être utilisé. Le principe de construction de la solution restera le même. Et le résultat final sera une valeur nulle pour le RTO et le RPO.
Source : habr.com
