

La traduction de l'article a été préparée spécialement pour les étudiants du cours .
Au cours des dernières semaines, nous avons ajouté à un format de flux binaire, complétant le format de fichiers déjà existant pour l'accès aléatoire / IPC. Nous avons des implémentations en Java et C++ ainsi que des liaisons Python. Dans cet article, je vais expliquer comment fonctionne le format et montrer comment atteindre une très haute capacité de données pour DataFrame pandas.
Flux de données en colonnes
Une question commune que je reçois des utilisateurs d'Arrow concerne le coût élevé de la migration de grands ensembles de données tabulaires d'un format orienté lignes ou enregistrements vers un format en colonnes. Pour les jeux de données de plusieurs gigaoctets, la transposition en mémoire ou sur disque peut s'avérer être une tâche collossale.
Pour le streaming de données, qu'elles soient d'origine textuelle ou en colonnes, l'une des options reste l'envoi de petits paquets de lignes, chacun contenant une disposition par colonnes à l'intérieur.
Dans Apache Arrow, une collection de tableaux en colonnes en mémoire, représentant une chunk de table, s'appelle un paquet d'enregistrements (record batch). Pour représenter une structure de données unique sous forme de table logique, plusieurs paquets d'enregistrements peuvent être rassemblés.
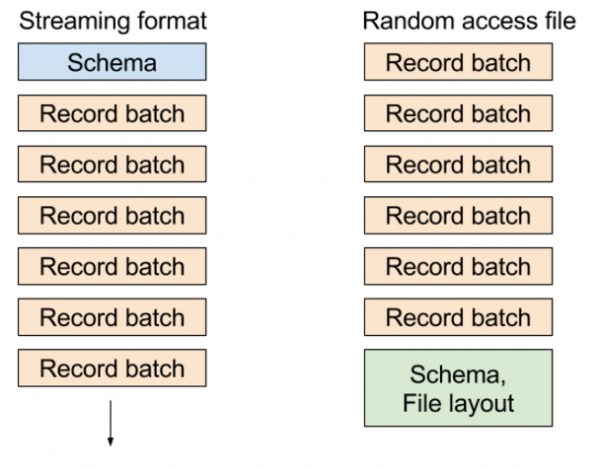
Dans le format de fichiers existant pour l'accès aléatoire, nous écrivons des métadonnées contenant le schéma de la table et la position des blocs à la fin du fichier, ce qui vous permet de choisir n'importe quel paquet d'enregistrements ou n'importe quelle colonne de l'ensemble de données de manière très économique. Dans le format de streaming, nous envoyons une série de messages : le schéma puis un ou plusieurs paquets d'enregistrements.
Différents formats ressemblent à peu près à ce qui est présenté sur cette image :
Flux de données dans PyArrow : application
Pour vous montrer comment cela fonctionne, je vais créer un exemple de jeu de données représentant un chunk de streaming :
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Maintenant, supposons que nous voulons enregistrer 1 Go de données, constituées de chunks de 1 Mo chacun, soit un total de 1024 chunks. Commençons par créer le premier DataFrame d'une taille de 1 Mo avec 16 colonnes :
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Ensuite, je les convertis en pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Je vais maintenant créer un flux de sortie qui écrira en mémoire vive et créerai StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Ensuite, nous allons écrire 1024 morceaux, qui au total constitueront 1 Go de données :
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Puisque nous avons écrit en RAM, nous pourrons obtenir tout le flux dans un seul tampon :
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Étant donné que ces données sont en mémoire, la lecture des paquets d'enregistrements Arrow s'effectue sans copie. J'ouvre StreamReader, je lis les données dans pyarrow.Table, puis je les convertis en DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
Tout cela est bien sûr intéressant, mais vous pourriez avoir des questions. À quelle vitesse cela se produit-il ? Comment la taille du morceau influence-t-elle la performance de l'obtention du DataFrame pandas ?
Performance de la transmission de données
À mesure que la taille du morceau diminue, le coût de reconstruction d'un cadre de colonnes continu dans pandas augmente en raison de schémas d'accès mémoire inefficaces. Il y a également quelques frais généraux liés à l'utilisation de structures de données C++ et de tableaux et leurs tampons mémoire.
Pour 1 Mo, comme indiqué ci-dessus, sur mon ordinateur portable (Quad-core Xeon E3-1505M), on obtient :
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
Cela donne une bande passante effective de 7,75 Go/s pour récupérer un DataFrame de 1 Go à partir de 1024 morceaux de 1 Mo. Que se passe-t-il si nous utilisons des morceaux de taille supérieure ou inférieure ? Voici les résultats :
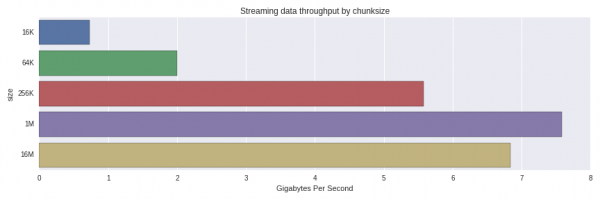
La performance diminue considérablement lorsque l'on passe de morceaux de 256K à 64K. J'ai été surpris de constater que les morceaux de 1 Mo étaient traités plus rapidement que ceux de 16 Mo. Il serait intéressant de mener une recherche plus approfondie pour comprendre si c'est une distribution normale ou si d'autres facteurs influencent cela.
Dans la mise en œuvre actuelle du format, les données ne sont pas compressées du tout, donc la taille en mémoire et celle « dans les fils » est à peu près la même. À l'avenir, la compression pourrait devenir une option supplémentaire.
Conclusion
La transmission de données en colonnes peut être un moyen efficace de transférer de grandes quantités de données vers des outils d'analyse de colonnes, comme pandas, en utilisant des petits morceaux. Les services de données qui utilisent un stockage orienté sur les lignes peuvent transférer et transposer de petits morceaux de données, qui sont plus adaptés au cache L2 et L3 de votre processeur.
Code complet
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size / ncols / np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Source : habr.com
