

Bonjour, Habr.
Récemment, j'ai sur les paramètres que nous utilisons le plus souvent dans notre équipe pour Kafka Producer et Consumer, afin de nous rapprocher d'une livraison garantie. Dans cet article, je souhaite expliquer comment nous avons organisé le traitement des événements reçus de Kafka en raison de l'indisponibilité temporaire d'un système externe.
Les applications modernes fonctionnent dans un environnement très complexe. La logique métier, enveloppée dans une pile technologique moderne, fonctionne dans une image Docker gérée par un orchestrateur tel que Kubernetes ou OpenShift, et communique avec d'autres applications ou des solutions d'entreprise via une chaîne de routeurs physiques et virtuels. Dans un tel environnement, quelque chose peut toujours casser, c'est pourquoi le traitement des événements en cas d'indisponibilité de l'un des systèmes externes est une partie importante de nos processus métier.
Comment c'était avant Kafka
Auparavant, dans le projet, nous utilisions IBM MQ pour la livraison asynchrone des messages. En cas d'erreur survenant dans le processus de travail du service, le message reçu pouvait être placé dans une dead-letter-queue (DLQ) pour un examen manuel ultérieur. La DLQ était créée à côté de la file d'attente entrante, le transfert du message se faisait au sein d'IBM MQ.
Si l'erreur était temporaire et que nous pouvions le déterminer (par exemple, ResourceAccessException lors d'un appel HTTP ou MongoTimeoutException lors d'une requête à MongoDb), alors la stratégie des appels répétés entrait en vigueur. Peu importe la branche de la logique de l'application, le message d'origine était transféré soit dans une file d'attente système pour un envoi différé, soit dans une application distincte qui avait été créée il y a longtemps pour renvoyer des messages. Dans ce cas, le numéro de réexpédition, lié à l'intervalle de retard ou à la fin de la stratégie au niveau de l'application, était enregistré dans l'en-tête du message. Si nous atteignons la fin de la stratégie mais que le système externe reste indisponible, alors le message sera placé dans une DLQ pour un examen manuel.
Recherche de solution
, on peut trouver ce qui suit . En bref, il est proposé de créer un topic par intervalle de retard et de mettre en œuvre des Consumers du côté de l'application, qui liront les messages avec le retard nécessaire.
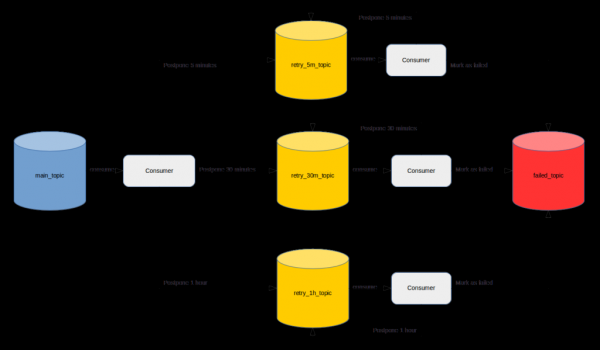
Bien qu'il y ait de nombreux avis positifs, il me semble qu'il n'est pas tout à fait réussi. Tout d'abord, parce que le développeur, en plus de répondre aux exigences commerciales, devra consacrer beaucoup de temps à la mise en œuvre du mécanisme décrit.
De plus, si la gestion des accès est activée sur le cluster Kafka, il faudra passer un certain temps à créer des topics et à garantir les accès nécessaires à ceux-ci. En outre, il sera nécessaire de choisir le bon paramètre retention.ms pour chacun des topics de réessai, afin que les messages puissent être renvoyés à temps et ne disparaissent pas. La mise en œuvre et la demande d'accès devront être répétées pour chaque service existant ou nouveau.
Voyons maintenant quels mécanismes de traitement des messages en double nous propose spring en général et spring-kafka en particulier. Spring-kafka a une dépendance transitive sur spring-retry, qui fournit des abstractions pour gérer différentes BackOffPolicy. C'est un outil assez flexible, mais son inconvénient majeur est le stockage des messages à renvoyer en mémoire de l'application. Cela signifie qu'un redémarrage de l'application en raison d'une mise à jour ou d'une erreur pendant l'exploitation entraînera la perte de tous les messages en attente de traitement à nouveau. Étant donné que ce point est critique pour notre système, nous avons choisi de ne pas le considérer davantage.
La bibliothèque spring-kafka propose plusieurs implémentations de ContainerAwareErrorHandler, par exemple , qui permet de traiter le message plus tard sans déplacer l'offset en cas d'erreur. Depuis la version 2.3 de spring-kafka, il est possible de définir une BackOffPolicy.
Cette approche permet aux messages en réessai de survivre au redémarrage de l'application, mais le mécanisme DLQ est toujours absent. C'est cette option que nous avons choisie au début de 2019, en pensant de manière optimiste que le DLQ ne serait pas nécessaire (nous avons eu de la chance et il ne fut effectivement pas nécessaire pendant quelques mois d'exploitation de l'application avec ce système de réessai). Des erreurs temporaires provoquaient l'activation de SeekToCurrentErrorHandler. Les autres erreurs étaient enregistrées dans les logs, entraînant un décalage de l'offset, et le traitement se poursuivait avec le message suivant.
Solution finale
La mise en œuvre basée sur SeekToCurrentErrorHandler nous a poussés à développer notre propre mécanisme pour le renvoi des messages.
Avant tout, nous voulions tirer parti de l'expérience existante et l'élargir en fonction de la logique de l'application. Pour une application à logique linéaire, il serait optimal d'arrêter la lecture de nouveaux messages pendant un court laps de temps défini dans la stratégie de réessai. Pour les autres applications, nous souhaiterions avoir un point central qui garantirait l'application de la stratégie de réessai. De plus, ce point unique doit disposer d'une fonctionnalité DLQ pour les deux approches.
La stratégie de réessai elle-même doit être stockée dans l'application responsable de la récupération du prochain intervalle en cas d'erreur temporaire.
Arrêt du Consumer pour une application à logique linéaire
Lors de l'utilisation de spring-kafka, le code pour arrêter le Consumer peut ressembler à ceci :
public void pauseListenerContainer(MessageListenerContainer listenerContainer,
                                   Instant retryAt) {
        if (nonNull(retryAt) && listenerContainer.isRunning()) {
            listenerContainer.stop();
            taskScheduler.schedule(() -> listenerContainer.start(), retryAt);
            return;
        }
        // vers DLQ
    }
Dans cet exemple, retryAt est le moment auquel il faut redémarrer le MessageListenerContainer s'il est encore en cours d'exécution. Le redémarrage se fera dans un thread séparé, lancé par TaskScheduler, dont l'implémentation est également fournie par spring.
Nous trouvons la valeur de retryAt de la manière suivante :
- Nous recherchons la valeur du compteur de réessais.
- En fonction de la valeur du compteur, l'intervalle de délai actuel est recherché dans la stratégie de réessai. La stratégie est déclarée dans l'application elle-même, et nous avons choisi le format JSON pour son stockage.
- L'intervalle trouvé dans le tableau JSON contient le nombre de secondes après lesquelles il faudra réessayer le traitement. Ce nombre de secondes est ajouté au temps actuel, formant ainsi la valeur pour retryAt.
- Si l'intervalle n'est pas trouvé, la valeur de retryAt est nulle et le message sera envoyé dans la DLQ pour un traitement manuel.
Avec cette approche, il ne reste qu'à conserver le nombre de tentatives pour chaque message actuellement en cours de traitement, par exemple dans la mémoire de l'application. Conserver le compteur de tentatives en mémoire n'est pas critique pour cette approche, car une application avec une logique linéaire ne peut pas traiter l'ensemble. Contrairement à spring-retry, le redémarrage de l'application ne conduira pas à la perte de tous les messages à réitérer, mais simplement à un redémarrage de la stratégie.
Cette approche permet de réduire la charge sur le système externe, qui peut être indisponible en raison d'une très forte charge. En d'autres termes, en plus de la réitération, nous avons réussi à mettre en œuvre le modèle. .
Dans notre cas, le seuil d'erreur est de seulement 1, et pour minimiser le temps d'arrêt du système en raison d'une panne de réseau temporaire, nous utilisons une stratégie de réitération très granulaire avec de courtes intervalles de délai. Cela peut ne pas convenir à toutes les applications du groupe, donc le ratio entre le seuil d'erreur et la taille de l'intervalle doit être ajusté en fonction des caractéristiques du système.
Une application distincte pour le traitement des messages provenant d'applications avec une logique non déterministe
Voici un exemple de code qui envoie un message à une telle application (Retryer), qui effectuera une nouvelle tentative d'envoi vers le sujet DESTINATION lorsque le temps RETRY_AT sera atteint :
public  void retry(ConsumerRecord record, String retryToTopic,
                         Instant retryAt, String counter, String groupId, Exception e) {
        Headers headers = ofNullable(record.headers()).orElse(new RecordHeaders());
        List arrayOfHeaders =
            new ArrayList(Arrays.asList(headers.toArray()));
        updateHeader(arrayOfHeaders, GROUP_ID, groupId::getBytes);
        updateHeader(arrayOfHeaders, DESTINATION, retryToTopic::getBytes);
        updateHeader(arrayOfHeaders, ORIGINAL_PARTITION,
                     () -> Integer.toString(record.partition()).getBytes());
        if (nonNull(retryAt)) {
            updateHeader(arrayOfHeaders, COUNTER, counter::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "retry"::getBytes);
            updateHeader(arrayOfHeaders, RETRY_AT, retryAt.toString()::getBytes);
        } else {
            updateHeader(arrayOfHeaders, REASON,
                         ExceptionUtils.getStackTrace(e)::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "backout"::getBytes);
        }
        ProducerRecord messageToSend =
            new ProducerRecord(retryTopic, null, null, record.key(), record.value(), arrayOfHeaders);
        kafkaTemplate.send(messageToSend);
    }
L'exemple montre qu'une grande quantité d'informations est transmise dans les en-têtes. La valeur RETRY_AT est déterminée de la même manière que pour le mécanisme de répétition via l'arrêt du Consumer. En plus de DESTINATION et RETRY_AT, nous transmettons :
- GROUP_ID, par lequel nous groupons les messages pour une analyse manuelle et simplifions la recherche.
- ORIGINAL_PARTITION, afin d'essayer de conserver le même Consumer pour le retraitement. Ce paramètre peut être null, auquel cas une nouvelle partition sera obtenue par la clé record.key() du message original.
- La valeur mise à jour du COUNTER, pour suivre la stratégie de répétitions.
- SEND_TO — une constante qui indique s'il faut renvoyer le message pour retraitement lorsqu'on atteint RETRY_AT ou le placer dans la DLQ.
- REASON — la raison pour laquelle le traitement du message a été interrompu.
Le Retryer conserve les messages pour un nouvel envoi et une analyse manuelle dans PostgreSQL. Une tâche est lancée selon un minuteur, qui trouve les messages dont le RETRY_AT est atteint et les renvoie dans la partition ORIGINAL_PARTITION du sujet DESTINATION avec la clé record.key().
Après l'envoi, les messages sont supprimés de PostgreSQL. L'analyse manuelle des messages se déroule dans une interface simple qui interagit avec le Retryer via l'API REST. Ses principales caractéristiques sont la réexpédition ou la suppression de messages de la DLQ, la consultation des informations d'erreur et la recherche de messages, par exemple, par nom d'erreur.
Comme l'accès est contrôlé sur nos clusters, il est nécessaire de demander l'accès au sujet écouté par le Retryer et de permettre au Retryer d'écrire dans le sujet DESTINATION. C'est peu pratique, mais, contrairement à l'approche avec un sujet basé sur des intervalles, nous disposons d'une véritable DLQ et d'une interface utilisateur pour la gérer.
Il arrive que le sujet entrant soit lu par plusieurs groupes de consommateurs différents, dont les applications mettent en œuvre une logique variée. La répétition d'un message via le Retryer pour l'une de ces applications entraînera un doublon pour l'autre. Pour se protéger contre cela, nous créons un sujet distinct pour le retraitement. Le sujet entrant et le sujet de répétition peuvent être lus par le même Consumer sans aucune restriction.
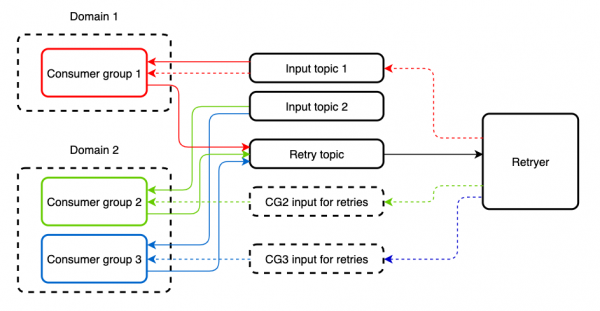
Par défaut, cette approche ne fournit pas la possibilité d'un circuit breaker, mais cela peut être ajouté dans l'application à l'aide de ou du nouveau , en enveloppant les lieux d'appels aux services externes dans les abstractions appropriées. De plus, cela permet de choisir une stratégie pour un modèle, ce qui peut également être utile. Par exemple, dans spring-cloud-netflix, cela peut être une pool de threads ou un sémaphore.
Sortie
En conséquence, nous avons développé une application distincte qui permet de répéter le traitement d'un message en cas d'indisponibilité temporaire d'un système externe.
L'un des principaux avantages de l'application est qu'elle peut être utilisée par des systèmes externes opérant sur le même cluster Kafka, sans nécessiter d'importantes modifications de leur part ! Cette application n'aura besoin que d'accéder au topic retry, de remplir quelques en-têtes Kafka et d'envoyer le message au Retryer. Il n'est pas nécessaire de déployer d'infrastructure supplémentaire. De plus, pour réduire le nombre de messages transférés entre l'application et le Retryer, nous avons isolé des applications avec une logique linéaire et mis en place un traitement répété via l'arrêt du Consumer.
Source : habr.com
