

Récemment, des collègues du secteur m'ont demandé de manière indépendante comment obtenir tous les canaux Bluetooth à partir d'un seul récepteur SDR. La bande passante le permet, avec un SDR à bande de sortie de 80 MHz ou plus. Bien sûr, cela pourrait être fait sur FPGA, mais le temps de développement serait assez long. Je savais depuis longtemps qu'il était relativement simple de le faire sur GPU, mais à ce niveau !
La norme Bluetooth définit le niveau physique en deux versions : Classic et Low Energy. La spécification est . Le document est terriblement volumineux, le lire en entier est dangereux pour le cerveau. Heureusement, de grandes entreprises fabriquant des appareils de mesure ont les moyens de créer des documents visuels sur le sujet. et , par exemple. Je n'ai absolument aucune chance de rivaliser avec elles en termes de qualité de présentation du contenu. Je demande aux intéressés d'étudier les liens.
Tout ce que j'ai besoin de savoir sur le niveau physique pour créer un filtre multicanal est le pas de la grille de fréquences et la vitesse de modulation. Ils sont présentés dans un tableau dans l'un des documents mentionnés :
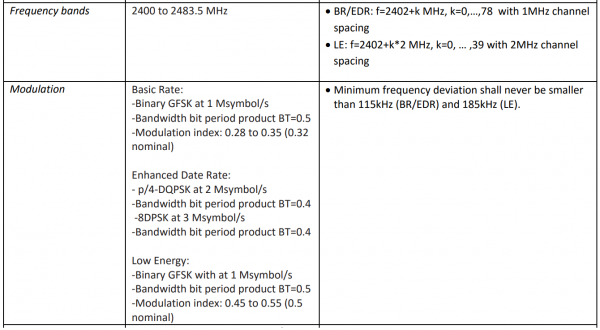
Ainsi, nous devons découper la bande de 80 MHz en 79 filtres avec un pas de réglage de 1 MHz et, en même temps, en 40 filtres avec un pas de réglage de 2 MHz. Les fréquences d'échantillonnage des sorties des filtres doivent être respectivement de 1 MHz et 2 MHz.
Ainsi, nous avons besoin de deux peignes de filtres.
Pour commencer, choisissons les paramètres de ces filtres en fonction des bandes de signaux Bluetooth Classic et Bluetooth Low Energy. Nous avons besoin de leurs caractéristiques d'impulsion pour calculer la charge sur l'appareil de traitement du filtre. Il convient de préciser que les longueurs des caractéristiques d'impulsion ont été choisies en fonction des exigences de l'algorithme de filtrage "rapide". L'essence ne change pas. De plus, le nombre de coefficients de la réponse impulsionnelle ne doit pas être trop élevé pour que le filtre soit réalisable sur du matériel de calcul raisonnable.
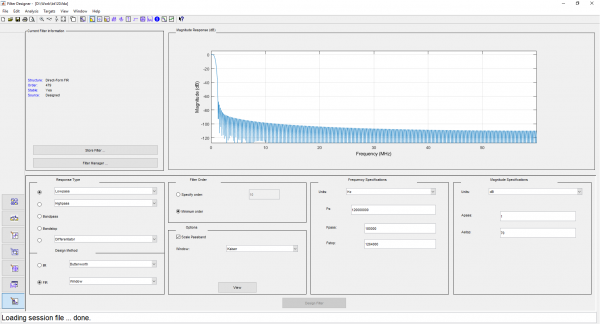
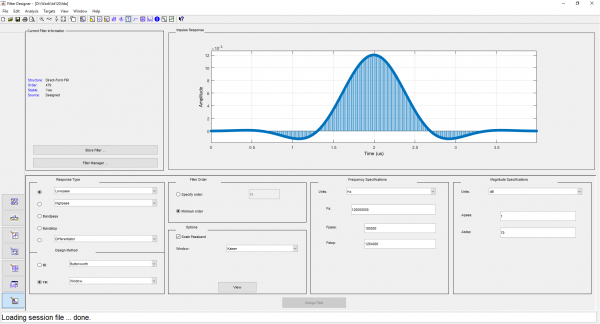
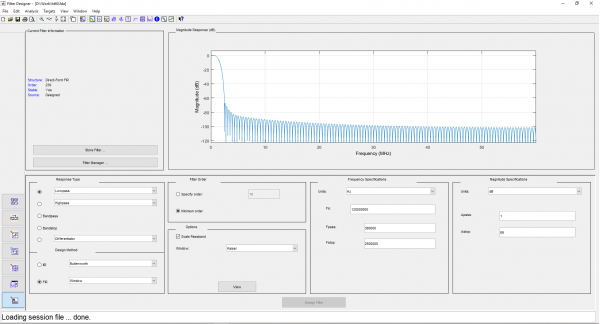
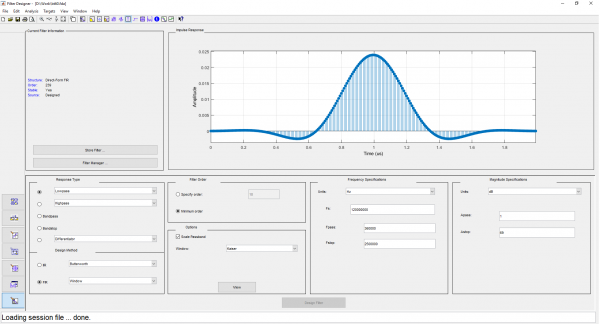
Pour les filtres avec un pas de 1 MHz, choisissons une bande passante de filtre passe-bas (la moitié de la bande passante du filtre passe-bande) de 500 kHz, et ajustons la longueur de la réponse impulsionnelle à 480 échantillons. Pour les filtres avec un pas de 2 MHz, choisissons ces paramètres à 1 MHz et 240 échantillons, respectivement. Nous choisissons le type de fenêtre de Kaiser. Calculons les caractéristiques d'impulsion dans filterDesigner et exportons-les au format C-header :
Captures d'écran de filterDesigner
On peut aborder le problème de manière directe : construire un tableau DDC correspondant au nombre de filtres (). Cette approche est avantageuse pour les FPGA, où il est possible de réaliser des économies en réduisant la largeur des calculateurs de premier niveau. De plus, les FPGA sont la méthode d'implémentation la plus efficace sur le plan énergétique. Cependant, les coûts en main-d'œuvre pour cette méthode sont les plus élevés.
Lors de l'utilisation d'une peigne de filtres sur les GPU actuellement populaires, il devient possible de mettre en œuvre un algorithme plus sophistiqué : un peigne de filtres polyphasé basé sur la FFT, qui est disponible via la bibliothèque CUDA. Dans la littérature étrangère, l'algorithme est appelé Polyphase or WOLA (Weight, Overlap and Add) FFT Filterbank. Ma paresse pour le dessin m'empêche de fournir une explication visuelle par moi-même. Il existe de nombreux matériaux sur le sujet en ligne, notamment un graphique illustratif réalisé à la page 11 (un grand merci aux auteurs respectés), le voici :
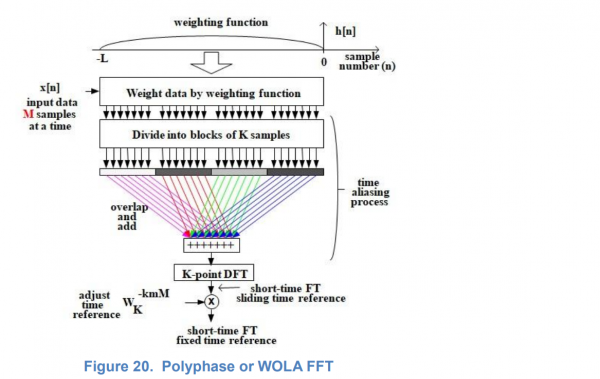
J'essaierai d'expliquer le schéma de traitement avec mes propres mots. Je demande aux âmes sensibles de ne pas lire.
J'essaierai d'expliquer le schéma de traitement avec mes propres mots dans la mesure de mes capacités méthodologiques. La FFT est la convolution du signal d'entrée avec tout le spectre d'harmoniques complexes orthogonaux, qui se superposent sur l'intervalle de la réponse impulsionnelle. La réponse impulsionnelle du filtre, sur laquelle le signal est multiplié avant d'entrer dans la FFT, est modulée par ce spectre d'harmoniques. En d'autres termes, l'enveloppe des réponses impulsionnelles des filtres résultants est mise de côté. Ensuite, le spectre des harmoniques est élagué par un certain facteur, en raison de l'élargissement de la bande passante du filtre par rapport à celle du filtre à fenêtre rectangulaire. Sur le graphique, nous voyons un élagage par quatre. En d'autres termes, après l'élargissement de la bande avec la fenêtre de Kaiser (avec augmentation simultanée de l'atténuation dans la bande de transition), nous n'avons plus besoin de tous les filtres, mais seulement d'un quart d'entre eux. Les autres sont redondants, leurs caractéristiques fréquentielles se chevauchent. Parmi les quatre points de la FFT consécutifs, nous ne sélectionnons que le point zéro, dont le calcul consiste à additionner les quatre
points d'entrée, prélevés après un temps égal à un quart de la durée de la FFT initiale.
Nous choisirons le matériel que nous avons à portée de main. Il s'agit de la carte d'entrée de l'entreprise "Instrumental Systems" FMC126P. J'en ai déjà parlé dans un précédent article. . Dans le port FMC de la carte, un sous-module de la même entreprise avec le transceiver AD9371 et une bande passante de 100 MHz est inséré. L'intégralité du flux du transceiver peut être continuellement transmise à un ordinateur pour traitement.
Choisissons une carte graphique avec le GPU GTX 1050. (J'ai menti, c'est elle qui nous a choisis : c'est tout ce qui était à portée de main, elle a été arrachée d'un calculateur pour le calcul des antennes, mais quelle surprise de voir un dispositif opérationnel). Passons à la partie logicielle.
Malheureusement, en raison des licences, nous ne pouvons pas publier le code complet. Nous ne pouvons montrer que les noyaux du GPU. D'ailleurs, le reste du code n'est pas vraiment intéressant.
Voici le noyau qui effectue la multiplication du signal par la fenêtre et l'addition, ainsi qu'un wrapper pour son appel :
__global__ void cuComplexMultiplyWindowKernel(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result) {
    __shared__ cuComplex multiplicationResult[480];
    multiplicationResult[threadIdx.x] = cuComplexMultiplyFloat(data[threadIdx.x + windowSize / 4 * blockIdx.x], window[threadIdx.x]);
    __syncthreads();
    cuComplex sum;
    sum.x = sum.y = 0;
    if (threadIdx.x < windowSize / 4) {
        for(int i = 0; i < 4; i++) {
            sum = cuComplexAdd(sum, multiplicationResult[threadIdx.x + i * windowSize / 4]);
        }
        result[threadIdx.x + windowSize / 4 * blockIdx.x] = sum;
    }
}

cudaError_t cuComplexMultiplyWindow(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result, size_t dataSize, cudaStream_t stream) {
    size_t windowStep = windowSize / 4;
    cuComplexMultiplyWindowKernel<<>>(data, window, windowSize, result);
    return cudaGetLastError();
}
Le code de traitement du signal qui appelle ce noyau suit exactement le schéma de l'algorithme illustré dans l'image ci-dessus, donc je ne vois pas l'intérêt de le reproduire ici.
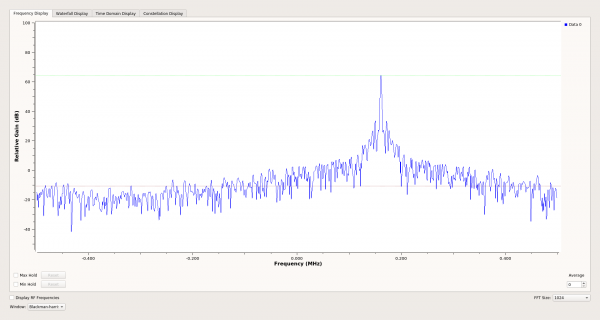
Les filtres ont été vérifiés sur le spectre de sortie des canaux en temps réel. Un signal de générateur de signaux de 2450 MHz était appliqué à l'entrée de l'AD9371, la sélectivité des filtres correspondait aux calculs.
Prévisions : adaptation du logiciel sur la carte XRTX et réalisation de la recherche de paquets, si cela intéresse quelqu'un ou si du temps libre se présente.
Tout le travail logiciel a été réalisé par , gloire à lui !
Source : habr.com
