

Chers lecteurs, bonjour !
La nécessité de construire des plateformes IT pour l'accumulation et l'analyse de données se pose tôt ou tard pour toute entreprise dont le modèle commercial repose sur des services intellectuellement exigeants ou sur la création de produits techniquement complexes. La construction de plateformes analytiques est une tâche complexe et laborieuse. Cependant, chaque tâche peut être simplifiée. Dans cet article, je souhaite partager mon expérience sur l'utilisation d'outils low-code qui aident à créer des solutions analytiques. Cette expérience a été acquise lors de la mise en œuvre de plusieurs projets dans le domaine des Solutions Big Data de l'entreprise Neoflex. Depuis 2005, le département des Solutions Big Data de Neoflex s'occupe de la construction de entrepôts et de lacs de données, résout des problèmes d'optimisation de la vitesse de traitement de l'information et travaille sur la méthodologie de gestion de la qualité des données.
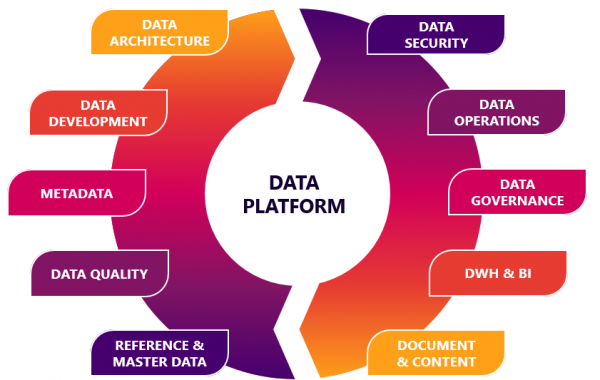
Éviter l'accumulation consciente de données faiblement et/ou fortement structurées sera impossible pour quiconque. Même pour une petite entreprise, cela s'applique. En effet, à mesure que l'entreprise se développe, l'entrepreneur aspirant sera confronté à des questions telles que le développement d'un programme de fidélité, l'analyse de l'efficacité des points de vente, la réflexion sur la publicité ciblée, et se posera des questions sur la demande de produits complémentaires. Dans un premier temps, la tâche peut être résolue de manière improvisée. Mais avec la croissance de l'entreprise, le recours à une plateforme analytique devient inévitable.
Cependant, quand les tâches d'analyse de données peuvent-elles se transformer en problèmes de type « Rocket Science » ? Probablement au moment où il s'agit de données véritablement massives.
Pour simplifier la tâche « Rocket Science », il est possible de manger un éléphant morceau par morceau.
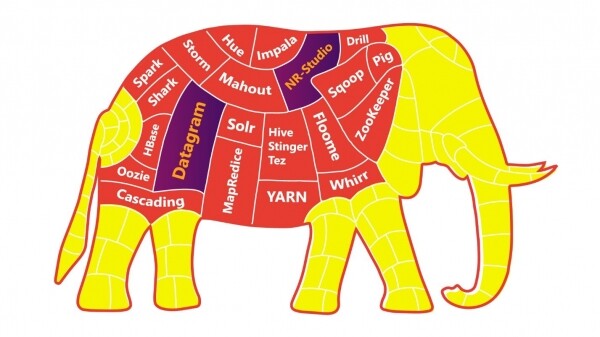
Plus la granularité et l'autonomie de vos applications/services/microservices sont grandes, plus il sera facile pour vous, vos collègues et l'ensemble de l'entreprise de digérer l'éléphant.
Cette assertion a été adoptée par presque tous nos clients, qui ont réaménagé leur paysage en s'appuyant sur les pratiques d'ingénierie des équipes DevOps.
Mais même avec un régime « séparé, à base d'éléphant », nous avons de bonnes chances de subir une « saturation » de l'environnement IT. À ce moment-là, il convient de faire une pause, de respirer profondément et de se tourner vers la plateforme d'ingénierie low-code.
De nombreux développeurs craignent de se retrouver à un point mort dans leur carrière en s'éloignant de l'écriture de code pour se diriger vers le « glisser-déposer » d'éléments dans les interfaces utilisateur des systèmes low-code. Cependant, l'apparition des machines-outils n'a pas entraîné la disparition des ingénieurs, mais a plutôt élevé leur travail à un nouveau niveau !
Voyons pourquoi.
L'analyse des données dans le domaine de la logistique, de l'industrie télécom, des études médiatiques et du secteur financier est toujours liée aux questions suivantes :
- La rapidité de l'analyse automatisée;
- La possibilité de réaliser des expériences sans affecter le flux principal de production de données;
- La fiabilité des données préparées;
- Le suivi des modifications et la versionning;
- La provenance des données, la lignée des données, CDC;
- La rapidité de livraison de nouvelles fonctionnalités dans l'environnement de production;
- Et le fameux : le coût de développement et de maintenance.
Cela signifie que les ingénieurs ont un grand nombre de tâches de haut niveau à accomplir, tâches que l'on peut réaliser avec une efficacité suffisante uniquement en libérant leur esprit des tâches de développement de bas niveau.
Les prérequis au passage des développeurs à un nouveau niveau ont été l'évolution et la numérisation des affaires. La valeur d'un développeur change également : il y a une forte pénurie de développeurs capables de plonger dans l'essence des concepts d'affaires à automatiser.
Faisons une analogie entre les langages de programmation de bas niveau et de haut niveau. Le passage des langages de bas niveau vers les langages de haut niveau représente un passage de l'écriture de « directives directes en langage machine » vers « directives en langage humain ». Cela signifie l'ajout d'un certain niveau d'abstraction. Dans ce cas, le passage des plateformes low-code des langages de programmation de haut niveau représente un passage de « directives en langage humain » vers « directives en langage commercial ». Si des développeurs dépriment à ce sujet, alors ils sont peut-être tristes depuis le moment où JavaScript est né, qui utilise des fonctions de tri de tableaux. Ces fonctions ont, bien entendu, une implémentation logicielle sous le capot, à l'aide des mêmes moyens de programmation de haut niveau.
Par conséquent, le low-code n'est qu'un nouvel niveau d'abstraction.
L'expérience pratique de l'utilisation du low-code.
Le concept de low-code est assez vaste, mais je voudrais maintenant parler de l'application des « concepts low-code » à travers l'exemple d'un de nos projets.
La division Big Data Solutions de la société « Neoflex » se spécialise principalement dans le secteur financier, construisant des entrepôts et des lacs de données et automatisant divers rapports. Dans ce créneau, l'utilisation de low-code est devenue une norme depuis longtemps. Parmi d'autres outils low-code, on peut mentionner des solutions pour organiser des processus ETL : Informatica Power Center, IBM Datastage, Pentaho Data Integration. Ou encore Oracle Apex, qui se présente comme un environnement de développement rapide pour les interfaces d'accès et de modification des données. Cependant, l'utilisation des outils de développement low-code n'est pas toujours associée à la création d'applications à usage spécifique sur une pile technologique commerciale avec une dépendance clairement définie envers le fournisseur.
Avec les plateformes low-code, il est également possible d'organiser l'orchestration des flux de données, de créer des plateformes de data science ou, par exemple, des modules de vérification de la qualité des données.
Un des exemples pratiques de l'utilisation d'outils de développement low-code est la collaboration entre « Neoflex » et la société Mediascope, un des leaders du marché russe de la recherche média. L'un des objectifs commerciaux de cette entreprise est de produire des données sur la base desquelles les annonceurs, les plateformes Internet, les chaînes de télévision, les stations de radio, les agences de publicité et les marques prennent des décisions d'achat d'espaces publicitaires et planifient leurs communications marketing.
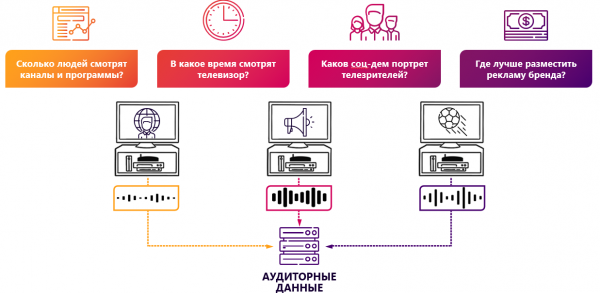
Les études médiatiques sont un domaine d'affaires technologiquement chargé. La reconnaissance des séquences vidéo, la collecte de données à partir d'appareils analysant les visionnages, la mesure de l'activité sur les ressources web — tout cela implique que l'entreprise dispose d'un grand personnel informatique et d'une énorme expérience dans la construction de solutions analytiques. Mais la croissance exponentielle de la quantité d'informations, du nombre et de la diversité de ses sources oblige l'industrie informatique à progresser constamment. La solution la plus simple pour l'échelle d'une plateforme analytique existante de Mediascope aurait pu être d'augmenter le personnel informatique. Mais une solution beaucoup plus efficace est d'accélérer le processus de développement. Un des pas vers cette direction pourrait être l'utilisation de plateformes low-code.
Au moment du lancement du projet, la société disposait déjà d'une solution produit fonctionnelle. Cependant, la mise en œuvre de la solution sur MSSQL ne pouvait pas pleinement répondre aux attentes en matière d'évolutivité des fonctionnalités tout en maintenant un coût acceptable pour les ajustements.
La tâche qui nous attendait était véritablement ambitieuse – « Neoflex » et Mediascope devaient créer une solution industrielle en moins d'un an, avec la condition de lancer le MVP dès le premier trimestre à compter de la date de début des travaux.
Comme fondation pour la construction de la nouvelle plateforme de données, basée sur des calculs faible code, la pile technologique Hadoop a été choisie. Le standard de stockage des données est devenu HDFS avec l'utilisation de fichiers au format parquet. Pour accéder aux données sur la plateforme, Hive a été utilisé, où toutes les vitrines disponibles se présentent sous la forme de tables externes. Le chargement des données dans le stockage a été réalisé à l'aide de Kafka et Apache NiFi.
L'outil faible code dans ce concept a été appliqué pour optimiser la tâche la plus laborieuse dans la construction de la plateforme analytique – le calcul des données.
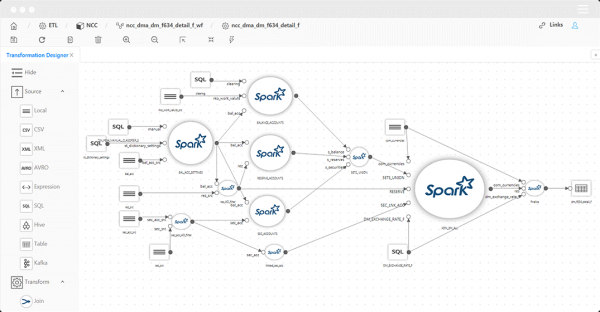
Le principal mécanisme de mapping des données a été choisi comme étant l'outil faible code Datagram. Neoflex Datagram est un moyen de développer des transformations et des flux de données.
En utilisant cet outil, il est possible de se passer de l'écriture de code en Scala « à la main ». Le code Scala est généré automatiquement en utilisant une approche d'Architecture Pilotée par Modèle.
L'avantage évident de cette approche est d'accélérer le processus de développement. Cependant, en plus de la rapidité, il y a encore d'autres avantages :
- Visualisation du contenu et de la structure des sources/destinations;
- Suivi de l'origine des objets de flux de données jusqu'aux champs individuels (provenance);
- Exécution partielle des transformations avec visualisation des résultats intermédiaires;
- Visualisation du code source et de sa correction avant exécution;
- Validation automatique des transformations;
- Chargement automatique des données 1 à 1.
Le seuil d'entrée dans les solutions low-code pour la génération de transformations est assez bas : un développeur doit connaître SQL et avoir de l'expérience avec des outils ETL. Cependant, il convient de préciser que les générateurs de transformations basés sur le code ne sont pas des outils ETL au sens large du terme. Les outils low-code peuvent ne pas disposer de leur propre environnement d'exécution de code. Cela signifie que le code généré sera exécuté dans l'environnement qui existait sur le cluster avant l'installation de la solution low-code. Et c'est peut-être un autre plus pour le low-code. En effet, une équipe « classique » peut travailler en parallèle avec l'équipe low-code, mettant en œuvre des fonctionnalités, par exemple, dans un code Scala pur. L'intégration des modifications des deux équipes dans la production sera simple et « sans couture ».
Il convient également de noter qu'en plus du low-code, il existe aussi des solutions no-code. En soi, ce sont des choses différentes. Le low-code permet dans une plus grande mesure au développeur d'intervenir dans le code généré. Dans le cas de Datagram, il est possible de visualiser et de modifier le code Scala généré, tandis que le no-code peut ne pas offrir cette possibilité. Cette différence est très significative non seulement en termes de flexibilité de la solution, mais aussi en termes de confort et de motivation au travail des data engineers.
Architecture de la solution
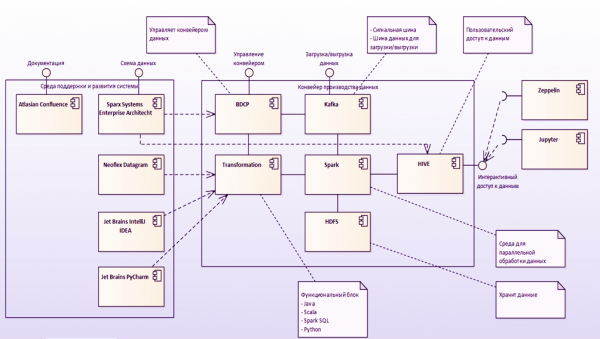
Essayons de comprendre comment un outil low-code aide à résoudre le problème d'optimisation de la vitesse de développement des fonctionnalités de calcul des données. Pour commencer, examinons l'architecture fonctionnelle du système. Dans ce cas, l'exemple est un modèle de production de données pour des recherches médiatiques.
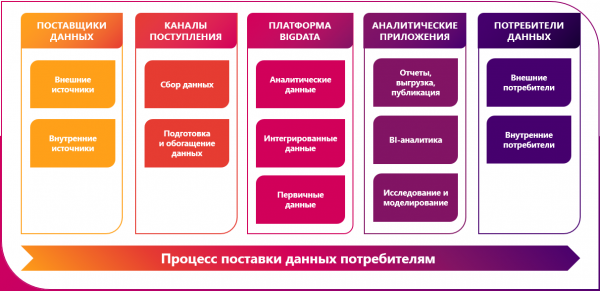
Les sources de données dans notre cas sont très hétérogènes et diverses :
- Les Peoplemetres (mètres de télévision) sont des dispositifs logiciels et matériels qui analysent le comportement des utilisateurs parmi les répondants du panel télévisé, en identifiant qui, quand et quelle chaîne ils ont regardée dans le foyer participant à l'étude. Les informations fournies constituent un flux d'intervalles d'audience directement lié aux forfaits médiatiques et aux produits médiatiques. Les données lors du chargement dans le Data Lake peuvent être enrichies d'attributs démographiques, de liens géographiques, de fuseaux horaires et d'autres informations nécessaires à l'analyse des audiences des différents produits médiatiques. Les mesures obtenues peuvent être utilisées pour analyser ou planifier des campagnes publicitaires, évaluer l'activité et les préférences du public, ainsi que pour élaborer une grille de programmes.
- Les données peuvent provenir de systèmes de surveillance de la télévision en streaming et de mesures de visionnage de contenus sur des plateformes vidéo en ligne.
- Les outils de mesure dans l'environnement web comprennent à la fois des compteurs centrés sur le site et des compteurs centrés sur l'utilisateur. Une extension de navigateur, le research bar, et une application mobile intégrée peuvent servir de fournisseurs de données pour le Data Lake. VPN.
- Les données peuvent également provenir de plateformes consolidant les résultats des enquêtes en ligne et les résultats des interviews téléphoniques réalisées dans les recherches de l'entreprise.
- L'enrichissement additionnel du Data Lake peut se faire par le chargement d'informations à partir des journaux des entreprises partenaires.
L'implémentation du chargement tel quel des systèmes sources vers un staging primaire de données brutes peut être organisée de différentes manières. Dans le cas où une approche low-code serait utilisée, il est possible de générer automatiquement des scénarios de chargement basés sur les métadonnées. Cela élimine la nécessité de descendre au niveau de développement de mappages source vers cible. Pour réaliser un chargement automatique, nous devons établir une connexion avec la source, puis définir dans l'interface de chargement la liste des entités à charger. La création de la structure des répertoires dans HDFS se fera automatiquement et correspondra à la structure de stockage des données dans le système source.
Cependant, dans le cadre de ce projet, nous avons décidé de ne pas utiliser cette capacité de la plateforme low-code, car la société Mediascope a déjà commencé à développer un service similaire basé sur Nifi + Kafka.
Il est important de préciser que ces outils ne sont pas interchangeables, mais se complètent plutôt. Nifi et Kafka peuvent fonctionner tant dans une liaison directe (Nifi -> Kafka) que dans l'autre sens (Kafka -> Nifi). La première option a été utilisée pour la plateforme de recherche médiatique.
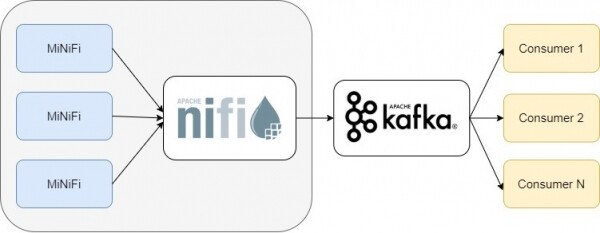
Dans notre cas, Nifi devait traiter différents types de données provenant des systèmes sources et les transmettre au broker Kafka. Dans ce contexte, l'acheminement des messages vers un topic spécifique de Kafka se faisait par l'utilisation de processeurs Nifi PublishKafka. L'orchestration et la gestion de ces pipelines sont réalisées via une interface visuelle. L'outil Nifi et l'utilisation de la combinaison Nifi + Kafka peuvent également être qualifiés d'approche low-code pour le développement, offrant un faible seuil d'entrée dans les technologies Big Data et accélérant le processus de développement d'applications.
La prochaine étape de la réalisation du projet consistait à formater un niveau sémantique uniforme de données détaillées. En cas de présence d'attributs historiques dans une entité, le calcul se fait dans le contexte de la partition considérée. Si l'entité n'est pas historique, il est optionnel de recalculer entièrement le contenu de l'objet ou d'abandonner complètement le recalcul de cet objet (en raison de l'absence de changements). À ce stade, des clés sont générées pour toutes les entités. Les clés sont sauvegardées dans les répertoires de master-objets Hbase correspondants, contenant la correspondance entre les clés de la plateforme analytique et les clés des systèmes sources. La consolidation des entités atomiques est accompagnée de l'enrichissement des résultats de pré-calcul des données analytiques. Le framework pour le calcul des données était Spark. La fonctionnalité décrite pour le formatage des données en une sémantique unique a également été mise en œuvre sur la base des mappings de l'outil low-code Datagram.
Dans l'architecture cible, il était nécessaire d'assurer un accès SQL aux données pour les utilisateurs métiers. Pour cette option, Hive a été utilisé. L'enregistrement des objets dans Hive se fait automatiquement lorsque l'option « Enregistrer la table Hive » est activée dans l'outil low-code.
Gestion du flux de calcul
Datagram a une interface pour la conception de flux de travail. Le lancement des mappages peut être effectué à l'aide du planificateur Oozie. Dans l'interface développeur des flux, il est possible de créer des schémas d'exécution de transformations de données parallèles, séquentielles ou dépendantes de conditions données. Il y a un support pour les scripts shell et les programmes Java. L'utilisation est également possible. de serveurs Apache Livy. Apache Livy est utilisé pour exécuter des applications directement depuis l'environnement de développement.
Si une entreprise possède déjà son propre orchestrateur de processus, il est possible d'utiliser l'API REST pour intégrer des mappages dans un flux existant. Par exemple, nous avons eu une expérience assez réussie d'intégration de mappages en Scala dans des orchestrateurs écrits en PLSQL et Kotlin. L'API REST de l'outil low-code implique des opérations telles que la génération d'une année exécutable basée sur le design du mappage, l'appel du mappage, l'appel d'une séquence de mappages et, bien sûr, la transmission de paramètres dans l'URL pour lancer les mappages.
En plus d'Oozie, il est possible d'organiser un flux de calcul avec Airflow. Je ne vais pas trop m'attarder sur la comparaison entre Oozie et Airflow, je dirai simplement que, dans le contexte des travaux sur le projet d'études médiatiques, le choix s'est porté sur Airflow. Les principaux arguments cette fois-ci étaient une communauté plus active développant le produit, et une interface + API plus avancées.
Airflow est également apprécié car il utilise le très apprécié Python pour décrire les processus de calcul. D'ailleurs, il n'existe pas beaucoup de plateformes de gestion des flux de travail open source. Le lancement et la surveillance de l'exécution des processus (y compris avec un diagramme de Gantt) ajoutent des points appréciables à la réputation d'Airflow.
Le format du fichier de configuration pour le lancement de mappages de solutions low-code est devenu spark-submit. Cela s'est produit pour deux raisons. Premièrement, spark-submit permet de lancer directement un fichier jar depuis la console. Deuxièmement, il peut contenir toutes les informations nécessaires pour configurer le flux de travail (ce qui facilite l'écriture de scripts formant le Dag).
L'élément le plus fréquemment rencontré dans notre flux de travail Airflow est devenu le SparkSubmitOperator.
Le SparkSubmitOperator permet de lancer des jar — des mappages Datagram emballés avec des paramètres d'entrée préalablement définis.
Il convient de mentionner que chaque tâche Airflow s'exécute dans un thread séparé et ne sait rien des autres tâches. Ainsi, l'interaction entre les tâches se fait via des opérateurs de contrôle tels que DummyOperator ou BranchPythonOperator.
L'utilisation conjointe de la solution low-code Datagram et de l'universalisation des fichiers de configuration (formant le Dag) a permis d'accélérer et de simplifier considérablement le processus de développement des flux de chargement de données.
Calcul des vitrines
Sans doute, l'étape la plus intellectuellement exigeante dans la production de données analytiques est la construction des vitrines. Dans le contexte de l'un des flux de calcul des données d'une société de recherche, à ce stade, une référence est établie en tenant compte du fuseau horaire en rapport avec la grille de diffusion. Une correction peut également être appliquée pour le réseau de diffusion local (actualités locales et publicité). Parmi d'autres, cette étape implique la segmentation des intervalles d'écoute continue des produits médiatiques basée sur l'analyse des intervalles d'écoute. C'est aussi à cette étape que se produit le « poids » des valeurs d'écoute en fonction des informations sur leur importance (calcul d'un coefficient de correction).
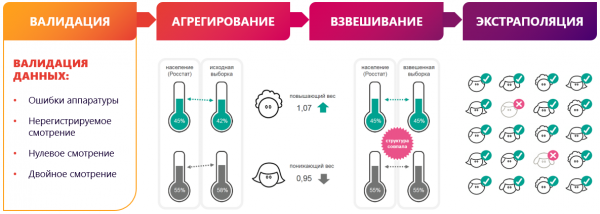
Une étape distincte de la préparation des vitrines est la validation des données. L'algorithme de validation est lié à l'application d'un certain nombre de modèles mathématiques. Cependant, l'utilisation d'une plateforme low-code permet de décomposer un algorithme complexe en plusieurs mappages lisibles visuellement. Chacun de ces mappages remplit une tâche spécifique. En conséquence, un débogage intermédiaire, un logging et une visualisation des étapes de préparation des données sont possibles.
Il a été décidé de discrétiser l'algorithme de validation en sous-étapes suivantes :
- Construction de régressions des dépendances d'écoute de la télé dans la région par rapport à l'écoute de toutes les chaînes dans la région sur 60 jours.
- Calcul des résidus studentisés (écarts entre les valeurs réelles et prévues par le modèle de régression) pour tous les points de régression et pour le jour de calcul.
- Échantillonnage des paires anormales région-télévision, où le résidu studentisé du jour de calcul dépasse la norme (définie par les paramètres de l'opération).
- Le recalcul du solde ajusté standardisé pour des paires anormales région-télé réseau pour chaque répondant ayant regardé le réseau dans la région, déterminant la contribution de ce répondant (le montant du changement du solde standardisé) en excluant la contribution de ce répondant de l'échantillon.
- Recherche de candidats dont l'exclusion ramène le solde standardisé du jour de calcul à la normale.
L'exemple ci-dessus confirme l'hypothèse selon laquelle un data engineer a déjà trop d'idées en tête… Et, si c'est vraiment un « ingénieur » et non un « codeur », alors la peur de la dégradation professionnelle due à l'utilisation d'outils low-code devrait le quitter définitivement.
Que peut faire de plus le low-code ?
Le champ d'application de l'outil low-code pour le traitement par lots et en flux de données sans nécessiter d'écriture manuelle de code en Scala ne s'arrête pas là.
L'utilisation de low-code dans le développement de datalakes est déjà devenue une certaine norme pour nous. On peut probablement dire que les solutions basées sur la pile Hadoop suivent le chemin de développement des DWH classiques basés sur les SGBD. Les outils low-code sur la pile Hadoop peuvent résoudre à la fois des tâches de traitement de données et des tâches de création d'interfaces BI finales. Il convient de noter que le BI peut ne pas seulement impliquer la représentation des données, mais aussi leur édition par des utilisateurs professionnels. Cette fonctionnalité est souvent utilisée par nous pour construire des plateformes analytiques pour le secteur financier.
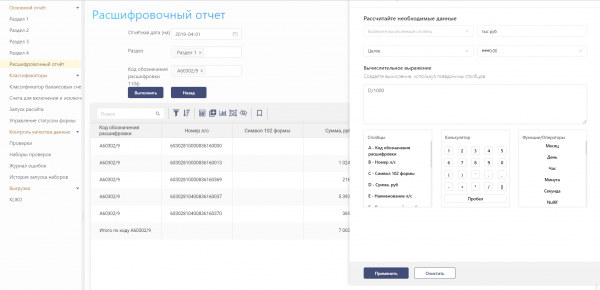
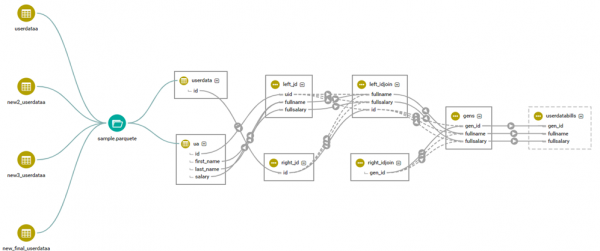
Parmi d'autres, grâce au low-code et en particulier à Datagram, il est possible de résoudre la problématique du suivi de l'origine des objets de flux de données avec une granularité jusqu'aux champs individuels (lineage). Pour cela, l'outil low-code intègre un couplage avec Apache Atlas et Cloudera Navigator. En essence, le développeur doit enregistrer une série d'objets dans les dictionnaires Atlas et faire référence à ces objets enregistrés lors de la construction des mappages. Le mécanisme de traçabilité des données ou d'analyse des dépendances des objets permet de gagner un temps considérable lors de la nécessité d'apporter des modifications aux algorithmes de calcul. Par exemple, lors de l'établissement de rapports financiers, cette fonctionnalité permet de mieux surmonter les périodes de changements législatifs. En effet, plus nous comprenons la dépendance inter-formulaire en ce qui concerne les objets du niveau détaillé, moins nous serons confrontés à des défauts « soudains » et nous réduirons le nombre de révisions.
Qualité des données & Low-code
Une autre tâche mise en œuvre par l'outil low-code dans le projet de la société Mediascope était de la classe Qualité des données. La particularité de la mise en œuvre du pipeline de vérification des données pour le projet de cette société de recherche était l'absence d'impact sur la fonctionnalité et la vitesse de l'écoulement principal du calcul des données. Pour orchestrer des flux indépendants de vérification des données, nous avons utilisé le déjà connu Apache Airflow. À mesure que chaque étape de production des données était prête, une partie distincte du pipeline DQ se lançait parallèlement.
Une bonne pratique consiste à surveiller la qualité des données dès leur création dans la plateforme analytique. En ayant des informations sur les métadonnées, nous pouvons déjà, dès l'entrée des informations dans la couche primaire, vérifier le respect des conditions de base — not null, contraintes, clés étrangères. Cette fonctionnalité est réalisée sur la base de mappages générés automatiquement de la famille qualité des données dans Datagram. La génération de code, dans ce cas, repose également sur les métadonnées du modèle. Dans le projet de la société Mediascope, le couplage s'est fait avec les métadonnées du produit Enterprise Architect.
Grâce au couplage de l'outil low-code et d'Enterprise Architect, les vérifications suivantes ont été générées automatiquement :
- Vérification de la présence de valeurs « null » dans les champs avec le modificateur « not null » ;
- Vérification de la présence de doublons de clé primaire ;
- Contrôle de la clé étrangère de l'entité;
- Vérification de l'unicité d'une ligne par ensemble de champs.
Pour des vérifications plus complexes de la disponibilité et de la fiabilité des données, un mappage avec Scala Expression a été créé, prenant en entrée le code Spark SQL externe de vérification, préparé par les analystes dans Zeppelin.
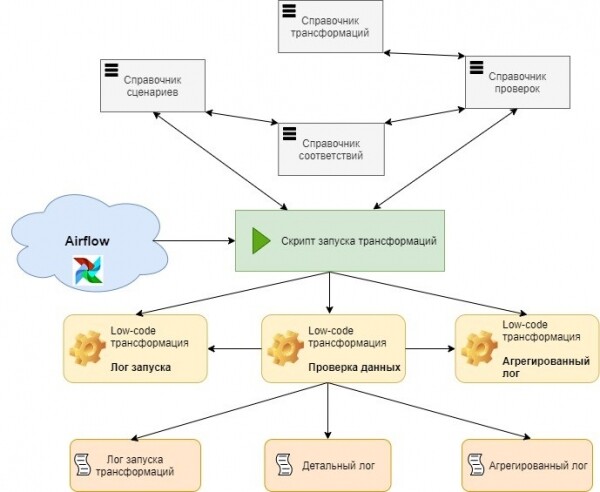
Bien sûr, l'autogénération des contrôles doit être abordée progressivement. Dans le cadre du projet décrit, les étapes suivantes ont précédé :
- DQ, implémentées dans des notebooks Zeppelin;
- DQ, intégrées dans le mappage;
- DQ sous forme de mappages massifs séparés, contenant un ensemble complet de vérifications pour chaque entité;
- Mappages DQ universels paramétrés, prenant en entrée des informations sur les métadonnées et les contrôles métiers.
Sans doute, le principal avantage de la création d'un service de vérifications paramétrées est la réduction du temps de livraison des fonctionnalités dans l'environnement de production. De nouveaux contrôles de qualité peuvent contourner le modèle classique de livraison de code, indirectement via les environnements de développement et de test :
- Tous les contrôles de métadonnées sont générés automatiquement lors de la modification du modèle dans l'EA;
- Les contrôles de disponibilité des données (détermination de la présence de certaines données à un moment donné) peuvent être générés sur la base d'un annuaire stockant le timing attendu de l'apparition de la prochaine série de données par objets;
- Les contrôles métiers de fiabilité des données sont réalisés par les analystes dans des notebooks Zeppelin. Ceux-ci sont directement envoyés dans les tableaux de configuration du module DQ dans l'environnement de production.
Les risques d'envoi direct de scripts en production sont pratiquement inexistants. Même en cas d'erreur syntaxique, la pire chose qui pourrait arriver serait de ne pas exécuter un contrôle, car le flux de calcul des données et le flux de lancement des contrôles de qualité sont séparés.
Essentiellement, le service DQ est en permanence actif dans l'environnement de production et prêt à commencer son travail dès l'arrivée d'une nouvelle série de données.
En conclusion
L'avantage d'utiliser le low-code est évident. Les développeurs n'ont pas besoin de créer une application « de zéro ». De plus, un programmeur libéré de tâches supplémentaires obtient des résultats plus rapidement. La vitesse, à son tour, libère des ressources supplémentaires en temps pour résoudre des questions d'optimisation. Par conséquent, dans ce cas, on peut s'attendre à une solution de meilleure qualité et plus rapide.
Bien sûr, le low-code n'est pas une panacée, et la magie ne se produira pas d'elle-même :
- L'industrie du low-code traverse une phase de « consolidation », et il n'existe pas encore de normes industrielles homogènes ;
- De nombreuses solutions low-code ne sont pas gratuites, et leur acquisition doit être un choix réfléchi, à faire uniquement avec une certitude totale de la rentabilité financière de leur utilisation ;
- De nombreuses solutions low-code ne s'entendent pas toujours bien avec GIT / SVN. Elles peuvent être difficiles à utiliser en cas de masquage du code généré ;
- Lors de l'expansion de l'architecture, des ajustements de la solution low-code peuvent être nécessaires - ce qui, à son tour, provoque un effet de « dépendance » vis-à-vis du fournisseur de la solution low-code.
- Un niveau de sécurité adéquat est possible, mais il est très laborieux et complexe à mettre en œuvre pour les moteurs des systèmes low-code. Les plateformes low-code ne devraient pas être choisies uniquement en fonction de la recherche de bénéfices liés à leur utilisation. Lors du choix, il convient de se poser des questions sur la présence de fonctionnalités de gestion des accès et de délégation / escalade des données d'identification au niveau de l'ensemble du paysage informatique de l'organisation.
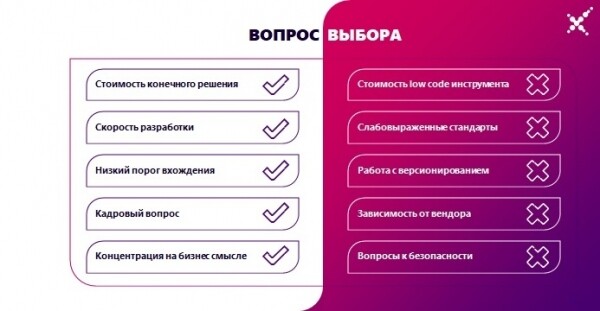
Cependant, si tous les inconvénients du système choisi vous sont connus, et que les bénéfices de son utilisation sont néanmoins dominants, alors passez au low-code sans crainte. D'autant plus que la transition vers celui-ci est inévitable - tout comme toute évolution.
Si un développeur sur une plateforme low-code peut accomplir son travail plus rapidement que deux développeurs sans low-code, alors cela donne à l'entreprise un avantage sur tous les fronts. Le seuil d'accès aux solutions low-code est plus bas que celui des technologies « traditionnelles », ce qui a un impact positif sur le problème de la pénurie de main-d'œuvre. L'utilisation d'outils à faible code permet d'accélérer l'interaction entre les équipes fonctionnelles et de prendre des décisions plus rapides sur la validité du chemin choisi pour des recherches en data science. Les plateformes à faible code peuvent être à l'origine de la transformation numérique de l'organisation, car les solutions produites peuvent être comprises par des non-techniques (en particulier, des utilisateurs métier).
Si vous avez des délais serrés, une logique commerciale complexe, une pénurie d'expertise technologique, et que vous devez accélérer le time to market, alors le low-code est l'un des moyens de répondre à vos besoins.
Il ne faut pas sous-estimer l'importance des outils de développement traditionnels, cependant, dans de nombreux cas, l'application de solutions à faible code est le meilleur moyen d'augmenter l'efficacité des tâches à accomplir.
Source : habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish