

Bonjour à tous !
Je m'appelle Masha, je travaille en tant qu'ingénieure qualité au sein du groupe Tinkoff. Le travail en QA implique de nombreuses communications avec différentes personnes provenant de différentes équipes, et j'ai également été manager et formatrice de programmes éducatifs, donc ma carte de communication était très large. À un moment donné, j'ai explosé : j'ai réalisé que je ne pouvais plus, je ne pouvais plus, je ne pouvais plus remplir d'énormes tonnes de tableaux et de documents illisibles.
Chacun d'entre vous a sûrement imaginé ce dont je parle en ce moment et a commencé à transpirer à froid : des listes de noms sans ordre alphabétique, des tableaux de centaines de colonnes avec une mise en page complètement décalée, des tableaux de milliers de lignes dans lesquels il faut frotter son doigt sur la molette de la souris pour voir le titre, des tonnes de pages d'instructions non numérotées, des centaines de mails transférés les uns aux autres avec des données à analyser, systématiser et fourrer dans ces mêmes tableaux illisibles.
Et donc, quand j'ai un peu refroidi, j'ai décidé d'écrire cet article. Je vais parler de la manière de gérer correctement (et parfois même confortablement) la documentation non produit. J'espère que l'article se répandra sur le web et que le niveau de désordre dans les départements voisins du développement diminuera un peu, rendant les gens (et moi y compris) un peu plus heureux.
Outils
La documentation produit est souvent stockée à côté du code, ce qui est bien. La documentation non produit, en revanche, traîne souvent n'importe où. Les gens essaient souvent de déplacer des informations depuis différents endroits vers Confluence, et nous ne faisons pas exception. Donc, tout le récit qui suit en parlera.
Confluence est en fait un moteur de wiki avancé. Il permet de travailler avec des données sous différentes formes d'affichage : texte formaté, tableaux, divers diagrammes. C'est un outil très intéressant et puissant, mais si on ne sait pas comment l'utiliser correctement, on obtient un fouillis de documents illisibles. Je vais vous apprendre à l'utiliser !
Macros
La plupart des fonctionnalités de Confluence reposent sur les macros. Il y a beaucoup de macros, et elles peuvent être combinées entre elles. Certaines sont payantes et d'autres gratuites, et par la suite, il y aura différents exemples de macros avec des liens vers leur documentation.
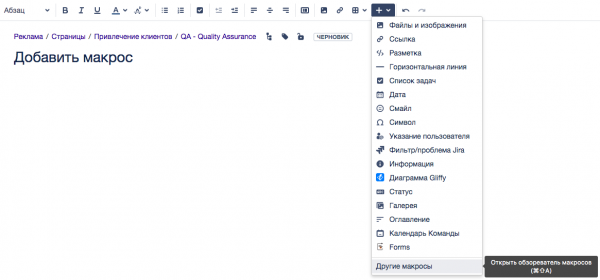
L'interface de travail avec les macros est extrêmement simple. Pour ajouter une macro, il suffit de cliquer sur le plus et de sélectionner l'élément souhaité dans la liste.
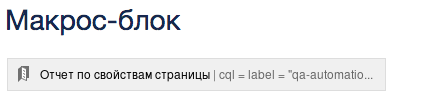
Si le macro est autonome, c'est-à-dire qu'il ne nécessite rien d'autre en son sein, il apparaît comme un bloc.
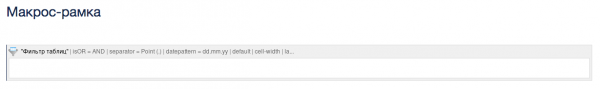
Si le macro nécessite quelque chose à insérer à l'intérieur, il apparaît comme un cadre.
Dans ce cas, vous pouvez insérer autant d'autres éléments que vous le souhaitez dans un seul cadre, tant que votre pyramide a du sens.
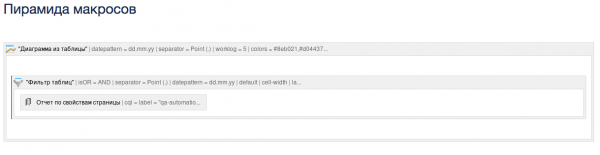
Chaque macro a un aperçu : il montre immédiatement si vous avez correctement rempli et configuré le macro.
Modèles
En plus des macros, il existe un outil pratique de pré-remplissage de contenu : le modèle.
Les modèles peuvent être utilisés lors de la création de n'importe quelle page : il suffit de cliquer sur les trois points à côté du bouton « Créer » et de choisir le modèle souhaité.
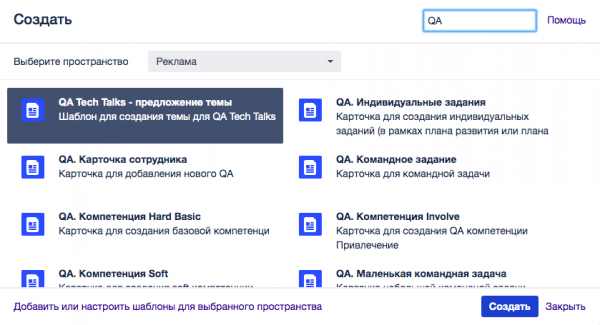
Alors, tout le contenu présent dans le modèle sera ajouté à la page créée.
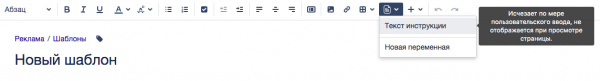
Toute personne peut créer des pages à partir de modèles, mais seuls ceux qui ont les droits peuvent créer ou modifier les modèles eux-mêmes. Des instructions supplémentaires peuvent être ajoutées au modèle pour indiquer comment la page doit être gérée.
La magie des tableaux
En fait, en tant que technicien, j'aime tendrement les tableaux et je peux encapsuler presque n'importe quelle information en eux (bien que ce ne soit pas toujours efficace). Les tableaux en eux-mêmes sont clairs, structurés, scalables, magiques !
Mais même une entité aussi merveilleuse qu'un tableau peut être gâchée. Cependant, elle peut aussi être utilisée avec succès et même améliorée. C'est ce dont je vais parler ci-dessous.
Filtrage (plugin payant)
N'importe quel tableau énorme et illisible peut devenir un peu moins gigantesque et un peu plus lisible grâce au filtrage. Pour cela, on peut utiliser un macro payant. .
À l'intérieur de ce macro, il faut insérer le tableau (même le plus laid, l'important est de le mettre dans son intégralité). Dans le macro, vous pouvez choisir les colonnes à filtrer via une liste déroulante, un filtre textuel, numérique et un filtre par date.
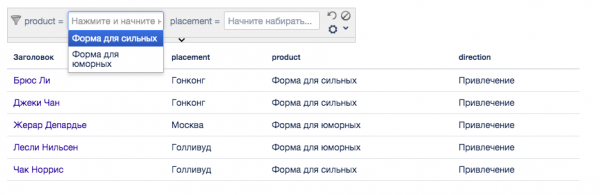
Imaginez que toutes les informations sur les candidats pour tous les postes sont enregistrées dans une liste tabulaire. Naturellement, ils ne sont pas triés — les gens ne viennent pas aux entretiens par ordre alphabétique. Et vous devez comprendre si vous avez déjà eu un entretien avec un candidat particulier. Il vous suffit de mettre ce chaos dans le macro de filtrage, d'ajouter un filtre textuel par nom de famille — et voilà, l'information est à l'écran.
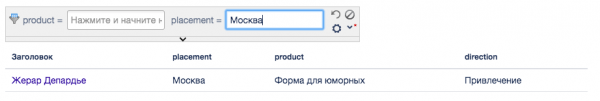
Il convient de noter que le filtrage de grandes tables peut affecter le fonctionnement du système et le temps de chargement des pages. Par conséquent, mettre une énorme table dans un filtre est une solution temporaire. Il est préférable de mettre en place un processus qui évite de créer d'énormes tables illisibles (un exemple de processus sera donné à la fin de l'article).
Tri (plugin payant)
Avec la magie d'un macro , il est également possible de définir un tri par défaut pour n'importe quelle colonne et de numéroter les lignes. Ou cliquez sur n'importe quelle colonne de la table incluse dans le macro filtre, et le tri par cette colonne s'effectuera.
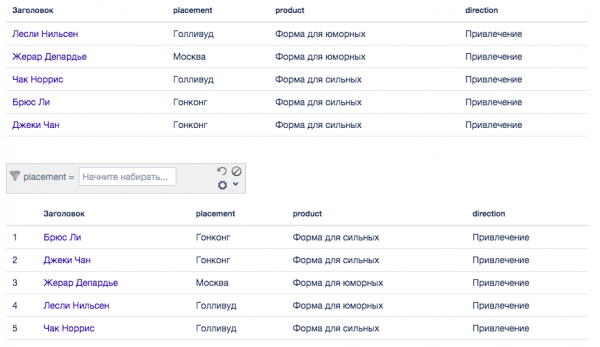
Par exemple, si vous avez la même table avec des candidats et que vous devez estimer combien d'entretiens ont été réalisés au cours d'un mois donné, triez par date et réjouissez-vous.
Tableaux croisés (plugin payant)
Passons maintenant à un cas plus intéressant. Imaginez que votre tableau est énorme et que vous devez effectuer des calculs sur celui-ci. Bien sûr, vous pouvez le copier dans Excel, faire les calculs nécessaires et réimporter les données dans Confluence. Mais vous pouvez aussi appliquer une fois le macro , et obtenir le même résultat, mais qui est en plus actualisable.
Par exemple : si vous avez un tableau contenant les données de tous les employés — où ils se trouvent géographiquement et quels postes ils occupent — pour compter combien de personnes se trouvent dans chaque ville, vous devez sélectionner dans le macro «Tableau croisé» la ligne selon laquelle les données sont agrégées (localisation) et le type d'opération (somme).
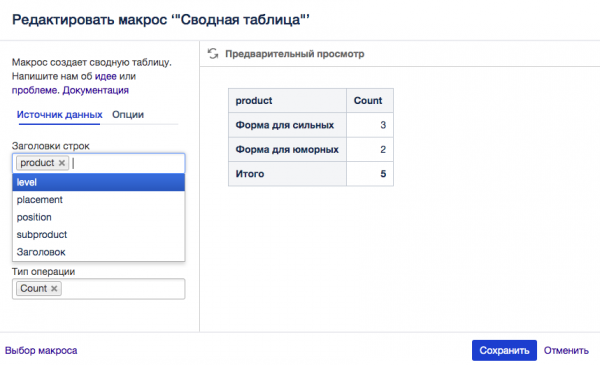
Évidemment, il est possible de regrouper selon plusieurs critères simultanément, toutes les options peuvent être consultées. .
Graphiques (plugin payant)
Comme je l'ai déjà dit, tout le monde n'aime pas les tables autant que moi. Malheureusement, les managers, pour la plupart, ne les apprécient pas du tout. En revanche, tout le monde aime les graphiques colorés et éclatants.
Les créateurs de Confluence le savaient sans doute (ils ont sûrement un patron qui aime les rapports et les graphiques, quel malheur). Donc, vous pouvez utiliser le magique macro . Dans ce macro, il faut placer le tableau croisé du point précédent, et voilà — vos données grises et ennuyeuses sont joliment visualisées.
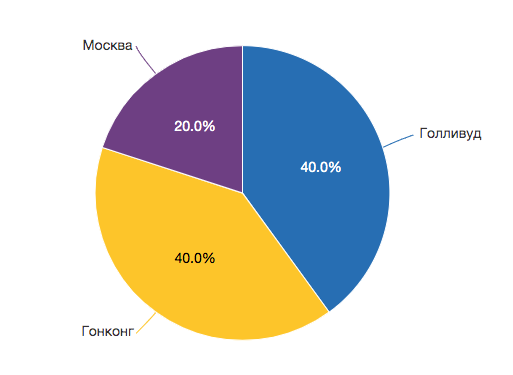
Évidemment, ce macro a aussi des paramètres. Vous pouvez trouver le lien vers la documentation de n'importe quel macro en mode d'édition de ce dernier.
Simplicité de l'agrégation
Les informations des sections précédentes n'ont sûrement pas été une révélation pour vous. Mais maintenant, vous savez comment utiliser les macros, et je peux passer à une partie plus intéressante de l'article.
Étiquettes
C'est problématique lorsque les gens conservent des informations dans un seul article non structuré ou un énorme tableau. Encore pire – lorsque certaines de ces informations sont non seulement mal présentées, mais aussi éparpillées dans Confluence. Heureusement, il est possible de rassembler les informations éparpillées au même endroit. Pour cela, il faut utiliser (connu sous le nom de tags sur les réseaux sociaux).
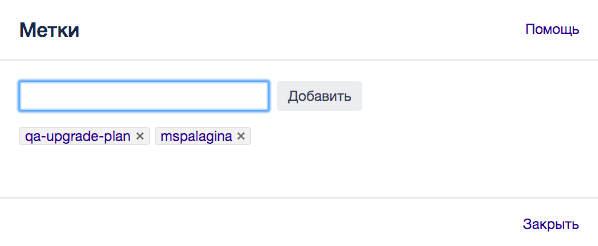
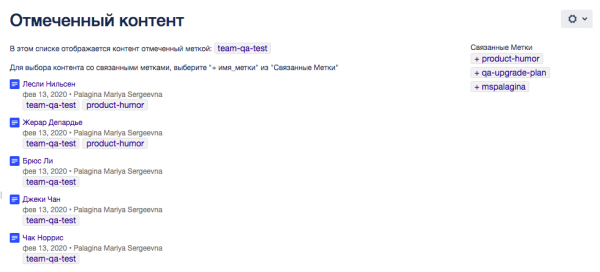
On peut ajouter un nombre illimité d'étiquettes à n'importe quelle page. En cliquant sur une étiquette, vous accéderez à une page d'agrégation, où se trouvent des liens vers tous les documents portant cette étiquette, ainsi qu'un ensemble d'étiquettes associées. Les étiquettes associées sont celles qui apparaissent souvent sur une même page.
Propriétés des pages
On peut également ajouter une autre macro intéressante pour structurer l'information – . À l'intérieur, il faut fournir un tableau de deux colonnes, la première étant la clé et la seconde la valeur de la propriété. En outre, la macro peut être masquée sur la page pour ne pas gêner la lecture du contenu, tout en permettant que la page soit toujours marquée avec les clés nécessaires.
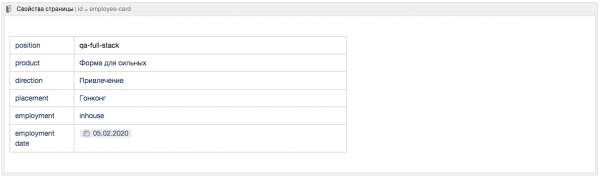
Faites attention à l'ID – il est pratique de le définir pour attribuer différents groupes de propriétés à différentes pages (ou même à différents groupes de propriétés sur une seule page).
Rapports
Des rapports peuvent être générés à partir des étiquettes. Par exemple, la macro rassemble toutes les pages avec un ensemble spécifique d'étiquettes.
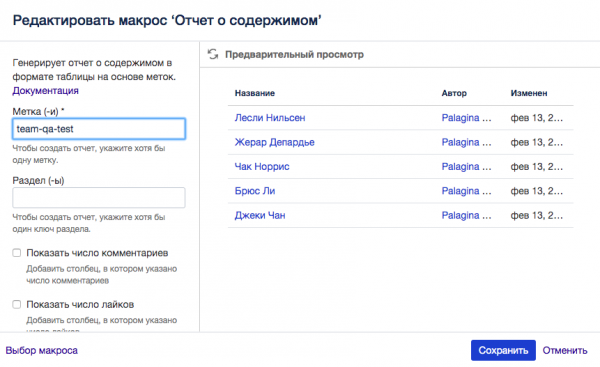
Mais un rapport plus intéressant est la macro . Elle collecte également toutes les pages avec un certain ensemble d'étiquettes, mais ne se contente pas de les lister, elle crée un tableau (vous saisissez le lien avec le début de l'article ?), où les colonnes sont les clés des propriétés de la page.
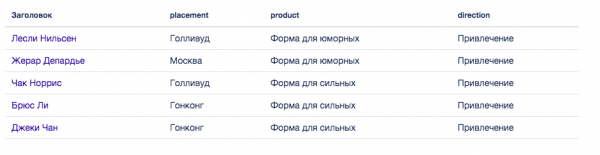
Cela crée un tableau récapitulatif des informations de différentes sources. Il est agréable de noter qu'il dispose de fonctions pratiques : un design adaptatif, un tri par n'importe quelle colonne. De plus, ce tableau de rapport peut être configuré à l'intérieur de la macro.
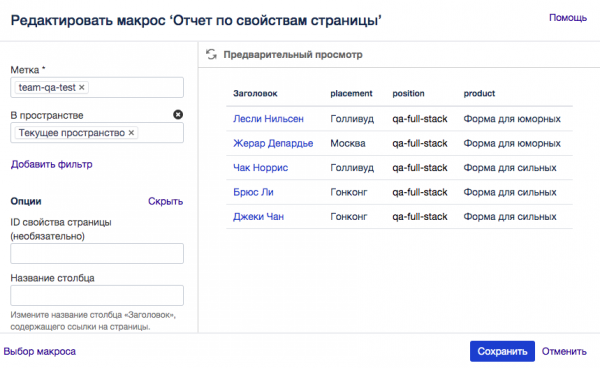
Lors de la configuration, il est possible de retirer certaines colonnes du rapport, de définir un état par défaut ou un nombre d'enregistrements affichés. Il est également possible de définir l'ID de la propriété de la page pour ne voir que les informations nécessaires.
Par exemple, vous avez plusieurs pages d'employés, et ces pages ont un ensemble de propriétés concernant la personne : quel est son niveau, où il se trouve, quand il a rejoint l'équipe, etc. Ces propriétés sont marquées. ID = employee_inf. Et il y a un deuxième ensemble de propriétés sur cette même page, qui rassemble des informations sur la personne en tant que membre de l'équipe : quel rôle la personne joue, dans quelle équipe elle se trouve, etc. Ces propriétés sont marquées. ID = team_inf. Ainsi, lors de la génération de rapports, vous pouvez afficher uniquement les informations pour un seul identifiant ou pour les deux — comme cela vous arrange.
La beauté de cette approche est que chacun peut rassembler le tableau d'informations dont il a besoin, qui ne contiendra aucune duplication et sera mis à jour lors des mises à jour de la page principale. Par exemple : un team lead ne se soucie pas du moment où ses développeurs ont été embauchés, mais il est important de savoir quel rôle chacun d'eux joue dans l'équipe. Le team lead rassemblera un rapport sur l'équipe. Et un comptable se moque totalement de qui joue quel rôle, mais les postes sont importants — il rassemblera un rapport basé sur les postes. Dans ce cas, la source d'information ne sera ni dupliquée ni déplacée.
Processus final
Instruction
Ainsi, nous pouvons structurer joliment et agréger efficacement les informations dans Confluence en utilisant des macros. Mais idéalement, il faut s'assurer que les nouvelles informations soient immédiatement structurées et intégrées dans tous les mécanismes d'agrégation déjà utilisés.
Ici, l'association de macros et de templates viendra à l'aide. Pour inciter les gens à créer de nouvelles pages dans le format requis, vous pouvez utiliser la macro « Créer à partir d'un modèle ». Elle ajoute un bouton sur la page, qui, lorsqu'il est cliqué, crée une nouvelle page à partir du modèle souhaité. Ainsi, vous obligez les gens à travailler directement dans le format souhaité.
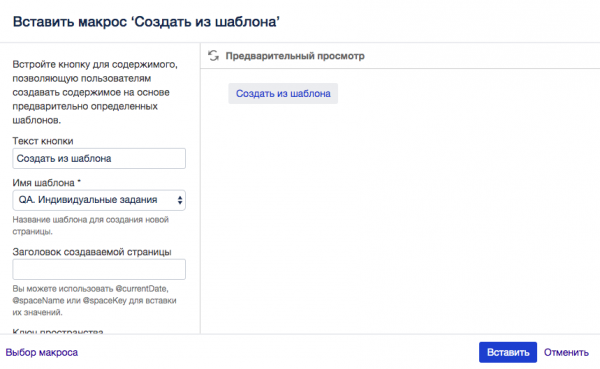
Dans le modèle à partir duquel vous autorisez la création de pages, il est nécessaire d'ajouter à l'avance des étiquettes, la macro « Propriétés de la page » et un tableau des propriétés dont vous avez besoin. Je vous recommande également d'ajouter des instructions sur les valeurs devant être renseignées sur la page et les valeurs des propriétés.
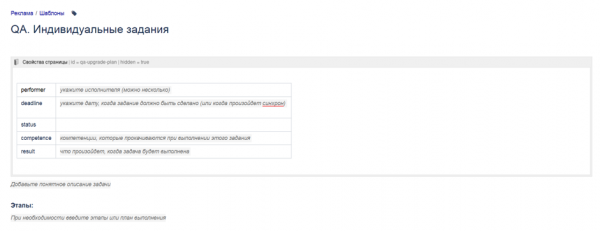
Le processus final apparaîtra ainsi :
- Vous créez un modèle pour des informations d'un type spécifique.
- Dans ce modèle, vous ajoutez des étiquettes et des propriétés de page dans la macro.
- Dans n'importe quel endroit confortable, créez une page racine avec un bouton, sur lequel un clic crée une page fille à partir d'un modèle.
- Vous autorisez les utilisateurs potentiels à accéder à la page racine, qui généreront les informations nécessaires (selon le modèle souhaité, en cliquant sur le bouton).
- Vous compilez un rapport basé sur les propriétés de la page via les balises que vous avez spécifiées dans le modèle.
- Vous vous réjouissez : vous avez toutes les informations nécessaires dans un format pratique.
Les pièges
En tant qu'ingénieur qualité, je peux affirmer sans hésitation qu'il n'y a rien de parfait dans le monde. Même les tableaux divins ne sont pas parfaits. Et dans le processus décrit ci-dessus, il y a des écueils.
- Si vous décidez de changer les noms ou la composition des propriétés de la page, vous devrez mettre à jour tous les objets déjà créés afin que leurs données soient correctement intégrées dans le rapport consolidé. C'est dommage, mais d'un autre côté, cela force à réfléchir en détail à l'« architecture » de votre ensemble d'informations, ce qui est une tâche très intéressante.
- Vous devrez rédiger un nombre considérable d'instructions sur la façon de remplir les tableaux d'information et d'utiliser les balises. Mais, d'un autre côté, vous pouvez simplement envoyer cet article à toutes les personnes concernées.
Exemple de stockage de documentation non produit
Grâce au processus décrit ci-dessus, il est possible d'organiser le stockage de presque toutes les informations. L'avantage de cette approche est qu'elle est universelle : une fois que les utilisateurs s'y habituent, ils cessent de générer du désordre. Un autre gros avantage (mais pas gratuit) est la possibilité de collecter instantanément diverses statistiques et de créer de beaux graphiques.
Je vais donner un exemple de notre processus de gestion des informations sur l'équipe.
Pour chaque membre de l'équipe, nous avons décidé de créer une fiche de personnel. Ainsi, nous avons un modèle selon lequel chaque nouvelle personne crée sa propre fiche et y consigne toutes les informations personnelles.
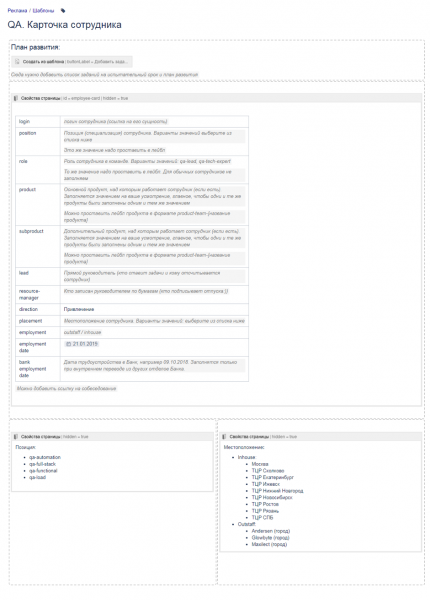
Comme vous pouvez le voir, nous avons un tableau détaillé des propriétés et il y a déjà des instructions sur la manière de gérer cette page. Certaines balises sont mises en place par les employés selon les instructions, dans le modèle seules les principales balises : balise de la fiche employee-card, balise de direction direction-involve et balise d'équipe team-qa.
Au final, après que chacun a créé sa propre carte, cela donne un tableau complet d'informations sur les employés. Cette information peut être utilisée à différents endroits. Les gestionnaires de ressources peuvent rassembler des tableaux généraux, tandis que les leads d'équipe peuvent créer des tableaux d'équipe en ajoutant des tags d'équipe à leur sélection.
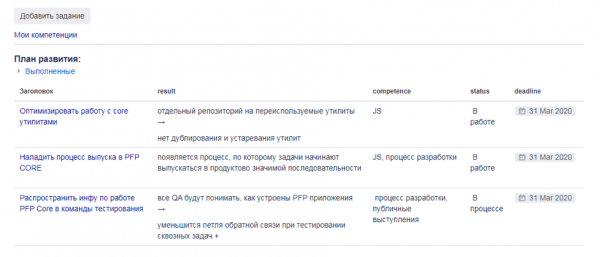
Par les tags, vous pouvez voir différents résumés, par exemple sur qa-upgrade-plan toutes les tâches de développement QA s'afficheront. Chaque personne, dans sa carte d'employé, entretient une histoire importante et son plan de développement – créant une page imbriquée à partir du modèle de plans de développement.
Conclusion
Rédigez toute documentation de manière à ce que vous n'ayez pas à en avoir honte et que les utilisateurs n'en souffrent pas !
J'espère vraiment que cet article sera utile et qu'un ordre régnera dans toutes les documentations du monde.
Source : habr.com
