

Les applications web sont désormais omniprésentes, et parmi tous les protocoles de transport, HTTP en occupe une grande partie. En explorant les subtilités du développement d'applications web, la plupart des gens accordent très peu d'attention au système d'exploitation sur lequel ces applications s'exécutent réellement. La séparation entre le développement (Dev) et l'exploitation (Ops) n'a fait qu'aggraver la situation. Cependant, avec la montée de la culture DevOps, les développeurs commencent à assumer la responsabilité de la mise en route de leurs applications dans le cloud. Il est donc très utile pour eux de se familiariser en profondeur avec le backend du système d'exploitation. Cela est particulièrement bénéfique si vous essayez de déployer un système pour des milliers ou des dizaines de milliers de connexions simultanées.
Les restrictions dans les services web ressemblent beaucoup à celles rencontrées dans d'autres applications. Que ce soit les équilibreurs de charge ou les serveurs de bases de données, toutes ces applications présentent des problèmes similaires dans un environnement hautes performances. Comprendre ces limitations fondamentales et les moyens de les surmonter permettra d'évaluer la performance et la scalabilité de vos applications web.
J'écris cette série d'articles en réponse aux questions de jeunes développeurs qui souhaitent devenir des architectes systèmes bien informés. Il est impossible de comprendre clairement les méthodes d'optimisation des applications Linux sans plonger dans leurs fondements et leur fonctionnement au niveau du système d'exploitation. Bien qu'il existe de nombreux types d'applications, dans ce cycle, je souhaite explorer les applications réseau plutôt que les applications de bureau comme les navigateurs ou les éditeurs de texte. Ce matériel s'adresse aux développeurs et architectes qui souhaitent comprendre comment fonctionnent les programmes Linux ou Unix et comment les structurer pour des performances élevées.
Linux est un système d'exploitation serveur, et la plupart du temps, vos applications fonctionnent sur ce système d'exploitation. Bien que je dise « Linux », vous pouvez souvent supposer avec confiance que cela fait référence à toutes les systèmes d'exploitation de type Unix au sens large. Cependant, je n'ai pas testé le code d'accompagnement sur d'autres systèmes. Donc, si vous êtes intéressé par FreeBSD ou OpenBSD, les résultats peuvent varier. Lorsque j'essaie quelque chose de spécifique à Linux, je l'indique.
Bien que vous puissiez utiliser les connaissances acquises pour créer une application depuis zéro, qui sera parfaitement optimisée, il est préférable de ne pas le faire. Si vous écrivez un nouveau serveur web en C ou C++ pour l'application commerciale de votre organisation, cela pourrait être votre dernier jour de travail. Cependant, connaître la structure de ces applications vous aidera à choisir parmi les programmes existants. Vous pourrez comparer les systèmes basés sur les processus avec ceux basés sur les threads, ainsi que sur les événements. Vous comprendrez et apprécierez pourquoi Nginx fonctionne mieux qu'Apache httpd, et pourquoi une application Python basée sur Tornado peut servir plus d'utilisateurs qu'une application Python basée sur Django.
ZeroHTTPd : outil d'apprentissage
— un serveur web que j'ai écrit depuis zéro en C en tant qu'outil pédagogique. Il n'a aucune dépendance externe, y compris l'accès à Redis. Nous exécutons nos propres procédures Redis. Pour plus de détails, voir ci-dessous.
Bien que nous puissions discuter longuement de la théorie, rien ne vaut le fait d'écrire du code, de l'exécuter et de comparer toutes les architectures de serveurs. C'est la méthode la plus illustrative. Par conséquent, nous allons écrire le simple serveur web ZeroHTTPd, en appliquant chaque modèle : basé sur des processus, des threads et des événements. Nous vérifierons chacun de ces serveurs et verrons comment ils fonctionnent les uns par rapport aux autres. ZeroHTTPd est implémenté dans un seul fichier C. Le serveur basé sur les événements comprend , une excellente implémentation de table de hachage qui est fournie dans un seul fichier d'en-tête. Dans les autres cas, il n'y a aucune dépendance afin de ne pas compliquer le projet.
Le code contient de nombreux commentaires pour aider à la compréhension. Étant un simple serveur web en quelques lignes de code, ZeroHTTPd sert également de cadre minimal pour le développement web. Il a une fonctionnalité limitée, mais il est capable de servir des fichiers statiques et des pages 'dynamiques' très simples. Je dois dire que ZeroHTTPd est bien adapté pour apprendre à créer des applications Linux haute performance. En principe, la plupart des services web attendent des requêtes, les vérifient et les traitent. C'est exactement ce que fera ZeroHTTPd. C'est un outil d'apprentissage, pas un outil de production. Il n'est pas fort en gestion d'erreurs et n'a probablement pas les meilleures pratiques de sécurité (oh oui, j'ai utilisé strcpy) ou des tours de langage en C. Mais j'espère qu'il s'en sortira bien avec sa tâche.
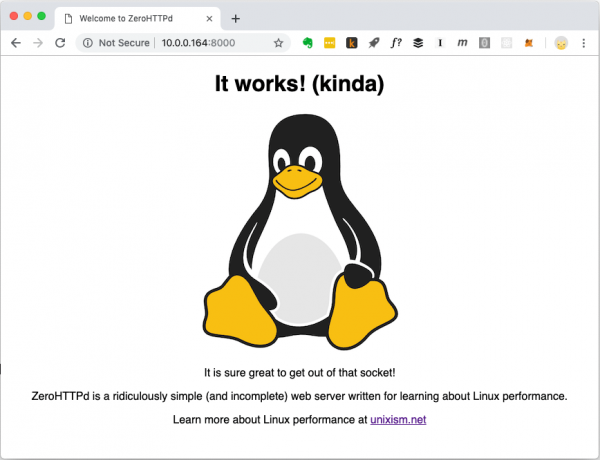
Page d'accueil de ZeroHTTPd. Il peut fournir différents types de fichiers, y compris des images.
Application de livre d'or
Les applications web modernes ne se limitent généralement pas aux fichiers statiques. Elles ont des interactions complexes avec diverses bases de données, caches, etc. Nous allons donc créer une simple application web appelée « Livre d'or », où les visiteurs laissent des messages sous leurs noms. Le livre d'or conserve les messages laissés auparavant. Il y a aussi un compteur de visiteurs en bas de la page.
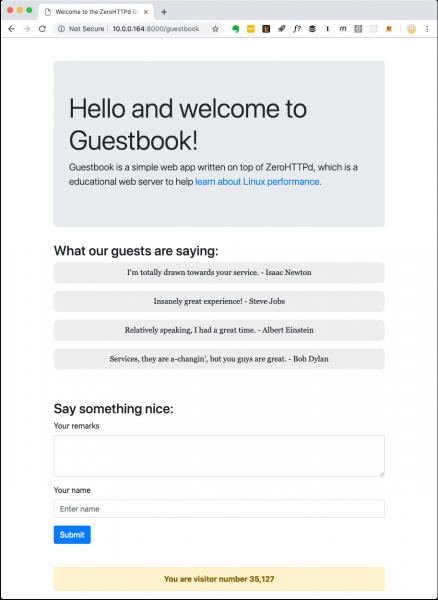
Application web « Livre d'or » ZeroHTTPd
Le compteur de visiteurs et les messages du livre d'or sont stockés dans Redis. Des procédures personnalisées ont été mises en place pour communiquer avec Redis, indépendamment des bibliothèques externes. Je ne suis pas un grand fan de développer un code maison alors qu'il existe des solutions publiques et bien testées. Mais l'objectif de ZeroHTTPd est d'explorer la performance de Linux et l'accès aux services externes, tandis que le traitement des requêtes HTTP a un impact significatif sur la performance. Nous devons contrôler complètement les communications avec Redis dans chacune de nos architectures serveur. Dans une architecture, nous utilisons des appels bloquants, tandis que dans d'autres, nous utilisons des procédures basées sur les événements. L'utilisation d'une bibliothèque cliente Redis externe ne fournirait pas un tel contrôle. De plus, notre petit client Redis exécute seulement quelques fonctions (obtenir, configurer et incrémenter une clé ; obtenir et ajouter à un tableau). De plus, le protocole Redis est d'une élégance et d'une simplicité exceptionnelles. On n'a même pas besoin d'apprendre spécifiquement à l'utiliser. Le fait que tout le travail du protocole soit réalisé en environ cent lignes de code montre à quel point il est bien conçu.
La figure suivante montre les actions de l'application lorsque le client (navigateur) fait une demande. /guestbookURL.

Mécanisme de fonctionnement de l'application livre d'or
Lorsqu'il est nécessaire de délivrer une page du livre d'or, un appel est effectué au système de fichiers pour lire le modèle en mémoire et trois appels réseau à Redis. Le fichier modèle contient la majeure partie du contenu HTML de la page visible sur la capture d'écran ci-dessus. Il y a également des espaces réservés spéciaux pour la partie dynamique du contenu : les entrées et le compteur de visiteurs. Nous les récupérons depuis Redis, les insérons sur la page et délivrons un contenu complètement formé au client. Le troisième appel à Redis peut être évité car Redis renvoie une nouvelle valeur de la clé lorsqu'elle est incrémentée. Cependant, pour notre serveur avec une architecture asynchrone basée sur des événements, de nombreux appels réseau constituent une bonne épreuve à des fins éducatives. Ainsi, nous dédaignons la valeur renvoyée par Redis concernant le nombre de visiteurs et la demandons dans un appel séparé.
Architectures serveurs ZeroHTTPd
Nous construisons sept versions de ZeroHTTPd avec des fonctionnalités identiques, mais avec des architectures différentes :
- Itérative
- Serveur fork (un processus fils par requête)
- Serveur pré-fork (forking de processus à l'avance)
- Serveur avec des threads d'exécution (un thread par requête)
- Serveur avec threads pré-créés
- Architecture basée sur
poll() - Architecture basée sur
epoll
Nous mesurons la performance de chaque architecture en chargeant le serveur avec des requêtes HTTP. Mais lors de la comparaison des architectures avec un haut degré de parallélisme, le nombre de requêtes augmente. Nous effectuons trois tests et calculons la moyenne.
Méthodologie de test
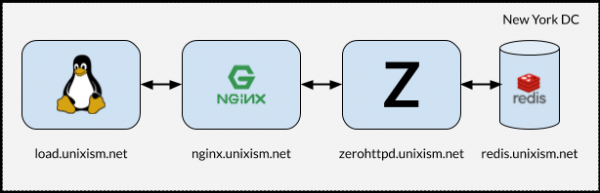
Configuration pour le test de charge de ZeroHTTPd
Il est important que, lors de l'exécution des tests, tous les composants ne fonctionnent pas sur une seule machine. Dans ce cas, le système d'exploitation entraîne des frais généraux supplémentaires en raison de la planification, car les composants rivalisent pour le CPU. Mesurer les frais généraux du système d'exploitation avec chacune des architectures serveur choisies est l'un des objectifs les plus importants de cet exercice. L'ajout de variables supplémentaires serait préjudiciable au processus. Par conséquent, la configuration illustrée ci-dessus fonctionne le mieux.
Que fait chacun de ces serveurs
- load.unixism.net : ici nous exécutons
ab, l'outil Apache Benchmark. Il génère la charge nécessaire pour tester nos architectures serveurs. - nginx.unixism.net : parfois, nous voulons exécuter plusieurs instances d'un programme serveur. Pour cela, le serveur Nginx, avec les configurations appropriées, fonctionne comme un répartiteur de charge recevant des requêtes de ab nos processus serveur.
- zerohttpd.unixism.net : ici, nous exécutons nos programmes serveur sur sept architectures différentes, un à la fois.
- redis.unixism.net : sur ce serveur, le démon Redis fonctionne, où les enregistrements du livre d'or et le compteur de visiteurs sont stockés.
Tous les serveurs fonctionnent sur un seul cœur de processeur. L'idée est d'évaluer la performance maximale de chacune des architectures. Comme tous les programmes serveur sont testés sur le même matériel, cela constitue une base pour leur comparaison. Mon installation de test se compose de serveurs virtuels loués chez Digital Ocean.
Qu'est-ce que nous mesurons ?
Différents indicateurs peuvent être mesurés. Nous évaluons la performance de chaque architecture dans cette configuration, en chargeant les serveurs avec des requêtes à différents niveaux de parallélisme : la charge augmente de 20 à 15 000 utilisateurs simultanés.
Résultats des tests
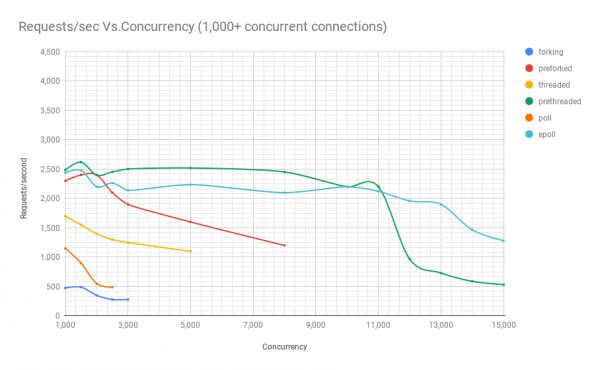
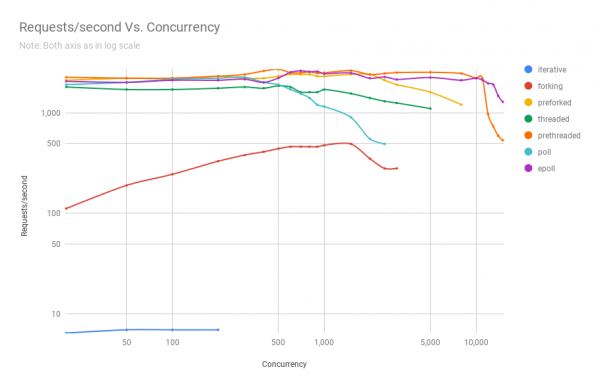
Le graphique suivant montre la performance des serveurs sur différentes architectures à divers niveaux de parallélisme. Sur l'axe y, le nombre de requêtes par seconde, sur l'axe x, les connexions parallèles.
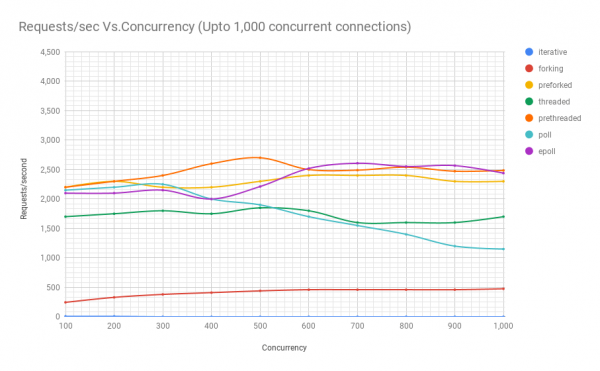
Ci-dessous, un tableau avec les résultats.
requêtes par seconde
parallélisme
itératif
fork
pré-fork
threadé
pré-threadé
poll
epoll
20
7
112
2100
1800
2250
1900
2050
50
7
190
2200
1700
2200
2000
2000
100
7
245
2200
1700
2200
2150
2100
200
7
330
2300
1750
2300
2200
2100
300
–
380
2200
1800
2400
2250
2150
400
–
410
2200
1750
2600
2000
2000
500
–
440
2300
1850
2700
1900
2212
600
–
460
2400
1800
2500
1700
2519
700
–
460
2400
1600
2490
1550
2607
800
–
460
2400
1600
2540
1400
2553
900
–
460
2300
1600
2472
1200
2567
1000
–
475
2300
1700
2485
1150
2439
1500
–
490
2400
1550
2620
900
2479
2000
–
350
2400
1400
2396
550
2200
2500
–
280
2100
1300
2453
490
2262
3000
–
280
1900
1250
2502
large variation
2138
5000
–
large variation
1600
1100
2519
–
2235
8000
–
–
1200
large variation
2451
–
2100
10 000
–
–
large variation
–
2200
–
2200
11 000
–
–
–
–
2200
–
2122
12 000
–
–
–
–
970
–
1958
13 000
–
–
–
–
730
–
1897
14 000
–
–
–
–
590
–
1466
15 000
–
–
–
–
532
–
1281
D'après le graphique et le tableau, on peut voir qu'au-delà de 8000 requêtes simultanées, il ne reste que deux options : pré-fork et epoll. Avec l'augmentation de la charge, le serveur basé sur poll performe moins bien que le threadé. L'architecture avec création anticipée de threads constitue une sérieuse concurrence pour epoll : cela témoigne de l'efficacité avec laquelle le noyau Linux gère un grand nombre de threads.
Code source de ZeroHTTPd
Code source de ZeroHTTPd . Un répertoire distinct pour chaque architecture.
ZeroHTTPd
│
├── 01_iterative
│   ├── main.c
├── 02_forking
│   ├── main.c
├── 03_preforking
│   ├── main.c
├── 04_threading
│   ├── main.c
├── 05_prethreading
│   ├── main.c
├── 06_poll
│   ├── main.c
├── 07_epoll
│    └── main.c
├── Makefile
├── public
│   ├── index.html
│   └── tux.png
└── templates
    └── guestbook
        └── index.html
En plus des sept répertoires pour toutes les architectures, il y a deux autres dans le répertoire racine : public et templates. Le premier contient le fichier index.html et l'image du premier écran. D'autres fichiers et dossiers peuvent y être placés, et ZeroHTTPd doit être capable de servir ces fichiers statiques sans problème. Si le chemin dans le navigateur correspond au chemin dans le dossier public, ZeroHTTPd recherche le fichier index.html dans ce répertoire. Le contenu du livre d'or est généré dynamiquement. Il n'a qu'une seule page principale, dont le contenu est basé sur le fichier 'templates/guestbook/index.html'. ZeroHTTPd permet d'ajouter facilement des pages dynamiques pour s'étendre. L'idée est que les utilisateurs peuvent ajouter des modèles dans ce répertoire et étendre ZeroHTTPd au besoin.
Pour compiler les sept serveurs, exécutez make all depuis le répertoire racine — et tous les builds apparaîtront dans ce répertoire. Les fichiers exécutables recherchent les répertoires public et templates dans le répertoire depuis lequel ils sont lancés.
API Linux
Pour comprendre les informations dans ce cycle d'articles, il n'est pas nécessaire de bien connaître l'API Linux. Cependant, je recommande de lire davantage sur le sujet, il existe de nombreuses ressources de référence en ligne. Bien que nous abordions plusieurs catégories de l'API Linux, notre attention se concentrera principalement sur les processus, les threads, les événements et la pile réseau. En plus des livres et articles sur l'API Linux, je recommande également de lire les manuels pour les appels système et les fonctions de bibliothèque utilisées.
Performance et évolutivité
Une remarque sur la performance et l'évolutivité. Théoriquement, il n'y a aucun lien entre les deux. Vous pouvez avoir un service web qui fonctionne très bien, avec un temps de réponse de quelques millisecondes, mais qui n'est pas évolutif du tout. De même, une application web peu performante peut prendre plusieurs secondes pour répondre, mais elle peut évoluer pour gérer des dizaines de milliers d'utilisateurs simultanés. Néanmoins, la combinaison d'une haute performance et d'une évolutivité est une très puissante. Les applications hautes performances utilisent généralement les ressources de manière économique et par conséquent, gèrent efficacement un plus grand nombre d'utilisateurs simultanés sur le serveur, réduisant ainsi les coûts.
Tâches CPU et I/O
Enfin, il existe toujours deux types possibles de tâches dans les calculs : celles liées à l'I/O et celles liées au CPU. La réception de requêtes via Internet (entrée/sortie réseau), la gestion de fichiers (entrée/sortie réseau et disque), les communications avec la base de données (entrée/sortie réseau et disque) - tout cela constitue des actions I/O. Certaines requêtes à la base de données peuvent légèrement solliciter le CPU (tri, calcul de la moyenne d'un million de résultats, etc.). La plupart des applications web sont limitées par un I/O maximal, tandis que le processeur est rarement utilisé à pleine capacité. Lorsque vous constatez qu'une tâche d'entrée/sortie utilise beaucoup de CPU, c'est probablement un signe d'une mauvaise architecture d'application. Cela peut signifier que les ressources CPU sont dépensées pour la gestion des processus et le changement de contexte - ce qui n'est pas particulièrement utile. Si vous faites quelque chose comme le traitement d'images, la conversion de fichiers audio ou de l'apprentissage automatique, alors l'application nécessite une puissance CPU élevée. Mais pour la plupart des applications, ce n'est pas le cas.
Plus de détails sur les architectures serveur
Source : habr.com
