

Aujourd'hui, nous allons parler de la meilleure façon de stocker des données dans un monde où les réseaux de cinquième génération, les scanners de génomes et les voitures autonomes produisent plus de données en une journée que l'ensemble de l'humanité n'en a généré depuis la révolution industrielle.
Notre monde génère de plus en plus d'informations. Une partie de celle-ci est éphémère et est perdue aussi rapidement qu'elle est collectée. D'autres doivent être stockées plus longtemps, tandis que certaines sont conçues pour 'des siècles' — du moins, c'est ainsi que nous le percevons aujourd'hui. Les flux d'informations s'accumulent dans les centres de données à un rythme tel que toute nouvelle approche, toute nouvelle technologie destinée à satisfaire cette 'demande' infinie, obsolète rapidement.
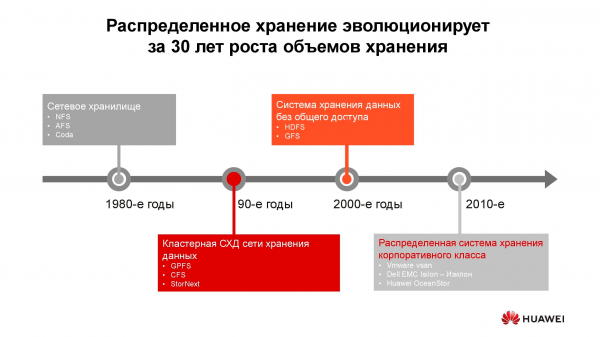
40 ans de développement des systèmes de stockage distribués
Les premiers systèmes de stockage en réseau, sous la forme que nous connaissons aujourd'hui, sont apparus dans les années 1980. Beaucoup d'entre vous ont probablement entendu parler de NFS (Network File System), AFS (Andrew File System) ou Coda. Une décennie plus tard, la mode et la technologie ont changé, et les systèmes de fichiers distribués ont cédé la place aux systèmes de stockage en cluster basés sur GPFS (General Parallel File System), CFS (Clustered File Systems) et StorNext. Des systèmes de stockage par blocs de l'architecture classique ont été utilisés comme base, sur laquelle une couche logicielle créait un système de fichiers unique. Ces solutions et d'autres similaires sont encore appliquées, occupent leur niche et sont assez demandées.
À la fin du millénaire, la paradigme des systèmes de stockage distribués a quelque peu évolué, et des systèmes avec une architecture SN (Shared-Nothing) ont pris la tête. Il y a eu un passage du stockage en cluster au stockage sur des nœuds individuels, qui étaient généralement des serveurs classiques dotés d'un logiciel garantissant une conservation sûre ; des systèmes comme HDFS (Hadoop Distributed File System) et GFS (Global File System) ont été construits sur ces principes.
Vers 2010, les concepts fondamentaux des systèmes de stockage distribués ont commencé à se refléter de plus en plus dans des produits commerciaux complets, tels que VMware vSAN, Dell EMC Isilon et notre . Derrière ces plateformes, il n'y a plus une communauté d'enthousiastes, mais des fournisseurs concrets qui assurent la fonctionnalité, le support, le service du produit et garantissent son développement futur. De telles solutions sont les plus demandées dans plusieurs domaines.
Opérateurs de télécommunications
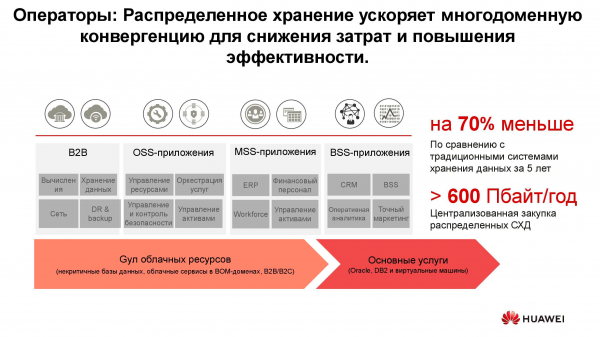
Sans aucun doute, l'un des plus anciens consommateurs de systèmes de stockage distribués sont les opérateurs de télécommunications. Le schéma montre quels groupes d'applications génèrent le volume principal de données. OSS (Systèmes de Support d'Opérations), MSS (Services de Support de Gestion) et BSS (Systèmes de Support d'Affaires) représentent trois couches logicielles complémentaires nécessaires pour fournir le service aux abonnés, pour la comptabilité financière du fournisseur et pour le support opérationnel des ingénieurs de l'opérateur.
Souvent, les données de ces couches sont fortement mélangées entre elles, et pour éviter l'accumulation de copies inutiles, on utilise justement des stockages distribués qui accumulent tout le volume d'information provenant du réseau en fonctionnement. Les stockages sont regroupés dans un pool commun, auquel tous les services accèdent.
Nos calculs montrent que le passage des systèmes de stockage classiques aux systèmes en blocs permet d'économiser jusqu'à 70 % du budget uniquement en renonçant à des systèmes de stockage dédiés de classe hi-end et en utilisant des serveurs classiques de l'architecture traditionnelle (généralement x86), fonctionnant avec un logiciel spécialisé. Les opérateurs de télécommunications ont déjà commencé à acquérir de telles solutions en quantités considérables depuis un certain temps. En particulier, les opérateurs russes utilisent de tels produits de Huawei depuis plus de six ans.
Oui, certaines tâches ne peuvent pas être réalisées avec des systèmes distribués. Par exemple, en cas d’exigences accrues en matière de performance ou de compatibilité avec d'anciens protocoles. Mais au moins 70 % des données traitées par l'opérateur peuvent tout à fait être placées dans un pool distribué.
Secteur bancaire
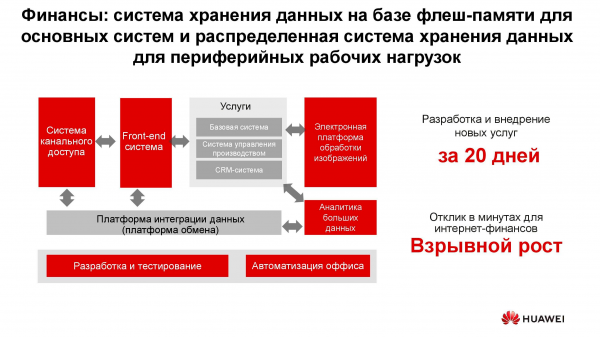
Dans chaque banque coexistent de nombreux systèmes informatiques hétérogènes, allant du traitement à un système bancaire automatisé. Cette infrastructure traite aussi un immense volume d'informations, la plupart des tâches ne requérant pas de performances élevées ni une fiabilité accrue des systèmes de stockage, par exemple le développement, les tests, l'automatisation des processus de bureau, etc. L'utilisation des systèmes de stockage classiques est possible ici, mais elle devient de moins en moins rentable chaque année. De plus, dans ce cas, il n'y a pas de flexibilité dans l'utilisation des ressources, dont la performance est calculée sur la base de la charge de pic.
Lors de l'utilisation de systèmes de stockage distribués, leurs nœuds, qui sont en fait des serveurs ordinaires, peuvent à tout moment être convertis, par exemple, en ferme de serveurs et utilisés comme plateforme de calcul.
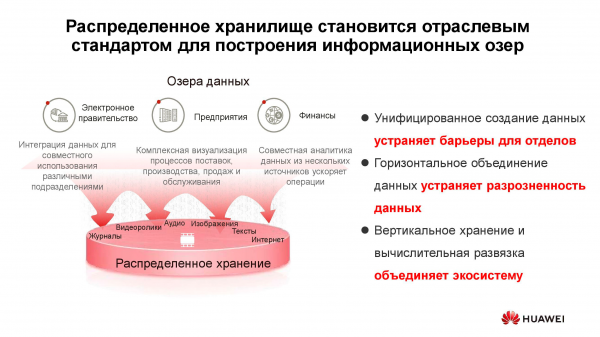
Lacs de données
Dans le schéma ci-dessus, vous trouverez une liste des consommateurs typiques des services . Cela peut inclure des services de gouvernement électronique (par exemple, « Services publics »), des entreprises ayant fait l'objet d'une numérisation, des institutions financières, etc. Tous nécessitent de travailler avec de grands volumes d'informations hétérogènes.
L'exploitation des systèmes de stockage classiques pour résoudre de telles tâches est inefficace, car un accès performant aux bases de données en block ainsi qu'un accès ordinaire aux bibliothèques de documents numérisés, conservés sous forme d'objets, sont nécessaires. Un système de commande via un portail web peut également y être associé. Pour réaliser tout cela sur une plateforme de système de stockage classique, un ensemble important de matériel sera requis pour différentes tâches. Un seul système de stockage horizontal universel peut très bien couvrir toutes les tâches précédemment énumérées : il suffira de créer plusieurs pools avec différentes caractéristiques de stockage.
Générateurs de nouvelles informations
La quantité d'informations stockées dans le monde augmente d'environ 30 % par an. C'est une bonne nouvelle pour les fournisseurs de systèmes de stockage, mais quelle est la principale source de ces données et quelle sera-t-elle à l'avenir ?
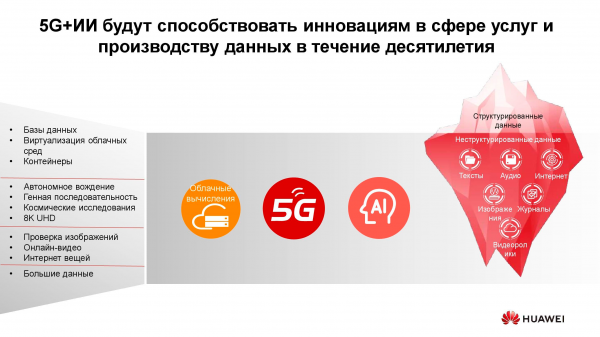
Il y a dix ans, les réseaux sociaux sont devenus de tels générateurs, ce qui a nécessité la création d'un grand nombre de nouveaux algorithmes, de solutions matérielles, etc. À présent, trois principaux moteurs de croissance des volumes de stockage se distinguent. Le premier est l'informatique en nuage. Actuellement, environ 70 % des entreprises utilisent d'une manière ou d'une autre des services cloud. Cela comprend des systèmes de messagerie électronique, des sauvegardes et d'autres entités virtualisées.
Le deuxième moteur est constitué par les réseaux de cinquième génération. Ce sont de nouvelles vitesses et de nouveaux volumes de transmission de données. Selon nos prévisions, la large diffusion de la 5G entraînera une baisse de la demande en cartes mémoire Flash. Peu importe combien de mémoire un téléphone possède, elle finit toujours par se remplir, et avec un canal de 100 mégabits dans l'appareil, il n'est plus nécessaire de stocker des photos localement.
La troisième catégorie de raisons pour lesquelles la demande de systèmes de stockage augmente comprend le développement rapide de l'intelligence artificielle, le passage à l'analyse des grandes données et la tendance à l'automatisation généralisée de tout ce qui peut l'être.
Une caractéristique du "nouveau trafic" est son . Nous devons stocker ces données sans définir leur format. Celui-ci n'est nécessaire que lors de la lecture ultérieure. Par exemple, un système de scoring bancaire pour déterminer le montant de crédit disponible examinera les photos que vous avez publiées sur les réseaux sociaux, déterminant à quelle fréquence vous allez à la mer et dans les restaurants, tout en analysant en même temps les extraits médicaux qui lui sont accessibles. Ces données, d'une part, sont exhaustives, mais d'autre part, elles manquent d'homogénéité.
L'océan des données non structurées
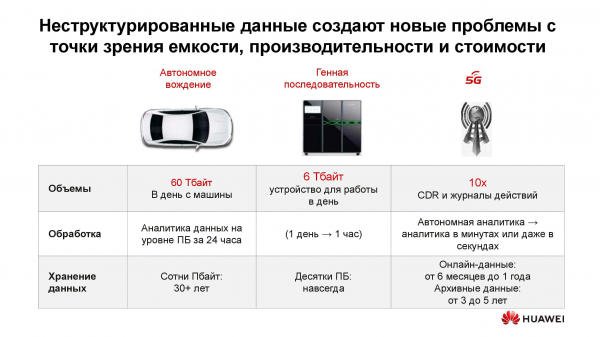
Quelles sont donc les problèmes liés à l'émergence des "nouvelles données" ? La plus pressante d'entre elles est bien sûr le volume d'informations et la durée de leur stockage. Un seul véhicule autonome moderne génère chaque jour jusqu'à 60 To de données en provenance de tous ses capteurs et mécanismes. Pour développer de nouveaux algorithmes de mouvement, ces informations doivent être traitées dans le même délai, sinon elles commenceront à s'accumuler. De plus, elles doivent être conservées pendant très longtemps — des décennies. Ce n'est qu'alors qu'il sera possible de tirer des conclusions basées sur de grands échantillons analytiques dans le futur.
Un seul appareil pour déchiffrer les séquences génétiques produit environ 6 To par jour. Et les données collectées grâce à son aide ne doivent en aucun cas être supprimées, c'est-à-dire qu'elles devraient théoriquement être conservées éternellement.
Enfin, il y a les réseaux de cinquième génération. En plus des informations transmises, un tel réseau est en lui-même un énorme générateur de données : journaux d'actions, enregistrements d'appels, résultats intermédiaires des interactions entre machines, etc.
Tout cela nécessite l'élaboration de nouvelles approches et algorithmes pour le stockage et le traitement des informations. Et de telles approches commencent à apparaître.
Technologies de la nouvelle époque
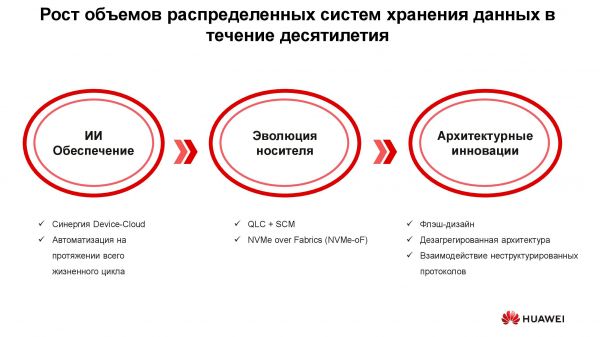
On peut distinguer trois groupes de solutions destinées à répondre aux nouvelles exigences des systèmes de stockage d'informations : l'intégration de l'intelligence artificielle, l'évolution technique des supports de données et les innovations dans le domaine de l'architecture des systèmes. Commençons par l'IA.
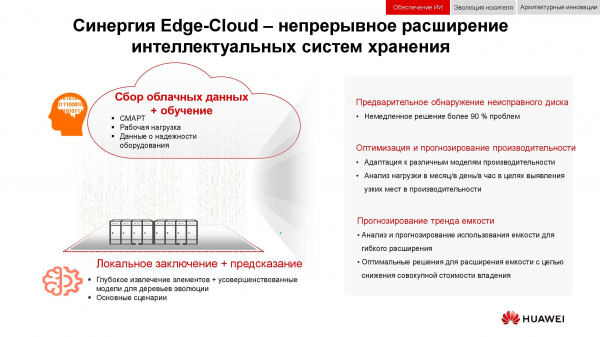
Dans les nouvelles solutions de Huawei, l'intelligence artificielle est déjà utilisée au niveau même du stockage, qui est équipé d'un processeur IA permettant au système d'analyser son propre état et de prédire des pannes. Si le système de stockage est connecté à un cloud de services possédant d'importantes capacités de calcul, l'intelligence artificielle pourra traiter plus d'informations et améliorer la précision de ses hypothèses.
En plus des pannes, cette IA est capable de prévoir la future charge de pointe et le temps restant avant l'épuisement de la capacité. Cela permet d'optimiser les performances et de faire évoluer le système avant l'apparition d'événements indésirables.
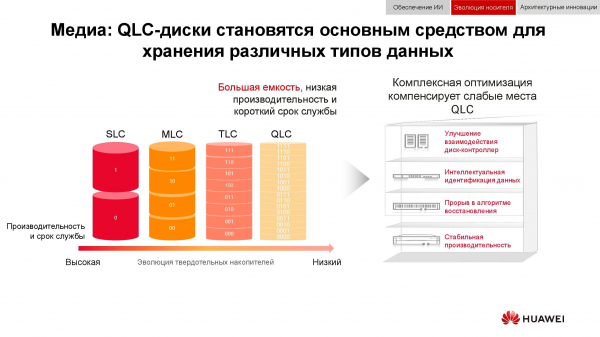
Parlons maintenant de l'évolution des supports de données. Les premières clés USB étaient fabriquées selon la technologie SLC (Single-Level Cell). Les appareils basés sur cette technologie étaient rapides, fiables et stables, mais avaient une capacité limitée et coûtaient très cher. L'augmentation du volume et la baisse des prix ont été obtenues grâce à des compromis techniques, entraînant une réduction de la vitesse, de la fiabilité et de la durée de vie des supports. Cependant, cette tendance n'a pas affecté les systèmes de stockage, qui, grâce à différentes astuces architecturales, sont devenus à la fois plus performants et plus fiables.
Mais pourquoi a-t-on eu besoin de systèmes de stockage de classe All-Flash ? N'était-il pas suffisant de remplacer les anciens HDD par de nouveaux SSD de même facteur de forme dans un système déjà en service ? Cela était nécessaire pour utiliser efficacement toutes les ressources des nouveaux disques à état solide, ce qui n'était tout simplement pas possible dans les anciens systèmes.
Par exemple, Huawei a développé une série de technologies pour résoudre ce problème, dont l'une est , qui a permis d'optimiser au maximum les interactions « disque — contrôleur ».
L'identification intelligente a permis de répartir les données sur plusieurs flux et de gérer plusieurs phénomènes indésirables, tels que (amplification d'écriture). Parallèlement, de nouveaux algorithmes de récupération, en particulier , ont augmenté la vitesse de reconstruction, réduisant son temps à des valeurs quasiment négligeables.
Les pannes, la saturation, le « ramassage des ordures » — ces facteurs n'affectent également plus la performance du système de stockage grâce à des optimisations spécifiques des contrôleurs.
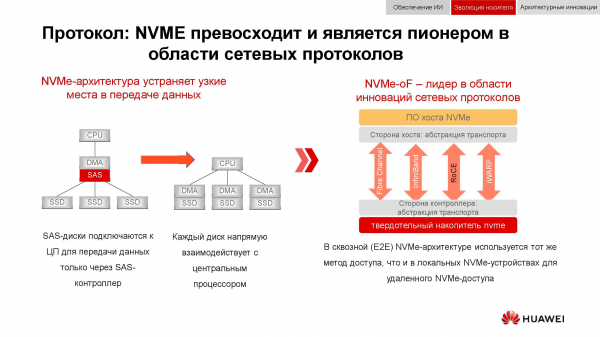
De plus, les systèmes de stockage par blocs se préparent à accueillir . Rappelons que le schéma classique d'accès aux données fonctionnait de la manière suivante : le processeur interrogeait le contrôleur RAID via le bus PCI Express. Celui-ci interagissait ensuite avec des disques mécaniques via SCSI ou SAS. L'utilisation de NVMe en backend a considérablement accéléré l'ensemble du processus, mais présentait un inconvénient : les unités de stockage devaient être directement connectées au processeur pour garantir un accès direct à la mémoire.
La phase suivante de développement de la technologie que nous observons actuellement est l'application de NVMe-oF (NVMe over Fabrics). En ce qui concerne les technologies de blocs de Huawei, elles prennent déjà en charge FC-NVMe (NVMe over Fibre Channel), et NVMe over RoCE (RDMA over Converged Ethernet) est en préparation. Les modèles de test sont tout à fait fonctionnels, et il ne reste que quelques mois avant leur présentation officielle. Notons que tout cela apparaîtra également dans des systèmes distribués, où 'Ethernet sans perte' sera très recherché.
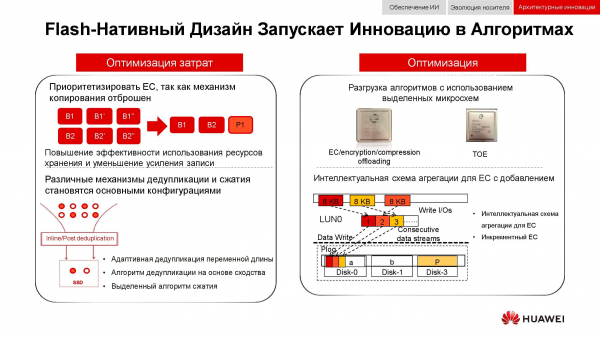
Une façon supplémentaire d'optimiser le fonctionnement des systèmes de stockage distribués a été de se passer complètement du miroirage des données. Les solutions Huawei n'utilisent plus n copies, comme dans le traditionnel RAID 1, et passent entièrement au mécanisme (Erasure coding). Un paquet mathématique spécial calcule à intervalles réguliers des blocs de contrôle qui permettent de restaurer des données intermédiaires en cas de perte.
Les mécanismes de dédupllication et de compression deviennent obligatoires. Si dans les systèmes de stockage classiques, nous sommes limités par le nombre de processeurs installés dans les contrôleurs, dans les systèmes de stockage distribués évolutifs horizontalement, chaque nœud contient tout le nécessaire : disques, mémoire, processeurs et interconnexion. Ces ressources sont suffisantes pour que la déduplication et la compression aient un impact minimal sur les performances.
Et en ce qui concerne les méthodes matérielles d'optimisation. Ici, la charge sur les processeurs centraux a été réduite à l'aide de circuits intégrés dédiés (ou de blocs dédiés dans le processeur lui-même), jouant le rôle de (TCP/IP Offload Engine) ou s'occupant des tâches mathématiques de l'EC, de la déduplication et de la compression.
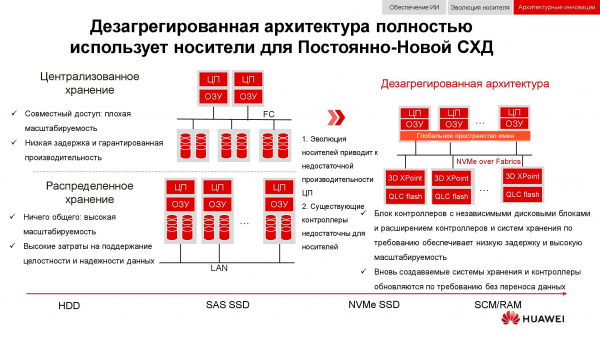
De nouvelles approches de stockage des données se sont matérialisées dans une architecture désagrégée (distribuée). Dans les systèmes de stockage centralisés, il existe une ferme de serveurs, connectée par Fibre Channel à un grand nombre de baies. Les inconvénients de cette approche incluent des difficultés de mise à l’échelle et d’assurance d’un niveau de service garanti (en termes de performance ou de latence). Les systèmes hyperconvergés utilisent les mêmes hôtes, tant pour le stockage que pour le traitement des informations. Cela offre une possibilité de mise à l’échelle pratiquement illimitée, mais entraîne des coûts élevés pour maintenir l'intégrité des données.
Contrairement à ces deux architectures, l'architecture désagrégée implique la séparation du système en une ferme de calcul et un système de stockage horizontal. Cela fournit les avantages des deux architectures et permet de mettre à l’échelle pratiquement sans limites uniquement l'élément dont la performance est insuffisante.
De l'intégration à la convergence
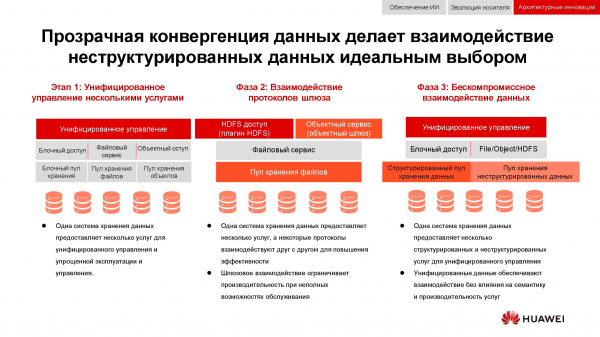
Un défi classique, dont la pertinence n'a cessé de croître au cours des 15 dernières années, est la nécessité d'assurer simultanément le stockage en blocs, l'accès aux fichiers, l'accès aux objets, l'exploitation d'une ferme pour le big data, etc. La cerise sur le gâteau pourrait par exemple être un système de sauvegarde sur bande magnétique.
Au premier stade, il n'a été possible d'unifier que la gestion de ces services. Des systèmes de stockage de données hétérogènes étaient liés à un logiciel spécialisé, par lequel l'administrateur répartissait les ressources des pools disponibles. Mais comme ces pools étaient techniquement différents, la migration des charges de travail entre eux était impossible. À un niveau d'intégration plus élevé, la consolidation se faisait au niveau de la passerelle. Avec un accès fichier commun, il était possible de le remettre via différents protocoles.
La méthode de convergence la plus avancée à notre disposition aujourd'hui implique la création d'un système hybride universel. C'est exactement ce que devrait devenir notre . L'accès universel utilise les mêmes ressources matérielles, logiquement divisées en différents pools, mais permettant la migration de la charge. Tout cela peut être géré via une console de gestion unique. De cette manière, nous avons réussi à mettre en œuvre le concept « un centre de données - un stockage ».
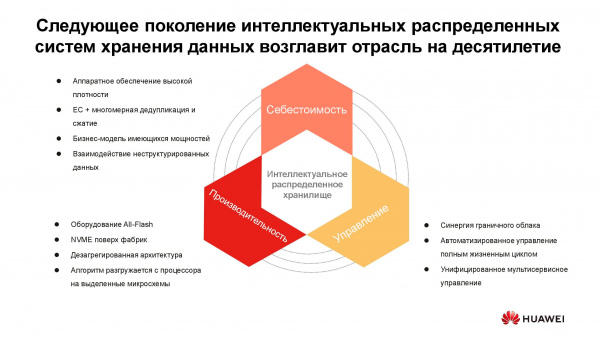
Le coût du stockage des informations détermine actuellement de nombreuses solutions architecturales. Et bien qu'il puisse être placé au premier plan, nous discutons aujourd'hui du stockage « vivant » avec accès actif, donc la performance doit également être prise en compte. Une autre caractéristique importante des systèmes distribués de nouvelle génération est l'unification. Après tout, personne ne veut avoir plusieurs systèmes disparates gérés depuis différentes consoles. Toutes ces qualités se sont matérialisées dans la nouvelle série de produits Huawei. .
Stockage de nouvelle génération
OceanStor Pacific répond aux exigences de fiabilité au niveau de « six neufs » (99,9999 %) et peut être utilisé pour créer des centres de données de classe HyperMetro. Avec une distance entre deux centres de données allant jusqu'à 100 km, les systèmes affichent une latence supplémentaire de 2 ms, ce qui permet de construire des solutions de résilience aux catastrophes, y compris avec des serveurs de quorum.
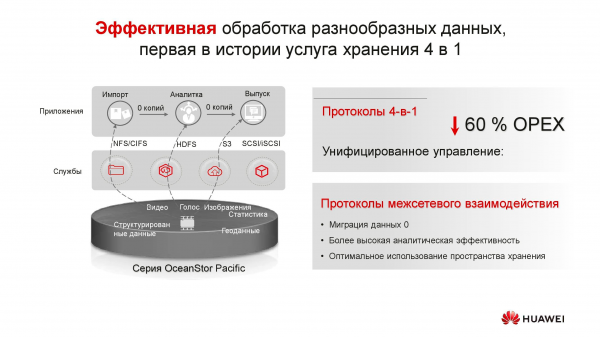
Les produits de la nouvelle série démontrent une polyvalence en matière de protocoles. OceanStor 100D prend déjà en charge l'accès en bloc, l'accès objet et l'accès Hadoop. L'accès aux fichiers sera également mis en œuvre prochainement. Il n'est pas nécessaire de conserver plusieurs copies de données si elles peuvent être fournies via différents protocoles.
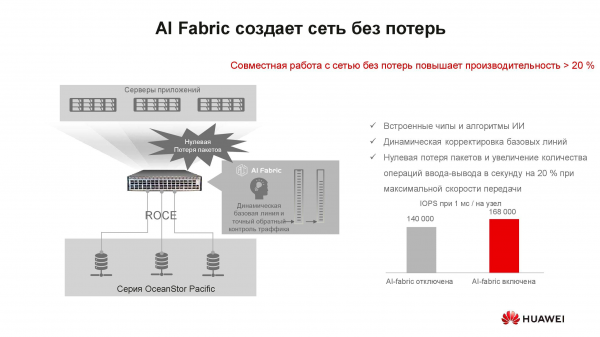
On pourrait se demander quel rapport la notion de « réseau sans perte » a avec le stockage ? La réalité est que les systèmes de stockage distribués reposent sur un réseau rapide soutenant les algorithmes et le mécanisme RoCE appropriés. De plus, la vitesse du réseau peut être augmentée et la latence réduite grâce au système d'intelligence artificielle pris en charge par nos commutateurs. . Le gain de performance du stockage activé par AI Fabric peut atteindre 20 %.
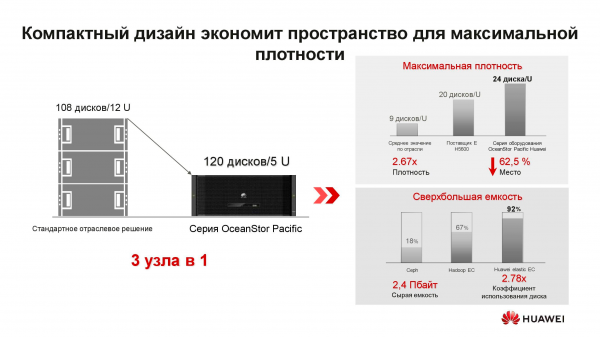
Que représente donc le nouveau nœud de stockage distribué OceanStor Pacific ? La solution au format 5U comprend 120 disques et peut remplacer trois nœuds classiques, offrant ainsi plus de deux fois d'économie d'espace en rack. Grâce à l'abandon du stockage de copies, l'efficacité des disques augmente considérablement (jusqu'à +92 %).
Nous sommes habitués à ce que le stockage défini par logiciel soit un logiciel spécial installé sur un serveur classique. Mais maintenant, pour atteindre des performances optimales, cette solution architecturale nécessite également des nœuds spéciaux. Elle comprend deux serveurs basés sur des processeurs ARM, gérant un ensemble de disques de 3 pouces.
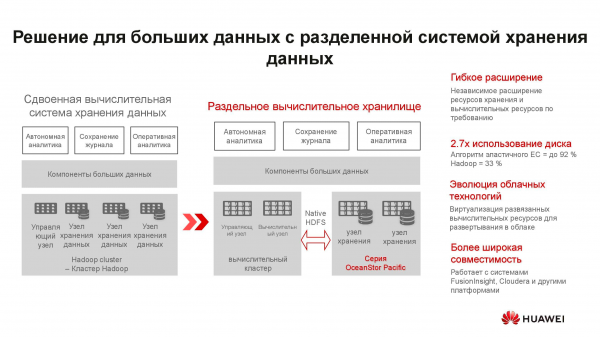
Ces serveurs conviennent peu aux solutions hyperconvergées. Premièrement, il existe peu d'applications pour ARM, et deuxièmement, il est difficile de maintenir un équilibre de charge. Nous proposons de passer à un stockage séparé : un cluster de calcul, représenté par des serveurs classiques ou des serveurs en rack, fonctionne séparément, mais se connecte aux nœuds de stockage OceanStor Pacific, qui accomplissent également leurs tâches directes. Et cela est justifié.
Prenons par exemple une solution classique de stockage de grandes données avec un système hyperconvergé occupant 15 racks de serveurs. Si nous répartissons la charge entre des serveurs de calcul séparés et les nœuds de stockage OceanStor Pacific, en les séparant, le nombre de racks nécessaires sera réduit de moitié ! Cela réduit les coûts d'exploitation du data center et diminue le coût total de possession. Dans un monde où le volume des informations stockées augmente de 30 % par an, on ne peut pas se permettre de négliger de tels avantages.
***
Vous pouvez obtenir plus d'informations sur les solutions Huawei et leurs scénarios d'application sur notre ou en contactant directement des représentants de l'entreprise.
Source : habr.com
