

Je vous invite à consulter la transcription de la présentation de Nikolaï Samokhvalov "Approche industrielle pour le tuning PostgreSQL : expériences sur les bases de données"
Shared_buffers = 25 % – est-ce beaucoup ou peu ? Ou juste ce qu'il faut ? Comment déterminer si cette recommandation – assez ancienne – est appropriée dans votre cas spécifique ?
Il est temps d'aborder la question de la sélection des paramètres de postgresql.conf "comme des professionnels". Pas à l'aide de "tuneurs automatiques" aveugles ou de conseils obsolètes provenant d'articles et de blogs, mais sur la base de :
- strictement d'expériences contrôlées sur les bases de données, réalisées de manière automatisée, en grand nombre et dans des conditions aussi proches que possible des "conditions réelles",
- d'une compréhension approfondie des spécificités de fonctionnement des SGBD et des systèmes d'exploitation.
En utilisant Nancy CLI (), nous examinerons un cas concret – les fameux shared_buffers – dans différentes situations, sur différents projets, et nous essaierons de comprendre comment bien ajuster cette configuration pour notre infrastructure, nos bases de données et notre charge.
Nous parlerons d'expériences sur les bases de données. C'est une histoire qui dure depuis un peu plus de six mois.
Un peu sur moi. Une expérience avec Postgres de plus de 14 ans. J'ai fondé plusieurs sociétés de réseaux sociaux. Partout, Postgres a été utilisé et continue de l'être.
Aussi, le groupe RuPostgres sur Meetup, deuxième au monde. Nous nous approchons lentement des 2000 membres. RuPostgres.org.
Et lors de plusieurs conférences, y compris Highload, je suis responsable des bases de données, notamment de Postgres depuis sa création.
Et ces dernières années, j'ai redémarré ma pratique de consultance sur Postgres dans 11 fuseaux horaires différents.
Lorsque j'ai fait cela il y a quelques années, il m'a fallu une pause dans le travail manuel actif avec Postgres, probablement depuis 2010. J'ai été surpris de voir à quel point la vie quotidienne des DBA avait peu changé, combien il fallait encore faire de travail manuel. Et j'ai immédiatement pensé qu'il y avait un problème, qu'il fallait automatiser beaucoup plus de choses.
Et comme tout cela se passait à distance, la plupart des clients étaient dans le cloud. Et déjà beaucoup de choses étaient clairement automatisées. J'y reviendrai plus tard. C'est-à-dire que cela a conduit à l'idée qu'il devait y avoir un certain nombre d'outils, à savoir une plateforme qui automatiserait presque toutes les actions des DBA, afin de pouvoir gérer un grand nombre de bases.
Cette présentation ne contiendra pas :
- de « solutions miracles » ou d'affirmations comme – mettez 8 Go ou 25 % de shared_buffers et tout ira bien. Il n'y aura pas beaucoup à dire sur les shared_buffers.
- Des éléments « hardcore ».
Et qu'est-ce qui va se passer ?
- Il y aura des principes d'optimisation que nous appliquons et développons. Il y aura diverses idées qui apparaissent en cours de route et différents outils que nous créons principalement en Open Source, c'est-à-dire que nous établissons notre base en Open Source. De plus, nous avons des tickets, presque toutes les communications se font en Open Source. Vous pouvez voir ce que nous faisons actuellement, ce qui sera dans la prochaine version, etc.
- Il y aura également quelques expériences d'utilisation de ces principes et outils dans diverses entreprises : des petites start-ups aux grandes entreprises.
Comment tout cela évolue-t-il ?
Tout d'abord, la principale tâche d'un DBA en plus de garantir la création d'instances, le déploiement des sauvegardes, etc., est de trouver les goulets d'étranglement et d'optimiser la performance.
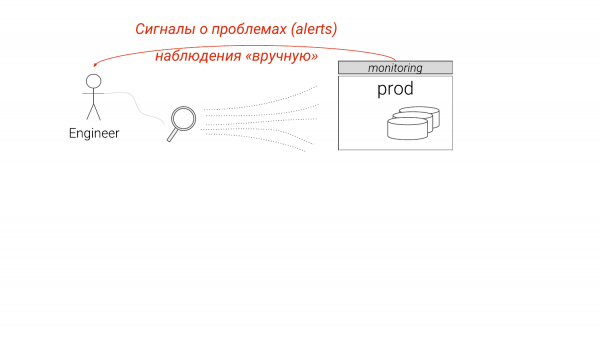
Actuellement, cela fonctionne de cette manière. Nous regardons le monitoring, nous voyons quelque chose, il nous manque des détails. Nous commençons à examiner plus attentivement, habituellement à la main, et nous comprenons ce qu'il faut faire.
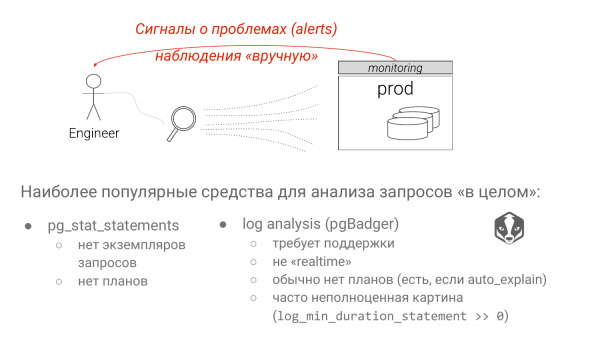
Il existe deux approches. Pg_stat_statements est la solution standard par défaut pour identifier les requêtes lentes. Et l'analyse des journaux Postgres avec pgBadger.
Chacune de ces approches a de sérieux inconvénients. La première approche nous laisse sans tous les paramètres. Si nous voyons des groupes SELECT * FROM table where la colonne est égale à « ? » ou « $ » à partir de la version 10 de Postgres, nous ne savons pas si c'est un index scan ou un seq scan. Cela dépend beaucoup du paramètre. Si vous introduisez une valeur rarement rencontrée, ce sera un index scan. Si vous introduisez une valeur qui représente 90 % de la table, ce sera un seq scan, car Postgres connaît les statistiques. C'est un gros inconvénient de pg_stat_statements, bien que des travaux soient en cours.
L'analyse des journaux a le principal inconvénient que vous ne pouvez généralement pas vous permettre de définir « log_min_duration_statement = 0 ». Nous en discuterons également. Par conséquent, vous ne voyez pas le tableau complet. Une requête très rapide peut consommer une énorme quantité de ressources, mais vous ne la verrez pas, car elle est en dessous de votre seuil.
Comment les DBA résolvent-ils les problèmes identifiés ?
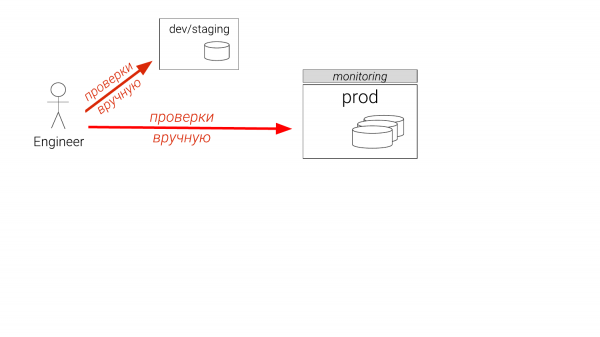
Par exemple, nous avons trouvé un problème. Que fait-on habituellement ? Si vous êtes développeur, vous allez effectuer des actions sur une instance qui n'est pas à la bonne taille. Si vous êtes DBA, vous avez un environnement de staging. Et il ne peut y en avoir qu'un seul. Et il est en retard de six mois. Vous pensez que vous allez passer en production. Même les DBA expérimentés vérifient ensuite en production, sur une réplique. Il arrive qu'ils créent un index temporaire, s'assurent qu'il aide, le suppriment et le remettent aux développeurs pour qu'ils l'intègrent dans les fichiers de migration. C'est ce genre d'ineptie qui se produit actuellement. Et c'est un vrai problème.
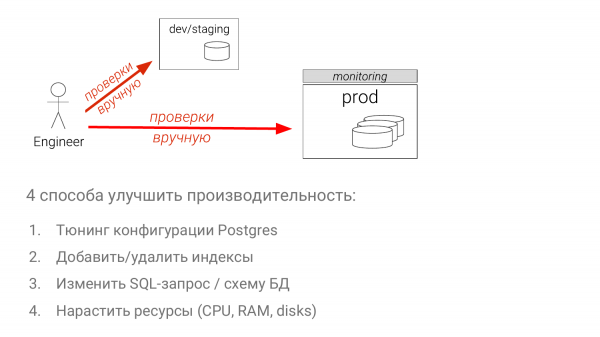
- Ajuster les configurations.
- Optimiser l'ensemble des index.
- Modifier la requête SQL elle-même (c'est le moyen le plus complexe).
- Ajouter des ressources (le moyen le plus simple dans la plupart des cas).
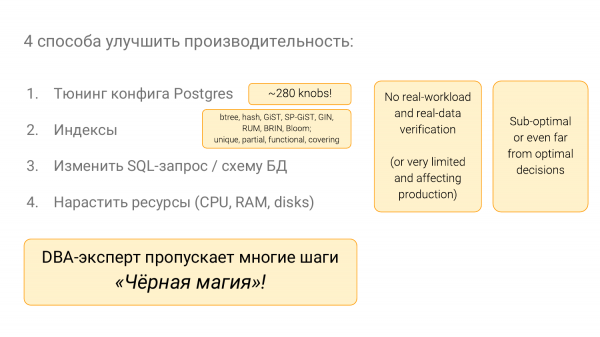
Il y a beaucoup de choses à considérer. Il y a de nombreux leviers dans Postgres. Il faut avoir une connaissance approfondie. Beaucoup d'index dans Postgres, grâce notamment aux organisateurs de cette conférence. Et il faut tout savoir, et c'est précisément ce qui donne à ceux qui ne sont pas DBA l'impression que les DBA pratiquent la magie noire. C'est-à-dire qu'il faut s'y consacrer pendant dix ans pour commencer à bien comprendre tout ça.
Et moi, je suis un combattant de cette magie noire. Je veux faire en sorte qu'il y ait une technologie plutôt qu'une intuition dans tout ça.
Exemples de la vie réelle
Je l'ai constaté dans au moins deux projets, y compris le mien. Un autre article de blog nous informe que la valeur 1 000 pour default_statistic_target est bonne. Très bien, essayons en production.
Et ici, nous, en utilisant notre outil deux ans plus tard grâce à des expériences sur des bases de données, dont nous parlons aujourd'hui, pouvons comparer ce qui était et ce qui est devenu.
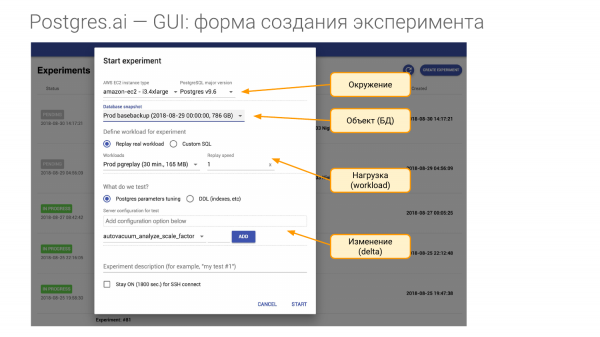
Pour cela, nous devons créer une expérience. Elle se compose de quatre parties.
- La première – c'est l'environnement. Nous avons besoin de matériel. Et quand je vais dans une entreprise et que je signe un contrat, je dis qu'il me faut du matériel identique à celui de la production. Pour chacun de vos Masters, j'ai besoin d'au moins une telle machine. Que ce soit une instance de machine virtuelle sur Amazon ou Google, ou qu'il me faille exactement le même matériel. C'est-à-dire que je veux recréer l'environnement. Et dans cette notion d'environnement, nous devons inclure la version majeure de Postgres.
- La deuxième partie – c'est l'objet de nos recherches. C'est la base de données. Elle peut être créée de plusieurs manières. Je vais montrer comment.
- La troisième partie – c'est la charge. C'est le moment le plus complexe.
- La quatrième partie est ce que nous vérifions, c'est-à-dire ce avec quoi nous allons comparer. Par exemple, nous pouvons modifier un ou plusieurs paramètres dans la configuration, ou créer un index, etc.
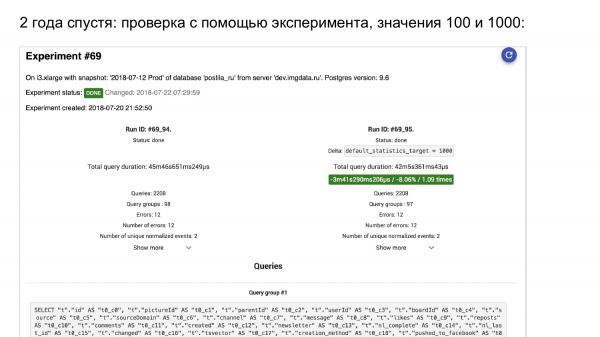
Nous lançons une expérience. Voici pg_stat_statements. À gauche, ce qui était. À droite, ce qui est devenu.
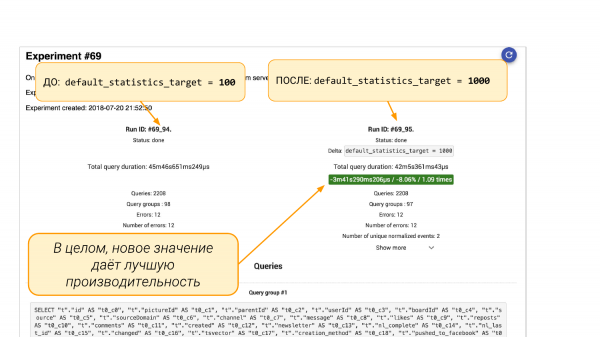
À gauche, default_statistics_target = 100, à droite = 1 000. Nous voyons que cela nous a aidés. En général, tout s'est amélioré de 8 %.
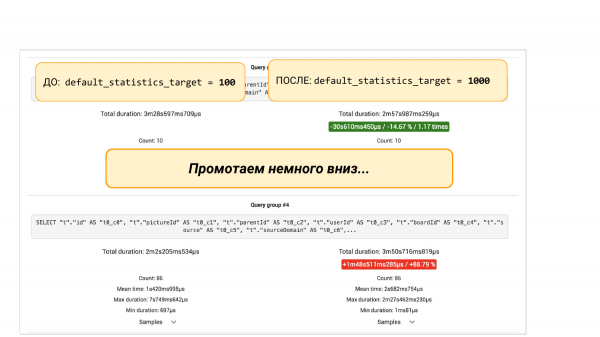
Mais si nous faisons défiler vers le bas, nous trouverons des groupes de requêtes provenant de pgBadger ou de pg_stat_statements. Il y a deux options. Nous verrons qu'une certaine requête a chuté de 88 %. C'est là qu'une approche d'ingénierie entre en jeu. Nous pouvons creuser plus profondément, car il est intéressant de savoir pourquoi elle a chuté. Il faut comprendre ce qui se passait avec la statistique. Pourquoi un plus grand nombre de buckets dans la statistique conduit à un résultat moins bon.
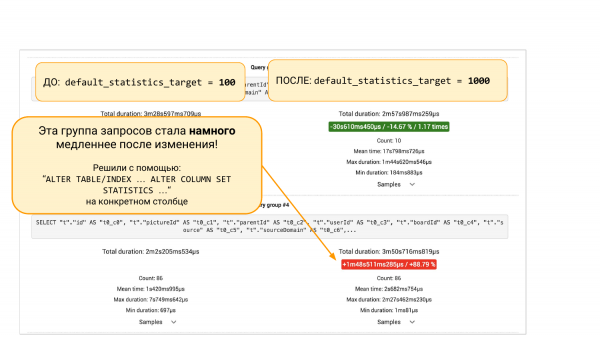
Ou nous pouvons ne pas creuser, mais faire un « ALTER TABLE … ALTER COLUMN » et remettre 100 buckets à la statistique de cette colonne. Ensuite, nous pouvons encore expérimenter pour nous assurer que ce correctif a aidé. Voilà, c'est cela une approche d'ingénierie qui nous aide à voir la situation et à prendre des décisions basées sur des données plutôt que sur de l'intuition.
Voici quelques exemples d'autres domaines. Dans les tests, il existe des tests CI depuis de nombreuses années. Et aucun projet sensé ne vivra sans tests automatisés.
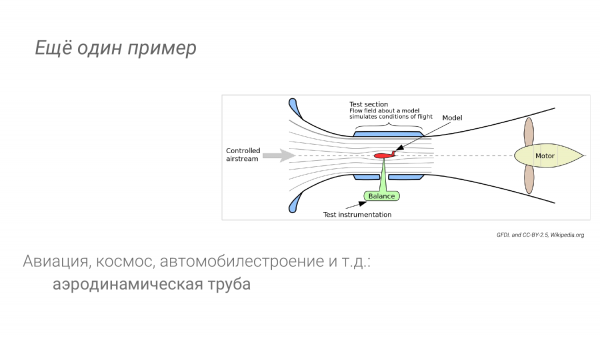
Dans d'autres industries : dans l'aviation, dans l'automobile, lorsque nous testons l'aérodynamique, nous avons aussi la possibilité de faire des expériences. Nous ne lançons pas quelque chose directement dans l'espace basé sur un dessin ou ne mettons pas une voiture directement sur la route. Par exemple, il existe une soufflerie aérodynamique.
Des observations d'autres industries nous permettent de tirer des conclusions.
Tout d'abord, nous avons un environnement spécial. Il est proche de la production, mais pas tout à fait. Sa principale caractéristique est qu'il doit être bon marché, répétable et aussi automatisé que possible. De plus, il doit y avoir des outils spéciaux pour effectuer une analyse détaillée.
Il est probable que lorsque nous avons lancé l'avion et que nous volons, nous avons moins d'opportunités d'étudier chaque millimètre de la surface de l'aile que dans une soufflerie. Nous avons plus de moyens pour le diagnostic. Nous pouvons nous permettre d'accrocher plus de poids, ce que nous ne pouvons pas faire avec un avion en vol. Il en va de même avec Postgres. Dans certains cas, nous pouvons activer la journalisation complète des requêtes lors des expériences. Et nous ne voulons pas faire cela en production. Nous pourrions même l'activer avec les plans à l'aide de auto_explain.
Comme je l'ai déjà dit, un haut niveau d'automatisation signifie que nous avons appuyé sur un bouton et répété. C'est comme cela que cela doit être, afin d'avoir beaucoup d'expériences, pour que ce soit en continu.
Nancy CLI – la base du « laboratoire DB »
Et nous avons créé quelque chose comme ça. C'est-à-dire que j'avais parlé de ces idées en juin, il y a presque un an. Et nous avons déjà dans Open Source ce qu'on appelle Nancy CLI. C'est la fondation pour construire un laboratoire de bases de données.
– C'est en Open Source, sur GitLab. Vous pouvez le dire, vous pouvez essayer. J'ai mis un lien dans les diapositives. Vous pouvez cliquer dessus et vous trouverez pour tous les paramètres.
Bien sûr, il y a encore beaucoup de choses en cours de développement. Il y a beaucoup d'idées. Mais c'est déjà ce que nous appliquons pratiquement tous les jours. Et lorsque nous avons une idée – par exemple, que se passe-t-il lorsque nous supprimons 40 000 000 de lignes et que tout se bloque sur l'I/O, nous pouvons faire une expérience et regarder de plus près pour comprendre ce qui se passe et ensuite essayer de le corriger en cours de route. C'est-à-dire que nous faisons une expérience. Par exemple, nous ajustons quelque chose et voyons ce qui en résulte. Et nous ne le faisons pas en production. C'est l'idée principale.
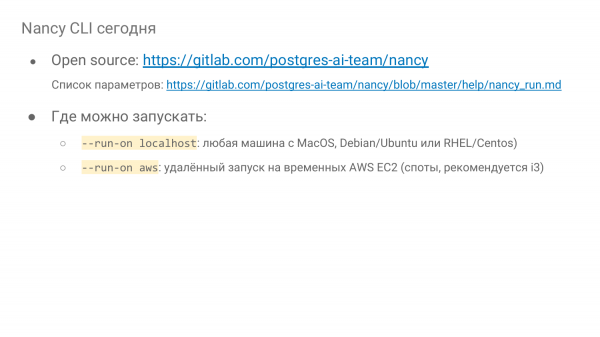
Où cela peut-il fonctionner ? Cela peut fonctionner localement, c'est-à-dire que cela peut être fait n'importe où, même sur un MacBook. Il faut Docker, on y va. Et c'est tout. Nous pouvons le lancer sur une instance physique, ou dans une machine virtuelle, peu importe.
Il existe également la possibilité de lancer à distance sur Amazon EC2 Instance, en spots. C'est une fonctionnalité très intéressante. Par exemple, hier, nous avons réalisé plus de 500 expériences sur une instance i3, en commençant par la plus petite et en terminant par l'i3-16-xlarge. Et ces 500 expériences nous ont coûté 64 dollars. Chacune a duré 15 minutes. Grâce aux spots, cela devient très abordable – une remise de 70 %, tarif à la seconde d'Amazon. Vous pouvez faire beaucoup de choses. Vous pouvez mener une véritable recherche.
Trois versions majeures de Postgres sont prises en charge. Ce n'est pas si compliqué d'adapter des anciennes versions et la nouvelle version 12 aussi.
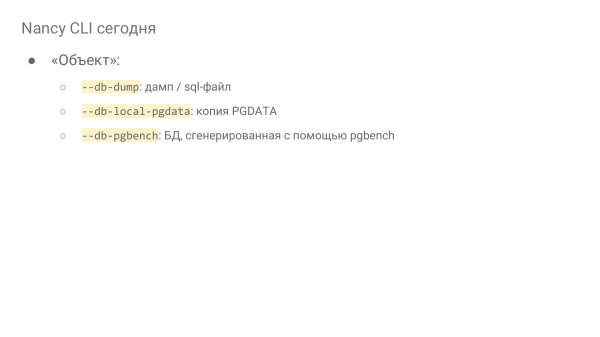
Nous pouvons définir l'objet de trois manières. Ce sont :
- Dump/fichier SQL.
- Le principal moyen est de cloner le répertoire PGDATA. En général, cela provient du serveur de sauvegarde. Si vous avez de bonnes sauvegardes binaires, vous pouvez en faire des clones. Si vous avez des clouds, alors la société cloud type Amazon ou Google s'en occupera pour vous. C'est la méthode principale pour cloner un environnement de production réel. Nous déployons en utilisant cette méthode.
- Et la dernière méthode convient pour les recherches, lorsque vous souhaitez comprendre comment quelque chose fonctionne dans Postgres. C'est pgbench. Vous pouvez générer avec pgbench. C'est juste une option "db-pgbench". Vous lui indiquez le scale. Et tout sera généré dans le cloud, comme indiqué.
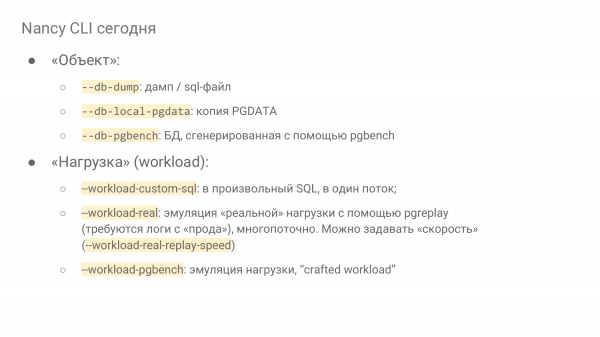
Et la charge :
- Nous pouvons exécuter la charge en un seul flux SQL. C'est la méthode la plus primitive.
- Nous pouvons aussi émuler la charge. Et nous pouvons l'émuler principalement de la manière suivante. Nous devons collecter tous les logs. Et cela peut être pénible. Je vais montrer pourquoi. Et à l'aide de pgreplay, intégré dans Nancy, nous pouvons les rejouer.
- Ou une autre option. La soi-disant charge artisanale, que nous créons avec un certain effort. En analysant notre charge actuelle sur le système de production, nous extrayons les groupes de requêtes les plus performants. Et avec pgbench, nous pouvons émuler cette charge en laboratoire.
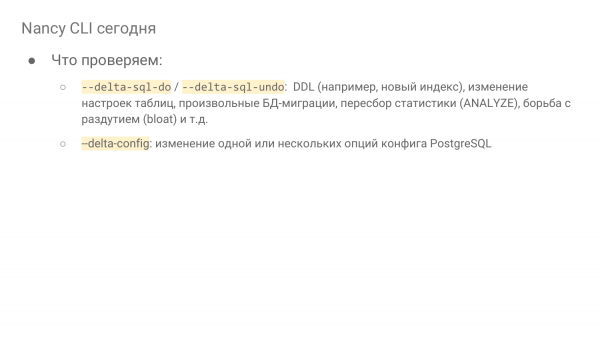
- Ou bien nous devons exécuter une requête SQL, c'est-à-dire vérifier une migration, créer un index, exécuter ANALYZE. Et nous observons ce qui s'est passé avant et après le vacuum. En général, n'importe quelle SQL.
- Soit nous modifions un ou plusieurs paramètres dans la configuration. Nous pouvons demander de vérifier, par exemple, 100 valeurs sur Amazon pour notre base de données de un téraoctet. Et après quelques heures, vous aurez le résultat. En règle générale, une base de données de un téraoctet se déploiera pendant plusieurs heures. Mais dans le développement, il y a un correctif, nous avons une série possible, c'est-à-dire que vous pouvez utiliser le même pgdata successivement sur le même serveur et effectuer des vérifications. Postgres redémarrera, les caches seront vidés. Et vous pouvez exécuter la charge.
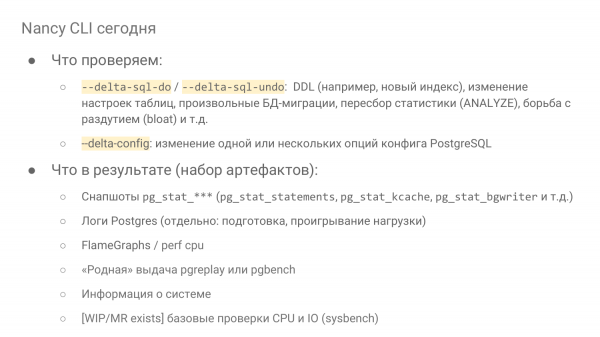
- Une directory arrive, contenant une multitude de fichiers, allant des snapshots pgstat***. Et là, le plus intéressant – c'est pg_stat_statements, pg_stat_kcache. Ce sont deux extensions qui analysent les requêtes. Et pg_stat_bgwriter contient non seulement les statistiques de pgwriter, mais aussi celles relatives aux checkpoints et à la façon dont les backends expulsent les buffers sales. Et c'est intéressant à observer. Par exemple, lorsque nous configurons shared_buffers, il est très intéressant de voir combien chacune a expulsé.
- Des journaux Postgres arrivent également. Deux journaux – le journal de préparation et le journal de replay de charge.
- Une fonctionnalité relativement nouvelle – c'est les FlameGraphs.
- De plus, si vous avez utilisé pgreplay ou pgbench pour le replay de charge, leur sortie native sera présente. Et vous pourrez voir la latence et le TPS. Cela vous permettra de comprendre comment ils ont observé cela.
- Informations sur le système.
- Vérifications de base du CPU et de l'IO. C'est principalement pour les instances EC2 sur Amazon, lorsque vous souhaitez lancer 100 instances identiques dans un flux et y effectuer 100 différents tests, vous aurez 10 000 expériences. Et vous devez vous assurer que vous n'avez pas eu une instance défectueuse, qu'un autre utilisateur exploite déjà. Sur ce matériel, d'autres fonctionnent et il ne vous reste pas beaucoup de ressources. De tels résultats doivent être écartés. Et c'est exactement avec l'aide de sysbench d'Alexey Kopytov que nous réalisons quelques courtes vérifications, qui arriveront et pourront être comparées aux autres, c'est-à-dire que vous comprendrez comment se comporte le CPU et comment se comporte l'IO.
Quelles sont les complexités techniques à travers différentes entreprises ?
Supposons que nous souhaitions reproduire une charge réelle à l'aide des journaux. Excellente idée, si cela est écrit sur Open Source pgreplay. Nous l'utilisons. Mais pour qu'il fonctionne bien, vous devez activer la journalisation complète des requêtes avec les paramètres et les timings.
Il y a certaines complications concernant la durée et l'horodatage. Nous allons ignorer cette partie. La question principale est : pouvez-vous vous le permettre ou non ?
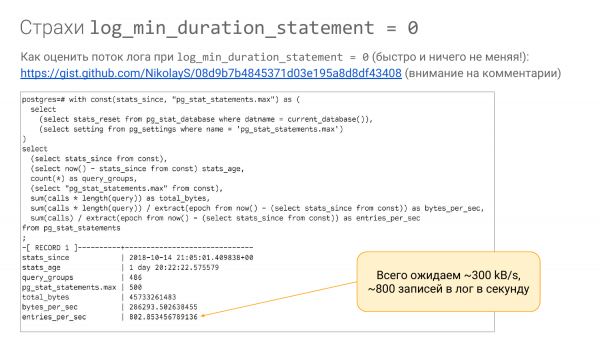
Le problème, c'est que cela peut être inaccessible. Vous devez d'abord comprendre quel flux sera inscrit dans le journal. Si vous avez pg_stat_statements, vous pouvez utiliser cette requête (le lien sera disponible dans les diapositives) pour estimer combien de bytes seront écrits par seconde.
Nous regardons la longueur de la requête. Nous ignorons le fait qu'il n'y a pas de paramètres, mais nous connaissons la longueur de la requête et savons combien de fois elle est exécutée par seconde. Ainsi, nous pouvons estimer combien de bytes par seconde cela représente. Nous pouvons nous tromper d'un facteur deux, mais nous aurons une idée du bon ordre.
Nous pouvons voir que cette requête est exécutée 802 fois par seconde. Et nous constatons qu'environ 300 kB/s seront écrits. En général, ce type de flux est gérable.
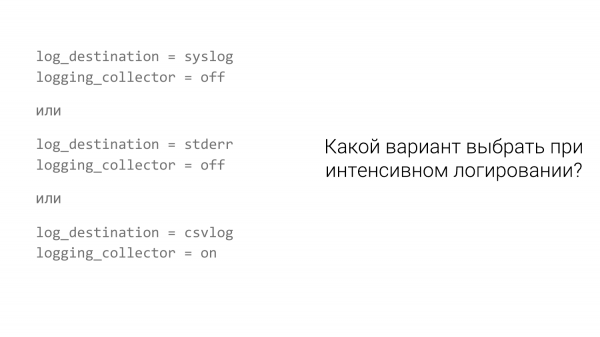
Mais ! Le fait est qu'il existe différents systèmes de journalisation. Et par défaut, les gens utilisent généralement « syslog ».
Si vous avez syslog, vous pouvez vous retrouver avec ce type de résultats. Nous allons utiliser pgbench, activer la journalisation des requêtes et voir ce que cela donne.
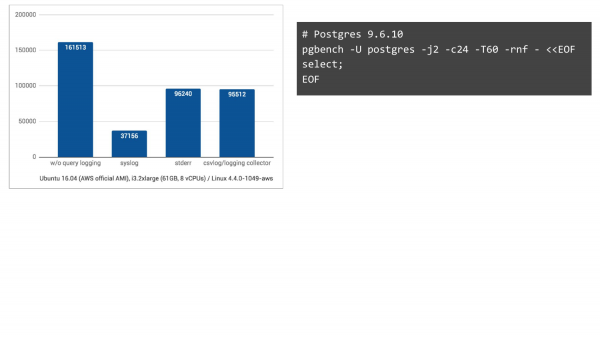
Sans journalisation – cela correspond à la colonne de gauche. Nous obtenons 161 000 TPS. Avec syslog – sous Ubuntu 16.04 sur Amazon, nous avons 37 000 TPS. Si nous changeons pour deux autres méthodes de journalisation, la situation s'améliore considérablement. C'est-à-dire que nous nous attendions à une baisse, mais pas à ce point.
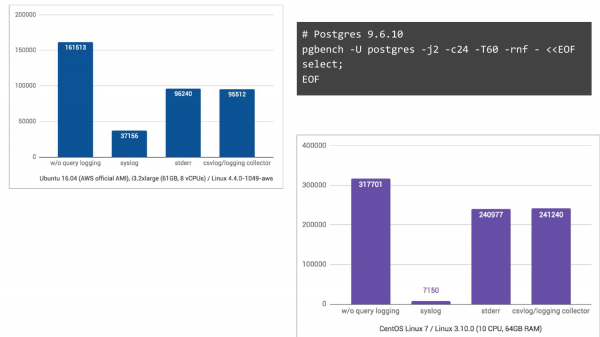
Et sous CentOS 7, où journald est également impliqué, convertissant les journaux en format binaire pour une recherche plus facile, la situation est catastrophique, avec une baisse de 44 fois en TPS.
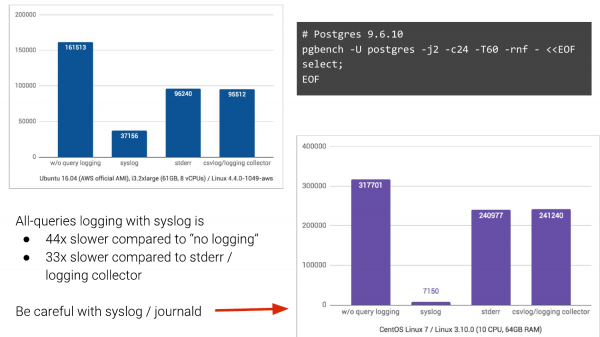
C'est ce dont les gens vivent. Et souvent, dans les entreprises, surtout les grandes, il est très difficile de changer cela. Si vous pouvez vous éloigner de syslog, n'hésitez pas.
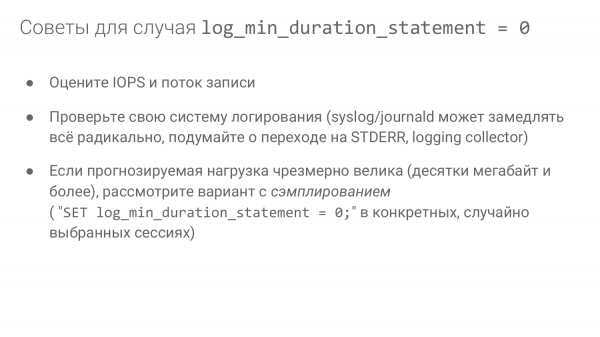
- Évaluez les IOPS et le flux d'écriture.
- Vérifiez votre système de journalisation.
- Si la charge prévue est trop élevée, envisagez l'option de l'échantillonnage.
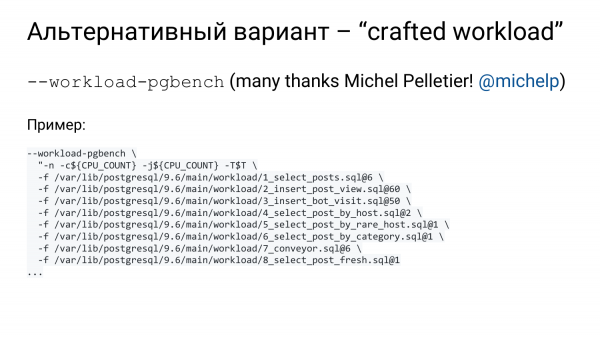
Nous avons pg_stat_statements. Comme je l'ai dit, il doit absolument être présent. Nous pouvons décrire chaque groupe de requêtes d'une manière particulière dans un fichier. Ensuite, nous pouvons utiliser une fonctionnalité très pratique dans pgbench – la possibilité de soumettre plusieurs fichiers avec l'option « -f ».
Il comprend beaucoup de « -f ». Et on peut indiquer avec « @ » à la fin quelle part de chaque fichier doit être utilisée. C'est-à-dire, nous pouvons dire que celui-ci doit être exécuté dans 10 % des cas, et celui-là dans 20 %. Cela nous rapprochera de ce que nous voyons en production.
Et comment allons-nous savoir ce que nous avons en production ? Quelle part et quoi exactement ? Ici, nous nous éloignons un peu. Nous avons encore un autre produit. . C'est aussi une base en Open Source. Et nous sommes actuellement en train de le développer activement.
Il est né pour d'autres raisons. En raison du fait que la surveillance est insuffisante. C'est-à-dire, vous arrivez, regardez la base, examinez les problèmes. Et, en général, vous faites un health_check. Si vous êtes un DBA expérimenté, vous faites un health_check. Vous regardez l'utilisation des index, etc. Si vous avez OKmeter, c'est super. C'est un excellent outil de surveillance pour Postgres. OKmeter.io – n'hésitez pas à l'installer, tout est vraiment bien fait. C'est payant.
Si vous ne l'avez pas, en général, il y a peu de choses. La surveillance inclut normalement le CPU, l'IO et encore avec des réserves, et c'est tout. Nous avons besoin de plus. Nous devons voir comment fonctionne l'autovacuum, comment fonctionne le checkpoint, dans l'IO, il faut séparer le checkpoint du bgwriter et des backends, etc.
Le problème est que lorsque vous aidez une grande entreprise, elle ne peut pas mettre quelque chose en œuvre rapidement. Elle ne peut pas acheter OKmeter rapidement. Peut-être que dans six mois, elle l'achètera. Elle ne peut pas installer certains packages rapidement.
Nous avons donc eu l'idée qu'il nous fallait un outil spécial qui ne nécessite aucune installation, c'est-à-dire que vous ne devez rien installer en production. Vous l'installez sur votre ordinateur portable ou sur un serveur d'observation à partir duquel vous allez l'exécuter. Et il va analyser beaucoup de choses : le système d'exploitation, le système de fichiers, et Postgres lui-même, en effectuant quelques requêtes légères qui peuvent être exécutées directement en production sans causer de problèmes.
Nous l'avons appelé Postgres-checkup. Si l'on parle de médecine, c'est un contrôle de santé régulier. Si l'on parle d'automobiles, c'est comme un entretien. Vous faites l'entretien de votre voiture tous les six mois ou un an, selon la marque. Mais faites-vous l'entretien de votre base de données ? C'est-à-dire, faites-vous régulièrement une recherche approfondie ? Vous devez le faire. Si vous faites des sauvegardes, faites aussi des checkups, c'est tout aussi important.
Et nous avons un tel outil. Il a commencé à se développer activement il y a seulement trois mois. Il est encore jeune, mais il y a déjà beaucoup de choses.
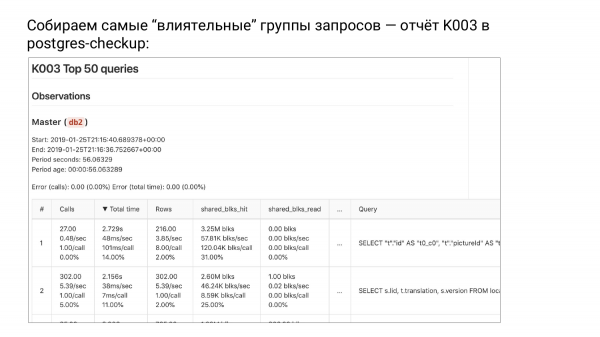
Nous rassemblons les groupes de requêtes les plus « influents » – rapport K003 dans Postgres-checkup
Et il y a un groupe de rapports K. Trois rapports pour le moment. Et il y a ce rapport K003. C'est le sommet de pg_stat_statements, trié par total_time.
Lorsque nous classons les groupes de requêtes par total_time, nous voyons en haut un groupe qui charge notre système de manière significative, c'est-à-dire qui consomme le plus de ressources. Pourquoi appelons-nous cela des groupes de requêtes ? Parce que nous avons éliminé les paramètres. Ce ne sont plus des requêtes, mais des groupes de requêtes, c'est-à-dire qu'ils sont abstraits.
Et si nous optimisons du haut vers le bas, nous allégeons nos ressources et repoussons le moment où nous devrons effectuer une mise à niveau. C'est un très bon moyen d'économiser de l'argent.
Peut-être que ce n'est pas une très bonne approche en termes de satisfaction des utilisateurs, car nous ne voyons peut-être pas des cas rares mais très ennuyeux où une personne attendait 15 secondes. En somme, ils sont si rares que nous ne les voyons pas, mais nous gérons les ressources.
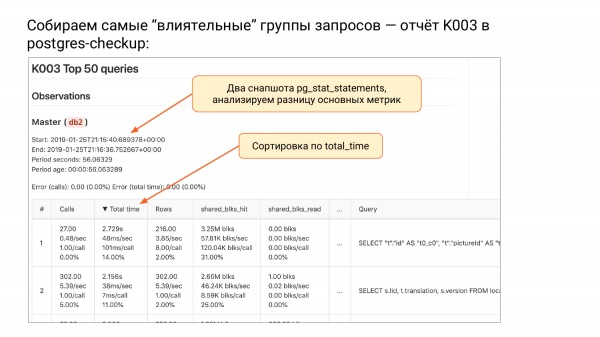
Que s'est-il passé dans ce tableau ? Nous avons fait deux snapshots. Postgres_checkup vous donnera la différence pour chaque métrique : par total-time, calls, rows, shared_blks_read, etc. Voilà, la différence a été calculée. Le gros problème avec pg_stat_statements est qu'il ne se souvient pas quand il a été réinitialisé. Si pg_stat_database se souvient, pg_stat_statements ne se souvient pas. Vous voyez ce nombre 1 000 000, mais nous ne savons pas d'où il a été calculé.
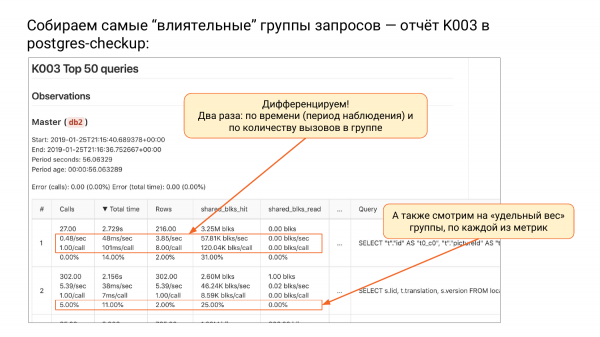
Ici, nous savons, ici nous avons deux snapshots. Nous savons que la différence dans ce cas était de 56 secondes. Un intervalle très court. Nous avons trié par total_time. Et ensuite, nous pouvons différencier, c'est-à-dire que nous divisons toutes les métriques par la durée. Si nous divisons chaque métrique par la durée, nous obtiendrons le nombre d'appels par seconde.
Ensuite, le total_time par seconde – c'est ma métrique préférée. Elle se mesure en secondes, par seconde, c'est-à-dire combien de secondes notre système a mis pour exécuter ce groupe de requêtes par seconde. Si vous voyez plus d'une seconde par seconde, cela signifie que vous aviez besoin de plus d'un noyau. C'est une très bonne métrique. Vous pouvez comprendre que cette entité, par exemple, a besoin d'au moins trois noyaux.
Voici notre innovation, je n'ai jamais vu ça ailleurs. Notez bien – c'est une chose très simple – seconde par seconde. Parfois, lorsque votre CPU est à 100 %, cela fait une demi-heure par seconde, c'est-à-dire que vous avez traité uniquement ces requêtes pendant une demi-heure.
Ensuite, nous voyons le nombre de lignes par seconde. Nous savons combien de lignes ont été renvoyées par seconde.
Et ensuite, il y a aussi une chose intéressante. Combien de shared_buffers nous avons lus par seconde à partir des shared_buffers. Les hits étaient déjà là, et les lignes ont été prises à partir du cache du système d'exploitation ou du disque. La première option est rapide, et la seconde peut être rapide, mais cela dépend de la situation.
Et la deuxième méthode de différenciation consiste à diviser le nombre de requêtes dans ce groupe. Dans la deuxième colonne, vous aurez toujours une requête divisée par la requête. Et ensuite, il est intéressant de voir combien de millisecondes cela a pris pour cette requête. Nous savons comment cette requête se comporte en moyenne. 101 millisecondes étaient nécessaires pour chaque requête. C'est une métrique traditionnelle dont nous avons besoin pour comprendre.
Combien de lignes chaque requête a renvoyées en moyenne. Nous voyons que ce groupe en renvoie 8. Combien ont été prises et lues en moyenne depuis le cache. Nous constatons que tout est bien mis en cache. Des hits complets pour le premier groupe.
Et la quatrième sous-ligne de chaque ligne indique le pourcentage du nombre total. Nous avons des appels. Disons 1 000 000. Et nous pouvons comprendre quelle contribution ce groupe apporte. Nous voyons que dans ce cas, le premier groupe apporte une contribution inférieure à 0,01 %. Autrement dit, il est si lent que nous ne le voyons pas dans l'ensemble du tableau. Et le deuxième groupe – 5 % des appels. C’est-à-dire que 5 % de tous les appels proviennent du deuxième groupe.
Concernant le total_time, c'est aussi intéressant. Pour le premier groupe de requêtes, nous avons dépensé 14 % de tout le temps de fonctionnement. Et pour le deuxième – 11 % et ainsi de suite.
Je ne vais pas entrer dans les détails, mais il y a des subtilités. Nous affichons l'erreur en haut, car lorsque nous comparons, les instantanés peuvent dériver, c’est-à-dire que certaines requêtes peuvent disparaitre et ne peuvent pas être présentes dans le deuxième, tandis que certaines peuvent apparaître. Et nous calculons cette erreur. Si vous voyez 0, c'est bon. Il n'y a pas d'erreurs. Si le taux d'erreur est inférieur à 20 %, c'est OK.
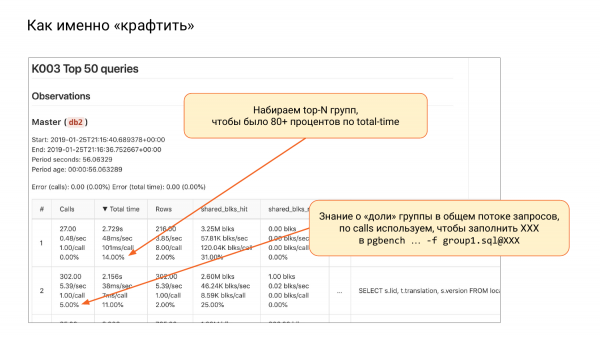
Ensuite, nous revenons à notre sujet. Nous devons créer une charge de travail. Nous prenons de haut en bas, jusqu'à atteindre 80 % ou 90 %. En général, il s'agit de 10 à 20 groupes. Et nous faisons des fichiers pour pgbench. Là, nous utilisons random. Parfois, hélas, cela ne fonctionne pas. Et dans Postgres 12, il y aura plus d'options pour utiliser cette approche.
Et ensuite, nous atteignons ainsi 80 à 90 % du total_time. Que faut-il mettre après «@» ? Nous examinons les appels, nous regardons combien de pourcentages et nous comprenons que nous devons ici avoir tant de pourcentages. À partir de ces pourcentages, nous pouvons évaluer comment équilibrer chacun des fichiers. Après cela, nous utilisons pgbench et nous commençons à travailler.
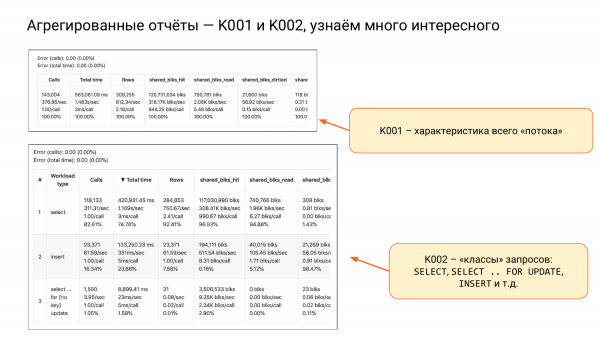
Nous avons aussi K001 et K002.
K001 - c'est une grande chaîne avec quatre sous-chaînes. C'est la caractéristique de toute notre charge. Regardez la deuxième colonne et la deuxième sous-chaîne. Nous voyons qu'il faut environ une seconde et demie par seconde, c’est-à-dire que si nous avons deux cœurs, cela ira bien. Cela correspond à environ 75 % d'utilisation. Et cela fonctionnera ainsi. Si nous avons 10 cœurs, nous serons complètement tranquilles. Ainsi, nous pouvons évaluer les ressources.
K002 - c'est ce que j'appelle des classes de requêtes, c’est-à-dire SELECT, INSERT, UPDATE, DELETE. Et séparément SELECT FOR UPDATE, parce qu'il verrouille.
Ici, nous pouvons conclure que les SELECT ordinaires, donc de lecture – représentent 82 % de tous les appels, mais en même temps – 74 % du total_time. C’est-à-dire qu'ils sont appelés beaucoup, mais consomment moins de ressources.
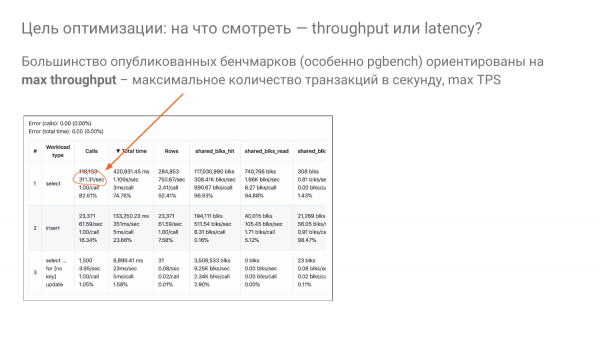
Revenons à la question : « Comment choisir correctement shared_buffers ? ». J'observe que la plupart des benchmarks sont construits sur l'idée - regardons quelle sera la capacité de traitement, c’est-à-dire quelle sera le taux de transfert. Il est généralement mesuré en TPS ou QPS.
Et nous essayons d'extraire de la machine le plus grand nombre possible de transactions par seconde à l'aide des paramètres d'optimisation. Ici, c'est justement 311 par seconde pour les select.
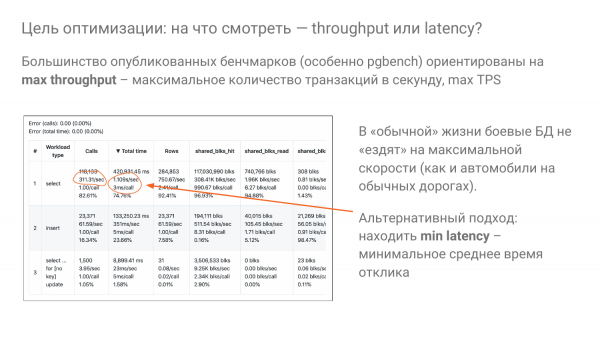
Mais personne ne va au travail et revient chez soi en voiture à pleine vitesse. C’est stupide. C'est pareil avec les bases de données. Nous ne devrions pas rouler à pleine vitesse, et personne ne le fait. Personne ne vit dans une production avec 100 % de CPU. Bien que certains puissent vivre ainsi, ce n'est pas une bonne chose.
L'idée est que nous roulons généralement à environ 20 % de notre capacité, de préférence pas plus de 50 %. Et nous nous efforçons d'optimiser le temps de réponse pour nos utilisateurs avant tout. C’est-à-dire que nous devons ajuster nos manettes pour qu'il y ait une latence minimale à 20 % de vitesse, de manière conditionnelle. C'est une idée que nous essayons également d'utiliser dans nos expériences.
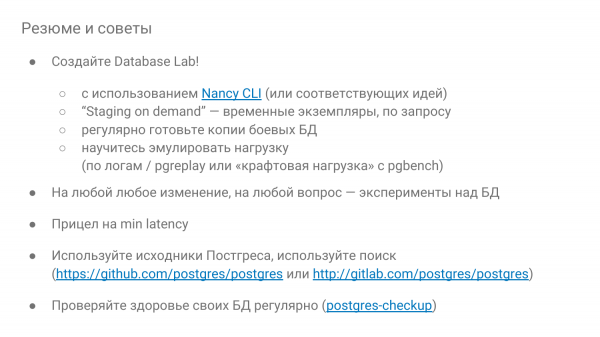
Et pour conclure avec les recommandations :
- Assurez-vous de créer un Database Lab.
- Si possible, faites-le à la demande, pour qu'il se déploie pendant un certain temps - jouez avec et laissez tomber. Si vous avez des clouds, c'est évident, c’est-à-dire qu'il faut avoir beaucoup de standing.
- Soyez curieux. Et si quelque chose ne va pas, faites des expériences pour voir comment cela fonctionne. Nancy peut être utilisée pour s'instruire et tester comment la base fonctionne.
- Visez le temps de réponse le plus court possible.
- Et n'ayez pas peur des sources de Postgres. Lorsque vous travaillez avec les sources, vous devez savoir l'anglais. Il y a beaucoup de commentaires, tout y est expliqué.
- Et vérifiez régulièrement la santé de la base, au moins une fois tous les trois mois manuellement ou avec Postgres-checkup.
Questions
Merci beaucoup ! C'est quelque chose de très intéressant.
Deux choses.
Oui, deux choses. Je n'ai pas tout à fait compris. Lorsque nous travaillons avec Nancy, pouvons-nous ajuster un seul paramètre ou un groupe entier ?
Nous avons un paramètre de delta-config. Vous pouvez y ajuster autant de choses que vous le souhaitez en même temps. Mais il faut comprendre que lorsque vous changez beaucoup de choses, vous pourriez en tirer des conclusions erronées.
Oui. Pourquoi ai-je demandé ça ? Parce qu'il est difficile de mener des expériences lorsque vous n'avez qu'un seul paramètre. Vous l'ajustez, regardez comment ça fonctionne. Vous le définissez. Ensuite, vous commencez avec le suivant.
Il est possible d'ajuster plusieurs paramètres en même temps, mais ça dépend bien sûr de la situation. Mais il est préférable de tester une seule idée. Hier, nous avons eu une idée. Nous avions une situation très similaire. Il y avait deux configurations. Et nous ne pouvions pas comprendre pourquoi il y avait une si grande différence. L'idée était d'utiliser la dichotomie pour comprendre séquentiellement et trouver la différence. Vous pouvez rendre simultanément la moitié des paramètres identiques, puis un quart, et ainsi de suite. Tout est flexible.
J'ai encore une question. Le projet est jeune, en développement. La documentation est-elle déjà prête, y a-t-il une description détaillée ?
J'ai mis un lien vers la description des paramètres là-bas. Cela existe. Mais beaucoup de choses ne sont pas encore là. Je cherche des personnes partageant les mêmes idées. Et je les trouve lorsque je m'exprime. C'est vraiment génial. Quelqu'un travaille déjà avec moi, quelqu'un a aidé et a fait quelque chose là-bas. Et si ce thème vous intéresse, faites-le moi savoir – ce qui manque.
Une fois que nous aurons établi le laboratoire, peut-être qu'il y aura des retours. Nous verrons. Merci !
Bonjour ! Merci pour la présentation ! J'ai vu qu'il y avait un support pour Amazon. Est-il prévu de prendre en charge GSP ?
Bonne question. Nous avons commencé à travailler dessus. Et nous avons mis cela en attente, car nous voulons économiser. C'est-à-dire, il y a un support via run on localhost. Vous pouvez créer vous-même une instance et travailler localement. D'ailleurs, c'est ce que nous faisons. Dans Getlab, je fais cela, il est sur GSP. Mais pour faire cette orchestration, nous ne voyons pas encore l'intérêt, car Google n'a pas d'instances spot à bas prix. Il y a des instances ???, mais elles ont des limitations. Tout d'abord, il y a toujours seulement une remise de 70 %, et on ne peut pas jouer avec le prix. Nous augmentons le prix des spots de 5 à 10 % pour réduire la probabilité de se faire éliminer. C'est-à-dire, vous économisez sur les spots, mais ils peuvent vous être retirés à tout moment. Si vous fixez un prix un peu plus élevé que les autres, vous serez tués plus tard. Google a une spécificité complètement différente. Et il y a une autre limitation très désavantageuse – elles ne vivent que 24 heures. Et parfois, nous voulons faire tourner l'expérience pendant 5 jours. Mais cela peut se faire sur des spots, parfois ils vivent des mois.
Bonjour ! Merci pour la présentation ! Vous avez mentionné le checkup. Comment calculez-vous les erreurs stat_statements ?
Très bonne question. Je peux montrer et expliquer en détail. En résumé – nous regardons comment a fluctué le groupe de requêtes : combien ont échoué et combien de nouvelles sont apparues. Ensuite, nous examinons deux métriques : total_time et calls, donc il y a deux erreurs. Et nous regardons quelle est la contribution des groupes défaillants. Il y a deux sous-groupes : celui qui est parti et celui qui est arrivé. Nous examinons quelle est leur contribution à l'ensemble.
N'avez-vous pas peur qu'elle soit analysée deux ou trois fois entre les snapshots ?
C'est-à-dire, se sont-ils réenregistrés ou comment cela se passe ?
Par exemple, cette requête a déjà été remplacée une fois, puis elle est revenue et a de nouveau été remplacée, puis elle est revenue encore une fois et a été remplacée. Et vous avez calculé quelque chose ici, mais où est tout cela ?
Bonne question, il faut regarder.
J'ai fait quelque chose de similaire. Moins compliqué, bien sûr, je l'ai fait seul. Mais j'ai dû tout réinitialiser, faire un reset stat_statements et m'orienter au moment du snapshot, en vérifiant qu'il y avait moins d'une certaine proportion pour savoir que ça n'avait pas atteint le plafond de ce que stat_statements pouvait accumuler. Et je me base sur le fait qu'il n'y a probablement rien qui ait été remplacé.
Oui-oui.
Mais je ne comprends pas comment faire autrement de manière fiable.
Malheureusement, je ne me souviens pas exactement – si nous utilisons là-bas le texte de la requête ou le queryid avec pg_stat_statements en nous basant là-dessus. Si nous nous basons sur le queryid, alors théoriquement, nous comparons des éléments comparables.
Non, il peut être évincé plusieurs fois entre les instantanés et revenir à nouveau.
Avec ce même ID ?
Oui.
Nous allons étudier cela. Bonne question. Il faut examiner. Mais pour l’instant, ce que nous voyons, c'est que nous avons soit 0 écrit...
C'est bien sûr un cas rare, mais j'ai été choqué d'apprendre que stat_statements pourrait être évincé.
Il peut y avoir beaucoup de choses dans Pg_stat_statements. Nous avons constaté que si track_utility = on, alors vos ensembles sont également suivis.
Oui, bien sûr.
Et si vous avez Java Hibernate qui est aléatoire, alors la table de hachage commence à se bloquer. Et dès que vous désactivez une application très chargée, vous avez environ 50 à 100 groupes. Et tout devient plus ou moins stable. Un des moyens de lutter contre cela est d'augmenter pg_stat_statements.max.
Oui, mais il faut savoir de combien. Et il faut le surveiller. C'est ce que je fais. C'est-à-dire que j'ai pg_stat_statements.max. Et je vérifie que je n'ai pas atteint 70 % au moment de l'instantané. Bien, cela signifie que nous n'avons rien perdu. Nous faisons un reset. Et nous accumulons à nouveau. Si lors du prochain instantané, c'est moins de 70, cela signifie probablement que nous n'avons de nouveau rien perdu.
Oui. Par défaut, c'est maintenant 5 000. Et beaucoup de gens s'en contentent.
En général, oui.
Vidéo :
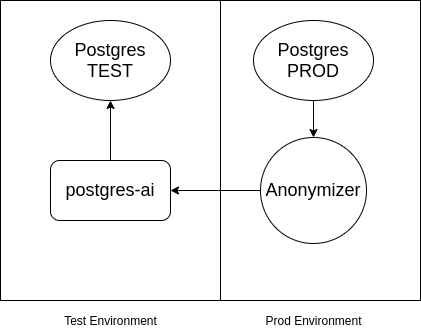
P.S. J'ajoute que si Postgres contient des données confidentielles qui ne doivent pas se retrouver dans l'environnement de test, il est possible d'utiliser . Le schéma est à peu près le suivant :
Source : habr.com
