

Salut, Habr !
Aujourd'hui, nous allons travailler sur la compétence d'utilisation des outils de regroupement et de visualisation des données en Python. Dans le jeu de données fourni , nous analyserons plusieurs caractéristiques et construirons un ensemble de visualisations.
Comme d'habitude, commençons par définir les objectifs :
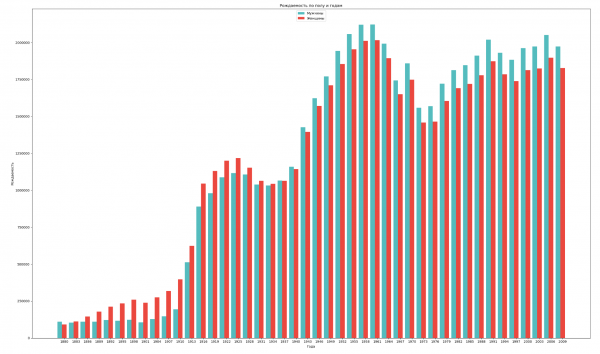
- Regrouper les données par sexe et par année et visualiser la dynamique globale de la natalité des deux sexes;
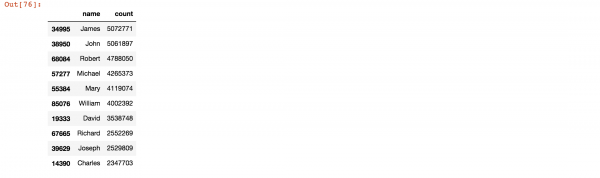
- Trouver les prénoms les plus populaires de l'histoire;
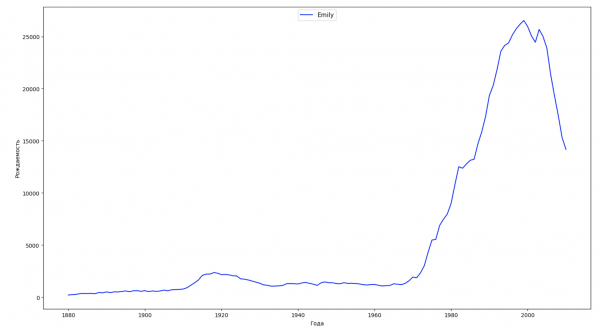
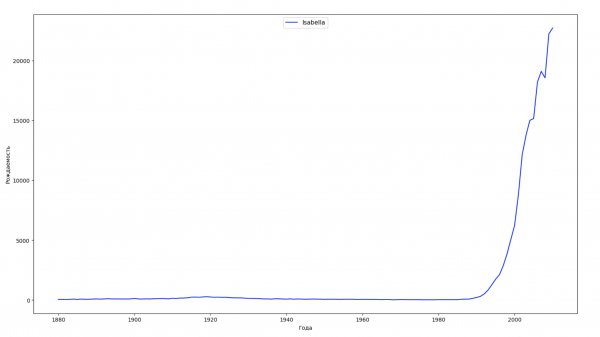
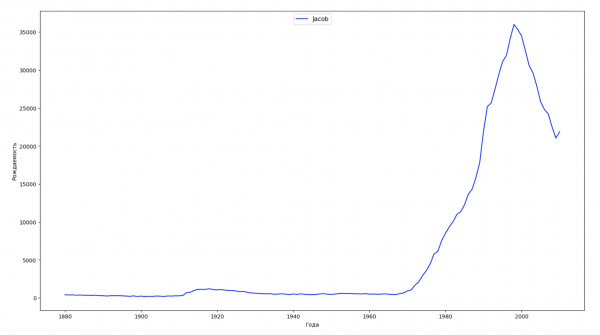
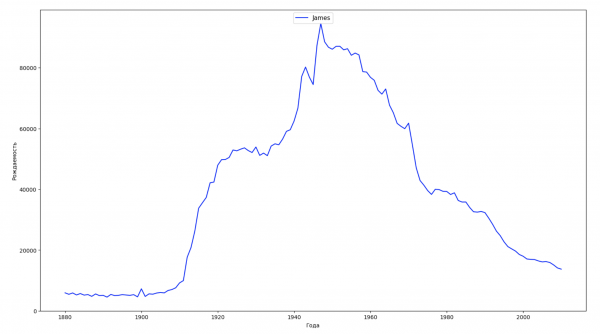
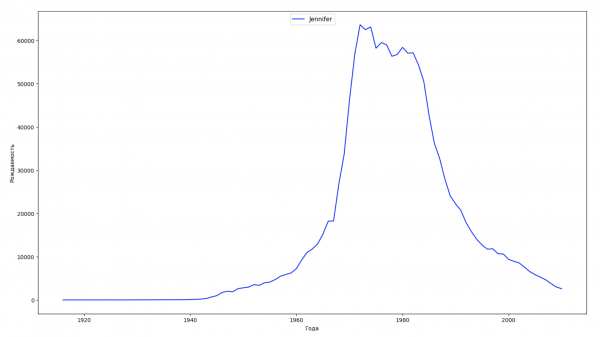
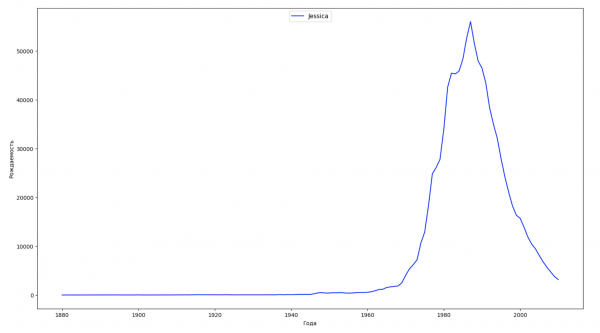
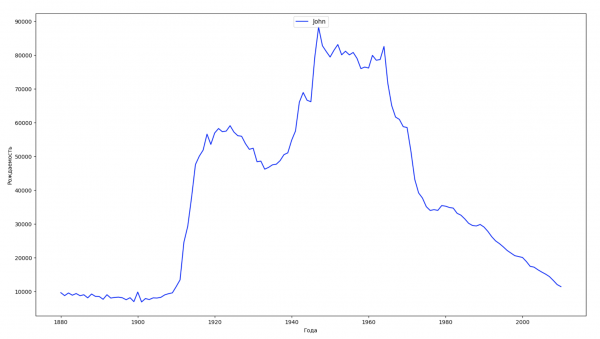
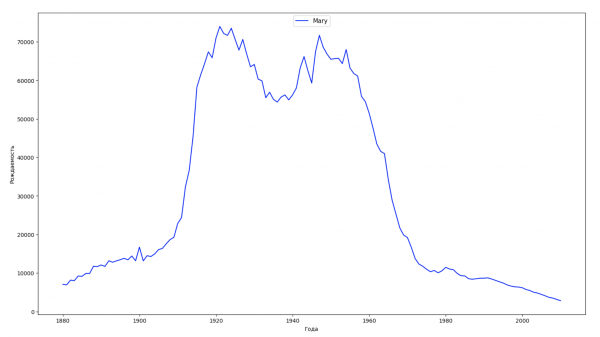
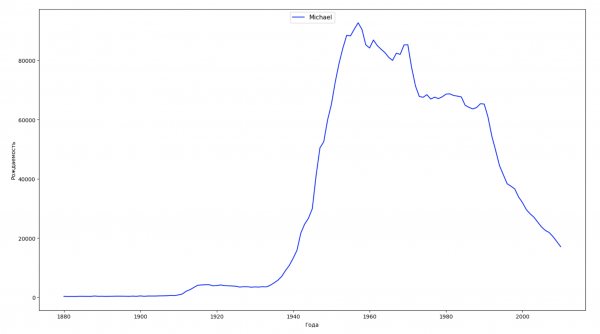
- Diviser toute la période des données en 10 parties et pour chacune trouver le prénom le plus populaire de chaque sexe. Pour chaque prénom trouvé, visualiser sa dynamique dans le temps;
- Pour chaque année, calculer combien de prénoms représentent 50 % de la population et visualiser (nous verrons la diversité des prénoms chaque année);
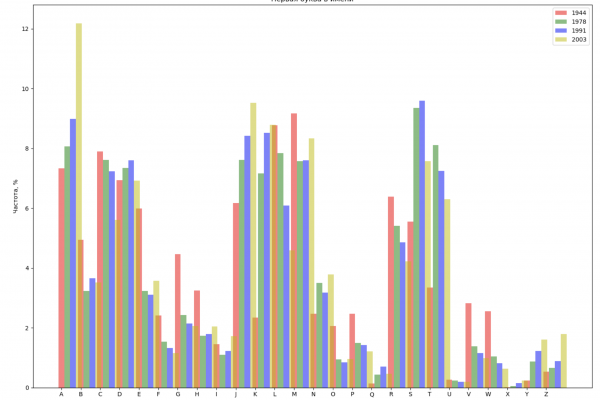
- Choisir 4 années dans toute la période et afficher pour chaque année la répartition par première lettre du prénom et par dernière lettre du prénom;
- Établir une liste de quelques personnalités célèbres (présidents, chanteurs, acteurs, personnages de films) et évaluer leur impact sur la dynamique des prénoms. Créer une visualisation claire.
Moins de mots, plus de code !
Et c'est parti.
Regroupons les données par sexe et par année et visualisons la dynamique globale de la natalité des deux sexes :
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

years = np.arange(1880, 2011, 3)
datalist = 'https://raw.githubusercontent.com/wesm/pydata-book/2nd-edition/datasets/babynames/yob{year}.txt'
dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe.assign(year=year))

result = pd.concat(dataframes)
sex = result.groupby('sex')
births_men = sex.get_group('M').groupby('year', as_index=False)
births_women = sex.get_group('F').groupby('year', as_index=False)
births_men_list = births_men.aggregate(np.sum)['count'].tolist()
births_women_list = births_women.aggregate(np.sum)['count'].tolist()

fig, ax = plt.subplots()
fig.set_size_inches(25,15)

index = np.arange(len(years))
stolb1 = ax.bar(index, births_men_list, 0.4, color='c', label='Hommes')
stolb2 = ax.bar(index + 0.4, births_women_list, 0.4, alpha=0.8, color='r', label='Femmes')

ax.set_title('Natalité par sexe et années')
ax.set_xlabel('Années')
ax.set_ylabel('Natalité')
ax.set_xticklabels(years)
ax.set_xticks(index + 0.4)
ax.legend(loc=9)

fig.tight_layout()
plt.show()
Trouvons les prénoms les plus populaires de l'histoire :
years = np.arange(1880, 2011)

dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe)

result = pd.concat(dataframes)
names = result.groupby('name', as_index=False).sum().sort_values('count', ascending=False)
names.head(10)
Nous allons diviser toute la période des données en 10 parties et pour chacune, nous allons trouver le prénom le plus populaire pour chaque sexe. Pour chaque prénom trouvé, nous allons visualiser sa dynamique au fil du temps :
years = np.arange(1880, 2011)
part_size = int((years[years.size - 1] - years[0]) / 10) + 1
parts = {}
def GetPart(year):
    return int((year - years[0]) / part_size)
for year in years:
    index = GetPart(year)
    r = years[0] + part_size * index, min(years[years.size - 1], years[0] + part_size * (index + 1))
    parts[index] = str(r[0]) + '-' + str(r[1])

dataframe_parts = []
dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframe_parts.append(dataframe.assign(years=parts[GetPart(year)]))
    dataframes.append(dataframe.assign(year=year))

result_parts = pd.concat(dataframe_parts)
result = pd.concat(dataframes)

result_parts_sums = result_parts.groupby(['years', 'sex', 'name'], as_index=False).sum()
result_parts_names = result_parts_sums.iloc[result_parts_sums.groupby(['years', 'sex'], as_index=False).apply(lambda x: x['count'].idxmax())]
result_sums = result.groupby(['year', 'sex', 'name'], as_index=False).sum()

for groupName, groupLabels in result_parts_names.groupby(['name', 'sex']).groups.items():
    group = result_sums.groupby(['name', 'sex']).get_group(groupName)
    fig, ax = plt.subplots(1, 1, figsize=(18,10))

    ax.set_xlabel('Années')
    ax.set_ylabel('Natalité')
    label = group['name']
    ax.plot(group['year'], group['count'], label=label.aggregate(np.max), color='b', ls='-')
    ax.legend(loc=9, fontsize=11)

    plt.show()
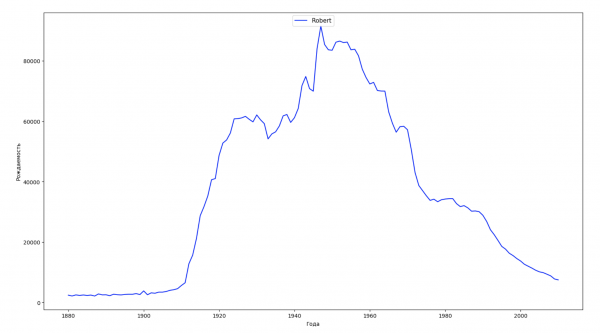
Pour chaque année, nous allons calculer combien de prénoms couvrent 50 % des personnes et visualiser ces données :
dataframe = pd.DataFrame({'year': [], 'count': []})
years = np.arange(1880, 2011)
for year in years:
    dataset = datalist.format(year=year)
    csv = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    names = csv.groupby('name', as_index=False).aggregate(np.sum)
    names['sum'] = names.sum()['count']
    names['percent'] = names['count'] / names['sum'] * 100
    names = names.sort_values(['percent'], ascending=False)
    names['cum_perc'] = names['percent'].cumsum()
    names_filtered = names[names['cum_perc'] <= 50]
    dataframe = dataframe.append(pd.DataFrame({'year': [year], 'count': [names_filtered.shape[0]]}))

fig, ax1 = plt.subplots(1, 1, figsize=(22,13))
ax1.set_xlabel('Années', fontsize = 12)
ax1.set_ylabel('Diversité des prénoms', fontsize = 12)
ax1.plot(dataframe['year'], dataframe['count'], color='r', ls='-')
ax1.legend(loc=9, fontsize=12)

plt.show()
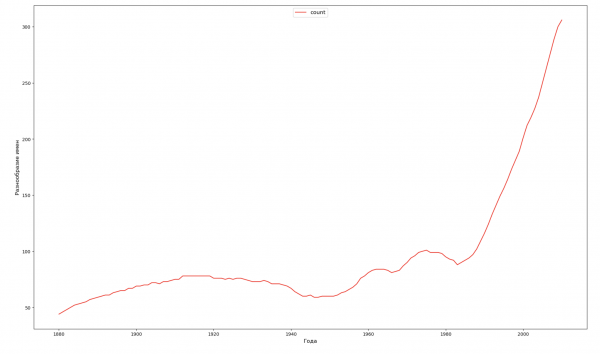
Nous allons choisir 4 années de toute la période et afficher pour chaque année la répartition selon la première et la dernière lettre du prénom :
from string import ascii_lowercase, ascii_uppercase

fig_first, ax_first = plt.subplots(1, 1, figsize=(14,10))
fig_last, ax_last = plt.subplots(1, 1, figsize=(14,10))

index = np.arange(len(ascii_uppercase))
years = [1944, 1978, 1991, 2003]
colors = ['r', 'g', 'b', 'y']
n = 0
for year in years:
    dataset = datalist.format(year=year)
    csv = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    names = csv.groupby('name', as_index=False).aggregate(np.sum)
    count = names.shape[0]

    dataframe = pd.DataFrame({'letter': [], 'frequency_first': [], 'frequency_last': []})
    for letter in ascii_uppercase:
        countFirst = (names[names.name.str.startswith(letter)].count()['count'])
        countLast = (names[names.name.str.endswith(letter.lower())].count()['count'])

        dataframe = dataframe.append(pd.DataFrame({
            'letter': [letter],
            'frequency_first': [countFirst / count * 100],
            'frequency_last': [countLast / count * 100]}))

    ax_first.bar(index + 0.3 * n, dataframe['frequency_first'], 0.3, alpha=0.5, color=colors[n], label=year)
    ax_last.bar(index + bar_width * n, dataframe['frequency_last'], 0.3, alpha=0.5, color=colors[n], label=year)
    n += 1

ax_first.set_xlabel('Lettre de l’alphabet')
ax_first.set_ylabel('Fréquence, %')
ax_first.set_title('Première lettre du prénom')
ax_first.set_xticks(index)
ax_first.set_xticklabels(ascii_uppercase)
ax_first.legend()

ax_last.set_xlabel('Lettre de l’alphabet')
ax_last.set_ylabel('Fréquence, %')
ax_last.set_title('Dernière lettre du prénom')
ax_last.set_xticks(index)
ax_last.set_xticklabels(ascii_uppercase)
ax_last.legend()

fig_first.tight_layout()
fig_last.tight_layout()

plt.show()
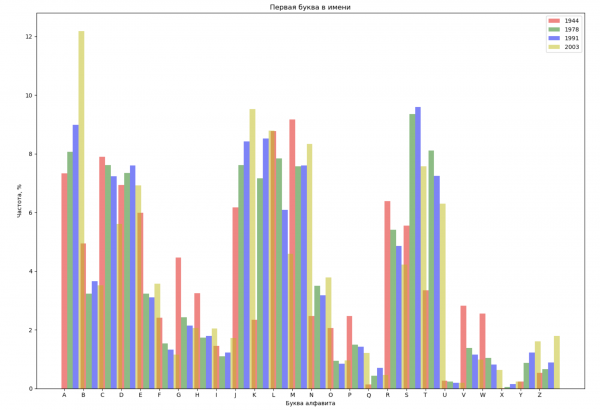
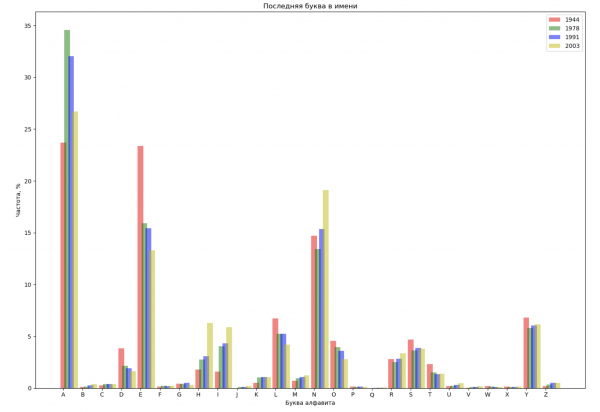
Établissons une liste de quelques personnes célèbres (présidents, chanteurs, acteurs, personnages de cinéma) et évaluons leur influence sur la dynamique des prénoms :
celebrities = {'Frank': 'M', 'Britney': 'F', 'Madonna': 'F', 'Bob': 'M'}
dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe.assign(year=year))

result = pd.concat(dataframes)

for celebrity, sex in celebrities.items():
    names = result[result.name == celebrity]
    dataframe = names[names.sex == sex]
    fig, ax = plt.subplots(1, 1, figsize=(16,8))

    ax.set_xlabel('Années', fontsize = 10)
    ax.set_ylabel('Natalité', fontsize = 10)
    ax.plot(dataframe['year'], dataframe['count'], label=celebrity, color='r', ls='-')
    ax.legend(loc=9, fontsize=12)

    plt.show()
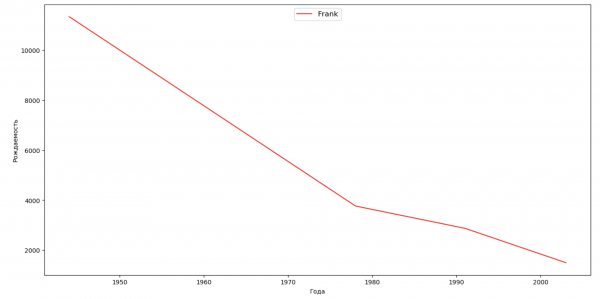
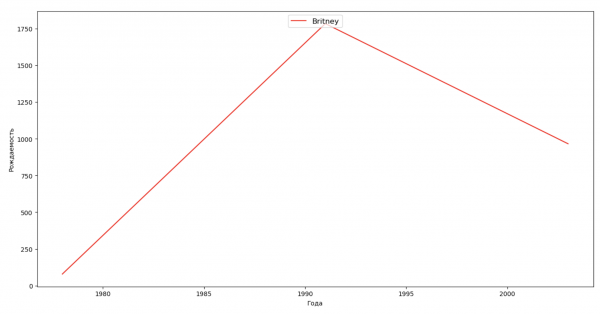
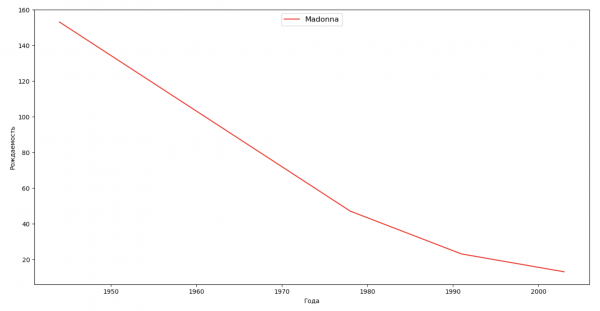
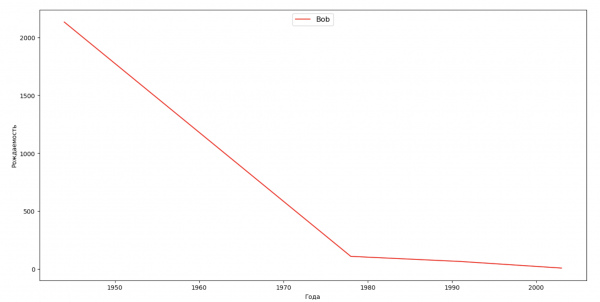
Pour vous entraîner, vous pouvez ajouter à la visualisation la période de vie de la célébrité, afin d’évaluer visuellement leur influence sur la dynamique des prénoms.
Ainsi, tous nos objectifs ont été atteints et réalisés. Nous avons développé la compétence d'utilisation des outils de regroupement et de visualisation des données en Python, et nous continuerons à travailler avec les données. Chacun pourra tirer ses propres conclusions à partir des données déjà prêtes et visualisées.
À tous la connaissance !
Source : habr.com
