

J'ai mis en ligne sur Github .
C'est une simple table de hachage pour GPU, capable de traiter des centaines de millions d'inserts par seconde. Sur mon ordinateur portable avec une NVIDIA GTX 1060, le code insère environ 64 millions de paires clé-valeur générées aléatoirement en environ 210 ms et supprime 32 millions de paires en environ 64 ms.
Cela signifie que la vitesse sur l'ordinateur portable est d'environ 300 millions d'inserts/sec et 500 millions de suppressions/sec.
La table est écrite en CUDA, bien que la même méthode puisse être appliquée à HLSL ou GLSL. La mise en œuvre a plusieurs limitations qui assurent de hautes performances sur la carte graphique :
- Seules des clés et des valeurs de 32 bits sont traitées.
- La table de hachage a une taille fixe.
- Et cette taille doit être égale à une puissance de deux.
Il faut réserver un marqueur de délimitation simple pour les clés et les valeurs (dans le code fourni, c'est 0xffffffff).
Table de hachage sans verrouillage
La table de hachage utilise l'adressage ouvert avec , cela signifie que c'est simplement un tableau de paires clé-valeur, qui est stocké en mémoire et a d'excellentes performances de cache. On ne peut pas en dire autant du chaînage, qui implique la recherche d'un pointeur dans une liste chaînée. La table de hachage est un simple tableau qui stocke les éléments KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
La taille de la table est une puissance de deux, et non un nombre premier, car pour appliquer un masque pow2/AND, il suffit d'une seule instruction rapide, tandis que l'opérateur modulo est beaucoup plus lent. C'est important dans le cas du sondage linéaire, car lors de la recherche linéaire dans la table, l'indice de la case doit être enveloppé dans chaque case. En conséquence, le coût de l'opération modulo s'ajoute à chaque case.
La table ne stocke que la clé et la valeur pour chaque élément, et non le hachage de la clé. Puisque la table ne stocke que des clés de 32 bits, le hachage est calculé très rapidement. Le code fourni utilise le hachage Murmur3, qui ne nécessite que quelques décalages, XOR et multiplications.
Dans une table de hachage, une méthode de protection contre les blocages est appliquée, qui ne dépend pas de l'ordre d'emplacement en mémoire. Même si certaines opérations d'écriture perturbent l'ordre d'autres opérations similaires, la table de hachage conservera quand même un état correct. Nous en parlerons plus bas. Cette méthode fonctionne très bien avec les cartes graphiques, où des milliers de threads s'exécutent en concurrence.
Les clés et les valeurs dans la table de hachage sont initialisées comme vides.
Le code peut être modifié pour qu'il puisse traiter des clés et des valeurs de 64 bits. Des opérations atomiques de lecture, d'écriture et de comparaison avec échange (compare-and-swap) sont nécessaires pour les clés. Pour les valeurs, des opérations atomiques de lecture et d'écriture sont nécessaires. Heureusement, dans CUDA, les opérations de lecture-écriture pour des valeurs de 32 et 64 bits sont atomiques tant qu'elles sont correctement alignées (voir ), et les cartes graphiques modernes prennent en charge les opérations atomiques de comparaison avec échange de 64 bits. Bien sûr, avec le passage à 64 bits, les performances diminuent légèrement.
État de la table de hachage
Chaque paire clé-valeur dans la table de hachage peut avoir l'un des quatre états suivants :
- La clé et la valeur sont vides. Dans cet état, la table de hachage est initialisée.
- La clé a été écrite, mais la valeur ne l'est pas encore. Si un autre thread lit des données à ce moment, il renverra ensuite une valeur vide. Cela est normal, la même chose se produirait si un autre thread venait de s'exécuter juste auparavant, et nous parlons ici d'une structure de données concurrente.
- La clé et la valeur sont toutes deux écrites.
- La valeur est accessible pour d'autres threads, mais la clé ne l'est pas encore. Cela peut se produire car le modèle de programmation dans CUDA suppose un modèle de mémoire faiblement ordonné. C'est normal, dans tous les cas, la clé est toujours vide même si la valeur ne l'est pas.
Un point important est que dès qu'une clé a été écrite dans un slot, elle ne bouge plus — même si la clé est supprimée, nous en parlerons plus bas.
Le code de la table de hachage fonctionne même avec des modèles de mémoire faiblement ordonnés, où l'ordre des lectures et des écritures en mémoire n'est pas connu. Lorsque nous examinerons l'insertion, la recherche et la suppression dans la table de hachage, gardez à l'esprit que chaque paire clé-valeur se trouve dans l'un des quatre états décrits ci-dessus.
Insertion dans la table de hachage
La fonction CUDA qui insère des paires clé-valeur dans une table de hachage se présente comme suit :
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
Pour insérer une clé, le code itère à travers le tableau de la table de hachage en commençant par le hachage de la clé à insérer. Dans chaque emplacement du tableau, une opération atomique de comparaison et d'échange est effectuée, où la clé dans cet emplacement est comparée à vide. Si un non-correspondance est détectée, la clé dans l'emplacement est mise à jour avec la clé à insérer, puis la clé d'origine de l'emplacement est retournée. Si cette clé d'origine était vide ou correspondait à la clé insérée, cela signifie que le code a trouvé un emplacement approprié pour l'insertion et insère la valeur dans cet emplacement.
Si dans un seul appel de noyau gpu_hashtable_insert() il y a plusieurs éléments avec la même clé, alors n'importe laquelle de leurs valeurs peut être écrite dans l'emplacement de la clé. Cela est considéré comme normal : une des opérations d'écriture de la clé-valeur durant l'appel sera réussie, mais comme tout cela se produit parallèlement au sein de plusieurs fils d'exécution, nous ne pouvons pas prédire quelle opération d'écriture en mémoire sera la dernière.
Recherche dans la table de hachage
Code pour rechercher des clés :
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
Pour trouver la valeur d'une clé stockée dans la table, nous itérons à travers le tableau à partir du hachage de la clé recherchée. Dans chaque emplacement, nous vérifions si la clé est celle que nous cherchons, et si oui, nous renvoyons sa valeur. Nous vérifions également si la clé est vide, et si c'est le cas, nous interrompons la recherche.
Si nous ne parvenons pas à trouver la clé, le code renvoie une valeur vide.
Toutes ces opérations de recherche peuvent être effectuées de manière concurrente lors des insertions et des suppressions. Chaque paire dans la table aura pour le fil l'un des quatre états décrits ci-dessus.
Suppression dans la table de hachage
Code pour supprimer des clés :
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
La suppression d'une clé s'effectue de manière inhabituelle : nous laissons la clé dans la table et marquons sa valeur (pas la clé elle-même) comme vide. Ce code ressemble beaucoup à lookup(), sauf que lorsqu'une correspondance est trouvée pour la clé, sa valeur est définie sur vide.
Comme mentionné précédemment, une fois qu'une clé est écrite dans un slot, elle ne bouge plus. Même lorsque l'élément est supprimé de la table, la clé reste à sa place, sa valeur devenant simplement vide. Cela signifie qu'il n'est pas nécessaire d'utiliser une opération d'écriture atomique pour la valeur du slot, car il n'importe pas si la valeur actuelle est vide ou non — elle deviendra de toute façon vide.
Redimensionnement de la table de hachage
Le redimensionnement de la table de hachage peut être effectué en créant une table plus grande et en insérant les éléments non vides de l'ancienne table. Je n'ai pas réalisé cette fonctionnalité car je voulais garder le code simple. De plus, dans les programmes CUDA, l'allocation de mémoire est souvent effectuée dans le code hôte, et non dans le noyau CUDA.
Dans l'article décrit comment modifier une telle structure de données protégée contre les blocages.
Concurrence
Dans les extraits de code ci-dessus, les fonctions gpu_hashtable_insert(), _lookup() et _delete() traitent une paire clé-valeur à la fois. En revanche, ci-dessous gpu_hashtable_insert(), _lookup() et _delete() traite un tableau de paires en parallèle, chaque paire dans un thread d'exécution GPU séparé :
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Une table de hachage protégée contre les blocages supporte les insertions, recherches et suppressions concurrentes. Comme les paires clé-valeur se trouvent toujours dans un des quatre états, et que les clés ne bougent pas, la table garantit la cohérence même lors de l'utilisation simultanée d'opérations de différents types.
Cependant, si nous traitons parallèlement un lot d'inserts et de suppressions, et si le tableau d'entrée contient des clés dupliquées, nous ne pourrons pas prédire quelles paires "vont gagner" — c'est-à-dire celles qui seront écrites en dernier dans la table de hachage. Supposons que nous avons appelé le code d'insertion avec le tableau d'entrée de paires A/0 B/1 A/2 C/3 A/4. Lorsque le code sera terminé, les paires B/1 et C/3 seront garanties d'être présentes dans la table, mais en même temps, l'une des paires A/0, A/2 ou A/4Cela peut être un problème ou non, tout dépend de l'application. Vous pouvez savoir à l'avance qu'il n'y a pas de clés dupliquées dans le tableau d'entrée, ou il se peut que cela ne vous importe pas quel est la valeur enregistrée en dernier.
Si c'est un problème pour vous, il faut diviser les paires dupliquées en différents appels système CUDA. Dans CUDA, toute opération d'appel de noyau se termine toujours avant le prochain appel de noyau (du moins à l'intérieur d'un même flux. Dans différents flux, les noyaux s'exécutent en parallèle). Si dans l'exemple ci-dessus, un noyau est appelé avec A/0 B/1 A/2 C/3, et un autre avec A/4, alors la clé A obtiendra la valeur 4.
Parlons maintenant de savoir si les fonctions lookup() et delete() doivent utiliser un pointeur simple (plain) ou un pointeur variable (volatile) sur un tableau de paires dans une table de hachage. déclare que :
Le compilateur peut optimiser à sa discrétion les opérations de lecture et d'écriture en mémoire globale ou partagée … Ces optimisations peuvent être désactivées à l'aide du mot-clé
volatile: … toute référence à cette variable est compilée en une véritable instruction de lecture ou d'écriture en mémoire.
Des considérations d'exactitude ne nécessitent pas d'application. volatileSi le flux d'exécution utilise une valeur mise en cache provenant d'une opération de lecture antérieure, cela signifie qu'il utilisera des informations légèrement obsolètes. Mais cela reste des informations provenant d'un état valide de la table de hachage à un moment donné de l'appel de noyau. Si vous devez utiliser les informations les plus récentes, alors vous pouvez utiliser un pointeur volatile, mais cela peut légèrement réduire les performances : selon mes tests, lors de la suppression de 32 millions d'éléments, la vitesse est passée de 500 millions de suppressions/seconde à 450 millions de suppressions/seconde.
Performance
Dans le test d'insertion de 64 millions d'éléments et la suppression de 32 millions d'entre eux, la concurrence entre std::unordered_map et la table de hachage pour GPU est en fait inexistante :
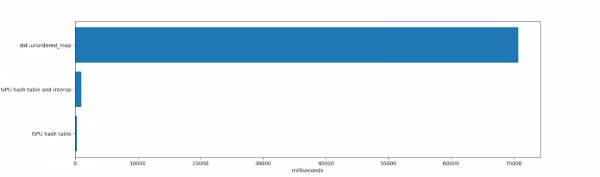
std::unordered_map cela a pris 70 691 ms pour insérer et supprimer des éléments avec le libération subséquente de unordered_map ((libérer des millions d'éléments prend beaucoup de temps, car à l'intérieur unordered_map de nombreuses allocations de mémoire sont effectuées). Honnêtement, pour std::unordered_map des limitations complètement différentes. Cela représente un seul flux d'exécution CPU, capable de gérer des clés-valeurs de n'importe quelle taille, fonctionnant bien sous des taux d'utilisation élevés et affichant des performances stables après de nombreuses suppressions.
La durée de fonctionnement de la table de hachage pour le GPU et l'interaction inter-programmes a été de 984 ms. Cela inclut le temps nécessaire pour allouer la table en mémoire et la supprimer (une seule allocation de 1 Go de mémoire, ce qui prend un certain temps dans CUDA), l'insertion et la suppression d'éléments, ainsi que l'itération à travers. Toutes les copies en mémoire et depuis la mémoire de la carte graphique ont également été prises en compte.
Le fonctionnement de la table de hachage elle-même a pris 271 ms. Cela inclut le temps que la carte graphique a passé à insérer et à supprimer des éléments, et n'inclut pas le temps nécessaire pour copier en mémoire et itérer à travers la table résultante. Si la table GPU reste active longtemps, ou si la table de hachage est entièrement stockée dans la mémoire de la carte graphique (par exemple, pour créer une table de hachage qui sera utilisée par un autre code GPU plutôt que par le processeur central), alors le résultat du test est pertinent.
La table de hachage pour la carte graphique démontre de hautes performances grâce à une grande bande passante et à un parallélisme actif.
Inconvénients
L'architecture de la table de hachage présente plusieurs problèmes à garder à l'esprit :
- Le sondage linéaire est affecté par la fragmentation, ce qui fait que les clés dans la table ne sont pas placées de manière optimale.
- Les clés ne sont pas supprimées par la fonction
supprimeret encombrent la table avec le temps.
En conséquence, les performances de la table de hachage peuvent progressivement diminuer, surtout si elle existe longtemps et que de nombreuses insertions et suppressions y sont effectuées. L'une des façons d'atténuer ces inconvénients est de re-hachager dans une nouvelle table avec un coefficient d'utilisation suffisamment bas et de filtrer les clés supprimées lors du re-hachage.
Pour illustrer les problèmes décrits, j'utilise le code ci-dessus pour créer une table de 128 millions d'éléments, et j'insérerai cycliquement 4 millions d'éléments jusqu'à ce que 124 millions de cases soient remplies (coefficient d'utilisation d'environ 0,96). Voici le tableau des résultats, chaque ligne représentant un appel au noyau CUDA avec l'insertion de 4 millions de nouveaux éléments dans une table de hachage :
Coefficient d'utilisation
Durée d'insertion de 4 194 304 éléments
0,00
11,608448 ms (361,314798 millions de clés/seconde)
0,03
11,751424 ms (356,918799 millions de clés/seconde)
0,06
11,942592 ms (351,205515 millions de clés/seconde)
0,09
12,081120 ms (347,178429 millions de clés/seconde)
0,12
12,242560 ms (342,600233 millions de clés/seconde)
0,16
12,396448 ms (338,347235 millions de clés/seconde)
0,19
12,533024 ms (334,660176 millions de clés/seconde)
0,22
12,703328 ms (330,173626 millions de clés/seconde)
0,25
12,884512 ms (325,530693 millions de clés/seconde)
0,28
13,033472 ms (321,810182 millions de clés/seconde)
0,31
13,239296 ms (316,807174 millions de clés/seconde)
0,34
13,392448 ms (313,184256 millions de clés/seconde)
0,37
13,624000 ms (307,861434 millions de clés/seconde)
0,41
13,875520 ms (302,280855 millions de clés/seconde)
0,44
14,126528 ms (296,909756 millions de clés/seconde)
0,47
14,399328 ms (291,284699 millions de clés/seconde)
0,50
14,690304 ms (285,515123 millions de clés/seconde)
0,53
15,039136 ms (278,892623 millions de clés/seconde)
0,56
15,478656 ms (270,973402 millions de clés/seconde)
0,59
15,985664 ms (262,379092 millions de clés/seconde)
0,62
16,668673 ms (251,627968 millions de clés/seconde)
0,66
17,587200 ms (238,486174 millions de clés/seconde)
0,69
18,690048 ms (224,413765 millions de clés/seconde)
0,72
20,278816 ms (206,831789 millions de clés/seconde)
0,75
22,545408 ms (186,038058 millions de clés/seconde)
0,78
26,053312 ms (160,989275 millions de clés/seconde)
0,81
31,895008 ms (131,503463 millions de clés/seconde)
0,84
42,103294 ms (99,619378 millions de clés/seconde)
0,87
61,849056 ms (67,815164 millions de clés/seconde)
0,90
105,695999 ms (39,682713 millions de clés/seconde)
0,94
240,204636 ms (17,461378 millions de clés/seconde)
À mesure que le coefficient d'utilisation augmente, la performance diminue. Cela est indésirable dans la plupart des cas. Si une application insère des éléments dans une table et les supprime ensuite (par exemple, lors du comptage des mots dans un livre), ce n'est pas un problème. Mais si une application utilise une table de hachage à long terme (par exemple, dans un éditeur graphique pour stocker les parties non vides des images lorsque l'utilisateur insère et supprime souvent des informations), ce comportement peut être gênant.
J'ai également mesuré la profondeur de sondage de la table de hachage après 64 millions d'inserts (coefficient d'utilisation de 0,5). La profondeur moyenne était de 0,4774, donc la plupart des clés étaient soit dans les meilleurs emplacements possibles, soit à un emplacement du meilleur emplacement. La profondeur maximale de sondage était de 60.
Ensuite, j'ai mesuré la profondeur de sondage dans une table avec 124 millions d'inserts (coefficient d'utilisation de 0,97). La profondeur moyenne était déjà de 10,1757, et la profondeur maximale était de 6474 (!!). La performance du sondage linéaire chute fortement à des coefficients d'utilisation élevés.
Il est préférable de maintenir un faible taux d'utilisation de cette table de hachage. Mais cela augmente la performance au prix de la consommation de mémoire. Heureusement, avec des clés et des valeurs de 32 bits, cela peut être justifié. Si dans l'exemple ci-dessus, la table de 128 millions d'éléments maintient un taux d'utilisation de 0,25, nous pourrons y placer au maximum 32 millions d'éléments, tandis que les 96 millions de places restantes seront perdues — soit 8 octets pour chaque paire, 768 Mo de mémoire perdue.
Notez qu'il s'agit de la perte de mémoire de la carte graphique, qui est une ressource plus précieuse que la mémoire système. Bien que la plupart des cartes graphiques de bureau modernes prenant en charge CUDA aient au moins 4 Go de mémoire (au moment de la rédaction, la NVIDIA 2080 Ti dispose de 11 Go), perdre de tels volumes ne sera pas la décision la plus judicieuse.
Je parlerai plus en détail de la création de tables de hachage pour les cartes graphiques qui n'ont pas de problèmes de profondeur de sonde, ainsi que des moyens de réutiliser les emplacements supprimés.
Mesure de la profondeur de sonde
Pour déterminer la profondeur de sonde d'une clé, nous pouvons extraire le hachage de la clé (son index idéal dans la table) de son index réel dans la table :
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
En raison de la magie de deux nombres binaires en complément à deux et du fait que la capacité d'une table de hachage est égale à une puissance de deux, cette approche fonctionnera même lorsque l'index de la clé déborde au début de la table. Prenons une clé qui est hachée en 1, mais insérée dans le slot 3. Ainsi, pour une table de capacité 4, nous obtenons (3 — 1) & 3, ce qui équivaut à 2.
Conclusion
Si vous avez des questions ou des commentaires, écrivez-moi à ou ouvrez un nouveau sujet dans.
Ce code est inspiré par d'excellents articles :
À l'avenir, je continuerai à écrire sur les implémentations de tables de hachage pour les cartes graphiques et j'analyserai leur performance. Je prévois d'aborder les chaînes de hachage, le hachage de Robin des Bois et le hachage par coucou en utilisant des opérations atomiques dans des structures de données adaptées aux cartes graphiques.
Source : habr.com
