

Ceci est une norme (ISO, ITU-T, GOST) pour un langage décrivant des informations structurées, ainsi que les règles d'encodage de ces informations. Pour moi, en tant que programmeur, c'est juste un autre format de sérialisation et de représentation des données, au même titre que JSON, XML, XDR et d'autres. Il est extrêmement courant dans notre vie quotidienne, et beaucoup y sont confrontés : dans les communications cellulaires, téléphoniques, VoIP (UMTS, LTE, WiMAX, SS7, H.323), dans les protocoles réseau (LDAP, SNMP, Kerberos), dans tout ce qui concerne la cryptographie (X.509, CMS, normes PKCS), sur les cartes bancaires et passeports biométriques, et bien d'autres domaines.
Cet article examine : une bibliothèque Python ASN.1 utilisée activement dans des projets liés à la cryptographie dans .
En fait, il n'est pas recommandé d'utiliser ASN.1 pour les tâches cryptographiques : ASN.1 et ses codecs sont complexes. Cela signifie que le code ne sera pas simple, ce qui constitue toujours un vecteur d'attaque supplémentaire. Il suffit de regarder des vulnérabilités dans les bibliothèques ASN.1. Bruce Schneier, dans son ouvrage recommande également de ne pas utiliser cette norme en raison de sa complexité : « Le codage TLV le mieux connu est ASN.1, mais il est incroyablement complexe et nous nous en éloignons ». Mais, malheureusement, aujourd'hui nous avons dans lesquels sont activement utilisées , CRL, OCSP, TSP, protocoles CMP, , messages , et une multitude de normes . Par conséquent, il faut savoir travailler avec ASN.1 si vous êtes impliqué dans quelque chose liée à la cryptographie.
ASN.1 peut être encodé de plusieurs manières/codecs :
- (Basic Encoding Rules)
- (Canonical Encoding Rules)
- (Distinguished Encoding Rules)
- (Generic String Encoding Rules)
- (JSON Encoding Rules)
- LWER (Light Weight Encoding Rules)
- (Octet Encoding Rules)
- (Packed Encoding Rules)
- SER (Signalling specific Encoding Rules)
- (XML Encoding Rules)
et plusieurs autres. Cependant, pour les tâches cryptographiques, en pratique, deux sont utilisées : BER et DER. Même dans les documents XML signés (, ) il y aura toujours des objets ASN.1 DER encodés en Base64, tout comme dans le protocole orienté JSON de Let’s Encrypt. Il est préférable de comprendre tous ces codecs et principes d'encodage BER/CER/DER à travers des articles et des livres : , , .
BER est un format TLV binaire orienté octets (par exemple, PER, populaire dans les communications cellulaires, est orienté bits). Chaque élément est codé sous la forme : d'une balise (destag), identifiant le type de l'élément codé (nombre entier, chaîne, date, etc.), d'une longueur (Llength) du contenu et du contenu lui-même (VLe BER optionnel permet de ne pas spécifier la valeur de longueur, en utilisant une valeur de longueur indéfinie et en terminant le message par une étiquette End-Of-Octets. En plus du codage de la longueur, le BER présente une grande variabilité dans la manière de coder les types de données, tels que :
- INTEGER, OBJECT IDENTIFIER, BIT STRING et la longueur de l'élément peuvent ne pas être normalisées (non codées sous leur forme minimale);
- BOOLEAN est vrai pour tout contenu non nul;
- BIT STRING peut contenir des bits nuls "superflus";
- BIT STRING, OCTET STRING et tous leurs types de chaînes dérivés, y compris date/heure, peuvent être fractionnés en morceaux (chunk) de longueur variable, dont la longueur n'est pas connue à l'avance lors du (dé)codage;
- UTCTime/GeneralizedTime peuvent avoir différentes méthodes pour spécifier le décalage horaire et des fractions de seconde "superflues";
- Les valeurs DEFAULT SEQUENCE peuvent être codées ou non;
- Les valeurs nommées des derniers bits dans BIT STRING peuvent ne pas être codées à la discrétion;
- SEQUENCE (OF)/SET (OF) peuvent avoir un ordre d'éléments arbitraire.
En raison de tout ce qui précède, coder des données de manière à ce qu'elles soient identiques à la forme originale n'est pas toujours possible. C'est pourquoi un sous-ensemble de règles a été conçu : le DER — qui impose une seule méthode de codage autorisée, ce qui est critique pour les tâches cryptographiques, où, par exemple, le changement d'un bit rendrait la signature ou le hachage invalide. Le DER a un inconvénient majeur : les longueurs de tous les éléments doivent être connues à l'avance lors du codage, ce qui empêche la sérialisation des données en flux. Le codec CER n'a pas ce problème, garantissant également une représentation unique des données. Malheureusement (ou heureusement, car nous n'avons pas encore de décodeurs plus complexes ?), il n'est pas devenu populaire. Ainsi, dans la pratique, nous rencontrons une utilisation "mixte" de données codées en BER et DER. Étant donné que les CER et DER sont des sous-ensembles du BER, tout décodeur BER est capable de les traiter.
Problèmes avec pyasn1
Dans notre travail, nous écrivons de nombreux programmes en Python liés à la cryptographie. Il y a quelques années, il y avait peu de bibliothèques gratuites disponibles : soit ce sont des bibliothèques très bas niveau, permettant simplement de coder/décoder, par exemple, un entier et un en-tête de structure, soit c'est la bibliothèque . Nous y avons vécu plusieurs années et au début, nous étions très satisfaits, car cela permet de travailler avec des structures ASN.1 comme des objets de haut niveau : par exemple, un objet décodé d'un certificat X.509 permet d'accéder à ses champs via une interface-dictionnaire : cert[«tbsCertificate»][«serialNumber»] nous montrera le numéro de série de ce certificat. De même, on peut «assembler» des objets complexes en travaillant avec eux comme avec des listes, des dictionnaires, puis simplement appeler la fonction pyasn1.codec.der.encoder.encode et obtenir une représentation sérialisée du document.
Cependant, des défauts, des problèmes et des limitations sont apparus. Dans pyasn1, il y avait et, malheureusement, il y a encore des erreurs : au moment de la rédaction de l'article, dans pyasn1, l'un des types de base - GeneralizedTime, décodé et codé.
Dans nos projets, pour économiser de l'espace, nous stockons souvent uniquement le chemin du fichier, le décalage et la longueur en octets de l'objet auquel nous souhaitons faire référence. Par exemple, un fichier signé arbitraire se trouvera sûrement dans la structure ASN.1 CMS SignedData :
  0     [1,3,1018]  ContentInfo SEQUENCE
  4     [1,1,   9]   . contentType: ContentType OBJECT IDENTIFIER 1.2.840.113549.1.7.2 (id_signedData)
 19-4   [0,0,1003]   . content: [0] EXPLICIT [UNIV 16] ANY
 19     [1,3, 999]   . . DÉFINI PAR id_signedData: SignedData SEQUENCE
 23     [1,1,   1]   . . . version: CMSVersion INTEGER v3 (03)
 26     [1,1,  19]   . . . digestAlgorithms: DigestAlgorithmIdentifiers SET OF
                           [...]
 47     [1,3, 769]   . . . encapContentInfo: EncapsulatedContentInfo SEQUENCE
 51     [1,1,   8]   . . . . eContentType: ContentType OBJECT IDENTIFIER 1.3.6.1.5.5.7.12.2 (id_cct_PKIData)
 65-4   [1,3, 751]   . . . . eContent: [0] EXPLICIT OCTET STRING 751 bytes OPTIONAL

                 ICI SE TROUVE LE CONTENU DU FICHIER SIGNÉ DE TAILLE 751 OCTETS

820     [1,2, 199]   . . . signerInfos: SignerInfos SET OF
823     [1,2, 196]   . . . . 0: SignerInfo SEQUENCE
826     [1,1,   1]   . . . . . version: CMSVersion INTEGER v3 (03)
829     [0,0,  22]   . . . . . sid: SignerIdentifier CHOICE subjectKeyIdentifier
                               [...]
956     [1,1,  64]   . . . . . signature: SignatureValue OCTET STRING 64 bytes
                     . . . . . . C1:B3:88:BA:F8:92:1C:E6:3E:41:9B:E0:D3:E9:AF:D8
                     . . . . . . 47:4A:8A:9D:94:5D:56:6B:F0:C1:20:38:D2:72:22:12
                     . . . . . . 9F:76:46:F6:51:5F:9A:8D:BF:D7:A6:9B:FD:C5:DA:D2
                     . . . . . . F3:6B:00:14:A4:9D:D7:B5:E1:A6:86:44:86:A7:E8:C9
Nous pouvons obtenir le fichier signé original avec un décalage de 65 octets, d'une longueur de 751 octets. Pyasn1 ne stocke pas cette information dans ses objets décodés. Une bibliothèque appelée TLVSeeker a été écrite, permettant de décoder les balises et les longueurs des objets, dans laquelle nous avons pu donner des commandes telles que « passer à la balise suivante », « entrer dans la balise » (en pénétrant dans l'objet SEQUENCE), « passer à la balise suivante », « indiquer notre offset et la longueur de l'objet où nous sommes ». Cela correspondait à un parcours « manuel » des données sérialisées ASN.1 DER. Cependant, cela ne pouvait pas fonctionner avec les données sérialisées BER, car par exemple, une chaîne d'octets OCTET STRING pouvait être codée en plusieurs morceaux.
Un autre inconvénient de pyasn1 pour nos besoins est l'incapacité de déterminer à partir des objets décodés si un champ spécifique était présent dans la SEQUENCE ou non. Par exemple, si la structure contient le champ Field SEQUENCE OF Smth OPTIONAL, il pouvait totalement manquer dans les données reçues (OPTIONAL), ou bien être présent mais de longueur nulle (liste vide). En général, cela ne pouvait pas être déterminé. Or, c'est nécessaire pour une vérification stricte de la validité des données reçues. Imaginez qu'une autorité de certification ait délivré un certificat avec des données « pas tout à fait » valides du point de vue des schémas ASN.1 ! Par exemple, l'autorité de certification « TÜRKTRUST Elektronik Sertifika Hizmet Sağlayıcısı » dans son certificat racine a dépassé les limites. de la longueur du composant subject — il est impossible de le décoder correctement selon le schéma. Le codec DER exige qu'un champ ayant la valeur par défaut ne soit pas codé lors de la transmission — dans la pratique, de tels documents existent, et la première version de PyDERASN a même volontairement permis ce comportement invalide (du point de vue DER) pour des raisons de compatibilité ascendante.
Une autre limitation est l'impossibilité de savoir facilement sous quelle forme (BER/DER) un objet particulier a été encodé dans la structure. Par exemple, la norme CMS stipule que le message est encodé en BER, mais le champ signedAttrs, qui est utilisé pour créer la signature cryptographique, doit être en DER. Si nous décodons avec DER, nous rencontrerons des difficultés lors du traitement de la CMS elle-même, et si nous décodons avec BER, nous ne saurons pas sous quelle forme se trouve signedAttrs. En fin de compte, il faudra utiliser TLVSeeker (dont il n'existe pas d'analogue dans pyasn1) pour rechercher la position de chacun des champs signedAttrs et les décoder séparément en DER à partir de la représentation sérialisée.
Nous avions vraiment hâte de pouvoir traiter automatiquement les champs DEFINED BY, qui se rencontrent très souvent. Après le décodage de la structure ASN.1, il peut nous rester de nombreux champs ANY qui doivent être traités selon un schéma basé sur l'OBJECT IDENTIFIER spécifié dans le champ de la structure. Dans le code Python, cela signifie écrire des instructions if et invoquer ensuite le décodeur pour le champ ANY.
L'émergence de PyDERASN
Dans Atlas, nous envoyons régulièrement des patches vers le haut en trouvant des problèmes ou en améliorant des programmes libres que nous utilisons. Dans pyasn1, nous avons envoyé des améliorations plusieurs fois, mais le code pyasn1 n'est pas le plus simple à comprendre et il a parfois subi des modifications d'API incompatibles qui nous ont pénalisés. De plus, nous étions habitués à rédiger des tests avec des tests génératifs, ce qui n'existait pas dans pyasn1.
Un beau jour, j'ai décidé que cela suffisait et qu'il était temps d'essayer d'écrire ma propre bibliothèque avec des __slots__, des offsets et des blobs magnifiquement affichables ! Créer un simple codec ASN.1 ne serait pas suffisant — il fallait transférer tous nos projets interconnectés vers cette bibliothèque, ce qui représente des centaines de milliers de lignes de code comportant beaucoup de travail avec des structures ASN.1. Donc, l'un des critères était : la facilité de transfert du code actuel de pyasn1. En dépensant tout mon congé, j'ai écrit cette bibliothèque et j'ai migré tous les projets vers elle. Étant donné qu'ils ont pratiquement une couverture de tests de 100 %, cela signifiait également la pleine fonctionnalité de la bibliothèque.
PyDERASN, de manière similaire, a pratiquement une couverture de tests de 100 %. Il utilise des tests génératifs avec une bibliothèque merveilleuse . Des tests de -em sur des machines à 32 cœurs. Bien que nous n'ayons presque plus de code Python2, PyDERASN conserve néanmoins la compatibilité avec celui-ci et, pour cette raison, a une unique dépendance. De plus, il a été testé contre .
Le principe de fonctionnement est similaire à pyasn1 — il travaille avec des objets Python de haut niveau. La description des schémas ASN.1 est similaire.
class TBSCertificate(Sequence):
    schema = (
        ("version", Version(expl=tag_ctxc(0), default="v1")),
        ("serialNumber", CertificateSerialNumber()),
        ("signature", AlgorithmIdentifier()),
        ("issuer", Name()),
        ("validity", Validity()),
        ("subject", Name()),
        ("subjectPublicKeyInfo", SubjectPublicKeyInfo()),
        ("issuerUniqueID", UniqueIdentifier(impl=tag_ctxp(1), optional=True)),
        ("subjectUniqueID", UniqueIdentifier(impl=tag_ctxp(2), optional=True)),
        ("extensions", Extensions(expl=tag_ctxc(3), optional=True)),
    )
Cependant, PyDERASN a une forme de typage strict. Dans pyasn1, si un champ avait le type CMSVersion(INTEGER), on pouvait lui attribuer un int ou un INTEGER. PyDERASN exige donc rigoureusement que l'objet attribué soit précisément CMSVersion. De plus, même si nous écrivons du code Python3, nous utilisons aussi , c'est pourquoi dans nos fonctions, nous aurons des arguments clairs tels que def func(serial, contents) et non des arguments ambigus comme def func(serial: CertificateSerialNumber, contents: EncapsulatedContentInfo), et PyDERASN aide à respecter ce type de code.
De plus, PyDERASN offre des concessions extrêmement pratiques concernant ce typage. pyasn1 ne permettait pas d'attribuer un objet SubjectKeyIdentifier() à un champ de SubjectKeyIdentifier().subtype(implicitTag=Tag(…)) (sans le tag IMPLICIT requis) et il fallait souvent copier et recréer des objets uniquement à cause de tags IMPLICIT/EXPLICIT modifiés. PyDERASN veille strictement sur le type de base — il insérera automatiquement les tags à partir du schéma ASN.1 existant. Cela simplifie considérablement le code des applications.
Lorsqu'une erreur se produit pendant le décodage, il n'est pas facile de comprendre exactement où elle s'est produite dans pyasn1. Par exemple, avec le certificat turc mentionné plus haut, nous obtiendrions l'erreur suivante : UTF8String (tbsCertificate:issuer:rdnSequence:3:0:value:DEFINED BY 2.5.4.10:utf8String) (à 138) limites non satisfaites : 1 ⇐ 77 ⇐ 64. Lors de la rédaction de structures ASN.1, les gens peuvent faire des erreurs, et cela aide à déboguer plus facilement les applications ou à identifier des problèmes dans les documents encodés de l'autre partie.
Dans la première version de PyDERASN, il n'y avait pas de support pour l'encodage BER. Celui-ci est apparu beaucoup plus tard et le traitement du UTCTime/GeneralizedTime avec des fuseaux horaires n'est toujours pas pris en charge. Cela viendra à l'avenir, car le projet est principalement développé pendant le temps libre du travail.
Dans la première version, il n'y avait également pas de traitement des champs DEFINED BY. Quelques mois plus tard, cette et a commencé à être largement utilisée, réduisant considérablement le code des applications - en une seule opération de décodage, on pouvait obtenir toute la structure décortiquée en profondeur. Pour cela, dans le schéma, on définit quels champs « définissent » quoi. Par exemple, la description du schéma CMS :
class ContentInfo(Sequence):
    schema = (
        ("contentType", ContentType(defines=((("content",), {
            id_authenticatedData: AuthenticatedData(),
            id_digestedData: DigestedData(),
            id_encryptedData: EncryptedData(),
            id_envelopedData: EnvelopedData(),
            id_signedData: SignedData(),
        }),))),
        ("content", Any(expl=tag_ctxc(0))),
    )
indique que si contentType contient un OID avec la valeur id_signedData, alors le champ content (qui se trouve dans cette même SEQUENCE) doit être décodé selon le schéma SignedData. Pourquoi tant de parenthèses ? Un champ peut « définir » plusieurs champs simultanément, comme c'est le cas dans les structures EnvelopedData. Les champs définis sont identifiés par ce qu'on appelle le decode path - il indique l'emplacement exact de tout élément dans toutes les structures.
Il n'est pas toujours souhaitable ou possible d'ajouter ces defines directement dans le schéma. Il peut y avoir des cas spécifiques à une application où les OID et les structures ne sont connus que dans un projet externe. PyDERASN offre la possibilité de spécifier ces defines directement au moment du décodage de la structure :
ContentInfo().decode(data, ctx={"defines_by_path": ((
    (
        "content", DecodePathDefBy(id_signedData),
        "certificates", any, "certificate", "tbsCertificate",
        "extensions", any, "extnID",
    ),
    ((("extnValue",), {
        id_ce_authorityKeyIdentifier: AuthorityKeyIdentifier(),
        id_ce_basicConstraints: BasicConstraints(),
        [...]
        id_ru_subjectSignTool: SubjectSignTool(),
    }),),
),)})
Ici, nous disons que dans le CMS SignedData pour tous les certificats attachés, décoder toutes leurs extensions (AuthorityKeyIdentifier, BasicConstraints, SubjectSignTool, etc.). Nous spécifions via le decode path à quel élément il faut « substituer » les defines, comme s'ils avaient été définis dans le schéma.
Enfin, PyDERASN offre la possibilité de travailler depuis pour décoder des fichiers ASN.1 et dispose d'un riche . On peut décoder un ASN.1 arbitraire, ou définir un schéma précis et voir quelque chose de similaire :
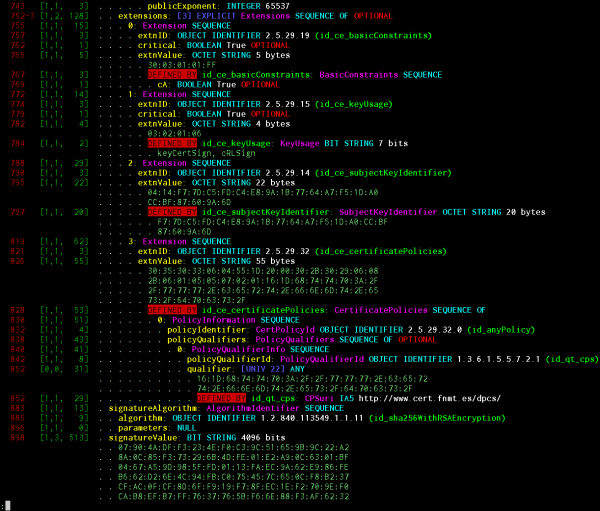
Informations affichées : décalage de l'objet, longueur de la balise, longueur de contenu, présence de l'EOC (fin des octets), indication de l'encodage BER, indication de l'encodage de longueur indéfinie, longueur et décalage de la balise EXPLICIT (le cas échéant), profondeur d'imbrication de l'objet dans les structures, valeur de la balise IMPLICIT/EXPLICIT, nom de l'objet selon le schéma, son type ASN.1 de base, numéro d'ordre dans la SEQUENCE/SET OF, valeur de CHOICE (le cas échéant), nom lisible par l'homme INTEGER/ENUMERATED/BIT STRING selon le schéma, valeur de tout type de base, indicateur DEFAULT/OPTIONAL du schéma, indication que l'objet a été automatiquement décodé comme DEFINED BY et grâce à quel OID cela a été réalisé, OID lisible par l'homme.
Le système de pretty printing est conçu pour générer une séquence d'objets PP qui sont déjà visualisés par des moyens séparés. La capture d'écran montre un rendu en texte coloré simple. Il existe également des rendus au format JSON/HTML, afin que cela puisse être vu avec syntaxe colorée dans le navigateur ASN.1 comme dans projet.
D'autres bibliothèques
Ce n'était pas l'objectif, mais PyDERASN s'est révélé sensiblement que pyasn1. Par exemple, le décodage de fichiers CRL de plusieurs mégaoctets peut prendre un temps si long qu'il faudra envisager des formats de stockage de données intermédiaires (rapides) et changer l'architecture des applications. pyasn1 décode CRL sur mon ordinateur portable en plus de 20 minutes, alors que PyDERASN le fait en 28 secondes ! Il existe un projet , axé sur un fonctionnement rapide avec des structures cryptographiques : il décode (complètement, pas paresseusement) le même CRL en 29 secondes, mais consomme presque deux fois plus de mémoire vive lors de son exécution sous Python3 (983 MiB contre 498), et 3,5 fois plus sous Python2 (1677 contre 488), tandis que pyasn1 consomme en fait 4,3 fois plus (2093 contre 488).
asn1crypto, que j'ai mentionné, n'a pas été envisagé, car le projet n'en était qu'à ses débuts, et nous n'en avions pas entendu parler. Maintenant, je ne regarderais pas non plus dans sa direction, car j'ai immédiatement découvert que le même GeneralizedTime n'accepte pas de formats arbitraires, et qu'en le sérialisant, il supprime silencieusement les fractions de seconde. C'est acceptable pour le travail avec des certificats X.509, mais en général cela ne conviendrait pas.
À ce jour, PyDERASN est le plus strict des décodeurs DER Python/Go libres dont j'ai connaissance. Dans la bibliothèque encoding/asn1 de mon Go préféré IDENTIFIANT D'OBJET et UTCTime/GeneralizedTime chaînes. Parfois, la rigueur peut nuire ( principalement à cause de la rétrocompatibilité avec les anciennes applications, qui ne seront plus mises à jour), donc dans PyDERASN, lors du décodage, il est possible de transmettre relâchant les vérifications.
Le code du projet tente d'être aussi simple que possible. Toute la bibliothèque est un seul fichier. Le code est écrit avec un accent sur la facilité de compréhension, sans optimisations de performance excessives ni code DRY. Comme je l'ai déjà dit, il n'y a pas de prise en charge complète du décodage BER des chaînes UTCTime/GeneralizedTime, ni des types de données REAL, RELATIVE OID, EXTERNAL, INSTANCE OF, EMBEDDED PDV, CHARACTER STRING. Dans tous les autres cas, personnellement, je ne vois pas l'intérêt d'utiliser d'autres bibliothèques en Python.
Comme tous mes projets, de type , , , , PyDERASN est entièrement , distribué sous les conditions de , et disponible en téléchargement gratuit. Des exemples d'utilisation sont disponibles dans et dans .
, , membre de , développeur Python/Go, expert principal .
Source : habr.com
