

Package tidyr fait partie du cœur de l'une des bibliothèques les plus populaires du langage R — tidyverse.
La principale fonction du package est de mettre les données en forme soignée.
Sur Habr, il existe déjà consacrée à ce package, mais elle date de l'année 2015. Et je veux parler des changements les plus récents, que son auteur Hadley Wickham a signalés il y a quelques jours.
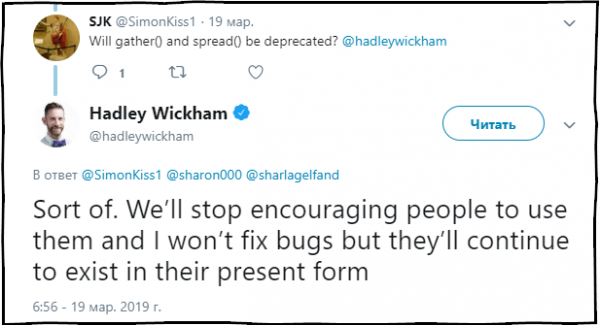
SJK: Les fonctions gather() et spread() seront-elles considérées comme obsolètes ?
Hadley Wickham: Dans une certaine mesure. Nous cesserons de recommander l'utilisation de ces fonctions et de corriger les erreurs qui y sont associées, mais elles resteront présentes dans le package dans leur état actuel.
Contenu
Si vous vous intéressez à l'analyse de données, mes et chaînes pourraient vous intéresser. La majorité du contenu est consacré au langage R.
Le concept de TidyData
L'objectif tidyr — vous aider à mettre vos données en forme dite soignée. Des données soignées, c'est des données où :
- Chaque variable se trouve dans une colonne.
- Chaque observation est une ligne.
- Chaque valeur représente une cellule.
Travailler avec des données mises au format tidy est beaucoup plus simple et pratique lors de l'analyse.
Les principales fonctions incluses dans le package tidyr
tidyr contient un ensemble de fonctions conçues pour transformer les tables :
fill()— remplit les valeurs manquantes d'une colonne avec les valeurs précédentes ;separate()— divise un champ en plusieurs à l'aide d'un séparateur ;unite()— réalise l'opération de combinaison de plusieurs champs en un, l'action inverse de la fonctionseparate();pivot_longer()— fonction qui transforme des données d'un format large à long ;pivot_wider()— fonction qui transforme des données d'un format long à large. L'opération est l'inverse de celle réalisée par la fonctionpivot_longer().gather()obsolète — fonction qui transforme des données d'un format large à long ;spread()obsolète — fonction qui transforme des données d'un format long à large. L'opération est l'inverse de celle réalisée par la fonctiongather().
Un nouveau concept de transformation des données d'un format large à long et vice versa
Auparavant, des fonctions étaient utilisées pour ce type de transformation gather() et spread(). Au fil des ans, il est devenu évident que pour la plupart des utilisateurs, y compris l'auteur du package, les noms de ces fonctions et de leurs arguments n'étaient pas suffisamment clairs, ce qui compliquait leur recherche et la compréhension de quelle fonction transforme un dataframe d'un format large en un format long, et vice versa.
C'est pourquoi tidyr deux nouvelles fonctions importantes ont été ajoutées, destinées à transformer les dataframes.
Nouvelles fonctionnalités pivot_longer() et pivot_wider() ont été conçues sous l'influence de certaines fonctions du package cdata, créé par John Mount et Nina Zumel.
Installation de la version la plus récente de tidyr 0.8.3.9000
Pour installer la version la plus récente du package tidyr 0.8.3.9000, qui contient les nouvelles fonctions, utilisez le code suivant.
devtools::install_github("tidyverse/tidyr")
Au moment de la rédaction de cet article, ces fonctions ne sont disponibles que dans la version dev du package sur GitHub.
Passage aux nouvelles fonctions
Il n'est pas difficile de traduire les anciens scripts pour les adapter aux nouvelles fonctions. Pour une meilleure compréhension, je vais prendre un exemple de la documentation des anciennes fonctions et montrer comment ces mêmes opérations s'effectuent avec les nouvelles pivot_*() fonctions.
Transformation du format large au format long.
Exemple de code extrait de la documentation de la fonction gather
# example
library(dplyr)
stocks <- data.frame(
  time = as.Date('2009-01-01') + 0:9,
  X = rnorm(10, 0, 1),
  Y = rnorm(10, 0, 2),
  Z = rnorm(10, 0, 4)
)

# old
stocks_gather <- stocks %>% gather(key   = stock,
                                   value = price,
                                   -time)

# new
stocks_long   <- stocks %>% pivot_longer(cols      = -time,
                                       names_to  = "stock",
                                       values_to = "price")
Transformation du format long au format large.
Exemple de code extrait de la documentation de la fonction spread
# old
stocks_spread <- stocks_gather %>% spread(key = stock,
                                          value = price)

# new
stock_wide    <- stocks_long %>% pivot_wider(names_from  = "stock",
                                            values_from = "price")
Étant donné que dans les exemples ci-dessus traitant de pivot_longer() et pivot_wider(), dans le tableau source stocks il n'y a pas de colonnes énumérées dans les arguments names_to et values_to leurs noms doivent être indiqués entre guillemets.
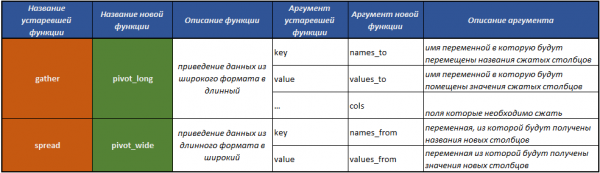
Tableau qui vous aidera le plus à comprendre comment passer à la nouvelle conception tidyr.
Note de l'auteur
Tout le texte présenté ci-dessous est une adaptation, je dirais même une traduction libre du site officiel de la bibliothèque tidyverse.
Un exemple simple de transformation des données d'un format large à un format long
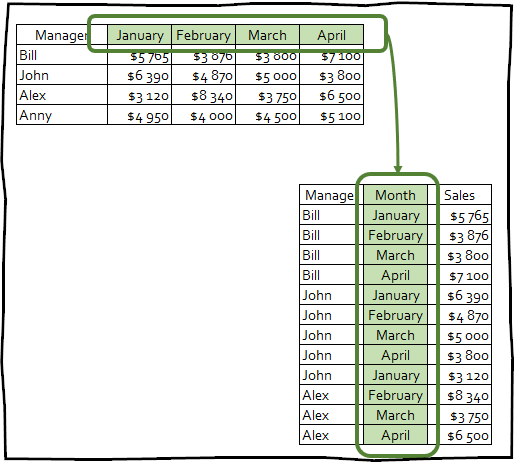
pivot_longer () rend les ensembles de données plus longs, réduisant le nombre de colonnes et augmentant le nombre de lignes.
Pour exécuter les exemples présentés dans l'article, il est d'abord nécessaire de charger les packages requis :
library(tidyr)
library(dplyr)
library(readr)
Supposons que nous ayons un tableau avec les résultats d'un sondage, dans lequel (entre autres) les gens ont été interrogés sur leur religion et leur revenu annuel :
#> # A tibble: 18 x 11
#>    religion `<$10k` `$10-20k` `$20-30k` `$30-40k` `$40-50k` `$50-75k`
#>    <chr>      <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#>  1 Agnostic      27        34        60        81        76       137
#>  2 Atheist       12        27        37        52        35        70
#>  3 Buddhist      27        21        30        34        33        58
#>  4 Catholic     418       617       732       670       638      1116
#>  5 Don’t k…      15        14        15        11        10        35
#>  6 Evangel…     575       869      1064       982       881      1486
#>  7 Hindu          1         9         7         9        11        34
#>  8 Histori…     228       244       236       238       197       223
#>  9 Jehovah…      20        27        24        24        21        30
#> 10 Jewish        19        19        25        25        30        95
#> # … with 8 more rows, and 4 more variables: `$75-100k` <dbl>,
#> #   `$100-150k` <dbl>, `>150k` <dbl>, `Don't know/refused` <dbl>
Ce tableau contient des données sur la religion des répondants dans les lignes, tandis que le niveau de revenu est dispersé au-dessus des noms des colonnes. Le nombre de répondants dans chaque catégorie est stocké dans les valeurs des cellules à l'intersection de la religion et du niveau de revenu. Pour mettre le tableau dans un format soigné et approprié, il suffit d'utiliser pivot_longer():
pew %>%
  pivot_longer(cols = -religion, names_to = "income", values_to = "count")
pew %>%
pivot_longer(cols = -religion, names_to = "income", values_to = "count")
#> # Un tibble : 180 x 3
#> religion income count
#>
#> 1 Agnostique 2 Agnostique $10-20k 34
#> 3 Agnostique $20-30k 60
#> 4 Agnostique $30-40k 81
#> 5 Agnostique $40-50k 76
#> 6 Agnostique $50-75k 137
#> 7 Agnostique $75-100k 122
#> 8 Agnostique $100-150k 109
#> 9 Agnostique >150k 84
#> 10 Agnostique Je ne sais pas/refusé 96
#> # … avec 170 autres lignesArguments de la fonction pivot_longer()
- Premier argument cols, décrit quelles colonnes doivent être combinées. Dans ce cas, toutes les colonnes sauf time.
- Argument names_to donne le nom de la variable qui sera créée à partir des noms des colonnes que nous avons combinées.
- values_to donne le nom de la variable qui sera créée à partir des données stockées dans les valeurs des cellules des colonnes combinées.
Spécifications
C'est une nouvelle fonctionnalité du package tidyr, qui était auparavant inaccessible lors de l'utilisation de fonctions obsolètes.
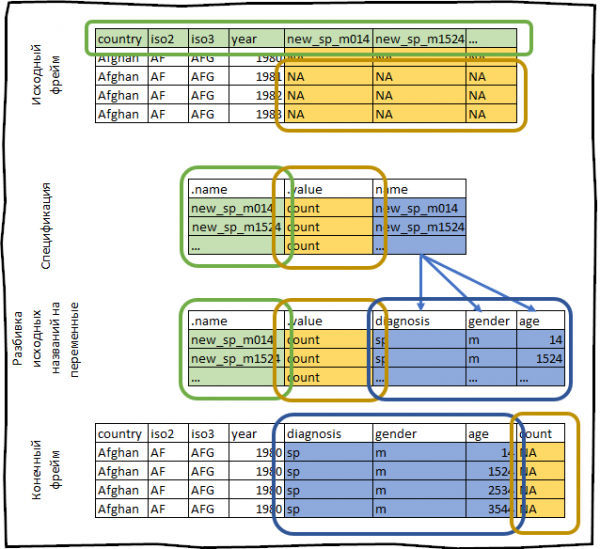
La spécification est un cadre de données, chaque ligne correspondant à une colonne dans le nouveau cadre de données de sortie, et deux colonnes spéciales qui commencent par :
- .name contient le nom d'origine de la colonne.
- .value contient le nom de la colonne dans laquelle les valeurs des cellules entreront.
Les autres colonnes de la spécification reflètent comment le nom des colonnes compressées sera affiché dans la nouvelle colonne de .name.
La spécification décrit les métadonnées stockées dans le nom de la colonne, avec une ligne pour chaque colonne et une colonne pour chaque variable, combinée avec le nom de la colonne, peut-être que cette définition semble confuse maintenant, mais après avoir regardé quelques exemples, tout deviendra beaucoup plus clair.
Le sens de la spécification est que vous pouvez extraire, modifier et définir de nouvelles métadonnées pour le cadre de données transformé.
Pour travailler avec les spécifications lors de la transformation d'un tableau d'un format large vers un format long, utilisez la fonction pivot_longer_spec().
Comment cette fonction fonctionne, elle prend n'importe quel cadre de données et forme ses métadonnées de la manière décrite ci-dessus.
Prenons par exemple le jeu de données who, fourni avec le package. tidyrCe jeu de données contient des informations fournies par l'organisation mondiale de la santé sur l'incidence de la tuberculose.
who
#> # A tibble: 7,240 x 60
#>    country iso2  iso3   year new_sp_m014 new_sp_m1524 new_sp_m2534
#>        <chr> <int>       <int>        <int>        <int>
#>  1 Afghan… AF    AFG    1980          NA           NA           NA
#>  2 Afghan… AF    AFG    1981          NA           NA           NA
#>  3 Afghan… AF    AFG    1982          NA           NA           NA
#>  4 Afghan… AF    AFG    1983          NA           NA           NA
#>  5 Afghan… AF    AFG    1984          NA           NA           NA
#>  6 Afghan… AF    AFG    1985          NA           NA           NA
#>  7 Afghan… AF    AFG    1986          NA           NA           NA
#>  8 Afghan… AF    AFG    1987          NA           NA           NA
#>  9 Afghan… AF    AFG    1988          NA           NA           NA
#> 10 Afghan… AF    AFG    1989          NA           NA           NA
#> # … avec 7,230 autres lignes et 53 autres variables
Construisons sa spécification.
spec <- who %>%
  pivot_longer_spec(new_sp_m014:newrel_f65, values_to = "count")
#> # A tibble: 56 x 3
#> .name .value name
#> <chr> <chr> <chr>
#> 1 new_sp_m014 count new_sp_m014
#> 2 new_sp_m1524 count new_sp_m1524
#> 3 new_sp_m2534 count new_sp_m2534
#> 4 new_sp_m3544 count new_sp_m3544
#> 5 new_sp_m4554 count new_sp_m4554
#> 6 new_sp_m5564 count new_sp_m5564
#> 7 new_sp_m65 count new_sp_m65
#> 8 new_sp_f014 count new_sp_f014
#> 9 new_sp_f1524 count new_sp_f1524
#> 10 new_sp_f2534 count new_sp_f2534
#> # … with 46 more rowsChamps pays, iso2, iso3 sont déjà des variables. Notre tâche est de retourner les colonnes avec new_sp_m014 pour newrel_f65.
Les noms de ces colonnes contiennent les informations suivantes :
- Préfixe
new_indique que la colonne contient des données sur de nouveaux cas de tuberculose, le dataframe actuel contient des informations uniquement sur de nouvelles maladies, donc ce préfixe n'a pas de signification dans ce contexte. sp/rel/sp/epdécrit le mode de diagnostic de la maladie.m/fgenre du patient.014/1524/2535/3544/4554/65tranche d'âge du patient.
Nous pouvons séparer ces colonnes à l'aide de la fonction extract(), en utilisant des expressions régulières.
spec <- spec %>%
        extract(name, c("diagnosis", "gender", "age"), "new_?(.*)_(.)(.*)")
#> # A tibble: 56 x 5
#> .name .value diagnosis gender age
#> <chr> <chr> <chr> <chr> <chr>
#> 1 new_sp_m014 count sp m 014
#> 2 new_sp_m1524 count sp m 1524
#> 3 new_sp_m2534 count sp m 2534
#> 4 new_sp_m3544 count sp m 3544
#> 5 new_sp_m4554 count sp m 4554
#> 6 new_sp_m5564 count sp m 5564
#> 7 new_sp_m65 count sp m 65
#> 8 new_sp_f014 count sp f 014
#> 9 new_sp_f1524 count sp f 1524
#> 10 new_sp_f2534 count sp f 2534
#> # … with 46 more rowsNotez que la colonne .name doit rester inchangée, car c'est notre index dans les noms de colonnes du jeu de données d'origine.
Le genre et l'âge (colonnes gender et age) ont des valeurs fixes et connues, il est donc recommandé de convertir ces colonnes en facteurs :
spec <-  spec %>%
            mutate(
              gender = factor(gender, levels = c("f", "m")),
              age = factor(age, levels = unique(age), ordered = TRUE)
            )
Enfin, afin d'appliquer la spécification que nous avons créée au dataframe d'origine who nous devons utiliser l’argument spec dans la fonction pivot_longer().
who %>% pivot_longer(spec = spec)
#> # A tibble: 405,440 x 8
#>    country     iso2  iso3   year diagnosis gender age   count
#>    <chr>       <chr> <chr> <int> <chr>     <fct>  <ord> <int>
#>  1 Afghanistan AF    AFG    1980 sp        m      014      NA
#>  2 Afghanistan AF    AFG    1980 sp        m      1524     NA
#>  3 Afghanistan AF    AFG    1980 sp        m      2534     NA
#>  4 Afghanistan AF    AFG    1980 sp        m      3544     NA
#>  5 Afghanistan AF    AFG    1980 sp        m      4554     NA
#>  6 Afghanistan AF    AFG    1980 sp        m      5564     NA
#>  7 Afghanistan AF    AFG    1980 sp        m      65       NA
#>  8 Afghanistan AF    AFG    1980 sp        f      014      NA
#>  9 Afghanistan AF    AFG    1980 sp        f      1524     NA
#> 10 Afghanistan AF    AFG    1980 sp        f      2534     NA
#> # … with 405,430 more rows
Tout ce que nous venons de faire peut être schématiquement représenté comme suit :
Spécification utilisant plusieurs valeurs (.value)
Dans l'exemple ci-dessus, la colonne de spécification .value ne contenait qu'une seule valeur, c'est le cas dans la plupart des cas.
Mais il peut parfois y avoir des situations où vous devez rassembler des données de colonnes avec différents types de données. Avec la fonction obsolète, spread() cela serait assez compliqué à faire.
L'exemple ci-dessous est tiré de du package data.table.
Créons un tableau de données d'entraînement.
family <- tibble::tribble(
  ~family,  ~dob_child1,  ~dob_child2, ~gender_child1, ~gender_child2,
       1L, "1998-11-26", "2000-01-29",             1L,             2L,
       2L, "1996-06-22",           NA,             2L,             NA,
       3L, "2002-07-11", "2004-04-05",             2L,             2L,
       4L, "2004-10-10", "2009-08-27",             1L,             1L,
       5L, "2000-12-05", "2005-02-28",             2L,             1L,
)
family % mutate_at(vars(starts_with("dob")), parse_date)
#> # A tibble: 5 x 5
#> family dob_child1 dob_child2 gender_child1 gender_child2
#> <int> <date> <date> <int> <int>
#> 1 1 1998-11-26 2000-01-29 1 2
#> 2 2 1996-06-22 NA 2 NA
#> 3 3 2002-07-11 2004-04-05 2 2
#> 4 4 2004-10-10 2009-08-27 1 1
#> 5 5 2000-12-05 2005-02-28 2 1Le tableau de données créé contient des données sur les enfants d'une même famille pour chaque ligne. Les familles peuvent avoir un ou deux enfants. Pour chaque enfant, des informations sur la date de naissance et le sexe sont fournies, avec les données de chaque enfant dans des colonnes distinctes. Notre tâche est de formater ces données correctement pour l'analyse.
Notez que nous avons deux variables contenant des informations sur chaque enfant : son sexe et sa date de naissance (colonnes avec le préfixe dob contiennent la date de naissance, les colonnes avec le préfixe gender contiennent le sexe de l'enfant). Dans le résultat attendu, elles doivent se trouver dans des colonnes séparées. Nous pouvons le faire en générant une spécification dans laquelle la colonne .value aura deux valeurs différentes.
spec %
  pivot_longer_spec(-family) %>%
  separate(col = name, into = c(".value", "child"))%>%
  mutate(child = parse_number(child))
#> # A tibble: 4 x 3
#>   .name         .value child
#>   <chr>         <chr>  <dbl>
#> 1 dob_child1    dob        1
#> 2 dob_child2    dob        2
#> 3 gender_child1 gender     1
#> 4 gender_child2 gender     2
Alors, examinons étape par étape les actions effectuées par le code ci-dessus.
pivot_longer_spec(-family)— nous créons une spécification qui condense toutes les colonnes disponibles, à l'exception de la colonne family.separate(col = name, into = c(".value", "child"))— nous séparons la colonne .name, qui contient les noms des champs d'origine, par un trait de soulignement et nous plaçons les valeurs obtenues dans les colonnes .value et enfant.mutate(child = parse_number(child))— nous convertissons les valeurs du champ enfant du type texte en type numérique.
Nous pouvons maintenant appliquer la spécification obtenue à notre tableau de données d'origine et amener la table à l'apparence souhaitée.
family %>%
    pivot_longer(spec = spec, na.rm = T)
#> # A tibble: 9 x 4
#> family child dob gender
#> <int> <dbl> <date> <int>
#> 1 1 1 1998-11-26 1
#> 2 1 2 2000-01-29 2
#> 3 2 1 1996-06-22 2
#> 4 3 1 2002-07-11 2
#> 5 3 2 2004-04-05 2
#> 6 4 1 2004-10-10 1
#> 7 4 2 2009-08-27 1
#> 8 5 1 2000-12-05 2
#> 9 5 2 2005-02-28 1Nous utilisons l'argument na.rm = TRUE, car la forme actuelle des données oblige à créer des lignes supplémentaires pour les observations inexistantes. Étant donné que la famille 2 n'a qu'un seul enfant, na.rm = TRUE garantit que la famille 2 aura une ligne dans les données de sortie.
Transformation des data frames d'un format long à large
pivot_wider() — est une transformation inverse, qui augmente en revanche le nombre de colonnes du cadre de données tout en diminuant le nombre de lignes.
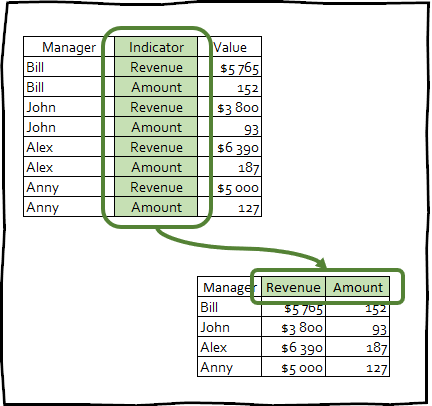
Ce type de transformation est extrêmement rare pour mettre les données en forme soignée, cependant cette technique peut être utile pour créer des tableaux croisés utilisés dans des présentations, ou pour l'intégration avec d'autres outils.
En fait, les fonctions pivot_longer() et pivot_wider() sont symétriques, et produisent des actions réciproques, c'est-à-dire : df %>% pivot_longer(spec = spec) %>% pivot_wider(spec = spec) et df %>% pivot_wider(spec = spec) %>% pivot_longer(spec = spec) retournera le df d'origine.
Un exemple basique de mise en forme d'une table au format large
Pour démontrer le fonctionnement de la fonction pivot_wider() nous utiliserons le jeu de données fish_encounters, qui contient des informations sur la façon dont différentes stations enregistrent le déplacement des poissons dans la rivière.
#> # A tibble: 114 x 3
#>    fish  station  seen
#>    <fct> <fct>   <int>
#>  1 4842  Release     1
#>  2 4842  I80_1       1
#>  3 4842  Lisbon      1
#>  4 4842  Rstr        1
#>  5 4842  Base_TD     1
#>  6 4842  BCE         1
#>  7 4842  BCW         1
#>  8 4842  BCE2        1
#>  9 4842  BCW2        1
#> 10 4842  MAE         1
#> # … with 104 more rows
Dans la plupart des cas, ce tableau sera plus informatif et pratique à utiliser si les informations de chaque station sont présentées dans une colonne distincte.
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
#> # A tibble: 19 x 12
#>    fish  Release I80_1 Lisbon  Rstr Base_TD   BCE   BCW  BCE2  BCW2   MAE
#>        &  & &   & & & & & &
#>  1 4842        1     1      1     1       1     1     1     1     1     1
#>  2 4843        1     1      1     1       1     1     1     1     1     1
#>  3 4844        1     1      1     1       1     1     1     1     1     1
#>  4 4845        1     1      1     1       1    NA    NA    NA    NA    NA
#>  5 4847        1     1      1    NA      NA    NA    NA    NA    NA    NA
#>  6 4848        1     1      1     1      NA    NA    NA    NA    NA    NA
#>  7 4849        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  8 4850        1     1     NA     1       1     1     1    NA    NA    NA
#>  9 4851        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> 10 4854        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  # … avec 9 autres lignes, et 1 autre variable : MAW
Ce jeu de données enregistre des informations uniquement lorsque le poisson a été détecté par la station, c'est-à-dire si un poisson n'a pas été enregistré par une station, ces données ne seront pas présentes dans le tableau. Cela signifie que les données de sortie seront remplies de NA.
Cependant, dans ce cas, nous savons que l'absence d'enregistrement signifie que le poisson n'a pas été observé, donc nous pouvons utiliser l'argument values_fill dans la fonction pivot_wider() et remplir ces valeurs manquantes avec des zéros :
fish_encounters %>% pivot_wider(
  names_from = station,
  values_from = seen,
  values_fill = list(seen = 0)
)
#> # A tibble: 19 x 12
#> fish Release I80_1 Lisbon Rstr Base_TD BCE BCW BCE2 BCW2 MAE
#> <fct> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
#> 1 4842 1 1 1 1 1 1 1 1 1 1
#> 2 4843 1 1 1 1 1 1 1 1 1 1
#> 3 4844 1 1 1 1 1 1 1 1 1 1
#> 4 4845 1 1 1 1 1 0 0 0 0 0
#> 5 4847 1 1 1 0 0 0 0 0 0 0
#> 6 4848 1 1 1 1 0 0 0 0 0 0
#> 7 4849 1 1 0 0 0 0 0 0 0 0
#> 8 4850 1 1 0 1 1 1 1 0 0 0
#> 9 4851 1 1 0 0 0 0 0 0 0 0
#> 10 4854 1 1 0 0 0 0 0 0 0 0
#> # … with 9 more rows, and 1 more variable: MAW <int>Génération du nom de colonne à partir de plusieurs variables d'origine
Imaginez que nous avons un tableau contenant une combinaison de produit, pays et année. Pour générer un cadre de données de test, vous pouvez exécuter le code suivant :
df %
  filter((product == "A" & country == "AI") | product == "B") %>%
  mutate(value = rnorm(nrow(.)))
#> # A tibble: 45 x 4
#> product country year value
#> <chr> <chr> <int> <dbl>
#> 1 A AI 2000 -2.05
#> 2 A AI 2001 -0.676
#> 3 A AI 2002 1.60
#> 4 A AI 2003 -0.353
#> 5 A AI 2004 -0.00530
#> 6 A AI 2005 0.442
#> 7 A AI 2006 -0.610
#> 8 A AI 2007 -2.77
#> 9 A AI 2008 0.899
#> 10 A AI 2009 -0.106
#> # … with 35 more rowsNotre tâche est d'élargir le cadre de données de manière à ce qu'une colonne contienne des données pour chaque combinaison de produit et de pays. Pour cela, il suffit de passer dans l'argument names_from un vecteur contenant les noms des champs à combiner.
df %>% pivot_wider(names_from = c(product, country),
                 values_from = "value")
#> # A tibble: 15 x 4
#> year A_AI B_AI B_EI
#> <int> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 0.607 1.20
#> 2 2001 -0.676 1.65 -0.114
#> 3 2002 1.60 -0.0245 0.501
#> 4 2003 -0.353 1.30 -0.459
#> 5 2004 -0.00530 0.921 -0.0589
#> 6 2005 0.442 -1.55 0.594
#> 7 2006 -0.610 0.380 -1.28
#> 8 2007 -2.77 0.830 0.637
#> 9 2008 0.899 0.0175 -1.30
#> 10 2009 -0.106 -0.195 1.03
#> # … with 5 more rowsVous pouvez également appliquer des spécifications à la fonction pivot_wider(). Mais lorsqu'il est fourni dans pivot_wider() la spécification effectue une transformation opposée pivot_longer(): des colonnes sont créées, comme indiqué dans .name, en utilisant des valeurs de .value et d'autres colonnes.
Pour cet ensemble de données, vous pouvez générer une spécification personnalisée si vous souhaitez que chaque combinaison possible de pays et de produit ait sa propre colonne, et non seulement celles présentes dans les données :
spec %
  expand(product, country, .value = "value") %>%
  unite(".name", product, country, remove = FALSE)
#> # A tibble: 4 x 4
#> .name product country .value
#> <chr> <chr> <chr> <chr>
#> 1 A_AI A AI value
#> 2 A_EI A EI value
#> 3 B_AI B AI value
#> 4 B_EI B EI valuedf %>% pivot_wider(spec = spec) %>% head()#> # A tibble: 6 x 5
#> year A_AI A_EI B_AI B_EI
#> <int> <dbl> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 NA 0.607 1.20
#> 2 2001 -0.676 NA 1.65 -0.114
#> 3 2002 1.60 NA -0.0245 0.501
#> 4 2003 -0.353 NA 1.30 -0.459
#> 5 2004 -0.00530 NA 0.921 -0.0589
#> 6 2005 0.442 NA -1.55 0.594Quelques exemples avancés de travail avec le nouveau concept de tidyr
Mettre les données en forme soignée à l'aide d'un ensemble de données sur les revenus et les loyers aux États-Unis
Jeu de données us_rent_income contient des informations sur le revenu moyen et le loyer pour chaque État des États-Unis pour l'année 2017 (l'ensemble de données est disponible dans le package tidycensus).
us_rent_income
#> # A tibble: 104 x 5
#>    GEOID NAME       variable estimate   moe
#>
#>  1 01    Alabama    income      24476   136
#>  2 01    Alabama    rent          747     3
#>  3 02    Alaska     income      32940   508
#>  4 02    Alaska     rent         1200    13
#>  5 04    Arizona    income      27517   148
#>  6 04    Arizona    rent          972     4
#>  7 05    Arkansas   income      23789   165
#>  8 05    Arkansas   rent          709     5
#>  9 06    Californie income      29454   109
#> 10 06    Californie rent         1358     3
#> # … avec 94 lignes supplémentaires
Dans la forme dans laquelle les données sont conservées dans l'ensemble de données us_rent_income il est très compliqué de travailler avec, donc nous aimerions créer un ensemble de données avec les colonnes : rent, rent_moe, come, income_moe. Il existe de nombreuses façons de créer cette spécification, mais l'essentiel est que nous devons générer chaque combinaison de valeurs de la variable et estimate/moe, puis générer le nom de la colonne.
  spec %
    expand(variable, .value = c("estimate", "moe")) %>%
    mutate(
      .name = paste0(variable, ifelse(.value == "moe", "_moe", ""))
    )
#> # A tibble: 4 x 3
#> variable .value .name
#> <chr> <chr> <chr>
#> 1 income estimate income
#> 2 income moe income_moe
#> 3 rent estimate rent
#> 4 rent moe rent_moeLa fourniture de cette spécification pivot_wider() nous donne le résultat que nous recherchons :
us_rent_income %>% pivot_wider(spec = spec)
#> # A tibble: 52 x 6
#>    GEOID NAME                 income income_moe  rent rent_moe
#>    <chr> <chr>                 <dbl>      <dbl> <dbl>    <dbl>
#>  1 01    Alabama               24476        136   747        3
#>  2 02    Alaska                32940        508  1200       13
#>  3 04    Arizona               27517        148   972        4
#>  4 05    Arkansas              23789        165   709        5
#>  5 06    California            29454        109  1358        3
#>  6 08    Colorado              32401        109  1125        5
#>  7 09    Connecticut           35326        195  1123        5
#>  8 10    Delaware              31560        247  1076       10
#>  9 11    District of Columbia  43198        681  1424       17
#> 10 12    Florida               25952         70  1077        3
#> # … with 42 more rows
Banque mondiale
Parfois, mettre un ensemble de données sous la forme souhaitée nécessite plusieurs étapes.
Jeu de données world_bank_pop contient des données de la Banque mondiale sur la population de chaque pays entre 2000 et 2018.
#> # A tibble: 1,056 x 20
#>    country indicator `2000` `2001` `2002` `2003`  `2004`  `2005`   `2006`
#>    <chr>   <chr>      <dbl>  <dbl>  <dbl>  <dbl>   <dbl>   <dbl>    <dbl>
#>  1 ABW     SP.URB.T… 4.24e4 4.30e4 4.37e4 4.42e4 4.47e+4 4.49e+4  4.49e+4
#>  2 ABW     SP.URB.G… 1.18e0 1.41e0 1.43e0 1.31e0 9.51e-1 4.91e-1 -1.78e-2
#>  3 ABW     SP.POP.T… 9.09e4 9.29e4 9.50e4 9.70e4 9.87e+4 1.00e+5  1.01e+5
#>  4 ABW     SP.POP.G… 2.06e0 2.23e0 2.23e0 2.11e0 1.76e+0 1.30e+0  7.98e-1
#>  5 AFG     SP.URB.T… 4.44e6 4.65e6 4.89e6 5.16e6 5.43e+6 5.69e+6  5.93e+6
#>  6 AFG     SP.URB.G… 3.91e0 4.66e0 5.13e0 5.23e0 5.12e+0 4.77e+0  4.12e+0
#>  7 AFG     SP.POP.T… 2.01e7 2.10e7 2.20e7 2.31e7 2.41e+7 2.51e+7  2.59e+7
#>  8 AFG     SP.POP.G… 3.49e0 4.25e0 4.72e0 4.82e0 4.47e+0 3.87e+0  3.23e+0
#>  9 AGO     SP.URB.T… 8.23e6 8.71e6 9.22e6 9.77e6 1.03e+7 1.09e+7  1.15e+7
#> 10 AGO     SP.URB.G… 5.44e0 5.59e0 5.70e0 5.76e0 5.75e+0 5.69e+0  4.92e+0
#> # … with 1,046 more rows, and 11 more variables: `2007` <dbl>,
#> #   `2008` <dbl>, `2009` <dbl>, `2010` <dbl>, `2011` <dbl>, `2012` <dbl>,
#> #   `2013` <dbl>, `2014` <dbl>, `2015` <dbl>, `2016` <dbl>, `2017` <dbl>
Notre objectif est de créer un ensemble de données soigné, où chaque variable se trouve dans une colonne distincte. Il n'est pas encore clair quelles étapes exactes sont nécessaires, mais nous commencerons par le problème le plus évident : l'année est répartie sur plusieurs colonnes.
Pour corriger cela, il est nécessaire d'utiliser la fonction pivot_longer().
pop2 %
  pivot_longer(`2000`:`2017`, names_to = "year")
#> # A tibble: 19,008 x 4
#> country indicator year value
#> <chr> <chr> <chr> <dbl>
#> 1 ABW SP.URB.TOTL 2000 42444
#> 2 ABW SP.URB.TOTL 2001 43048
#> 3 ABW SP.URB.TOTL 2002 43670
#> 4 ABW SP.URB.TOTL 2003 44246
#> 5 ABW SP.URB.TOTL 2004 44669
#> 6 ABW SP.URB.TOTL 2005 44889
#> 7 ABW SP.URB.TOTL 2006 44881
#> 8 ABW SP.URB.TOTL 2007 44686
#> 9 ABW SP.URB.TOTL 2008 44375
#> 10 ABW SP.URB.TOTL 2009 44052
#> # … with 18,998 more rowsLa prochaine étape est d'examiner la variable indicator.
pop2 %>% count(indicator)
#> # A tibble: 4 x 2
#>   indicator       n
#>   <chr>       <int>
#> 1 SP.POP.GROW  4752
#> 2 SP.POP.TOTL  4752
#> 3 SP.URB.GROW  4752
#> 4 SP.URB.TOTL  4752
Où SP.POP.GROW représente la croissance de la population, SP.POP.TOTL est la population totale, et SP.URB. * est pareil, mais uniquement pour les zones urbaines. Divisons ces valeurs en deux variables : area — zone (total ou urbain) et une variable contenant les données réelles (population ou croissance) :
pop3 %
  separate(indicator, c(NA, "area", "variable"))
#> # A tibble: 19,008 x 5
#> country area variable year value
#> <chr> <chr> <chr> <chr> <dbl>
#> 1 ABW URB TOTL 2000 42444
#> 2 ABW URB TOTL 2001 43048
#> 3 ABW URB TOTL 2002 43670
#> 4 ABW URB TOTL 2003 44246
#> 5 ABW URB TOTL 2004 44669
#> 6 ABW URB TOTL 2005 44889
#> 7 ABW URB TOTL 2006 44881
#> 8 ABW URB TOTL 2007 44686
#> 9 ABW URB TOTL 2008 44375
#> 10 ABW URB TOTL 2009 44052
#> # … with 18,998 more rowsIl nous reste maintenant à diviser la variable variable en deux colonnes :
pop3 %>%
  pivot_wider(names_from = variable, values_from = value)
#> # A tibble: 9,504 x 5
#> country area year TOTL GROW
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 ABW URB 2000 42444 1.18
#> 2 ABW URB 2001 43048 1.41
#> 3 ABW URB 2002 43670 1.43
#> 4 ABW URB 2003 44246 1.31
#> 5 ABW URB 2004 44669 0.951
#> 6 ABW URB 2005 44889 0.491
#> 7 ABW URB 2006 44881 -0.0178
#> 8 ABW URB 2007 44686 -0.435
#> 9 ABW URB 2008 44375 -0.698
#> 10 ABW URB 2009 44052 -0.731
#> # … with 9,494 more rowsListe des contacts
Pour le dernier exemple, imaginez que vous avez une liste de contacts que vous avez copiée depuis un site web :
contacts <- tribble(
  ~field, ~value,
  "name", "Jiena McLellan",
  "company", "Toyota",
  "name", "John Smith",
  "company", "google",
  "email", "john@google.com",
  "name", "Huxley Ratcliffe"
)
Mettre cette liste sous forme de tableau est assez compliqué, car il n'y a pas de variable identifiant à quel contact chaque donnée appartient. Nous pouvons corriger cela en remarquant que les données pour chaque nouveau contact commencent par le nom ("name"), donc nous pouvons créer un identifiant unique et l'incrémenter à chaque fois que la valeur “name” apparaît dans la colonne field :
contacts %
  mutate(
    person_id = cumsum(field == "name")
  )
contacts
#> # A tibble: 6 x 3
#> field value person_id
#> <chr> <chr> <int>
#> 1 name Jiena McLellan 1
#> 2 company Toyota 1
#> 3 name John Smith 2
#> 4 company google 2
#> 5 email john@google.com 2
#> 6 name Huxley Ratcliffe 3Maintenant que nous avons un identifiant unique pour chaque contact, nous pouvons pivoter le champ et la valeur en colonnes :
contacts %>%
  pivot_wider(names_from = field, values_from = value)
#> # A tibble: 3 x 4
#> person_id name company email
#> <int> <chr> <chr> <chr>
#> 1 1 Jiena McLellan Toyota <NA>
#> 2 2 John Smith google john@google.com
#> 3 3 Huxley Ratcliffe <NA> <NA>Conclusion
Personnellement, je pense que le nouveau concept tidyr est vraiment intuitivement plus évident et surpasse de loin les fonctions obsolètes. spread() et gather(). J'espère que cet article vous a aidé à comprendre pivot_longer() et pivot_wider().
Source : habr.com
