

La traduction de l'article a été préparée en prévision du lancement du cours
L'apprentissage distribué sur plusieurs instances de calcul haute performance peut réduire le temps d'entraînement des réseaux de neurones profonds modernes sur un grand volume de données de plusieurs semaines à quelques heures, voire minutes, faisant de cette technique d'apprentissage un standard pour l'utilisation pratique de l'apprentissage profond. Les utilisateurs doivent comprendre comment partager et synchroniser les données sur plusieurs instances, ce qui a un impact significatif sur l'efficacité de l'échelle. De plus, les utilisateurs doivent également savoir comment déployer un script d'entraînement sur plusieurs instances qui fonctionne sur une seule instance.
Dans cet article, nous allons discuter d'un moyen rapide et simple d'apprentissage distribué en utilisant la bibliothèque open source d'apprentissage profond Apache MXNet et le framework d'apprentissage distribué Horovod. Nous allons illustrer les avantages du framework Horovod en matière de performance et montrer comment rédiger un script d'entraînement MXNet pour qu'il fonctionne en mode distribué avec Horovod.
Qu'est-ce qu'Apache MXNet
est un framework open source pour l'apprentissage profond, utilisé pour créer, entraîner et déployer des réseaux de neurones profonds. MXNet abstrait les complexités liées à l'implémentation de réseaux de neurones, offrant une haute performance et une évolutivité, ainsi qu'une API pour les langages de programmation populaires tels que , , , , , , et d'autres.
Apprentissage distribué dans MXNet avec un serveur de paramètres
utilise une approche de serveur de paramètres. Il utilise un ensemble de serveurs de paramètres pour recueillir les gradients de chaque worker, effectuer l'agrégation et renvoyer les gradients mis à jour aux workers pour la prochaine itération d'optimisation. Déterminer le bon ratio de serveurs par rapport aux workers est la clé d'un scale efficace. S'il n'y a qu'un seul serveur de paramètres, il peut devenir un goulet d'étranglement dans le calcul. À l'inverse, si trop de serveurs sont utilisés, la connexion « plusieurs-à-plusieurs » peut saturer toutes les connexions réseau.
Qu'est-ce que Horovod
– un framework ouvert d'apprentissage profond distribué, développé par Uber. Il utilise des technologies efficaces pour l'interaction entre plusieurs GPU et nœuds, telles que la NVIDIA Collective Communications Library (NCCL) et le Message Passing Interface (MPI) pour distribuer et agréger les paramètres du modèle entre les workers. Il optimise l'utilisation de la bande passante réseau et se redimensionne bien lors du travail avec des modèles de réseaux de neurones profonds. Actuellement, il prend en charge plusieurs frameworks d'apprentissage automatique populaires, à savoir , Tensorflow, Keras et PyTorch.
Intégration de MXNet et Horovod
MXNet s'intègre avec Horovod via l'API d'apprentissage distribué définie dans Horovod. Dans Horovod, les API de communication horovod.broadcast(), horovod.allgather() et horovod.allreduce() sont mises en œuvre à l'aide de rappels asynchrones du moteur MXNet, dans le cadre de son graphe de tâches. Ainsi, les dépendances des données entre la communication et les calculs sont facilement gérées par le moteur MXNet pour éviter les pertes de performance dues à la synchronisation. L'objet optimiseur distribué, défini dans Horovod horovod.DistributedOptimizer élargit Optimiseur dans MXNet de manière à ce qu'il appelle les API Horovod appropriées pour la mise à jour distribuée des paramètres. Tous ces détails d'implémentation sont transparents pour les utilisateurs finaux.
Démarrage rapide
Vous pouvez rapidement commencer à entraîner un petit réseau de neurones convolutif sur le jeu de données MNIST avec MXNet et Horovod sur votre MacBook.
Pour commencer, installez mxnet et horovod depuis PyPI :
pip install mxnet
pip install horovod
Remarque : Si vous rencontrez une erreur lors de pip install horovod, vous devez peut-être ajouter la variable MACOSX_DEPLOYMENT_TARGET=10.vv, où vv – est la version de votre version MacOS, par exemple, pour MacOSX Sierra, vous devrez écrire MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
Ensuite, installez OpenMPI .
Enfin, téléchargez le script de test mxnet_mnist.py et exécutez les commandes suivantes dans le terminal du MacBook dans le répertoire de travail :
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pyAinsi, vous exécuterez l'entraînement sur deux cœurs de votre processeur. En sortie, vous obtiendrez ce qui suit :
INFO:root:Epoch[0] Batch [0-50] Speed: 2248.71 samples/sec      accuracy=0.583640
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.89 samples/sec      accuracy=0.882812
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.39 samples/sec      accuracy=0.870000
Démonstration des performances
Lors de l'entraînement du modèle ResNet50-v1 sur le jeu de données ImageNet sur 64 GPU avec huit instances p3.16xlarge EC2, chacun contenant 8 GPU NVIDIA Tesla V100 sur le cloud AWS, nous avons atteint un débit d'apprentissage de 45 000 images/seconde (c'est-à-dire le nombre d'exemples appris par seconde). L'entraînement s'est terminé en 44 minutes après 90 époques avec une précision maximale de 75,7%.
Nous avons comparé cela à l'apprentissage distribué MXNet avec une approche utilisant des serveurs de paramètres sur 8, 16, 32 et 64 GPU avec un serveur à un seul paramètre et un rapport serveurs/travailleurs de 1 à 1 et 2 à 1 respectivement. Le résultat est visible sur la Figure 1 ci-dessous. Sur l'axe y à gauche, les colonnes reflètent le nombre d'images pour l'apprentissage par seconde, et les lignes reflètent l'efficacité de mise à l'échelle (c'est-à-dire le rapport entre le débit réel et idéal) sur l'axe y à droite. Comme vous pouvez le constater, le choix du nombre de serveurs influence l'efficacité de mise à l'échelle. Si le serveur de paramètres est unique, l'efficacité de mise à l'échelle chute à 38% sur 64 GPU. Pour atteindre la même efficacité de mise à l'échelle qu'avec Horovod, il faut doubler le nombre de serveurs par rapport au nombre de travailleurs.
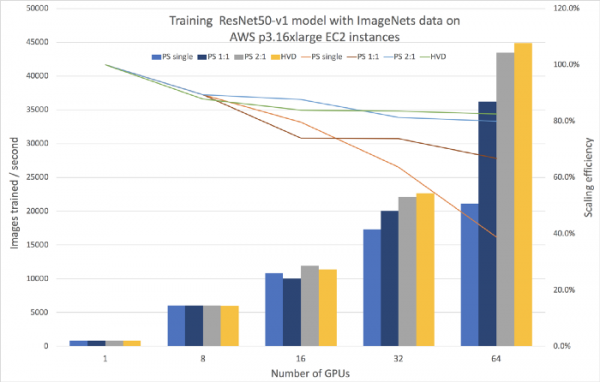
Figure 1. Comparaison de l'apprentissage distribué utilisant MXNet avec Horovod et avec un serveur de paramètres.
Dans le Tableau 1 ci-dessous, nous avons comparé le coût total par instance lors des expériences sur 64 GPU. L'utilisation de MXNet avec Horovod offre le meilleur débit au coût le plus bas.
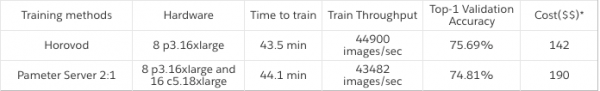
Tableau 1. Comparaison des coûts entre Horovod et un serveur de paramètres avec un rapport serveurs/travailleurs de 2 à 1.
Étapes pour reproduire
Dans les étapes suivantes, nous allons expliquer comment reproduire le résultat de l'apprentissage distribué avec MXNet et Horovod. Pour en savoir plus sur l'apprentissage distribué avec MXNet, lisez .
Étape 1
Créez un cluster d'instances homogènes avec MXNet version 1.4.0 ou supérieure et Horovod version 0.16.0 ou supérieure pour utiliser l'apprentissage distribué. Vous devrez également installer les bibliothèques nécessaires pour l'apprentissage sur GPU. Pour nos instances, nous avons choisi Ubuntu 16.04 Linux, avec le pilote GPU 396.44, CUDA 9.2, la bibliothèque cuDNN 7.2.1, le communicateur NCCL 2.2.13 et OpenMPI 3.1.1. Vous pouvez également utiliser , où ces bibliothèques sont déjà préinstallées.
Étape 2
Ajoutez la possibilité de travailler avec l'API Horovod dans votre script d'entraînement MXNet. Le script ci-dessous, basé sur MXNet Gluon API, peut être utilisé comme un modèle simple. Les lignes en gras sont nécessaires si vous avez déjà un script d'entraînement correspondant. Voici quelques changements critiques à apporter pour l'entraînement avec Horovod :
- Définissez le contexte en fonction du rang local de Horovod (ligne 8), afin de comprendre que l'entraînement se fait sur le bon cœur graphique.
- Transmettez les paramètres initiaux d'un worker à tous (ligne 18) pour vous assurer que tous les workers commencent avec les mêmes paramètres initiaux.
- Créez Horovod DistributedOptimizer (ligne 25), pour mettre à jour les paramètres de manière distribuée.
Pour obtenir le script complet, consultez les exemples Horovod-MXNet. et .
1  import mxnet as mx
2  import horovod.mxnet as hvd
3
4  # Horovod : initialiser Horovod
5  hvd.init()
6
7  # Horovod : épingler un GPU à utiliser pour le rang local
8  context = mx.gpu(hvd.local_rank())
9
10 # Construire le modèle
11 model = ...
12
13 # Initialiser les paramètres
14 model.initialize(initializer, ctx=context)
15 params = model.collect_params()
16
17 # Horovod : diffuser les paramètres
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Créer l'optimiseur
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod : envelopper l'optimiseur avec DistributedOptimizer
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Créer le formateur et la fonction de perte
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Entraîner le modèle
32 for epoch in range(num_epoch):
33    ...
Étape 3
Connectez-vous à l'un des workers pour lancer l'entraînement distribué en utilisant la directive MPI. Dans cet exemple, l'entraînement distribué est lancé sur quatre instances avec 4 GPU chacune, totalisant 16 GPU dans le cluster. Un optimiseur de descente de gradient stochastique (SGD) sera utilisé avec les hyperparamètres suivants :
- taille de mini-lot : 256
- taux d'apprentissage : 0.1
- momentum : 0.9
- weight decay : 0.0001
En passant d'un GPU à 64 GPU, nous avons linéairement augmenté la vitesse d'apprentissage en fonction du nombre de GPU (de 0,1 pour 1 GPU à 6,4 pour 64 GPU), tout en maintenant le nombre d'images par GPU à 256 (d'un lot de 256 images pour 1 GPU à 16 384 pour 64 GPU). Les paramètres de weight decay et de momentum ont été ajustés lors de l'augmentation du nombre de GPU. Nous avons utilisé l'apprentissage à précision mixte avec le type de données float16 pour la propagation avant et float32 pour les gradients, afin d'accélérer les calculs float16 pris en charge par les GPU NVIDIA Tesla.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Conclusion
Dans cet article, nous avons examiné une approche évolutive pour l'apprentissage distribué des modèles en utilisant Apache MXNet et Horovod. Nous avons démontré l'efficacité de la montée en charge et sa rentabilité par rapport à l'approche basée sur un serveur de paramètres, en utilisant le jeu de données ImageNet, sur lequel le modèle ResNet50-v1 a été entraîné. Nous avons également détaillé les étapes que vous pouvez suivre pour modifier un script existant afin de démarrer l'apprentissage sur plusieurs instances avec Horovod.
Si vous débutez avec MXNet et l'apprentissage profond, rendez-vous sur la page d'installation , pour commencer à compiler MXNet. Nous recommandons également fortement de lire l'article , pour commencer à travailler.
Si vous avez déjà travaillé avec MXNet et souhaitez essayer l'apprentissage distribué avec Horovod, jetez un œil à la , compilez-le avec MXNet et suivez l'exemple ou .
*le coût est calculé sur la base de AWS pour les instances EC2
En savoir plus sur le cours
Source : habr.com
