

Le théorème CAP est la pierre angulaire de la théorie des systèmes distribués. Bien sûr, les débats à son sujet ne cessent pas : ses définitions ne sont pas canonisées et il n'existe pas de preuve stricte... Cela dit, en restant fermement sur des positions de bon sens™, nous comprenons intuitivement que le théorème est vrai.
La seule chose qui n'est pas évidente, c'est la signification de la lettre « P ». Lorsque le cluster se divise, il décide s'il doit ne pas répondre jusqu'à ce qu'un quorum soit atteint ou s'il doit fournir les données disponibles. En fonction des résultats de ce choix, le système est classé soit comme CP, soit comme AP. Cassandra, par exemple, peut se comporter de l'une ou l'autre manière, non pas en fonction des paramètres du cluster, mais des paramètres de chaque requête spécifique. Mais si le système n'est pas « P », et qu'il est divisé, alors que se passe-t-il ?
La réponse à cette question est quelque peu inattendue : un cluster CA ne peut pas se diviser.
Quel type de cluster est-ce qui ne peut pas se diviser ?
Un attribut indispensable de ce type de cluster est un système de stockage de données commun. Dans la grande majorité des cas, cela signifie une connexion via SAN, ce qui limite l'application des solutions CA aux grandes entreprises capables de maintenir une infrastructure SAN. Pour que plusieurs serveurs puissent travailler avec les mêmes données, un système de fichiers en cluster est nécessaire. De tels systèmes de fichiers se trouvent dans les portefeuilles HPE (CFS), Veritas (VxCFS) et IBM (GPFS).
Oracle RAC
L'option Real Application Cluster a fait son apparition pour la première fois en 2001 lors de la sortie d'Oracle 9i. Dans un tel cluster, plusieurs instances de serveurs travaillent avec la même base de données.
Oracle peut fonctionner à la fois avec un système de fichiers en cluster et avec sa propre solution - ASM, Automatic Storage Management.
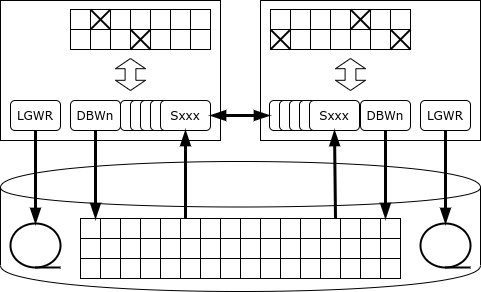
Chaque instance tient son propre journal. Une transaction est exécutée et enregistrée par une instance. En cas de défaillance d'une instance, l'un des nœuds survivants du cluster (instances) lit son journal et récupère les données perdues - c'est ce qui assure la disponibilité.
Toutes les instances maintiennent leur propre cache, et les mêmes pages (blocs) peuvent se trouver simultanément dans les caches de plusieurs instances. De plus, si une instance a besoin d'une page et qu'elle est dans le cache d'une autre instance, elle peut l'obtenir de son « voisin » grâce au mécanisme de fusion des caches au lieu de la lire depuis le disque.
Mais que se passe-t-il si l'une des instances a besoin de modifier des données ?
La particularité d'Oracle est qu'il n'a pas de service de verrouillage dédié : si un serveur souhaite verrouiller une ligne, l'enregistrement du verrouillage est directement inscrit sur la page mémoire où se trouve la ligne verrouillée. Grâce à cette approche, Oracle est le champion de la performance parmi les bases de données monolithiques : le service de verrouillage n'est jamais un goulot d'étranglement. Cependant, dans une configuration en cluster, une telle architecture peut entraîner un échange de données intensif et des blocages mutuels.
Une fois qu'un enregistrement est verrouillé, l'instance informe toutes les autres instances que la page contenant cet enregistrement est occupée en mode monopolistique. Si une autre instance a besoin de modifier l'enregistrement sur la même page, elle doit attendre que les modifications de la page soient validées, c'est-à-dire que l'information de changement soit enregistrée dans le journal sur le disque (pendant ce temps, la transaction peut se poursuivre). Il se peut aussi qu'une page soit modifiée de manière séquentielle par plusieurs instances, et alors, lors de l'écriture de la page sur le disque, il faudra déterminer laquelle des instances détient la version actuelle de cette page.
Une mise à jour aléatoire des mêmes pages à travers différents nœuds RAC entraîne une baisse drastique de la performance de la base de données - au point que la performance du cluster peut être inférieure à celle d'une instance unique.
Une utilisation correcte d'Oracle RAC consiste en une division physique des données (par exemple, à l'aide du mécanisme des tables partitionnées) et en l'accès à chaque ensemble de partitions via un nœud dédié. L'objectif principal de RAC est devenu non pas le scalabilité horizontale, mais la garantie de la tolérance aux pannes.
Si un nœud cesse de répondre au heartbeat, le nœud qui le détecte en premier lance une procédure de vote sur disque. Si là encore le nœud manquant ne se signale pas, l'un des nœuds assume les responsabilités de récupération des données :
- « fige » toutes les pages qui étaient dans le cache du nœud manquant ;
- lit les journaux (redo) du nœud manquant et réapplique les modifications enregistrées dans ces journaux, tout en vérifiant s'il n'y a pas de versions plus récentes des pages modifiées sur d'autres nœuds.
- annule les transactions inachevées.
Pour faciliter le passage entre les nœuds, Oracle propose le concept de service – une instance virtuelle. Une instance peut gérer plusieurs services, et un service peut se déplacer entre les nœuds. Une instance d'application, qui gère une certaine partie de la base (par exemple, un groupe de clients), fonctionne avec un seul service, et le service qui est responsable de cette partie de la base se déplace vers un autre nœud en cas de défaillance du nœud.
IBM Pure Data Systems for Transactions
La solution cluster pour SGBD est apparue dans le portefeuille du Grand Bleu en 2009. Idéologiquement, elle est l'héritière du cluster Parallel Sysplex, construit sur du matériel « traditionnel ». En 2009, le produit DB2 pureScale a été lancé, qui est un ensemble de logiciels, et en 2012, IBM a proposé un ensemble logiciel-matériel (appliance) appelé Pure Data Systems for Transactions. Il ne faut pas le confondre avec Pure Data Systems for Analytics, qui n'est autre qu'un Netezza renommé.
L'architecture pureScale ressemble à première vue à Oracle RAC : de la même manière, plusieurs nœuds sont connectés à un système de stockage de données commun, et chaque nœud exécute sa propre instance de SGBD avec ses propres zones de mémoire et journaux de transactions. Mais, contrairement à Oracle, DB2 dispose d'un service de verrouillage dédié, représenté par un ensemble de processus db2LLM*. Dans une configuration de cluster, ce service est déplacé sur un nœud séparé, qui dans Parallel Sysplex est appelé facility de couplage (CF), et dans Pure Data – PowerHA.
PowerHA fournit les services suivants :
- gestionnaire de verrouillage ;
- cache global de pages ;
- zone de communication inter-processus.
Pour le transfert de données de PowerHA vers les nœuds BD et vice versa, un accès distant à la mémoire est utilisé, donc l'interconnexion de cluster doit supporter le protocole RDMA. PureScale peut utiliser à la fois Infiniband et RDMA over Ethernet.
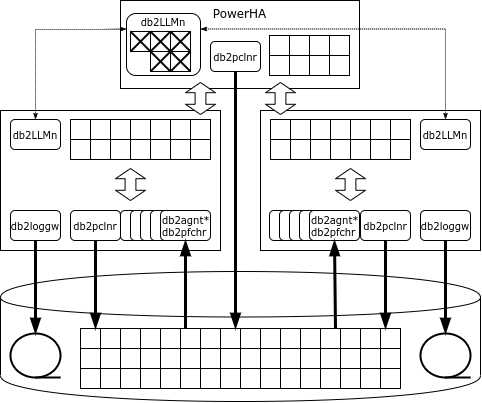
Si un nœud nécessite une page, et que cette page n'est pas dans le cache, le nœud demande la page dans le cache global, et seulement si elle n'y est pas non plus, il la lit depuis le disque. Contrairement à Oracle, la requête ne va que vers PowerHA, et non vers les nœuds voisins.
Lorsqu'une instance souhaite modifier une ligne, elle la verrouille en mode exclusif, tandis que la page contenant la ligne est verrouillée en mode partagé. Tous les verrous sont enregistrés dans le gestionnaire de verrouillage global. Lorsque la transaction se termine, le nœud envoie un message au gestionnaire de verrouillage, qui copie la page modifiée dans le cache global, lève les verrous et invalide la page modifiée dans les caches des autres nœuds.
Si la page contenant la ligne modifiable est déjà verrouillée, le gestionnaire de verrouillage lira la page modifiée depuis la mémoire du nœud ayant effectué les changements, lèvera le verrou, invalidera la page modifiée dans les caches des autres nœuds et donnera le verrou de la page au nœud qui l'a demandé.
Les pages « sales », c'est-à-dire modifiées, peuvent être écrites sur disque à partir de n'importe quel nœud, qu'il soit normal ou PowerHA (castout).
En cas de défaillance d'un des nœuds pureScale, la récupération est limitée uniquement aux transactions qui n'ont pas encore été finalisées au moment de la panne : les pages modifiées par ce nœud dans des transactions terminées sont présentes dans le cache global sur PowerHA. Le nœud redémarre dans une configuration réduite sur l'un des serveurs du cluster, annule les transactions non finalisées et libère les verrous.
PowerHA fonctionne sur deux serveurs, et le nœud principal réplique son état de manière synchrone. En cas de défaillance du nœud principal, le cluster PowerHA continue à fonctionner avec le nœud de secours.
Bien sûr, si l'on accède à l'ensemble de données via un seul nœud, la performance globale du cluster sera supérieure. PureScale peut même détecter qu'une certaine zone de données est traitée par un seul nœud, alors tous les verrous relatifs à cette zone seront gérés localement par le nœud sans communications avec PowerHA. Mais dès que l'application essaie d'accéder à ces données via un autre nœud, le traitement centralisé des verrous sera repris.
Les tests internes d'IBM sur une charge de travail composée de 90 % de lectures et 10 % d'écritures, ce qui ressemble beaucoup à une charge de travail industrielle réelle, montrent un presque scalabilité linéaire jusqu'à 128 nœuds. Les conditions de test, hélas, ne sont pas divulguées.
HPE NonStop SQL
La plateforme hautement disponible est également dans le portefeuille de Hewlett-Packard Enterprise. Il s'agit de la plateforme NonStop, lancée sur le marché en 1976 par Tandem Computers. En 1997, l'entreprise a été absorbée par Compaq, qui, à son tour, a été intégrée dans Hewlett-Packard en 2002.
NonStop est utilisé pour construire des applications critiques – par exemple, HLR ou le traitement des cartes bancaires. La plateforme est fournie sous forme de complexe matériel et logiciel (appliance), comprenant des nœuds de calcul, un système de stockage et du matériel de communication. Le réseau ServerNet (dans les systèmes modernes – Infiniband) sert autant à l'échange entre les nœuds qu'à l'accès au système de stockage.
Dans les premières versions du système, des processeurs propriétaires étaient utilisés, qui étaient synchronisés entre eux : toutes les opérations étaient exécutées de manière synchrone par plusieurs processeurs, et dès qu'un processeur rencontrait une erreur, il se désactivait pendant que les autres continuaient de fonctionner. Plus tard, le système est passé à des processeurs standard (d'abord MIPS, puis Itanium et enfin x86), et d'autres mécanismes de synchronisation ont été utilisés :
- messages : chaque processus système a un doublon « ombre », auquel le processus actif envoie périodiquement des messages sur son état ; en cas de défaillance du processus principal, le processus ombre reprend à l'état défini par le dernier message ;
- vote : le système de stockage a un composant matériel spécial qui reçoit plusieurs requêtes identiques et les exécute uniquement si les requêtes correspondent ; au lieu d'une synchronisation physique, les processeurs fonctionnent de manière asynchrone, et les résultats de leur travail ne sont comparés que lors des moments d'entrée/sortie.
Depuis 1987, une base de données relationnelle fonctionne sur la plateforme NonStop – d'abord SQL/MP, puis SQL/MX.
L'ensemble de la base de données est divisé en parties, et chaque partie est gérée par son propre processus Data Access Manager (DAM). Celui-ci assure l'enregistrement des données, la mise en cache et le mécanisme de verrouillage. Le traitement des données est effectué par des processus exécutants (Executor Server Process), qui fonctionnent sur les mêmes nœuds que les gestionnaires de données correspondants. Le planificateur SQL/MX répartit les tâches entre les exécutants et combine les résultats. Pour apporter des modifications consensuelles, un protocole de validation à deux phases est utilisé, assuré par la bibliothèque TMF (Transaction Management Facility).
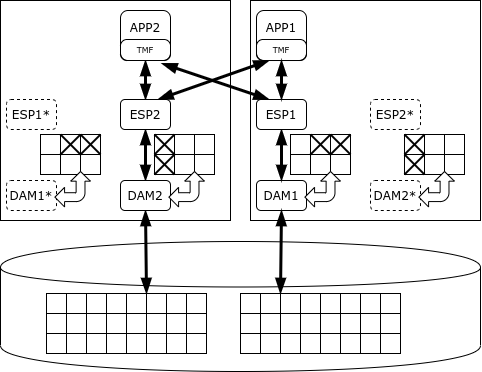
NonStop SQL sait donner la priorité aux processus de manière à ce que les longues requêtes analytiques n'entravent pas l'exécution des transactions. Cependant, sa vocation est précisément le traitement de courtes transactions, et non l'analyse. Le développeur garantit la disponibilité du cluster NonStop à un niveau de cinq « neuf », c'est-à-dire que le temps d'arrêt ne dépasse que 5 minutes par an.
SAP HANA
La première version stable du SGBD HANA (1.0) a été publiée en novembre 2010, et le package SAP ERP est passé à HANA en mai 2013. La plateforme est basée sur des technologies acquises : TREX Search Engine (pour la recherche dans le stockage en colonnes), SGBD P*TIME et MAX DB.
Le terme « HANA » est un acronyme pour High performance ANalytical Appliance. Ce SGBD est fourni sous forme de code, qui peut fonctionner sur n'importe quel serveur x86, cependant les installations industrielles ne sont autorisées que sur du matériel certifié. Des solutions de HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi et NEC sont disponibles. Certaines configurations de Lenovo permettent même une exploitation sans SAN, le cluster GPFS sur disques locaux jouant le rôle de stockage partagé.
Contrairement aux plateformes mentionnées ci-dessus, HANA est un SGBD en mémoire, c'est-à-dire que l'ensemble des données primaires est stocké en mémoire vive, et seules les journaux et des instantanés périodiques sont enregistrés sur le disque – pour récupération en cas de panne.
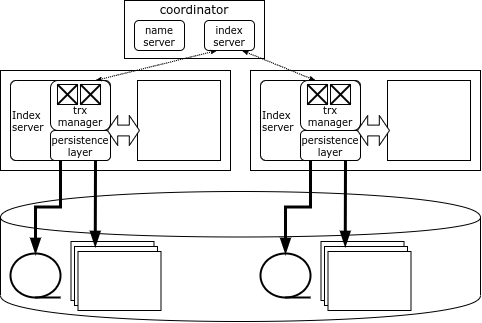
Chaque nœud du cluster HANA est responsable de sa partie des données, et la carte des données est stockée dans un composant spécial – le Name Server, situé sur le nœud coordinateur. Les données ne sont pas dupliquées entre les nœuds. Les informations sur les verrouillages sont également conservées sur chaque nœud, mais un détecteur global de blocages est présent dans le système.
Le client HANA, lors de la connexion au cluster, charge sa topologie et peut ensuite accéder directement à n'importe quel nœud en fonction des données dont il a besoin. Si la transaction concerne les données d'un seul nœud, elle peut être exécutée localement par ce nœud. En revanche, si des données de plusieurs nœuds sont modifiées, le nœud initiateur se tourne vers le nœud coordinateur, qui ouvre et coordonne la transaction distribuée, la validant à l'aide d'un protocole optimisé de validation en deux étapes.
Le nœud coordinateur est redondant, donc en cas de défaillance du coordinateur, le nœud de secours prend immédiatement le relais. En revanche, si un nœud contenant des données tombe en panne, la seule façon d'accéder à ses données est de redémarrer le nœud. En général, dans les clusters HANA, un serveur de secours (spare) est maintenu afin de pouvoir redémarrer le nœud perdu le plus rapidement possible.
Source : habr.com
