

Bonjour, habitants de Habr. Comme nous l'avons déjà mentionné, ce mois-ci, OTUS lance deux cours sur l'apprentissage automatique, à savoir et . Dans ce contexte, nous continuons à partager du contenu utile.
L'objectif de cet article est de partager notre première expérience d'utilisation de .
Nous commencerons la revue avec son serveur de suivi et nous enregistrerons toutes les itérations de la recherche. Ensuite, nous partagerons notre expérience de connexion de Spark à MLflow via UDF.
Contexte
Nous avons utilise l'apprentissage automatique et l'intelligence artificielle pour permettre aux personnes de prendre soin de leur santé et de leur bien-être. C'est pourquoi les modèles d'apprentissage automatique sont au cœur de nos produits de traitement des données, et c'est également pour cette raison que nous avons été attirés par MLflow - une plateforme open source qui couvre tous les aspects du cycle de vie de l'apprentissage automatique.
MLflow
L'objectif principal de MLflow est d'assurer une couche supplémentaire au-dessus de l'apprentissage automatique, permettant aux spécialistes des données de travailler pratiquement avec n'importe quelle bibliothèque d'apprentissage automatique (, , , , et ), élevant son utilisation à un nouveau niveau.
MLflow fournit trois composants :
- Suivi – enregistrement et requêtes sur les expériences : code, données, configuration et résultats. Suivre le processus de création de modèle est très important.
- Projets – Format d'emballage pour un déploiement sur n'importe quelle plateforme (par exemple, )
- Modèles – format unifié pour l'envoi de modèles à divers outils de déploiement.
MLflow (au moment de la rédaction de cet article en version alpha) est une plateforme open source qui permet de gérer le cycle de vie de l'apprentissage automatique, y compris les expériences, la réutilisation et le déploiement.
Configuration de MLflow
Pour utiliser MLflow, il faut d'abord configurer tout l'environnement Python, pour cela nous allons utiliser (pour installer Python sur Mac, consultez ). Ainsi, nous pouvons créer un environnement virtuel où nous installerons toutes les bibliothèques nécessaires au démarrage.
```
pyenv install 3.7.0
pyenv global 3.7.0 # Utiliser Python 3.7
mkvirtualenv mlflow # Créer un environnement virtuel avec Python 3.7
workon mlflow
```
Installons les bibliothèques requises.
```
pip install mlflow==0.7.0
            Cython==0.29
            numpy==1.14.5
            pandas==0.23.4
            pyarrow==0.11.0
```
Remarque : nous utilisons PyArrow pour exécuter des modèles tels que UDF. Les versions de PyArrow et Numpy devaient être ajustées, car les dernières versions entraient en conflit entre elles.
Lançons l'interface utilisateur de suivi
MLflow Tracking nous permet de journaliser et de requêter les expériences à l'aide de Python et API. En outre, il est possible de définir où stocker les artefacts du modèle (localhost, , , ou ). Étant donné qu'Alpha Health utilise AWS, S3 sera utilisé comme stockage des artefacts.
# Running a Tracking Server
mlflow server
    --file-store /tmp/mlflow/fileStore
    --default-artifact-root s3://<bucket>/mlflow/artifacts/
    --host localhost
    --port 5000
MLflow recommande d'utiliser un stockage de fichiers permanent. Un stockage de fichiers est l'endroit où le serveur stockera les métadonnées des exécutions et des expériences. Lorsque vous démarrez le serveur, assurez-vous qu'il pointe vers un stockage de fichiers permanent. Ici, pour l'expérience, nous allons simplement utiliser /tmp.
N'oubliez pas que si nous souhaitons utiliser le serveur mlflow pour exécuter d'anciennes expériences, celles-ci doivent être présentes dans le stockage de fichiers. Cependant, même sans cela, nous pourrions les utiliser dans UDF, car nous avons seulement besoin du chemin vers le modèle.
Remarque : Gardez à l'esprit que l'interface utilisateur de Tracking et le client du modèle doivent avoir accès à l'emplacement de l'artefact. Donc, quel que soit l'emplacement de l'interface utilisateur de Tracking sur une instance EC2, lors de l'exécution locale de MLflow, la machine doit avoir un accès direct à S3 pour écrire des modèles d'artefacts.
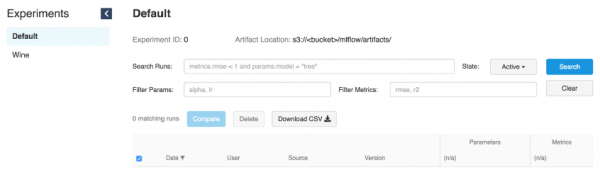
L'interface utilisateur de Tracking stocke les artefacts dans un bucket S3
Lancement des modèles
Une fois que le serveur Tracking fonctionne, vous pouvez commencer à entraîner des modèles.
À titre d'exemple, nous allons utiliser la modification de wine de l'exemple MLflow dans .
MLFLOW_TRACKING_URI=http://localhost:5000 python wine_quality.py
  --alpha 0.9
  --l1_ration 0.5
  --wine_file ./data/winequality-red.csv
Comme nous l'avons mentionné, MLflow permet de journaliser les paramètres, les métriques et les artefacts des modèles, afin que nous puissions suivre leur évolution au fil des itérations. Cette fonctionnalité est extrêmement utile, car elle nous permet de reproduire le meilleur modèle en consultant le serveur Tracking ou en comprenant quel code a exécuté l'itération nécessaire en utilisant les logs des hash de commit git.
with mlflow.start_run():

    ... modèle ...

    mlflow.log_param("source", wine_path)
    mlflow.log_param("alpha", alpha)
    mlflow.log_param("l1_ratio", l1_ratio)

    mlflow.log_metric("rmse", rmse)
    mlflow.log_metric("r2", r2)
    mlflow.log_metric("mae", mae)

    mlflow.set_tag('domaine', 'vin')
    mlflow.set_tag('prédire', 'qualité')
mlflow.sklearn.log_model(lr, "modèle") 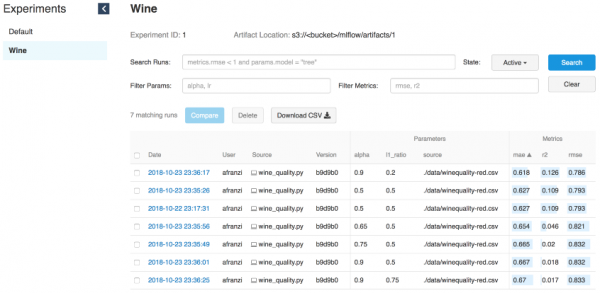
Itérations wine
Partie serveur pour le modèle
Le serveur de suivi MLflow, lancé avec la commande “mlflow server”, dispose d'une API REST pour suivre les exécutions et enregistrer les données dans le système de fichiers local. Vous pouvez spécifier l'adresse du serveur de suivi grâce à la variable d'environnement «MLFLOW_TRACKING_URI» et l'API de suivi MLflow se connectera automatiquement au serveur de suivi à cette adresse pour créer/obtenir des informations sur l'exécution, les métriques, les journaux, etc.
Source :
Pour fournir un serveur à un modèle, nous aurons besoin d'un serveur de suivi en cours d'exécution (voir l'interface de démarrage) et de l'ID d'exécution du modèle.
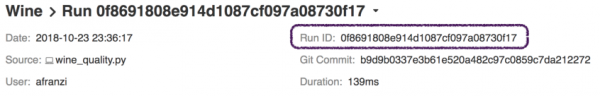
ID d'exécution
# Serve a sklearn model through 127.0.0.0:5005
MLFLOW_TRACKING_URI=http://0.0.0.0:5000 mlflow sklearn serve
  --port 5005
  --run_id 0f8691808e914d1087cf097a08730f17
  --model-path model
Pour gérer les modèles à l'aide de la fonctionnalité MLflow serve, nous aurons besoin d'accéder à l'interface utilisateur de suivi, afin d'obtenir des informations sur le modèle simplement en indiquant --run_id.
Une fois le modèle lié au serveur de suivi, nous pouvons obtenir un nouveau point de terminaison pour le modèle.
# Query Tracking Server Endpoint
curl -X POST
  http://127.0.0.1:5005/invocations
  -H 'Content-Type: application/json'
  -d '[
	{
		"fixed acidity": 3.42,
		"volatile acidity": 1.66,
		"citric acid": 0.48,
		"residual sugar": 4.2,
		"chloridessssss": 0.229,
		"free sulfur dsioxide": 19,
		"total sulfur dioxide": 25,
		"density": 1.98,
		"pH": 5.33,
		"sulphates": 4.39,
		"alcohol": 10.8
	}
]'

> {"predictions": [5.825055635303461]}
Exécution de modèles à partir de Spark
Bien que le serveur de suivi soit suffisamment puissant pour gérer les modèles en temps réel, leur entraînement et l'utilisation de la fonctionnalité serve (source : ), l'utilisation de Spark (batch ou streaming) est une solution encore plus puissante grâce à la répartition.
Imaginez que vous veniez tout juste d'effectuer un entraînement hors ligne, puis que vous avez appliqué le modèle sortant à toutes vos données. C'est là que Spark et MLflow brillent vraiment.
Installation de PySpark + Jupyter + Spark
Source :
Pour montrer comment nous appliquons les modèles MLflow aux DataFrames Spark, il faut configurer la collaboration entre les notebooks Jupyter et PySpark.
Commencez par installer la dernière version stable :
cd ~/Downloads/
tar -xzf spark-2.4.3-bin-hadoop2.7.tgz
mv ~/Downloads/spark-2.4.3-bin-hadoop2.7 ~/
ln -s ~/spark-2.4.3-bin-hadoop2.7 ~/spark
Installez PySpark et Jupyter dans un environnement virtuel :
pip install pyspark jupyterConfigurez les variables d'environnement :
export SPARK_HOME=~/spark
export PATH=$SPARK_HOME/bin:$PATH
export PYSPARK_DRIVER_PYTHON=jupyter
export PYSPARK_DRIVER_PYTHON_OPTS="notebook --notebook-dir=${HOME}/Projects/notebooks"
En définissant notebook-dir, nous pourrons stocker nos notebooks dans le dossier souhaité.
Lancement de Jupyter depuis PySpark
Puisque nous avons pu configurer Jupiter en tant que pilote PySpark, nous pouvons maintenant exécuter un notebook Jupyter dans le contexte de PySpark.
(mlflow) afranzi:~$ pyspark
[I 19:05:01.572 NotebookApp] extension sparkmagic activée !
[I 19:05:01.573 NotebookApp] Servir les notebooks depuis le répertoire local : /Users/afranzi/Projects/notebooks
[I 19:05:01.573 NotebookApp] Le Jupyter Notebook est en cours d'exécution à :
[I 19:05:01.573 NotebookApp] http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745
[I 19:05:01.573 NotebookApp] Utilisez Control-C pour arrêter ce serveur et fermer tous les noyaux (deux fois pour passer la confirmation).
[C 19:05:01.574 NotebookApp]

    Copiez/collez cette URL dans votre navigateur lorsque vous vous connectez pour la première fois,
    pour vous connecter avec un token :
http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745 
Comme mentionné précédemment, MLflow fournit une fonctionnalité de journalisation des artefacts de modèle dans S3. Une fois que nous avons le modèle sélectionné en main, nous avons la possibilité de l'importer en tant que UDF à l'aide du module mlflow.pyfunc.
import mlflow.pyfunc

model_path = 's3:///mlflow/artifacts/1/0f8691808e914d1087cf097a08730f17/artifacts/model'
wine_path = '/Users/afranzi/Projects/data/winequality-red.csv'
wine_udf = mlflow.pyfunc.spark_udf(spark, model_path)

df = spark.read.format("csv").option("header", "true").option('delimiter', ';').load(wine_path)
columns = [ "fixed acidity", "volatile acidity", "citric acid",
            "residual sugar", "chlorides", "free sulfur dioxide",
            "total sulfur dioxide", "density", "pH",
            "sulphates", "alcohol"
          ]

df.withColumn('prediction', wine_udf(*columns)).show(100, False) 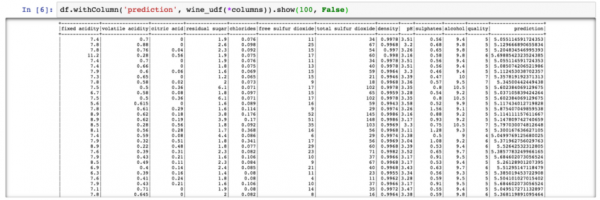
PySpark – Résultat de la prévision de la qualité du vin
Jusqu'à présent, nous avons parlé de l'utilisation de PySpark avec MLflow, en exécutant la prévision de la qualité du vin sur l'ensemble du jeu de données wine. Mais que faire si nous devons utiliser les modules Python MLflow à partir de Scala Spark ?
Nous avons testé cela, en partageant le contexte Spark entre Scala et Python. Cela signifie que nous avons enregistré le UDF MLflow en Python et l'avons utilisé depuis Scala (oui, ce n'est peut-être pas la meilleure solution, mais c'est ce que nous avons).
Scala Spark + MLflow
Pour cet exemple, nous allons ajouter au Jupyter existant.
Installation de Spark + Toree + Jupyter
pip install toree
jupyter toree install --spark_home=${SPARK_HOME} --sys-prefix
jupyter kernelspec list
```
```
Kernels disponibles :
  apache_toree_scala    /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/apache_toree_scala
  python3               /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/python3
```
Comme le montre le notebook ci-joint, le UDF est utilisé conjointement avec Spark et PySpark. Nous espérons que cette partie sera utile à ceux qui aiment Scala et souhaitent déployer des modèles d'apprentissage automatique en production.
import org.apache.spark.sql.functions.col
import org.apache.spark.sql.types.StructType
import org.apache.spark.sql.{Column, DataFrame}
import scala.util.matching.Regex

val FirstAtRe: Regex = "^_".r
val AliasRe: Regex = "[\s_.:@]+".r

def getFieldAlias(field_name: String): String = {
    FirstAtRe.replaceAllIn(AliasRe.replaceAllIn(field_name, "_"), "")
}

def selectFieldsNormalized(columns: List[String])(df: DataFrame): DataFrame = {
    val fieldsToSelect: List[Column] = columns.map(field =>
        col(field).as(getFieldAlias(field))
    )
    df.select(fieldsToSelect: _*)
}

def normalizeSchema(df: DataFrame): DataFrame = {
    val schema = df.columns.toList
    df.transform(selectFieldsNormalized(schema))
}

FirstAtRe = ^_
AliasRe = [s_.:@]+

getFieldAlias: (field_name: String)String
selectFieldsNormalized: (columns: List[String])(df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
normalizeSchema: (df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
Out[1]:
[s_.:@]+
In [2]:
val winePath = "~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv"
val modelPath = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"

winePath = ~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv
modelPath = \/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
Out[2]:
\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
In [3]:
val df = spark.read
              .format("csv")
              .option("header", "true")
              .option("delimiter", ";")
              .load(winePath)
              .transform(normalizeSchema)

df = [fixed_acidity: string, volatile_acidity: string ... 10 more fields]
Out[3]:
[fixed_acidity: string, volatile_acidity: string ... 10 more fields]
In [4]:
%%PySpark
import mlflow
from mlflow import pyfunc

model_path = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"
wine_quality_udf = mlflow.pyfunc.spark_udf(spark, model_path)

spark.udf.register("wineQuality", wine_quality_udf)
Out[4]:
<function spark_udf..predict at 0x1116a98c8>
In [6]:
df.createOrReplaceTempView("wines")
In [10]:
%%SQL
SELECT
    quality,
    wineQuality(
        fixed_acidity,
        volatile_acidity,
        citric_acid,
        residual_sugar,
        chlorides,
        free_sulfur_dioxide,
        total_sulfur_dioxide,
        density,
        pH,
        sulphates,
        alcohol
    ) AS prediction
FROM wines
LIMIT 10
Out[10]:
+-------+------------------+
|quality|        prediction|
+-------+------------------+
|      5| 5.576883967129615|
|      5|  5.50664776916154|
|      5| 5.525504822954496|
|      6| 5.504311247097457|
|      5| 5.576883967129615|
|      5|5.5556903912725755|
|      5| 5.467882654744997|
|      7| 5.710602976324739|
|      7| 5.657319539336507|
|      5| 5.345098606538708|
+-------+------------------+

In [17]:
spark.catalog.listFunctions.filter('name like "%wineQuality%").show(20, false)

+-----------+--------+-----------+---------+-----------+
|name       |database|description|className|isTemporary|
+-----------+--------+-----------+---------+-----------+
|wineQuality|null    |null       |null     |true       |
+-----------+--------+-----------+---------+-----------+
Prochaines étapes
Bien que MLflow soit encore en version Alpha au moment de la rédaction de cet article, il semble prometteur. La possibilité d'exécuter plusieurs frameworks d'apprentissage automatique et de les utiliser depuis un seul point d'accès élève les systèmes de recommandation à un nouveau niveau.
De plus, MLflow rapproche les ingénieurs en données et les spécialistes en data science en établissant une couche commune entre eux.
Après cette étude sur MLflow, nous sommes convaincus que nous irons plus loin et utiliserons cet outil pour nos pipelines Spark et dans nos systèmes de recommandation.
Il serait judicieux de synchroniser le stockage de fichiers avec la base de données, plutôt qu'avec le système de fichiers. Ainsi, nous devrions obtenir plusieurs points de terminaison pouvant utiliser le même stockage de fichiers. Par exemple, utiliser plusieurs instances et avec le même Glue metastore.
En résumé, je tiens à remercier la communauté MLFlow pour rendre notre travail avec les données plus intéressant.
Si vous expérimentez avec MLflow, n'hésitez pas à nous écrire et à nous dire comment vous l'utilisez, surtout si vous l'implémentez en production.
En savoir plus sur les cours :
Lire aussi :
Source : habr.com
