

Dans l'article précédent, j'ai parlé des bases du DATA VAULT, décrit les principaux éléments du DATA VAULT et leurs fonctions. Toutefois, le sujet du DATA VAULT n'est pas épuisé, il est nécessaire d'aborder les étapes suivantes de son évolution.
Dans cet article, je vais me concentrer sur le développement du DATA VAULT et la transition vers le BUSINESS DATA VAULT ou simplement le BUSINESS VAULT.
Raisons de l'émergence du BUSINESS DATA VAULT
Il convient de noter que, bien que le DATA VAULT ait certaines forces, il n'est pas dépourvu de faiblesses. L'une de ces faiblesses est la complexité de l'écriture des requêtes analytiques. Ces requêtes comportent un nombre significatif de JOIN, le code devient donc long et encombrant. De plus, les données entrant dans le DATA VAULT ne subissent aucune transformation, ce qui signifie que, du point de vue des affaires, le DATA VAULT en tant que tel n'a pas de valeur absolue.
C'est précisément pour remédier à ces défauts que la méthodologie du DATA VAULT a été enrichie par des éléments tels que :
- des tables PIT (point in time);
- des tables BRIDGE;
- des DERIVATIONS PRÉDÉFINIES.
Analysons plus en détail la fonction de ces éléments.
Tables PIT
En général, un objet métier (HUB) peut contenir des données avec des fréquences de mise à jour différentes. Par exemple, si nous parlons des données qui caractérisent une personne, nous pouvons dire que les informations relatives au numéro de téléphone, à l'adresse ou à l'e-mail ont une fréquence de mise à jour plus élevée que, par exemple, le nom complet, les données du passeport, la situation familiale ou le sexe.
Ainsi, lors de la détermination des satellites, il convient de tenir compte de leur fréquence de mise à jour. Pourquoi est-ce important ?
Si l'on stocke des attributs avec des fréquences de mise à jour différentes dans une même table, il faudra ajouter une ligne à cette table à chaque mise à jour de l'attribut le plus souvent modifié. En conséquence, cela entraîne une augmentation de l'espace disque nécessaire et un temps d'exécution des requêtes accru.
Maintenant que nous avons divisé les satellites en fonction de leur fréquence de mise à jour, et que nous pouvons charger des données indépendamment dans chacun d'eux, il est essentiel de garantir l'accès à des données actuelles. Il est préférable de le faire sans utiliser de JOIN superflus.
Par exemple, il est nécessaire d'obtenir des informations à jour (en fonction de la date de la dernière mise à jour) à partir de satellites ayant des fréquences de mise à jour différentes. Pour cela, il faudra non seulement effectuer un JOIN, mais aussi créer plusieurs requêtes imbriquées (pour chaque satellite contenant des informations) en sélectionnant la date de mise à jour maximale MAX(Date de mise à jour). Avec chaque nouveau JOIN, ce code s'agrandit et devient rapidement difficile à comprendre.
La table PIT est conçue pour simplifier de telles requêtes, les tables PIT sont remplies en même temps que l'enregistrement de nouvelles données dans le DATA VAULT. Table PIT :
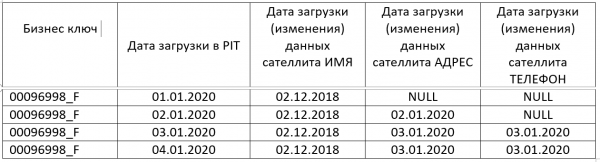
Ainsi, nous avons des informations sur la pertinence des données pour tous les satellites à chaque instant. En utilisant des JOIN sur la table PIT, nous pouvons complètement exclure les requêtes imbriquées, sous réserve que la PIT soit remplie chaque jour sans interruption. Même en cas de manques dans la PIT, il est possible d'obtenir des données à jour en n'utilisant qu'une seule requête imbriquée sur la PIT elle-même. Une requête imbriquée fonctionnera plus rapidement que des requêtes imbriquées vers chaque satellite.
BRIDGE
Les tables de type BRIDGE sont également utilisées pour simplifier les requêtes analytiques. Cependant, contrairement à la PIT, elles servent à simplifier et à accélérer les requêtes entre différents hubs, liens et leurs satellites.
La table contient toutes les clés nécessaires pour tous les satellites, qui sont souvent utilisées dans les requêtes. De plus, si nécessaire, les clés commerciales hachées peuvent être complétées par des clés textuelles, si les noms des clés sont nécessaires pour l'analyse.
Le fait est que sans l'utilisation de BRIDGE, lors de l'obtention de données situées dans des satellites appartenant à différents hubs, il sera nécessaire de faire un JOIN non seulement des satellites eux-mêmes, mais aussi des liens reliant les hubs.
La présence ou l'absence de BRIDGE est déterminée par la configuration de l'entrepôt et la nécessité d'optimiser la vitesse d'exécution des requêtes. Il est difficile d'imaginer un exemple universel de BRIDGE.
DERIVATIONS PRÉDÉFINIES
Un autre type d'objets qui nous rapproche du BUSINESS DATA VAULT est constitué des tables contenant des indicateurs préalablement calculés. Ces tables sont effectivement importantes pour les affaires, car elles contiennent des informations agrégées selon des règles données et permettent d'y accéder de manière relativement simple.
Les dérivations prédéfinies représentent rien d'autre qu'un autre satellite d'un hub spécifique. Tout comme un satellite ordinaire, il contient une clé commerciale et une date de création de l'enregistrement dans le satellite. Cependant, c'est là que s'arrêtent les ressemblances. La composition ultérieure des attributs de ce « satellite spécialisé » est déterminée par les utilisateurs commerciaux sur la base des indicateurs les plus demandés et préalablement calculés.
Par exemple, un hub contenant des informations sur un employé peut inclure un satellite avec des indicateurs tels que :
- Salaire minimum;
- Salaire maximum;
- Salaire moyen;
- Total accumulé des salaires versés, etc.
Il est logique d'inclure les dérivations prédéfinies dans la table PIT du même hub, permettant ainsi d'obtenir facilement des coupes de données sur l'employé à une date choisie.
CONCLUSIONS
Comme le montre la pratique, l'utilisation de Data Vault par les utilisateurs commerciaux est quelque peu difficile pour plusieurs raisons :
- Le code des requêtes est complexe et encombrant;
- L'abondance de JOIN affecte les performances des requêtes;
- Une connaissance exceptionnelle de la structure du stockage est nécessaire pour rédiger des requêtes analytiques.
Pour simplifier l'accès aux données, Data Vault est étendu avec des objets supplémentaires :
- des tables PIT (point in time);
- des tables BRIDGE;
- des DERIVATIONS PRÉDÉFINIES.
Dans la prochaine Je compte partager, à mon avis, les éléments les plus intéressants pour ceux qui travaillent avec BI. Je présenterai des méthodes de création de tables de faits et de tables de dimensions basées sur Data Vault.
Les matériaux de l'article sont basés sur :
- Sur Kenta Graziano, qui contient en plus une description détaillée avec des schémas du modèle;
- Le livre : « Building a Scalable Data Warehouse with DATA VAULT 2.0 »;
- Article .
Source : habr.com
