

Il y a quelques mois — un service public pour PostgreSQL.
Depuis, vous l'avez déjà utilisé plus de 6000 fois, mais l'une des fonctionnalités pratiques a pu passer inaperçue — il s'agit de suggestions structurées, qui ressemblent à peu près à ceci :
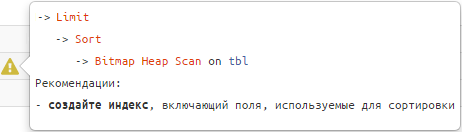
Écoutez-les, et vos requêtes « deviendront lisses et soyeuses ». 🙂
Et si l'on est sérieux, il existe de nombreuses situations qui rendent les requêtes lentes et « gourmandes » en ressources, qui sont typiques et peuvent être reconnues par la structure et les données du plan.
Dans ce cas, chaque développeur n'aura pas besoin de chercher une solution d'optimisation par lui-même, en s'appuyant uniquement sur son expérience — nous pouvons lui indiquer ce qui se passe, quelle pourrait être la cause, et comment aborder la solution. Ce que nous avons fait.
Examinons un peu plus en détail ces cas — comment ils sont déterminés et quelles recommandations ils engendrent.
Pour mieux s'immerger dans le sujet, vous pouvez d'abord écouter le bloc correspondant de , puis ensuite passer à l'analyse détaillée de chaque exemple :
#1: индексная «недосортировка»
Quand se pose la question
Afficher le dernier relevé du client « LLC Cloche ».
Comment identifier
-> Limite
   -> Trier
      -> Scan d'Index [Uniquement] [Inverse] | Scan Bitmap de Tas
Recommandations
Index utilisé étendre avec des champs de tri.
Exemple :
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "faits"
, (random() * 1000)::integer fk_cli; -- 1K clés étrangères différentes

CREATE INDEX ON tbl(fk_cli); -- index pour clé étrangère

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- sélection selon un lien spécifique
ORDER BY
  pk DESC -- nous voulons seulement un "dernier" enregistrement
LIMIT 1; 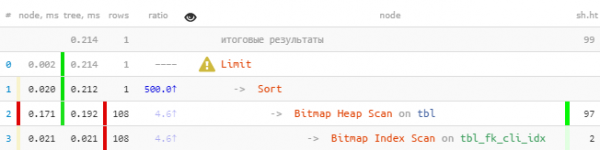
On peut immédiatement remarquer qu'en utilisant cet index, plus de 100 enregistrements ont été lus, qui ont ensuite tous été triés, et finalement un seul a été conservé.
Correction :
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- ajout de la clé de tri
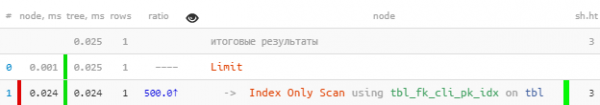
Même sur un échantillon aussi primitif — 8,5 fois plus rapide et 33 fois moins de lectures. L'effet sera d'autant plus évident que vous avez plus de « faits » pour chaque valeur fk.
Je note que cet index fonctionnera comme un « préfixe » au moins aussi bien que le précédent sur d'autres requêtes avec fk, où il n'y avait pas de tri sur pk n'était pas et n'est pas (vous pouvez lire plus à ce sujet ). De plus, il assurera un bon support des clés étrangères explicites pour ce champ.
#2: пересечение индексов (BitmapAnd)
Quand se pose la question
Afficher tous les contrats du client « LLC Cloche », conclus au nom de « NAO Loutik ».
Comment identifier
-> BitmapAnd
   -> Scan d'Index Bitmap
   -> Scan d'Index Bitmap
Recommandations
Créer indice composite par champs de l'une ou l'autre des sources ou étendre l'un des champs existants avec ceux de l'autre.
Exemple :
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "faits"
, (random() *  100)::integer fk_org  -- 100 clés étrangères différentes
, (random() * 1000)::integer fk_cli; -- 1K clés étrangères différentes

CREATE INDEX ON tbl(fk_org); -- index pour clef étrangère
CREATE INDEX ON tbl(fk_cli); -- index pour clef étrangère

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- sélection par paire spécifique 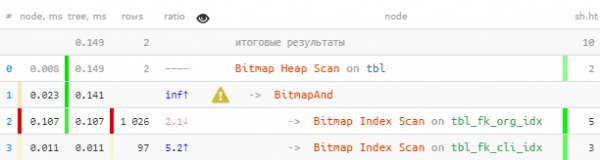
Correction :
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
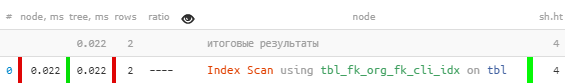
Ici, le gain est moins important, car le Bitmap Heap Scan est déjà assez efficace par lui-même. Mais quand même 7 fois plus rapide et 2,5 fois moins de lectures.
#3: объединение индексов (BitmapOr)
Quand se pose la question
Afficher les 20 demandes « anciennes » les plus anciennes ou non assignées pour traitement, les anciennes étant prioritaires.
Comment identifier
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Recommandations
Utiliser UNION [ALL] pour combiner les sous-requêtes de chaque bloc OR des conditions.
Exemple :
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "faits"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- avec une probabilité de 1:16 enregistrement "nul"
    ELSE (random() * 100)::integer -- 100 différentes clés étrangères
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- index avec un tri "supposément adéquat"

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- les siens
  fk_own IS NULL -- ... ou "nuls"
ORDER BY
  pk
, (fk_own = 1) DESC -- d'abord "les siens"
LIMIT 20;
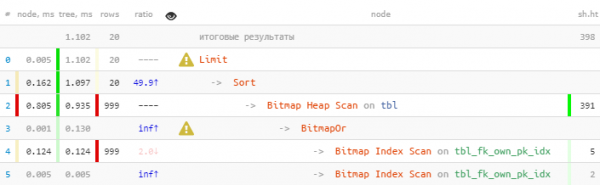
Correction :
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- d'abord "les siens" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- puis "nuls" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- mais au total - 20, pas besoin de plus 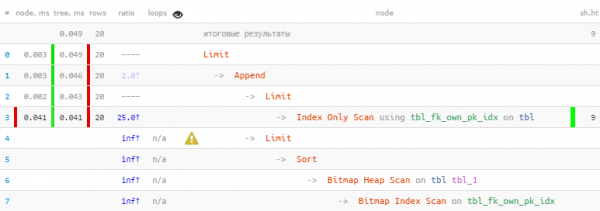
Nous avons profité du fait que tous les 20 enregistrements nécessaires ont été récupérés dès le premier bloc, donc le second, avec un Bitmap Heap Scan plus "coûteux", n'a même pas été exécuté - au final 22 fois plus rapide, 44 fois moins de lectures!
Une explication plus détaillée de cette méthode d'optimisation avec des exemples spécifiques peut être lue dans les articles et .
Version généralisée de la sélection ordonnée selon plusieurs clés (et pas seulement selon la paire const/NULL) est abordée dans l'article .
#4: читаем много лишнего
Quand se pose la question
En général, cela survient lorsqu'on souhaite "ajouter un filtre" à une requête existante.
"Et n'avez-vous pas un semblable, mais avec des boutons en nacre?» film "La main au collet"
Par exemple, en modifiant la tâche ci-dessus, afficher les 20 demandes « critiques » les plus anciennes pour traitement, indépendamment de leur assignation.
Comment identifier
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × rows < RRbF -- filtré >80% lu
   && loops × RRbF > 100 -- et en plus plus de 100 enregistrements au total
Recommandations
Créer [plus] spécialisé un index avec une condition WHERE ou inclure des champs supplémentaires dans l'index.
Si la condition de filtrage est « statique » pour vos tâches — c'est-à-dire ne suppose pas d'extension de la liste des valeurs à l'avenir — il est préférable d'utiliser un index WHERE. Différents statuts boolean/enum se classent bien dans cette catégorie.
Cependant, si la condition de filtrage peut prendre différentes valeurs, il vaut mieux élargir l'index avec ces champs — comme dans le cas de BitmapAnd ci-dessus.
Exemple :
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "faits"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 différentes clés étrangères
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, que la demande est "critique"

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 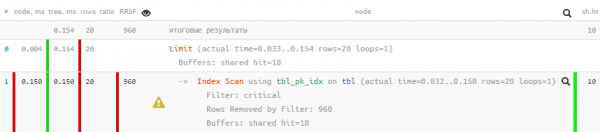
Correction :
CREATE INDEX ON tbl(pk)
  WHERE critical; -- ajout d'une condition de filtrage "statique"
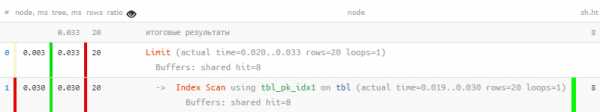
Comme nous le voyons, le filtrage du plan a complètement disparu, et la requête est devenue 5 fois plus rapide.
#5: разреженная таблица
Quand se pose la question
Différentes tentatives de créer sa propre file d'attente de traitement des tâches, lorsque de nombreuses mises à jour/suppressions d'enregistrements dans la table entraînent une situation avec de nombreux enregistrements « morts ».
Comment identifier
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && boucles × (lignes + RRbF) < (partagé hit + partagé lecture) × 8
      -- plus de 1 Ko lu pour chaque enregistrement
   && partagé hit + partagé lecture > 64
Recommandations
Effectuer régulièrement à la main VACUUM [FULL] ou garantir un fonctionnement suffisamment fréquent en ajustant ses paramètres, y compris .
Dans la plupart des cas, de tels problèmes sont causés par une mauvaise composition des requêtes lors des appels de logique métier comme celles abordées dans .
Mais il faut comprendre que même VACUUM FULL ne peut pas toujours aider. Pour ces cas, il vaut la peine de se renseigner sur l'algorithme de l'article .
#6: чтение с «середины» индекса
Quand se pose la question
On dirait que l'on a un peu lu, que tout était indexé et que l'on n'a filtré personne en trop — mais tout de même, beaucoup plus de pages ont été lues que souhaité.
Comment identifier
-> Index [Only] Scan [Backward]
   && boucles × (lignes + RRbF) < (partagé hit + partagé lecture) × 8
      -- plus de 1 Ko lu pour chaque enregistrement
   && partagé hit + partagé lecture > 64
Recommandations
Regardez attentivement la structure de l'index utilisé et les champs clés spécifiés dans la requête — il est probable que une partie de l'index n'est pas spécifiée. Il est probable que vous devrez créer un index similaire, mais sans les champs de préfixe ou .
Exemple :
CRÉER UNE TABLE tbl COMME
SÉLECTIONNER
  generate_series(1, 100000) pk      -- 100K "faits"
, (random() *  100)::integer fk_org  -- 100 clés étrangères différentes
, (random() * 1000)::integer fk_cli; -- 1K clés étrangères différentes

CRÉER UN INDEX SUR tbl(fk_org, fk_cli); -- tout est presque comme dans #2
-- sauf que cet index séparé par fk_cli a été jugé inutile et supprimé

SÉLECTIONNER
  *
DE
  tbl
OÙ
  fk_cli = 999 -- et fk_org n'est pas spécifié, bien qu'il soit dans l'index plus tôt
LIMITER 20; 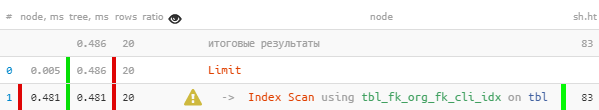
Tout semble en ordre, même avec l'index, mais c'est suspect — pour chacune des 20 enregistrements lus, il a fallu lire 4 pages de données, 32 Ko par enregistrement — n'est-ce pas un peu trop ? Et le nom de l'index tbl_fk_org_fk_cli_idx suscite des réflexions.
Correction :
CRÉER UN INDEX SUR tbl(fk_cli); 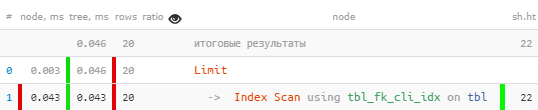
Soudainement — 10 fois plus rapide, et 4 fois moins à lire!
D'autres exemples de situations d'utilisation inefficace des index peuvent être vus dans l'article .
#7: CTE × CTE
Quand se pose la question
Dans la requête nous avons ajouté des CTE "gros" de différentes tables, puis décidé de les réaliser entre eux JOIN.
Le cas est pertinent pour les versions inférieures à v12 ou les requêtes avec AVEC MATÉRIALISÉ.
Comment identifier
-> Scan de CTE
   && boucles > 10
   && boucles × (lignes + RRbF) > 10000
      -- produit cartésien de CTE trop grand
Recommandations
Analyser soigneusement la requête — est-ce que ? Если все-таки да, то appliquer "dictionarisation" dans hstore/json selon le modèle décrit dans .
#8: swap на диск (temp written)
Quand se pose la question
Le traitement ponctuel (tri ou dé-duplication) d'un grand nombre d'enregistrements ne rentre pas dans la mémoire allouée à cet effet.
Comment identifier
-> *
   && temps écrit > 0
Recommandations
Si la mémoire utilisée par l'opération ne dépasse pas considérablement la valeur du paramètre , il vaut la peine de le corriger. On peut le faire directement dans la configuration pour tous, ou via SET [LOCAL] pour une requête/transaction spécifique.
Exemple :
MONTRER work_mem;
-- "16MB"

SÉLECTIONNER
  random()
DE
  generate_series(1, 1000000)
ORDONNÉ PAR
1; 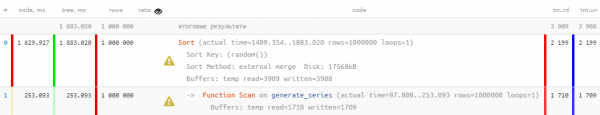
Correction :
SET work_mem = '128MB'; -- avant d'exécuter la requête 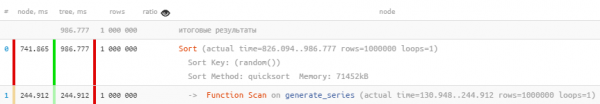
Pour des raisons évidentes, si seule la mémoire est utilisée, et non le disque, la requête sera exécutée beaucoup plus rapidement. En même temps, une partie de la charge du HDD est également réduite.
Mais il faut comprendre qu'il est aussi impossible d'allouer beaucoup de mémoire — il n'y en aura tout simplement pas assez pour tout le monde.
#9: неактуальная статистика
Quand se pose la question
De nombreuses données ont été importées d'un coup, mais nous n'avons pas eu le temps de faire passer ANALYSE.
Comment identifier
-> Scan séquentiel | Scan de tas bitmap | Scan [seulement] de l'index [arrière]
   && ratio >> 10
Recommandations
Il faut donc ANALYSE.
Cette situation est décrite en détail dans .
#10: «что-то пошло не так»
Quand se pose la question
Une attente a eu lieu en raison d'un verrou posé par une requête concurrente, ou de ressources matérielles CPU/hyperviseur insuffisantes.
Comment identifier
-> *
   && (frappe partagé / 8K) + (lecture partagée / 1K) < temps / 1000
      -- Ram hit = 64 Mo/s, lecture HDD = 8 Mo/s
   && temps > 100 ms -- nous avons peu lu, mais c'était trop long
Recommandations
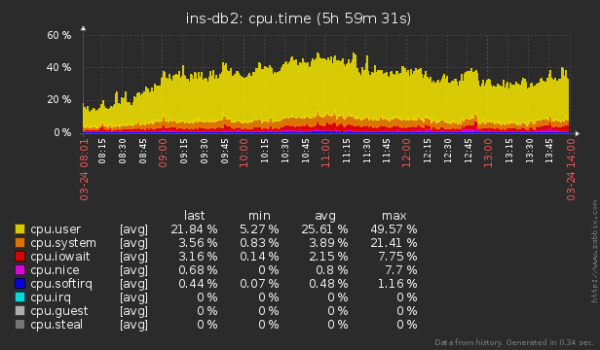
Utilisez un externe système de surveillance des serveurs pour détecter les blocages ou la consommation anormale de ressources. Nous avons déjà parlé de notre façon d'organiser ce processus pour des centaines de serveurs et .
Source : habr.com
