

Dans cet article, nous aimerions parler des particularités du fonctionnement des systèmes All Flash AccelStor avec l'une des plateformes de virtualisation les plus populaires - VMware vSphere. En particulier, nous allons mettre l'accent sur les paramètres qui aideront à maximiser l'effet d'utilisation d'un outil aussi puissant que l'All Flash.
Les systèmes All Flash AccelStor NeoSapphire™ représentent ou dispositifs à nœuds basés sur des unités SSD avec une approche fondamentalement différente dans la mise en œuvre du stockage de données et l'organisation de l'accès à celles-ci en utilisant notre propre technologie au lieu des algorithmes RAID très populaires. Ces systèmes offrent un accès bloc pour les hôtes via des interfaces Fibre Channel ou iSCSI. Pour être juste, notons que les modèles avec interface iSCSI disposent également d'un accès fichier comme agréable bonus. Cependant, dans cet article, nous nous concentrerons sur l'application des protocoles bloc comme étant les plus performants pour All Flash.
L'ensemble du processus de déploiement et de configuration ultérieure du fonctionnement conjoint des systèmes AccelStor et de la plateforme de virtualisation VMware vSphere peut être divisé en plusieurs étapes :
- Mise en œuvre de la topologie de connexion et configuration du réseau SAN;
- Configuration du système All Flash;
- Configuration des hôtes ESXi;
- Configuration des machines virtuelles.
Les équipements utilisés pour les exemples étaient des systèmes AccelStor NeoSapphire™ avec interface Fibre Channel et interface iSCSI. Le logiciel de base utilisé était VMware vSphere 6.7U1.
Avant de déployer les systèmes décrits dans l'article, il est fortement recommandé de consulter la documentation de VMware concernant les questions de performance ( ) et les configurations iSCSI ()
Topologie de connexion et configuration du réseau SAN
Les composants principaux d'un réseau SAN sont les adaptateurs HBA dans les hôtes ESXi, les commutateurs SAN et les nœuds du système. La topologie typique de ce réseau ressemblerait à ceci :
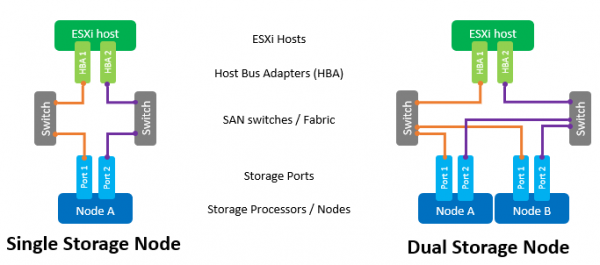
Le terme Switch ici désigne à la fois un commutateur physique distinct ou un ensemble de commutateurs (Fabric), ainsi qu'un dispositif partagé entre plusieurs services (VSAN dans le cas du Fibre Channel et VLAN dans le cas de l'iSCSI). L'utilisation de deux commutateurs indépendants/Fabric permettra d'éliminer un point de défaillance potentiel.
Bien que la connexion directe des hôtes au système de stockage soit prise en charge, elle n'est pas du tout recommandée. Les performances des systèmes All Flash sont suffisamment élevées. Pour une vitesse optimale, tous les ports du système de stockage doivent être utilisés. Par conséquent, la présence d'au moins un commutateur entre les hôtes et le NeoSapphire™ est indispensable.
La présence de deux ports sur le HBA de l'hôte est également une exigence essentielle pour atteindre des performances maximales et garantir la redondance.
En cas d'utilisation de l'interface Fibre Channel, une configuration du zoning est requise afin d'éviter d'éventuelles collisions entre les initiateurs et les cibles. Les zones sont créées selon le principe suivant : « un port d'initiateur – un ou plusieurs ports du système de stockage ».
Dans le cas d'une connexion via iSCSI, si un commutateur partagé avec d'autres services est utilisé, il est impératif d'isoler le trafic iSCSI au sein d'un VLAN séparé. Il est également fortement recommandé d'activer la prise en charge des Jumbo Frames (MTU = 9000) pour augmenter la taille des paquets dans le réseau, réduisant ainsi la quantité d'informations de protocole lors de la transmission. Cependant, il convient de se rappeler que pour un fonctionnement correct, il est nécessaire de modifier le paramètre MTU sur tous les composants du réseau dans la chaîne « initiateur-commutateur-cible ».
Configuration du système All Flash
Le système est livré aux clients avec des groupes déjà formés. . Par conséquent, aucune action visant à rassembler les disques en une seule structure n'est nécessaire. Il suffit de créer des volumes de la taille et du nombre requis.
Pour plus de commodité, une fonctionnalité de création groupée de plusieurs volumes de taille donnée est disponible. Par défaut, des volumes « fins » sont créés, car cela permet d'utiliser plus efficacement l'espace de stockage disponible (notamment grâce à la prise en charge de la récupération d'espace). En termes de performances, la différence entre les volumes « fins » et « épais » ne dépasse pas 1 %. Cependant, si vous souhaitez tirer le meilleur parti du système de stockage, vous pouvez toujours convertir n'importe quel volume « fin » en volume « épais ». Il convient de noter que cette opération est irréversible.
Il reste ensuite à « publier » les volumes créés et à définir les droits d'accès pour eux de la part des hôtes grâce à des ACL (adresses IP pour l'iSCSI et WWPN pour le FC) et à la séparation physique par les ports du tableau. Pour les modèles iSCSI, cela se fait en créant une Target.
Pour les modèles FC, la publication se fait en créant un LUN pour chaque port du tableau.
Pour accélérer le processus de configuration, les hôtes peuvent être regroupés. En outre, si l'hôte utilise une HBA FC multi-port (ce qui est souvent le cas dans la pratique), le système détermine automatiquement que les ports de cette HBA appartiennent à un hôte unique grâce à des WWPN qui diffèrent d'une unité. De plus, la création par lots de Target/LUN est supportée pour les deux interfaces.
Une remarque importante en cas d'utilisation de l'interface iSCSI est la création pour les volumes de plusieurs cibles simultanément afin d'augmenter la performance, car la queue sur la cible ne peut pas être modifiée, et elle sera en fait un goulot d'étranglement.
Configuration des hôtes ESXi
Du côté des hôtes ESXi, la configuration de base est effectuée selon un scénario plutôt attendu. L'ordre des opérations pour la connexion iSCSI :
- Ajouter un adaptateur iSCSI logiciel (non requis s'il est déjà ajouté, ou en cas d'utilisation d'un adaptateur iSCSI matériel) ;
- Créer un vSwitch, à travers lequel le trafic iSCSI passera, et ajouter des uplinks physiques et un VMkernal ;
- Ajouter les adresses du tableau dans la découverte dynamique ;
- Créer un DataStore
Quelques remarques importantes :
- En général, il est bien sûr possible d'utiliser un vSwitch existant, mais en cas de vSwitch séparé, la gestion des paramètres de l'hôte sera beaucoup plus simple.
- Il est nécessaire de séparer le trafic de gestion et l'iSCSI par des liaisons physiques et/ou des VLAN distincts afin d'éviter des problèmes de performance.
- Les adresses IP du VMkernal et des ports correspondants de l'ensemble Flash All doivent se situer dans le même sous-réseau, encore une fois à cause des questions de performance.
- Pour garantir la redondance selon les règles de VMware, le vSwitch doit avoir au moins deux uplinks physiques.
- Si les Jumbo Frames sont utilisés, il est nécessaire de modifier le MTU à la fois du vSwitch et du VMkernal.
- Il est utile de rappeler que, selon les recommandations de VMware pour les adaptateurs physiques qui seront utilisés pour gérer le trafic iSCSI, il est impératif de configurer le Teaming and Failover. En particulier, chaque VMkernel doit fonctionner uniquement via un uplink, tandis que le deuxième uplink doit être mis en mode inutilisé. Pour assurer la redondance, il est nécessaire d'ajouter deux VMkernels, chacun fonctionnant via son propre uplink.
Adaptateur VMkernel (vmk#)
Adaptateur réseau physique (vmnic#)
vmk1 (Storage01)
Adaptateurs actifs
vmnic2
Adaptateurs inutilisés
vmnic3
vmk2 (Storage02)
Adaptateurs actifs
vmnic3
Adaptateurs inutilisés
vmnic2
Aucune action préalable n'est requise pour une connexion via Fibre Channel. Vous pouvez immédiatement créer un Datastore.
Après la création du Datastore, vous devez vous assurer que la politique Round Robin est utilisée pour les chemins vers le Target/LUN, car elle est la plus performante.
Par défaut, les paramètres de VMware prévoient l'utilisation de cette politique selon le schéma suivant : 1000 demandes via le premier chemin, les 1000 demandes suivantes via le deuxième chemin, etc. Une telle interaction du hôte avec un ensemble à deux contrôleurs sera déséquilibrée. Nous recommandons donc de définir le paramètre Round Robin policy = 1 via Esxcli/PowerCLI.
Paramètres
Pour Esxcli :
- Afficher les LUN disponibles
esxcli storage nmp device list
- Copier le Device Name
- Modifier la politique Round Robin
esxcli storage nmp psp roundrobin deviceconfig set —type=iops —iops=1 —device=«Device_ID»
La plupart des applications modernes sont conçues pour échanger des paquets de données de grande taille afin de maximiser l'utilisation de la bande passante et de réduire la charge sur le processeur central. Par conséquent, ESXi, par défaut, envoie des demandes d'entrée/sortie au périphérique de stockage par morceaux allant jusqu'à 32767 Ko. Cependant, pour certains scénarios, un échange en plus petites portions sera plus performant. Pour les systèmes AccelStor, les scénarios suivants s'appliquent :
- La machine virtuelle utilise UEFI plutôt que Legacy BIOS
- vSphere Replication est utilisé
Pour ces scénarios, il est recommandé de changer la valeur du paramètre Disk.DiskMaxIOSize à 4096.
Pour les connexions iSCSI, il est recommandé de modifier le paramètre Login Timeout à 30 (par défaut 5) pour améliorer la stabilité de la connexion et de désactiver le délai de confirmation des paquets retransmis DelayedAck. Ces deux options se trouvent dans vSphere Client : Host → Configure → Storage → Storage Adapters → Advanced Options pour l'adaptateur iSCSI.
Un point assez délicat est le nombre de volumes utilisés pour le datastore. Il est évident que, pour simplifier la gestion, nous avons tendance à créer un grand volume pour l'ensemble de l'espace du tableau. Cependant, avoir plusieurs volumes et, par conséquent, plusieurs datastores a un effet bénéfique sur les performances globales (plus de détails sur les files d'attente un peu plus loin dans le texte). C'est pourquoi nous recommandons de créer au moins deux volumes.
Il n'y a pas si longtemps, VMware conseillait de limiter le nombre de machines virtuelles sur un seul datastore afin d'obtenir des performances maximales. Cependant, aujourd'hui, surtout avec la popularité de la VDI, ce problème n'est plus aussi pressant. Cela n'annule pas la règle ancienne de répartir les machines virtuelles nécessitant un I/O intensif sur différents datastores. Pour déterminer le nombre optimal de machines virtuelles par volume, rien ne vaut un dans le cadre de votre infrastructure.
Configuration des machines virtuelles
Il n'y a pas d'exigences particulières lors de la configuration des machines virtuelles, pour être plus précis, elles sont assez ordinaires :
- Utilisation de la version VM maximale possible (compatibilité)
- Faire attention à la taille de la RAM lors de la densité des machines virtuelles, par exemple, dans la VDI (car par défaut, au démarrage, un fichier d'échange de taille équivalente à celle de la RAM est créé, ce qui consomme de l'espace utile et affecte la performance globale)
- Utiliser les versions d'adaptateurs les plus performantes en matière d'I/O : le type de réseau VMXNET 3 et le type SCSI PVSCSI
- Utiliser le type de disque Thick Provision Eager Zeroed pour une performance maximale et Thin Provisioning pour une utilisation optimale de l'espace de stockage
- Limiter, dans la mesure du possible, le fonctionnement des machines non critiques en matière d'I/O à l'aide de Virtual Disk Limit
- Assurez-vous d'installer VMware Tools
Remarques sur les files d'attente
La file d'attente (ou Outstanding I/Os) est le nombre de requêtes d'entrée/sortie (commandes SCSI) en attente de traitement à tout moment pour un appareil/application spécifique. En cas de saturation de la file d'attente, une erreur QFULL est générée, ce qui se traduit finalement par une augmentation du paramètre de latence. En utilisant des systèmes de stockage à disque (spindle), théoriquement, plus la file d'attente est élevée, meilleure est la performance. Cependant, il ne faut pas en abuser, car cela peut facilement entraîner une erreur QFULL. Dans le cas des systèmes All Flash, d'une part, les choses sont un peu plus simples : en effet, le système a des latences beaucoup plus basses et donc il n'est généralement pas nécessaire d'ajuster séparément la taille des files d'attente. D'autre part, dans certains scénarios d'utilisation (un déséquilibre fort dans les besoins en I/O pour des machines virtuelles spécifiques, des tests de performance maximale, etc.), il est nécessaire, si ce n'est pas de modifier les paramètres de la file d'attente, au moins de comprendre quels niveaux peuvent être atteints et, surtout, par quels moyens.
Sur le système All Flash AccelStor, il n'y a aucune limite concernant les volumes ou les ports d'entrée/sortie. Si nécessaire, un seul volume peut même obtenir toutes les ressources du système. La seule contrainte sur les files d'attente est au niveau des cibles iSCSI. C'est pourquoi il a été mentionné plus haut la nécessité de créer plusieurs (idéalement jusqu'à 8) cibles par volume pour surmonter cette limite. Encore une fois, préciser que les systèmes AccelStor sont des solutions très performantes. Il est donc conseillé d'utiliser tous les ports d'interface du système pour atteindre une vitesse maximale.
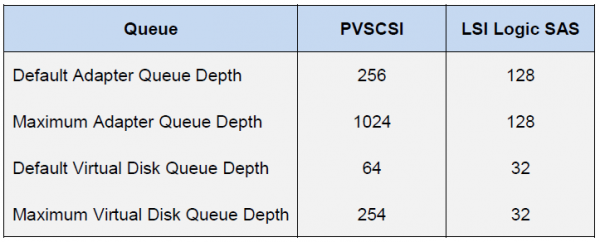
Du côté de l'hôte ESXi, la situation est complètement différente. L'hôte applique une pratique d'accès équitable aux ressources pour tous les participants. Par conséquent, il existe des files d'attente I/O distinctes pour le système d'exploitation invité et le HBA. Les files d'attente pour le système d'exploitation invité sont combinées à partir des files d'attente vers l'adaptateur SCSI virtuel et le disque virtuel :
La file d'attente vers le HBA dépend du type/fournisseur spécifique :
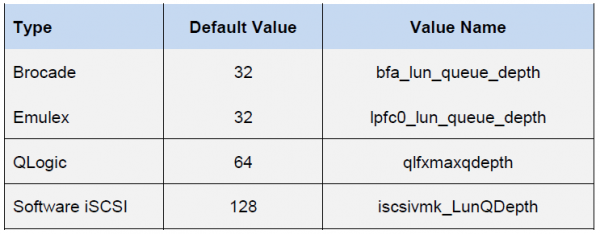
La performance finale de la machine virtuelle sera déterminée par la valeur la plus basse du paramètre de profondeur de file d'attente (Queue Depth limit) parmi les composants de l'hôte.
Grâce à ces valeurs, nous pouvons évaluer les performances que nous pouvons obtenir dans une configuration donnée. Par exemple, nous souhaitons connaître la performance théorique d'une machine virtuelle (sans liaison au bloc) avec une latence de 0,5 ms. Alors, IOPS = (1 000 / latence) * Outstanding I/Os (limite de profondeur de file d'attente)
Exemples
Exemple 1
- Adaptateur HBA FC Emulex
- Une VM sur le datastore
- Adaptateur SCSI Paravirtual VMware
Ici, la limite de profondeur de file d'attente est définie par l'HBA Emulex. Donc, IOPS = (1000 / 0.5) * 32 = 64K
Exemple 2
- Adaptateur logiciel iSCSI VMware
- Une VM sur le datastore
- Adaptateur SCSI Paravirtual VMware
Ici, la limite de profondeur de file d'attente est définie par l'adaptateur SCSI Paravirtual. Donc, IOPS = (1000 / 0.5) * 64 = 128K
Les modèles haut de gamme des systèmes All Flash d'AccelStor (par exemple, ) peuvent fournir une performance de 700K IOPS en écriture avec un bloc de 4K. À cette taille de bloc, il est clair qu'une seule machine virtuelle ne peut pas saturer un tel système. Il faut 11 (pour l'exemple 1) ou 6 (pour l'exemple 2) machines virtuelles.
En fin de compte, avec un réglage adéquat de tous les composants décrits du centre de données virtuel, on peut obtenir des résultats très impressionnants en termes de performance.
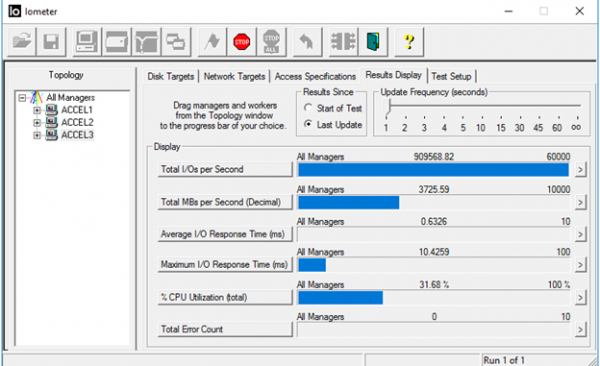
4K aléatoire, 70 % lecture / 30 % écriture
En réalité, le monde est beaucoup plus complexe pour être décrit par une simple formule. Sur un même hôte, il y a toujours plusieurs machines virtuelles avec différentes configurations et exigences en matière de E/S. De plus, le traitement des entrées/sorties est pris en charge par le processeur de l'hôte, dont la puissance n'est pas infinie. Ainsi, pour exploiter pleinement le potentiel de en réalité, trois hôtes sont nécessaires. En outre, les applications qui fonctionnent à l'intérieur des machines virtuelles apportent leurs propres ajustements. Par conséquent, pour une taille précise, nous proposons des systèmes All Flash au sein de l'infrastructure du client sur des tâches réelles en cours.
Source : habr.com
