

Au début de ce mois, le 3 mai, un grand lancement de la « plateforme de gestion pour les systèmes de stockage distribués dans Kubernetes » a été annoncé — . Il y a un peu plus d'un an, nous avions déjà un aperçu général de Rook. À cette époque, nous avons été invités à partager notre expérience de son utilisation pratique — et à l'approche de cette étape significative dans l'histoire du projet, nous sommes ravis de partager les impressions accumulées.
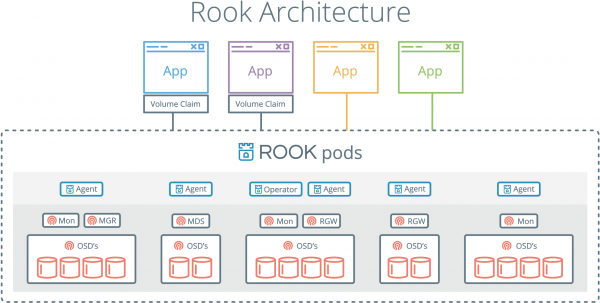
Pour faire court, Rook est un ensemble pour Kubernetes qui prend entièrement en charge le déploiement, la gestion et la récupération automatique de solutions de stockage de données telles que Ceph, EdgeFS, Minio, Cassandra, CockroachDB.
À ce jour, la solution la plus développée (et dans en phase stable) est rook-ceph-operator .
RemarqueAinsi, dans cet article, nous :
répondrons à la question des avantages que nous percevons dans l'utilisation de Rook pour le déploiement de Ceph dans un cluster Kubernetes ;
- partagerons notre expérience et nos impressions de l'utilisation de Rook en production ;
- expliquerons pourquoi nous disons « Oui ! » à Rook et nos projets à son sujet.
- Commençons par les concepts généraux et la théorie.
« J'ai un avantage d'une Tour ! » (joueur d'échecs inconnu)
L'un des principaux avantages de Rook est que l'interaction avec les systèmes de stockage de données se fait via les mécanismes de Kubernetes. Cela signifie qu'il n'est plus nécessaire de copier les commandes pour configurer Ceph depuis un papier dans la console.
— Tu veux déployer CephFS dans le cluster ? Il te suffit d'écrire un fichier YAML !
— Quoi ? Tu veux déployer aussi un store d'objets avec l'API S3 ? Il te suffit d'écrire un deuxième fichier YAML !
Rook est conçu selon toutes les règles d'un opérateur classique. L'interaction se fait à l'aide de
CRD (Custom Resource Definitions) (étant donné que c'est la seule implémentation stable, l'article parlera par défaut de Ceph, sauf indication contraire) . Selon les paramètres spécifiés, l'opérateur exécutera automatiquement les commandes nécessaires à la configuration.Concrètement, examinons cela à travers l'exemple de la création d'un Object Store, plus précisément —
CephObjectStoreUser CephObjectStoreUser.
apiVersion: ceph.rook.io/v1
kind: CephObjectStore
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  metadataPool:
    failureDomain: host
    replicated:
      size: 3
  dataPool:
    failureDomain: host
    erasureCoded:
      dataChunks: 2
      codingChunks: 1
  gateway:
    type: s3
    sslCertificateRef:
    port: 80
    securePort:
    instances: 1
    allNodes: false
---
apiVersion: ceph.rook.io/v1
kind: CephObjectStoreUser
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  store: {{ .Values.s3.crdName }}
  displayName: {{ .Values.s3.username }}
Les paramètres indiqués dans la liste sont assez standards et n'ont probablement pas besoin de commentaires, mais il est important de faire attention à ceux qui sont mis en variables de modèle.
Le schéma général de fonctionnement est que via le fichier YAML, nous "commandons" des ressources, pour lesquelles l'opérateur exécute les commandes nécessaires et nous renvoie un "faux" secret avec lequel nous pouvons continuer à travailler. (voir ci-dessous). Et à partir des variables mentionnées ci-dessus, sera constituée la commande et le nom du secret.
Quelle est donc cette commande ? Lors de la création d'un utilisateur pour le stockage d'objets, l'opérateur Rook exécutera ce qui suit à l'intérieur du pod :
radosgw-admin user create --uid="rook-user" --display-name="{{ .Values.s3.username }}"Le résultat de l'exécution de cette commande sera une structure JSON :
{
    "user_id": "rook-user",
    "display_name": "{{ .Values.s3.username }}",
    "keys": [
        {
           "user": "rook-user",
           "access_key": "NRWGT19TWMYOB1YDBV1Y",
           "secret_key": "gr1VEGIV7rxcP3xvXDFCo4UDwwl2YoNrmtRlIAty"
        }
    ],
    ...
}
Clés — qui seront nécessaires à l'avenir pour que les applications accèdent au stockage d'objets via l'API S3. L'opérateur Rook choisit ces clés et les stocke dans son namespace sous forme de secret nommé rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}.
Pour utiliser les données de ce secret, il suffit de les ajouter au conteneur en tant que variables d'environnement. Par exemple, voici un modèle pour un Job où nous créons automatiquement des buckets pour chaque environnement utilisateur :
{{- range $bucket := $.Values.s3.bucketNames }}
apiVersion: batch/v1
kind: Job
metadata:
  name: create-{{ $bucket }}-bucket-job
  annotations:
    "helm.sh/hook": post-install
    "helm.sh/hook-weight": "2"
spec:
  template:
    metadata:
      name: create-{{ $bucket }}-bucket-job
    spec:
      restartPolicy: Never
      initContainers:
      - name: waitdns
        image: alpine:3.6
        command: ["/bin/sh", "-c", "while ! getent ahostsv4 rook-ceph-rgw-{{ $.Values.s3.crdName }}; do sleep 1; done" ]
      - name: config
        image: rook/ceph:v1.0.0
        command: ["/bin/sh", "-c"]
        args: ["s3cmd --configure --access_key=$(ACCESS-KEY) --secret_key=$(SECRET-KEY) -s --no-ssl --dump-config | tee /config/.s3cfg"]
        volumeMounts:
        - name: config
          mountPath: /config
        env:
        - name: ACCESS-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: AccessKey
        - name: SECRET-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: SecretKey
      containers:
      - name: create-bucket
        image: rook/ceph:v1.0.0
        command:
        - "s3cmd"
        - "mb"
        - "--host=rook-ceph-rgw-{{ $.Values.s3.crdName }}"
        - "--host-bucket= "
        - "s3://{{ $bucket }}"
        ports:
        - name: s3-no-sll
          containerPort: 80
        volumeMounts:
        - name: config
          mountPath: /root
      volumes:
      - name: config
        emptyDir: {}
---
{{- end }}
Toutes les actions mentionnées dans ce Job ont été réalisées sans sortir de Kubernetes. Les structures décrites dans les fichiers YAML sont stockées dans un dépôt Git et réutilisées plusieurs fois. Cela représente un immense avantage pour les ingénieurs DevOps et le processus CI/CD dans son ensemble.
Avec Rook et Rados, c'est un plaisir
L'utilisation de l'association Ceph + RBD impose certaines limitations lors du montage des volumes aux pods.
En particulier, un secret d'accès à Ceph doit obligatoirement être présent dans le namespace pour que les applications stateful puissent fonctionner. Il est normal d'avoir 2-3 environnements dans vos espaces de noms : on peut alors les copier manuellement. Mais que faire si un environnement distinct est créé pour chaque fonctionnalité des développeurs avec son propre namespace ?
Nous avons résolu ce problème grâce à , qui copiait automatiquement les secrets dans de nouveaux namespaces (un exemple de ce hook est décrit dans ).
#! /bin/bash

if [[ $1 == “--config” ]]; then
   cat <<EOF
{"onKubernetesEvent":[
 {"name": "OnNewNamespace",
  "kind": "namespace",
  "event": ["add"]
  }
]}
EOF
else
    NAMESPACE=$(kubectl get namespace -o json | jq '.items | max_by( .metadata.creationTimestamp ) | .metadata.name')
    kubectl -n ${CEPH_SECRET_NAMESPACE} get secret ${CEPH_SECRET_NAME} -o json | jq ".metadata.namespace="${NAMESPACE}"" | kubectl apply -f -
fi
Cependant, avec Rook, ce problème n'existe tout simplement pas. Le processus de montage s'effectue à l'aide de ses propres pilotes basés sur ou (actuellement en phase bêta) et ne nécessite donc pas de secrets.
Rook résout automatiquement de nombreux problèmes, ce qui nous pousse à l'utiliser dans de nouveaux projets.
La conquête de Rook
Terminons la partie pratique par le déploiement de Rook et Ceph afin de pouvoir réaliser nos propres expériences. Pour rendre l'assaut sur cette tour imprenable plus facile, les développeurs ont préparé un paquet Helm. Téléchargeons-le :
$ helm fetch rook-master/rook-ceph --untar --version 1.0.0 Dans le fichier rook-ceph/values.yaml vous pouvez trouver de nombreux réglages différents. Le plus important est de spécifier des tolerations pour les agents et la recherche. Nous avons détaillé dans .
En résumé, nous ne voulons pas que les pods avec l'application cliente se trouvent sur les mêmes nœuds que ceux où sont situés les disques de stockage. La raison est simple : cela éviterait que le fonctionnement des agents Rook n'impacte l'application elle-même.
Alors, ouvrons le fichier rook-ceph/values.yaml avec votre éditeur préféré et ajoutons à la fin le bloc suivant :
discover:
  toleration: NoExecute
  tolerationKey: node-role/storage
agent:
  toleration: NoExecute
  tolerationKey: node-role/storage
  mountSecurityMode: Any
Pour chaque nœud réservé au stockage de données, ajoutons le taint correspondant :
$ kubectl taint node ${NODE_NAME} node-role/storage="":NoExecuteAprès cela, installons le chart Helm avec la commande :
$ helm install --namespace ${ROOK_NAMESPACE} ./rook-cephIl est maintenant nécessaire de créer un cluster et de spécifier l'emplacement :
apiVersion: ceph.rook.io/v1
kind: CephCluster
metadata:
  clusterName: "ceph"
  finalizers:
  - cephcluster.ceph.rook.io
  generation: 1
  name: rook-ceph
spec:
  cephVersion:
    image: ceph/ceph:v13
  dashboard:
    enabled: true
  dataDirHostPath: /var/lib/rook/osd
  mon:
    allowMultiplePerNode: false
    count: 3
  network:
    hostNetwork: true
  rbdMirroring:
    workers: 1
  placement:
    all:
      tolerations:
      - key: node-role/storage
        operator: Exists
  storage:
    useAllNodes: false
    useAllDevices: false
    config:
      osdsPerDevice: "1"
      storeType: filestore
    resources:
      limits:
        memory: "1024Mi"
      requests:
        memory: "1024Mi"
    nodes:
    - name: host-1
      directories:
      - path: "/mnt/osd"
    - name: host-2
      directories:
      - path: "/mnt/osd"
    - name: host-3
      directories:
      - path: "/mnt/osd"
Vérifions le statut de Ceph - nous nous attendons à voir HEALTH_OK:
$ kubectl -n ${ROOK_NAMESPACE} exec $(kubectl -n ${ROOK_NAMESPACE} get pod -l app=rook-ceph-operator -o name -o jsonpath='{.items[0].metadata.name}') -- ceph -sVérifions également que les pods avec l'application cliente ne se trouvent pas sur les nœuds réservés pour Ceph :
$ kubectl -n ${APPLICATION_NAMESPACE} get pods -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeNameEnsuite, si souhaité, configurez des composants supplémentaires. Plus de détails à leur sujet sont disponibles dans . Pour l'administration, nous recommandons fortement d'installer le tableau de bord et la boîte à outils.
Rook’s hooks: Rook est-il suffisant pour tout ?
Comme vous pouvez le voir, le développement de Rook progresse bien. Cependant, il subsiste des problèmes qui nous empêchent de nous passer complètement de la configuration manuelle de Ceph :
- Aucun pilote Rook exporter des métriques d'utilisation des blocs montés, ce qui nous prive de la surveillance.
- Flexvolume et CSI redimensionner les volumes (contrairement à RBD), donc Rook perd un outil utile (et parfois critique !).
- Rook n'est toujours pas aussi flexible que Ceph traditionnel. Si nous voulons configurer le pool de métadonnées CephFS pour qu'il soit stocké sur SSD, tandis que les données elles-mêmes sont sur HDD, nous devrons écrire des groupes d'appareils distincts dans les cartes CRUSH manuellement.
- Bien que le rook-ceph-operator soit considéré comme stable, il existe actuellement certains problèmes lors de la mise à jour de Ceph de la version 13 à 14.
Conclusions
« Actuellement, la Tour est protégée du monde extérieur par des pions, mais nous croyons qu'un jour elle jouera un rôle décisif dans la partie ! » (citation inventée spécialement pour cet article)
Le projet Rook a certainement conquis nos cœurs - nous pensons qu' [avec tous ses avantages et inconvénients] il mérite sans aucun doute votre attention également.
Nos futurs projets se concentrent sur la création de rook-ceph comme module pour , ce qui facilitera son utilisation dans nos nombreux clusters Kubernetes.
P.S.
Lisez aussi dans notre blog :
- «»;
- «»;
- «»;
- «»;
- «».
Source : habr.com
