

Des idées et des réunions sur les processus supplémentaires pouvant être automatisés surgissent quotidiennement dans des entreprises de toutes tailles. Cependant, en plus du temps consacré à la création du modèle, il est nécessaire de l'évaluer et de vérifier que le résultat obtenu n'est pas aléatoire. Une fois mise en œuvre, chaque modèle doit être surveillé et contrôlé périodiquement.
Et ce sont toutes des étapes que chaque entreprise doit franchir, quelle que soit sa taille. Si nous considérons l'échelle et l'héritage de Sberbank, le nombre de réglages fins augmente considérablement. À la fin de 2019, plus de 2000 modèles étaient déjà utilisés chez Sber. Il ne suffit pas de développer un modèle, il faut s'intégrer aux systèmes industriels, développer des vitrines de données pour la construction des modèles, et assurer le contrôle de son fonctionnement dans le cluster.
Notre équipe développe la plateforme Sber.DS. Elle permet de résoudre des problèmes d'apprentissage automatique, accélère le processus de vérification des hypothèses, simplifie fondamentalement le processus de développement et de validation des modèles, tout en contrôlant le résultat du travail du modèle en production.
Pour ne pas décevoir vos attentes, je tiens à dire à l'avance que ce post est une introduction, et que dans la suite, nous parlerons de ce qui se cache derrière la plateforme Sber.DS. L'histoire du cycle de vie du modèle, de sa création à sa mise en œuvre, sera abordée séparément.
Sber.DS se compose de plusieurs composants, dont les clés sont une bibliothèque, un système de développement et un système d'exécution de modèles.
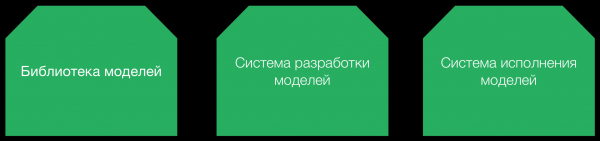
La bibliothèque contrôle le cycle de vie du modèle depuis l'émergence de l'idée de le développer jusqu'à sa mise en œuvre en production, sa mise sous surveillance et son retrait. De nombreuses fonctionnalités de la bibliothèque sont dictées par les règles du régulateur, comme le reporting et le stockage des ensembles de données d'apprentissage et de validation. En fait, c'est le registre de tous nos modèles.
Le système de développement est destiné à la conception visuelle de modèles et de méthodologies de validation. Les modèles développés passent par une validation initiale et sont fournis au système d'exécution pour remplir leurs fonctions commerciales. Dans le système d'exécution, le modèle peut également être placé sous surveillance pour effectuer périodiquement des validations afin de contrôler son fonctionnement.
Le système comprend plusieurs types de nœuds. Certains sont conçus pour se connecter à différentes sources de données, d'autres pour transformer les données sources et les enrichir (marquage). Il existe de nombreux nœuds pour construire divers modèles et des nœuds pour leur validation. Le développeur peut charger des données à partir de n'importe quelle source, les transformer, les filtrer, visualiser les données intermédiaires et les segmenter.
La plateforme contient également des modules prêts à l'emploi qui peuvent être glissés-déposés dans la zone de projet. Toutes les actions sont réalisées à l'aide d'une interface visualisée. En fait, il est possible de résoudre un problème sans écrire une seule ligne de code.
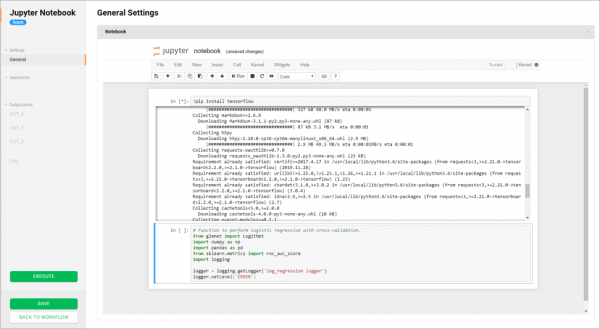
Si les possibilités intégrées ne suffisent pas, le système offre la possibilité de créer rapidement des modules personnalisés. Nous avons mis en place un mode de développement intégré basé sur pour ceux qui créent de nouveaux modules « à partir de zéro ».
L'architecture Sber.DS est construite sur des microservices. Il y a de nombreuses opinions sur la définition des microservices. Certains estiment qu'il suffit de diviser le code monolithique en morceaux, mais ils accèdent cependant tous à la même base de données. Chez nous, un microservice doit communiquer avec un autre microservice uniquement par l'API REST. Aucun accès direct à la base de données par des moyens détournés.
Nous veillons à ce que les services ne deviennent pas trop volumineux et rigides : une instance ne doit pas consommer plus de 4 à 8 Go de mémoire vive et doit garantir la possibilité d'un redimensionnement horizontal des requêtes en lançant de nouvelles instances. Chaque service communique avec d'autres uniquement via l'API REST (). L'équipe responsable du service doit maintenir la compatibilité ascendante de l'API pour le dernier client qui l'utilise.
Le cœur de l'application est écrit en Java en utilisant le Spring Framework. La solution a été initialement conçue pour un déploiement rapide dans une infrastructure cloud, c'est pourquoi l'application est construite en utilisant un système de conteneurisation (). La plateforme évolue constamment, tant en ce qui concerne l'expansion des fonctionnalités commerciales (de nouveaux connecteurs, AutoML) que sur le plan de l'efficacité technologique.
L'un des atouts de notre plateforme est que nous pouvons exécuter du code développé dans une interface visuelle sur n'importe quel système d'exécution de modèles de Sberbank. À présent, il y en a deux : un sur Hadoop et l'autre sur OpenShift (Docker). Nous ne nous arrêtons pas là et créons des modules d'intégration pour exécuter du code sur n'importe quelle infrastructure, y compris sur site et dans le cloud. Concernant les capacités d'intégration efficace dans l'écosystème de Sberbank, nous prévoyons également de prendre en charge les environnements d'exécution existants. À terme, la solution pourra être intégrée de manière flexible « clé en main » dans n'importe quel paysage organisationnel.
Ceux qui ont déjà essayé de maintenir une solution exécutant Python sur Hadoop dans un environnement de production savent qu'il ne suffit pas de préparer et de livrer un environnement utilisateur Python à chaque nœud de données. Un grand nombre de bibliothèques C/C++ pour l'apprentissage automatique utilisant des modules Python ne vous laisseront pas en paix. Il ne faut pas oublier de mettre à jour les paquets lors de l'ajout de nouvelles bibliothèques ou serveurs, tout en préservant la compatibilité ascendante avec le code des modèles déjà déployés.
Il existe plusieurs approches pour y parvenir. Par exemple, préparer à l'avance plusieurs bibliothèques couramment utilisées et les intégrer dans l'environnement de production. Dans la distribution Hadoop de Cloudera, on utilise généralement . De plus, Hadoop permet maintenant de lancer des -conteneurs. Dans certains cas simples, il est possible de livrer le code avec le paquet .
La banque accorde une grande importance à la sécurité de l'exécution de code tiers, c'est pourquoi nous profitons au maximum des nouvelles fonctionnalités du noyau Linux, où un processus exécuté dans un environnement isolé , peut être restreint, par exemple, en ce qui concerne l'accès au réseau et au disque local, ce qui réduit considérablement les capacités du code malveillant. Les domaines de données de chaque département sont protégés et accessibles uniquement à leurs propriétaires. La plateforme garantit que les données d'un domaine ne peuvent accéder à un autre domaine qu'à travers un processus de publication de données, contrôlé à toutes les étapes, depuis l'accès aux sources jusqu'à la transmission des données dans l'espace de destination.
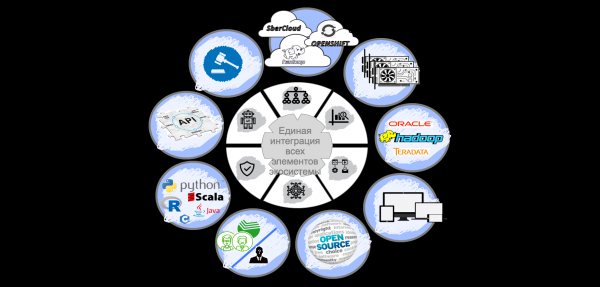
Cette année, nous prévoyons de finaliser le MVP du lancement de modèles écrits en Python/R/Java sur Hadoop. Nous nous sommes fixés un objectif ambitieux d'apprendre à exécuter n'importe quel environnement utilisateur sur Hadoop, afin de ne pas limiter les utilisateurs de notre plateforme.
De plus, il s'est avéré que de nombreux spécialistes en DS connaissent parfaitement les mathématiques et les statistiques, créent des modèles performants, mais comprennent moins bien les transformations de grandes données, ce qui nécessite l'aide de nos ingénieurs de données pour préparer les ensembles d'apprentissage. Nous avons décidé d'aider nos collègues et de créer des modules pratiques pour la transformation type et la préparation des fonctionnalités pour les modèles basés sur le moteur Spark. Cela permettra de consacrer plus de temps au développement de modèles sans attendre que les ingénieurs de données préparent un nouvel ensemble de données.
Nous avons des collaborateurs possédant des compétences dans divers domaines : Linux et DevOps, Hadoop et Spark, Java et Spring, Scala et Akka, OpenShift et Kubernetes. La prochaine fois, nous parlerons de la bibliothèque de modèles, du cycle de vie des modèles au sein de l'entreprise, ainsi que de la validation et de la mise en œuvre.
Source : habr.com
