

Je vous invite à consulter la transcription de la présentation d'Alexander Sigachev sur la découverte de services dans les systèmes distribués, en prenant Consul comme exemple.
La découverte de services est conçue pour connecter une nouvelle application dans notre environnement existant avec un minimum de coûts. En utilisant la découverte de services, nous pouvons séparer au maximum un conteneur sous forme de Docker ou un service virtuel de l'environnement dans lequel il est lancé.
Bonjour à tous ! Je suis Alexander Sigachev, je travaille chez Inventos. Aujourd'hui, je vais vous présenter le concept de découverte de services. Nous allons examiner la découverte de services en prenant Consul comme exemple.
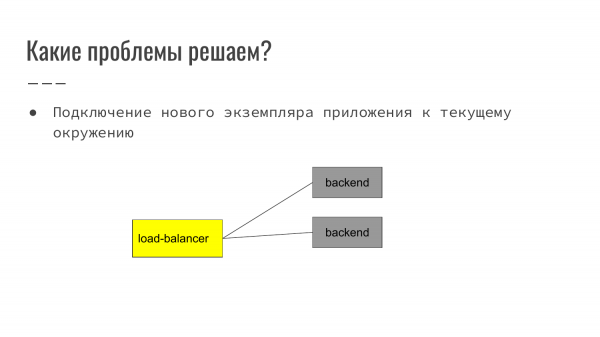
Quels problèmes la découverte de services résout-elle ? La découverte de services est conçue pour connecter une nouvelle application dans notre environnement existant avec un minimum de coûts. En utilisant la découverte de services, nous pouvons séparer au maximum un conteneur sous forme de Docker ou un service virtuel de l'environnement dans lequel il est lancé.
À quoi cela ressemble-t-il ?Prenons un exemple classique sur le web : un frontend qui reçoit une requête utilisateur. Ensuite, il effectue la routage vers le backend. Dans cet exemple, un load-balancer équilibre entre deux backends.
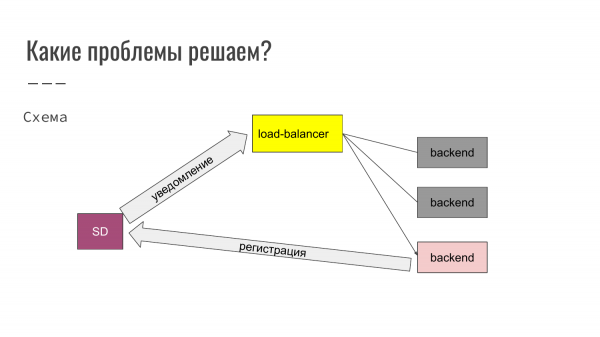
Ici, nous voyons que nous lancions un troisième exemplaire de l'application. Lorsque l'application est lancée, elle s'inscrit dans la découverte de services. La découverte de services informe le load-balancer. Le load-balancer modifie automatiquement sa configuration et le nouveau backend commence à fonctionner. Ainsi, des backends peuvent être ajoutés ou, au contraire, exclus du fonctionnement.
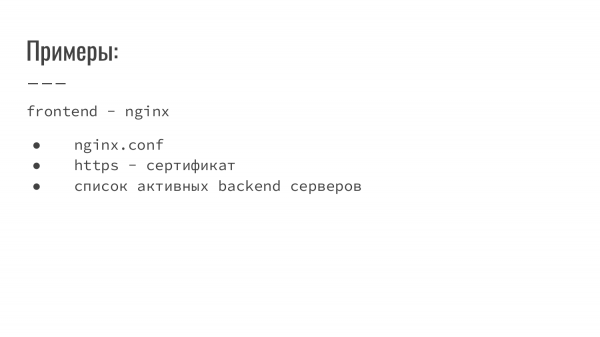
Que peut-on encore faire confortablement grâce à la découverte de services ? Dans la découverte de services, il est possible de stocker des configurations nginx, des certificats, et une liste de serveurs backend actifs.
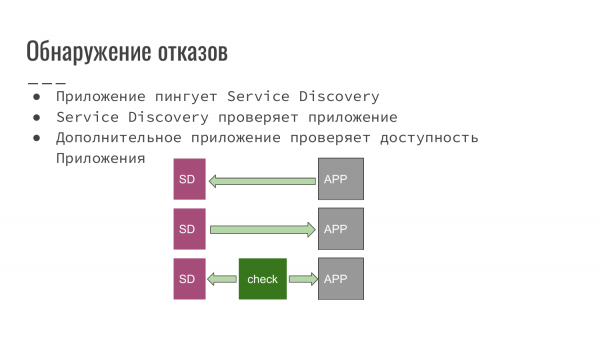 La découverte de services permet également de détecter des pannes et d'identifier des défaillances. Quelles pourraient être les schémas de détection des pannes ?
- Cette application que nous avons développée informe elle-même la découverte de services qu'elle est toujours opérationnelle.
- De son côté, la découverte de services interroge l'application sur sa disponibilité.
- Un script ou une application tiers peut aussi être utilisé pour vérifier la disponibilité de notre application et informer la découverte de services que tout va bien et qu'on peut travailler ou, au contraire, que tout va mal et qu'il est nécessaire d'exclure cet exemplaire de l'application de l'équilibrage.
Chacune des configurations peut être appliquée en fonction du logiciel que nous utilisons. Par exemple, si nous venons de commencer à développer un nouveau projet, nous pouvons facilement mettre en place un système où notre application informe le Service Discovery. Alternativement, nous pouvons connecter le Service Discovery pour qu'il effectue une vérification.
En revanche, si l'application nous a été laissée en héritage ou a été développée par un tiers, alors la troisième option s'applique, où nous écrivons un gestionnaire, et tout cela se met en place automatiquement dans notre travail.
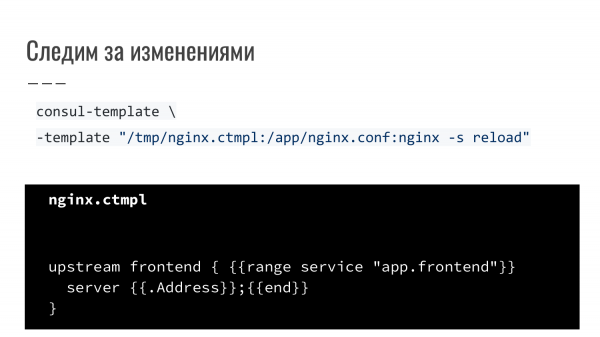
C'est un des exemples. Le load-balancer basé sur nginx redémarre. C'est un utilitaire supplémentaire qui est fourni avec Consul. C'est le consul-template. Nous décrivons une règle. Nous spécifions que nous utilisons un modèle (le moteur de template Golang). Lors des événements, lorsque des notifications d'un changement se produisent, il se régénère et un ordre « reload » est envoyé au Service Discovery. Un exemple simple, où nginx est reconfiguré et redémarré lors d'un événement.
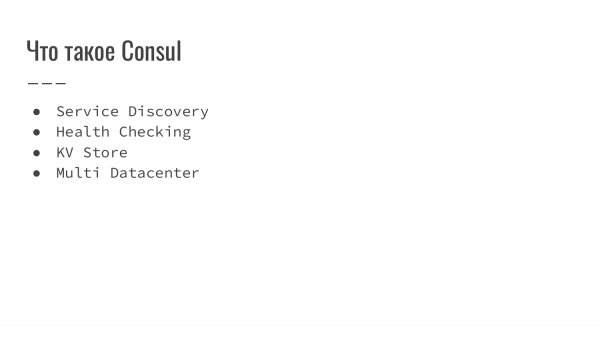
Qu'est-ce que Consul ?
Avant tout, c'est un Service Discovery.
Il dispose d'un mécanisme de vérification de disponibilité – le Health Checking.
Il a également un KV Store.
Et à sa base, il est conçu pour utiliser plusieurs centres de données.
À quoi tout cela peut-il servir ? Dans le KV Store, nous pouvons stocker des exemples de configurations. Le Health Checking nous permet de vérifier un service local et d'envoyer des notifications. Le Multi Datacenter est utilisé pour tracer une carte des services. Par exemple, Amazon possède plusieurs zones et dirige le trafic de manière optimale, afin d'éviter des requêtes superflues entre les centres de données, qui sont facturées séparément du trafic local et, par conséquent, présentent une latence moindre.
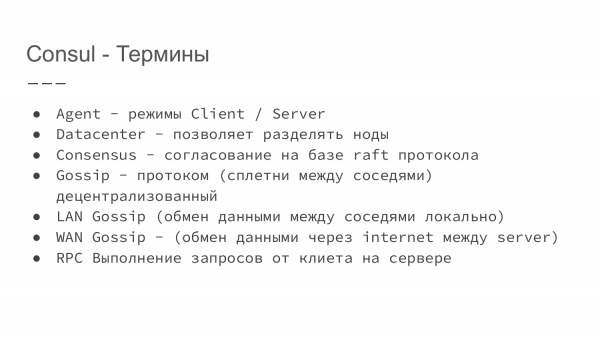
Voyons un peu les termes utilisés dans Consul.
- Consul est un service écrit en Go. Un des avantages des programmes en Go est qu'il s'agit d'un seul fichier binaire que vous pouvez simplement télécharger. Il suffit de le lancer depuis n'importe où et vous n'avez aucune dépendance.
- Ensuite, à l'aide des clés, nous pouvons lancer ce service soit en mode client, soit en mode serveur.
- De plus, l'attribut « datacenter » permet d'indiquer à quel centre de données appartient ce serveur.
- Le Consensus est basé sur le protocole Raft. Si cela intéresse quelqu'un, on peut en lire plus en détail sur le site de Consul. C'est un protocole qui permet de déterminer un leader et de définir quelles données considérer comme valides et accessibles.
- Gossip est un protocole qui assure l'interaction entre les nœuds. De plus, ce système est décentralisé. Au sein d'un même centre de données, tous les nœuds communiquent avec leurs voisins. Par conséquent, les informations sur l'état actuel sont échangées. On peut dire que ce sont des rumeurs entre voisins.
- LAN Gossip – échange local de données entre voisins au sein d'un même centre de données.
- WAN Gossip – utilisé lorsque nous devons synchroniser des informations entre deux centres de données. Les informations circulent entre les nœuds marqués comme serveurs.
- RPC – permet d'effectuer des requêtes via un client sur le serveur.
Description de RPC. Supposons qu'un client Consul est en cours d'exécution sur une machine virtuelle ou un serveur physique. Nous l'interrogeons localement. Ensuite, le client local demande des informations au serveur et se synchronise. Selon les configurations, les informations peuvent provenir du cache local ou être synchronisées avec le leader, le maître du serveur.
Ces deux schémas ont des avantages et des inconvénients. Si nous travaillons avec un cache local, cela est rapide. Si nous traitons des données stockées sur le serveur, cela prend plus de temps, mais nous obtenons des informations plus récentes.
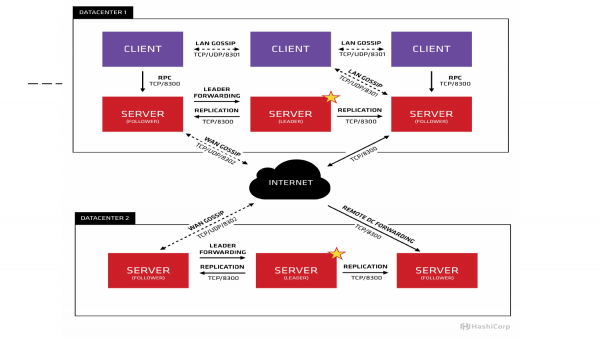
Si l'on visualise cela graphiquement, voici une image du site. Nous voyons que trois maîtres sont en cours d'exécution. L'un est marqué comme leader. Dans cet exemple, trois clients échangent localement des informations via UDP/TCP. Les informations entre les centres de données sont transférées entre les serveurs. Ici, les clients interagissent localement.
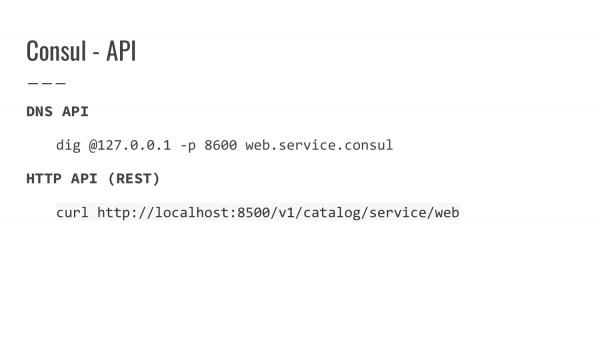
Quelle API fournit Consul ? Pour obtenir des informations, Consul propose deux types d'API.
C'est l'API DNS. Par défaut, Consul s'exécute sur le port 8600. Nous pouvons configurer le proxy pour accéder via le résolveur local, grâce au DNS local. Nous pouvons faire une requête par domaine et obtenir en réponse des informations sur l'adresse IP.
API HTTP – soit nous pouvons localement faire une requête sur le port 8500 pour obtenir des informations sur un service particulier et obtenir une réponse JSON indiquant quelle IP a le serveur, quel hôte, quel port est enregistré. Des informations supplémentaires peuvent être transmises via un token.
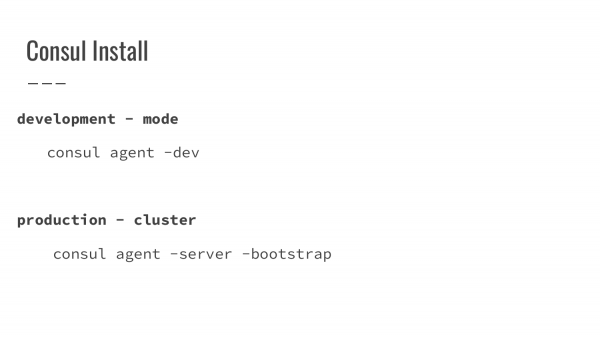
Que faut-il pour démarrer Consul ?
Dans la première option, nous spécifions un indicateur en mode développeur, indiquant qu'il s'agit d'un mode développeur. L'Agent démarre en tant que serveur et exécute toute la fonction de manière autonome sur une seule machine. C'est pratique, rapide et il n'est pratiquement pas nécessaire de faire des réglages supplémentaires pour le premier démarrage.
Le deuxième mode est le lancement en production. Ici, le démarrage est un peu plus compliqué. Si nous n'avons pas de version du consul, nous devons démarrer la première machine en mode bootstrap, c'est-à-dire la machine qui assumera les responsabilités de leader. Nous la lançons, puis nous mettons en place un deuxième serveur en lui fournissant les informations sur l'emplacement du maître. Puis nous démarrons le troisième. Une fois que nous avons trois machines opérationnelles, nous redémarrons la première machine à partir de Bootstrap en mode normal. Les données sont synchronisées, et le cluster initial est déjà établi.
Il est recommandé de faire fonctionner de trois à sept instances en mode serveur. Cela est dû au fait que si le nombre de serveurs augmente, le temps nécessaire à la synchronisation des informations entre eux s'allonge. Le nombre de nœuds doit être impair pour garantir le quorum.
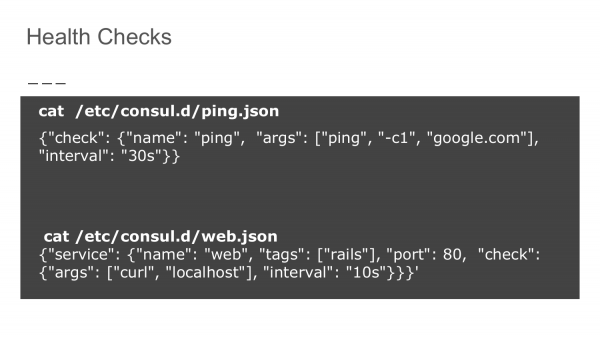
Comment les vérifications de santé sont-elles assurées ? Dans le répertoire de configuration de Consul, nous écrivons une règle de vérification au format Json. La première option consiste à vérifier la disponibilité, dans cet exemple, du domaine google.com. Nous indiquons qu'une vérification doit être effectuée toutes les 30 secondes. Ainsi, nous vérifions que notre nœud a accès à l'extérieur.
La deuxième option est de se vérifier soi-même. Nous utilisons simplement curl pour interroger localhost sur le port spécifié à un intervalle de 10 secondes.
Ces vérifications sont cumulées et envoyées au Service Discovery. En fonction de la disponibilité, ces nœuds sont soit exclus, soit ajoutés à la liste des machines disponibles et fonctionnant correctement.
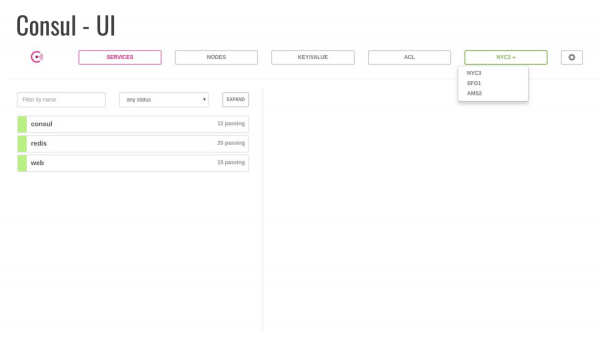
Consul fournit également une interface utilisateur qui est lancée avec un drapeau spécifique et sera accessible sur la machine. Cela permet de visualiser les informations et d'apporter certaines modifications.
Dans cet exemple, l'onglet « Service » est ouvert. Il montre que trois services sont en cours d'exécution, dont un est Consul. Le nombre de vérifications effectuées est affiché. Et il y a trois centres de données dans lesquels se situent les machines.
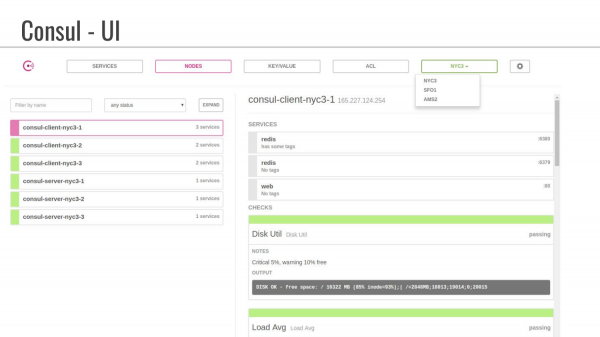
Ceci est un exemple d'onglet « Nodes ». Nous constatons qu'ils ont des noms composés impliquant des centres de données. Il montre également quels services sont en cours d'exécution, c'est-à-dire que nous voyons que les balises ne sont pas définies. Dans ces balises supplémentaires, il est possible d'indiquer certaines informations que le développeur peut utiliser pour spécifier des paramètres supplémentaires.
Il est également possible de transmettre des informations à Consul sur l'état des disques, sur la charge moyenne.
Questions
Question : Nous avons un conteneur Docker, comment l'utiliser avec Consul ?
Réponse : Pour le conteneur Docker, il existe plusieurs approches. L'une des plus courantes consiste à utiliser un conteneur Docker tiers chargé de l'enregistrement. Lors du démarrage, il reçoit le socket Docker. Tous les événements d'enregistrement et de dépublication du conteneur sont consignés dans Consul.
Question : C'est-à-dire que Consul démarre lui-même le conteneur Docker ?
Réponse : Non. Nous démarrons le conteneur Docker. Et lors de la configuration, nous indiquons – écoute ce socket. C'est à peu près comme avec un certificat, quand nous transmettons des informations sur où se trouvent nos fichiers.
Question : Cela signifie-t-il qu'à l'intérieur du conteneur Docker que nous essayons de connecter au Service Discovery, il doit y avoir une certaine logique capable de fournir des données à Consul ?
Réponse : Pas tout à fait. Lorsqu'il démarre, nous transmettons des variables via des variables d'environnement. Par exemple, le nom du service, le port du service. Le registre écoute ces informations et les insère dans Consul.
Question : J'ai encore une question au sujet de l'interface utilisateur. Nous avons déployé l'UI, disons, sur le serveur de production. Qu'en est-il de la sécurité ? Où sont stockées les données ? Est-il possible de regrouper les données ?
Réponse : Dans l'UI, les données proviennent de la base et du Service Discovery. Nous définissons nous-mêmes les mots de passe dans les paramètres.
Question : Peut-on publier cela sur Internet ?
Réponse : Par défaut, Consul démarre sur localhost. Pour le publier sur Internet, il faudra mettre en place un proxy. Nous sommes responsables des règles de sécurité.
Question : Fournit-il des données historiques par défaut ? Je suis intéressé par les statistiques des vérifications de santé. On peut diagnostiquer des problèmes si le serveur tombe souvent.
Réponse : Je ne suis pas sûr qu'il y ait des détails sur les vérifications.
Question : Ce n'est pas tant l'état actuel qui est important, mais la dynamique.
Réponse : Pour l'analyse – oui.
Question : Il vaut mieux ne pas utiliser Consul pour le Service Discovery de Docker ?
Réponse : Je ne le recommanderais pas. L'objectif de la présentation est de vous familiariser avec ce concept. Historiquement, il a parcouru un chemin, me semble-t-il, jusqu'à la première version. Il existe maintenant des solutions plus complètes, comme Kubernetes, qui intègre tout cela en interne. Dans Kubernetes, la découverte de services cède la place à Etcd. Mais je ne le connais pas aussi bien que Consul. C'est pourquoi j'ai décidé de faire un exemple de découverte de services avec Consul.
Question : Le schéma avec le serveur leader ralentit-il le démarrage de l'application dans son ensemble ? Et comment Consul détermine-t-il un nouveau leader, si celui-ci est hors ligne ?
Réponse : Ils ont décrit un protocole complet. Si cela vous intéresse, vous pouvez le lire.
Question : Consul fonctionne-t-il comme un serveur complet et toutes les requêtes passent-elles par lui ?
Réponse : Il n'agit pas comme un serveur complet, mais prend une certaine zone. Celle-ci se termine généralement par service.consul. Et ensuite, nous suivons la logique. Nous n'utilisons pas de noms de domaine en production, mais plutôt une infrastructure interne, qui est généralement cachée derrière le cache du serveur, si nous travaillons via DNS.
Question : Donc, si nous voulons accéder à la base de données, nous devrons nécessairement passer par Consul pour d'abord trouver cette base, n'est-ce pas ?
Réponse : Oui. Si nous travaillons via DNS, cela fonctionne comme sans Consul, lorsque nous utilisons des noms DNS. En général, les applications modernes ne font pas de requête pour chaque nom de domaine, car nous avons établi la connexion, tout fonctionne et dans un avenir proche, nous ne l'utilisons pratiquement plus. Si la connexion est rompue, alors oui, nous demandons à nouveau où se trouve la base et nous y allons.
— Chat des utilisateurs de Hashicorp : Consul, Nomad, Terraform
P.S. Concernant les vérifications d'état. Consul utilise, tout comme Kubernetes, un système de vérification de l'état de santé des services basé sur le code de statut.
200 OK pour sain
503 Service indisponible pour non sain
Sources :
Source : habr.com
