

Note de traduction.: Service mesh – un phénomène qui n'a pas encore de traduction stable en français (il y a plus de 2 ans, nous avions proposé l'expression « maillage de services », et peu après, certains collègues ont commencé à promouvoir activement la combinaison « tamis de service »). Les discussions constantes sur cette technologie ont conduit à une situation où les aspects marketing et techniques sont devenus étroitement imbriqués. Ce remarquable article, écrit par l'un des auteurs du terme original, vise à apporter de la clarté aux ingénieurs et au-delà.
Comic de
Introduction
Si vous êtes un ingénieur logiciel travaillant dans le domaine des systèmes backend, le terme « service mesh » s'est probablement solidement ancré dans votre esprit ces dernières années. Grâce à un étrange enchaînement des circonstances, cette expression prend de plus en plus d'ampleur dans l'industrie, et le buzz ainsi que les propositions commerciales qui l'entourent augmentent comme une boule de neige roulant sur une pente, sans aucun signe de ralentissement.
Le service mesh est né dans les eaux troubles et tendancieuses de l'écosystème cloud natif. Malheureusement, cela signifie qu'une grande partie des discussions qui l'entourent varie de « bavardage à faible teneur calorique » à — pour utiliser un terme technique — un véritable non-sens. Mais si l'on filtre tout ce bruit, on peut découvrir que le service mesh a une fonction réelle, définie et importante.
Dans cette publication, je vais m'efforcer de faire précisément cela : présenter un guide honnête, approfondi et axé sur les ingénieurs concernant le service mesh. Je vais répondre non seulement à la question : « Qu'est-ce que c'est ? », — mais aussi « Pourquoi ? », ainsi que « Pourquoi maintenant ? ». Enfin, je vais tenter de décrire pourquoi (à mon avis) cette technologie en particulier a suscité un tel engouement, ce qui est en soi une histoire intéressante.
Qui suis-je ?
Bonjour à tous ! Je m'appelle . Je suis l'un des créateurs de — le tout premier projet de service mesh et le projet qui est à l'origine de l'émergence du terme service mesh en tant que tel (désolé les gars !). (Traduction prim.: À propos, à l'aube de ce terme, il y a plus de 2,5 ans, nous avions déjà traduit un précédent article du même auteur intitulé «».) Je dirige également — une startup qui crée des choses aussi cool que des service mesh comme Linkerd et .
Vous vous doutez probablement que j'ai un avis plutôt subjectif et biaisé sur la question. Cependant, je vais m'efforcer de réduire la partialité au minimum (à l'exception d'une section : « Pourquoi y a-t-il tant de discussions autour des service meshes ? », dans laquelle je partagerai tout de même mes idées préconçues). Je ferai également tout mon possible pour rendre ce guide aussi objectif que possible. Dans des exemples concrets, je m'appuierai principalement sur l'expérience de Linkerd, tout en signalant les différences que je connais (s'il y en a) dans la mise en œuvre d'autres types de service meshes.
D'accord, passons aux choses intéressantes.
Qu'est-ce qu'un service mesh ?
Malgré tout le battage, la structure d'un service mesh est assez simple. C'est juste un tas de proxies en espace utilisateur situés « à proximité » des services (nous parlerons un peu plus tard de ce que signifie « à proximité »), plus un ensemble de processus de gestion. Les proxies dans leur ensemble sont appelés data plane, tandis que les processus de gestion sont appelés control plane. Le data plane intercepte les appels entre les services et effectue avec eux « diverses actions » ; le control plane, en conséquence, coordonne le comportement des proxies et fournit à vous, c'est-à-dire à l'opérateur, un accès à l'API, permettant de manipuler le réseau et de le mesurer comme un tout.
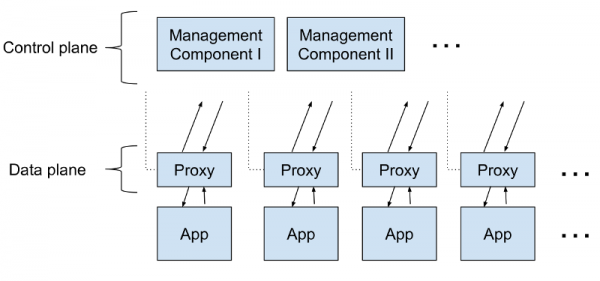
Qu'est-ce que c'est que ces proxies ? Ce sont des proxies TCP de catégorie « Layer 7-aware » c'est-à-dire « tenant compte » du niveau 7 du modèle OSI, comme HAProxy et NGINX. Vous pouvez choisir le proxy à votre goût ; Linkerd utilise un proxy en Rust, sobrement nommé Nous l'avons créé spécialement pour le service mesh. D'autres meshes préfèrent d'autres proxies (Envoy est un choix fréquent). Cependant, le choix du proxy n'est qu'une question de mise en œuvre.
Que font ces serveurs proxy ? Évidemment, ils proxoient les appels vers les services et en provenance de ceux-ci (strictement parlant, ils exercent la fonction de proxy et de proxy inverse, traitant tant les appels entrants qu'optinants). Et ils implémentent un ensemble de fonctions, se concentrant sur les appels entre les services. Ce focus sur le trafic entre les services distingue le proxy des service meshes des, disons, passerelles API ou des proxies ingress (ces derniers se concentrent sur les appels entrants dans le cluster provenant du monde extérieur). (Note de traduction.: pour une comparaison des contrôleurs Ingress existants pour Kubernetes, beaucoup d'entre eux utilisant déjà le mentionné Envoy, voir .)
Ainsi, nous avons compris le data plane. Le control plane est plus simple : il s'agit d'un ensemble de composants qui fournissent toute la mécanique nécessaire au data plane pour fonctionner de manière coordonnée, y compris la découverte des services, la délivrance de certificats TLS, l'agrégation des métriques, etc. Le data plane informe le control plane de son comportement ; en retour, le control plane fournit une API permettant de modifier et de suivre le comportement du data plane comme un tout.
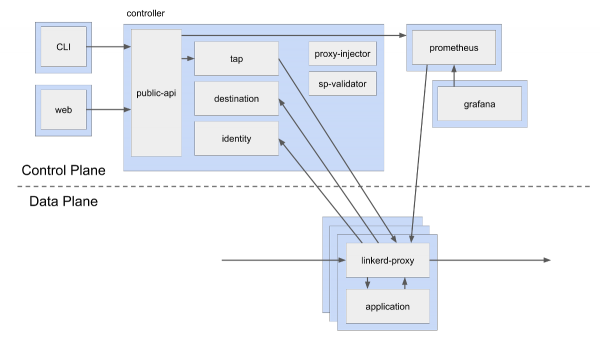
Voici le schéma du control plane et du data plane dans Linkerd. Comme vous pouvez le voir, le control plane comprend plusieurs composants différents, y compris une instance de Prometheus qui collecte des métriques auprès des serveurs proxy, ainsi que d'autres composants tels que destination (découverte des services), identity (centre de certification, CA) et public-api (endpoints pour web et CLI). En revanche, le data plane consiste en un simple linkerd-proxy à côté de l'instance de l'application. Il ne s'agit que d'un schéma logique ; dans des conditions réelles de déploiement, vous pourriez avoir trois répliques de chaque composant du control plane et des centaines ou des milliers de proxy dans le data plane.
(Les rectangles bleus sur ce schéma symbolisent les limites des pods Kubernetes. On voit que les conteneurs avec linkerd-proxy se trouvent dans le même pod que les conteneurs de l'application. Ce type de schéma est connu sous le nom de conteneur sidecar..)
L'architecture d'un service mesh a plusieurs conséquences importantes. Premièrement, comme la tâche du proxy est d'intercepter les appels entre les services, un service mesh n'a de sens que si votre application est construite sur un certain ensemble de services. Le mesh est possible peut être utilisé avec des monolithes, mais cela est manifestement superflu pour un seul proxy, et ses fonctionnalités seront probablement peu demandées.
Une autre conséquence importante est que le service mesh nécessite un nombre considérable de proxies. En réalité, Linkerd attache un linkerd-proxy à chaque instance de chaque service (d'autres implémentations ajoutent des proxies à chaque nœud/hôte/machine virtuelle. Quoi qu'il en soit, cela représente une charge importante). Cette utilisation active des proxies entraîne en elle-même plusieurs complications supplémentaires :
- Les proxies dans le data plane doivent être rapides, car chaque appel implique une paire d'appels au proxy : un côté client, un côté serveur.
- Les proxies doivent également être petits et légers.Chacun consommera des ressources mémoire et CPU, et cette consommation augmentera linéairement avec l'application.
- Vous aurez besoin d'un mécanisme pour déployer et mettre à jour un grand nombre de proxies. Le faire manuellement n'est pas une option.
En gros, le service mesh ressemble à ceci (du moins, vu de haut) : vous déployez une multitude de proxies en espace utilisateur qui « font quelque chose » avec le trafic interne entre services, et vous utilisez un plan de contrôle pour les surveiller et les gérer.
Il est temps de se poser la question « Pourquoi ? »
Pourquoi avoir besoin d'un service mesh ?
Il est compréhensible que ceux qui découvrent l'idée de service mesh ressentent un léger frisson. La structure du service mesh signifie qu'elle non seulement augmentera les latences dans l'application, mais aussi qu'elle va consommer des ressources et ajouter une multitude de nouveaux mécanismes à l'infrastructure. D'abord, vous installez le service mesh, puis vous vous rendez compte qu'il faut gérer des centaines (voire des milliers) de proxies. On peut se demander qui se portera volontaire pour cela ?
La réponse à cette question se divise en deux parties. D'une part, les coûts opérationnels liés au déploiement de ces proxies peuvent être considérablement réduits grâce à certains changements dans l'écosystème (plus de détails à ce sujet plus tard).
D'autre part, un tel dispositif est en réalité un excellent moyen d'introduire une logique supplémentaire dans le système. Et pas seulement parce qu'un service mesh permet d'ajouter de nombreuses nouvelles fonctions, mais aussi parce que cela peut être fait sans interférer avec l'écosystème. En réalité, tout le modèle de service mesh repose sur ce postulat : dans un système multi-services, peu importe ce que font les services individuels, le trafic entre eux est un point idéal pour ajouter des fonctionnalités.
Par exemple, dans Linkerd (comme dans la plupart des meshes), les fonctionnalités sont principalement axées sur les appels HTTP, y compris HTTP/2 et gRPC*. Les fonctionnalités sont assez riches — elles peuvent être divisées en trois classes :
- Fonctions liées à la fiabilité. Requêtes répétées, délais d'attente, approche canari (partitionnement/ redirection du trafic) etc.
- Fonctions liées à surveillance. Agrégation des indicateurs de succès, des délais et des volumes de requêtes pour chaque service ou chaque direction ; création de cartes topologiques des services, etc.
- Fonctions liées à la sécurité. Mutual TLS, contrôle d'accès, etc.
* D'un point de vue Linkerd, gRPC ne diffère pratiquement pas de HTTP/2 : il utilise simplement protobuf dans la charge utile. Du point de vue du développeur, ces deux choses diffèrent, bien sûr.
Beaucoup de ces mécanismes fonctionnent au niveau des requêtes (d'où le terme « proxy L7 »). Par exemple, si le service Foo envoie un appel HTTP au service Bar, le linkerd-proxy du côté de Foo peut effectuer un équilibrage de charge intelligent et diriger les appels de Foo vers les instances de Bar en fonction de la latence observée ; il peut également redémarrer la requête si nécessaire (et si elle est idempotente) ; il peut enregistrer le code de réponse et le temps d'attente, etc. De la même manière, le linkerd-proxy du côté de Bar peut rejeter la requête si elle n'est pas autorisée ou si la limite de requêtes est dépassée ; il peut enregistrer la latence de son côté, etc.
Les proxies peuvent également « faire quelque chose » au niveau de la connexion. Par exemple, le linkerd-proxy du côté de Foo peut initier une connexion TLS, tandis que le linkerd-proxy du côté de Bar peut la rompre, et les deux parties peuvent vérifier les certificats TLS l'une de l'autre. Cela assure non seulement le chiffrement entre les services, mais aussi un moyen cryptographiquement sûr d'identifier les services : Foo et Bar peuvent « prouver » qu'ils sont bien ceux qu'ils prétendent être.
* « L'un l'autre » signifie que le certificat du client est également vérifié (mutual TLS). Dans le TLS « classique », par exemple entre un navigateur et un serveur, seul le certificat d'une partie (serveur) est généralement vérifié.
Que ce soit au niveau des requêtes ou des connexions, il est important de souligner que toutes les fonctionnalités de la service mesh sont opérationnelles. Linkerd n'est pas capable de transformer la sémantique de la charge utile — par exemple, d'ajouter des champs dans un fragment JSON ou de modifier du protobuf. Nous discuterons de cette caractéristique importante plus tard, lorsqu'il sera question de l'ESB et des middleware.
Voici l'ensemble des fonctionnalités qu'offre la service mesh. La question se pose : pourquoi ne pas les implémenter directement dans l'application ? Et pourquoi s'embêter avec un proxy ?
Pourquoi la service mesh est-elle une bonne idée ?
Bien que les capacités de la service mesh captivent l'imagination, sa véritable valeur réside en réalité non pas dans les fonctionnalités. Au final, nous pouvons les réaliser directement dans l'application (nous verrons plus tard que c'était l'origine du service mesh). Si l'on devait exprimer cette idée en une seule phrase, la valeur du service mesh réside dans les éléments suivants : il fournit des fonctions cruciales pour le fonctionnement des logiciels serveurs modernes, de manière uniforme pour toute la pile et indépendante du code de l'application.
Analysons cette phrase.
«Fonctions cruciales pour le fonctionnement des logiciels serveurs modernes». Si vous développez une application serveur transactionnelle liée à Internet public, qui reçoit des requêtes du monde extérieur et y répond dans un court laps de temps — par exemple, une application web, un serveur API, et en fait la grande majorité des autres applications modernes — et si vous le réalisez comme un ensemble de services qui interagissent de manière synchrone, et si vous continuez à moderniser ce logiciel en ajoutant de nouvelles fonctionnalités, et si vous devez maintenir ce système opérationnel pendant le processus de modification — dans ce cas, félicitations, vous êtes en train de créer des logiciels serveurs modernes. Et toutes ces fonctions remarquables, énumérées ci-dessus, s'avèrent en réalité cruciales pour vous. L'application doit être fiable, sécurisée, et vous devez pouvoir surveiller ce qu'elle fait. C'est précisément ces questions que le service mesh aide à résoudre.
(D'accord, ma conviction que cette approche est une façon moderne de créer des logiciels serveurs s'est malgré tout glissée dans le paragraphe précédent. D'autres préfèrent développer des monolithes, des « microservices réactifs » et d'autres choses qui ne correspondent pas à la définition ci-dessus. Ces personnes ont sûrement leur propre opinion, différente de la mienne. Pour ma part, je pense qu'elles « ont tort » — bien que dans tous les cas, le service mesh ne leur soit pas très utile).
«Uniforme pour toute la pile». Les fonctions fournies par le service mesh ne sont pas seulement cruciales. Elles s'appliquent à tous les services de l'application, peu importe dans quel langage ils sont écrits, quel framework est utilisé, qui les a écrits, comment ils ont été déployés et toutes les autres subtilités de leur développement et application.
«Indépendant du code de l'applicationEnfin, le service mesh ne fournit pas seulement des fonctionnalités uniformes pour l'ensemble de la pile, mais le fait d'une manière qui ne nécessite pas de modification de l'application. La base fondamentale des fonctionnalités du service mesh, y compris les tâches de configuration, de mise à jour, d'exploitation, de maintenance, etc., se trouve exclusivement au niveau de la plateforme et est indépendante de l'application. L'application peut changer sans affecter le service mesh. Inversement, le service mesh peut évoluer sans aucune implication de l'application.
En d'autres termes, le service mesh ne fournit pas seulement des fonctions essentielles, mais le fait d'une manière globale, uniforme et indépendante de l'application. Ainsi, bien que les fonctionnalités du service mesh puissent être mises en œuvre dans le code du service (par exemple, sous forme de bibliothèque intégrée à chaque service), cette approche ne garantira pas l'homogénéité et l'indépendance si précieuses dans le cas du service mesh.
Et tout ce dont vous avez besoin pour cela, c'est d'ajouter quelques proxies ! Je vous promets, très bientôt, nous examinerons les coûts opérationnels associés à l'ajout de ces proxies. Mais d'abord, faisons une pause et examinons cette idée d'indépendance d'un point de vue différent. les humains.
À qui le service mesh est-il utile ?
Aussi désagréable que cela puisse être, pour qu'une technologie devienne une partie intégrante de l'écosystème, elle doit être adoptée par les gens. Alors qui est vraiment intéressé par le service mesh ? Qui en bénéficie ?
Si vous développez des logiciels serveur modernes, vous pouvez approximativement envisager votre équipe comme un groupe de propriétaires de services, qui conçoivent et mettent en œuvre ensemble la logique commerciale, et des propriétaires de plateforme, s'occupant du développement de la plateforme interne sur laquelle ces services fonctionnent. Dans les petites organisations, ce peut être les mêmes personnes, mais avec la croissance de l'entreprise, ces rôles ont tendance à se distinguer et à même se diviser en sous-rôles… (Il y a beaucoup à dire sur la nature changeante de DevOps, l'influence organisationnelle des microservices, etc. Mais pour l'instant, acceptons ces descriptions comme données).
Sous cet angle, les bénéficiaires évidents du service mesh sont les propriétaires de la plateforme. En fin de compte, l'objectif de l'équipe de la plateforme est de créer une plateforme interne où les propriétaires de services peuvent implémenter la logique métier de manière à garantir leur indépendance maximale vis-à-vis des détails obscurs de son exploitation. Le service mesh n'offre pas seulement des capacités qui sont critiques pour atteindre cet objectif : il le fait d'une manière qui n'impose pas de dépendances aux propriétaires de services.
Les propriétaires de services en bénéficient également, bien que de manière plus indirecte. L'objectif du propriétaire de service est d'être le plus productif possible dans l'implémentation de la logique des processus métier, et moins il a à se soucier des questions d'exploitation, mieux c'est. Au lieu de se préoccuper de la mise en œuvre, disons, des politiques de réessai ou de TLS, ils peuvent se concentrer exclusivement sur des tâches liées aux affaires et espérer que la plateforme s'occupe du reste. C'est un grand avantage pour eux.
Il est difficile de surestimer la valeur organisationnelle d'une telle séparation entre les propriétaires de plateformes et de services. Je pense qu'elle contribue le domaine principal à la valeur du service mesh.
Nous avons appris cette leçon lorsque l'un des premiers partisans de Linkerd nous a expliqué pourquoi ils ont choisi le service mesh : parce qu'il leur a permis de « réduire le bavardage au minimum ». Voici quelques détails : des gars d'une grande entreprise ont migré leur plateforme vers Kubernetes. Étant donné que l'application traitait des informations sensibles, ils voulaient chiffrer toutes les communications au sein des clusters. Cependant, la situation était compliquée par la présence de centaines de services et de centaines d'équipes de développeurs. La perspective de devoir contacter tout le monde pour les convaincre d'intégrer le support TLS dans leurs projets ne les enchantaient pas du tout. En déployant Linkerd, ils ont transféré la responsabilité des développeurs (pour qui cela représentait des tracas inutiles) vers les développeurs de la plateforme, pour qui c'était une priorité de premier ordre. En d'autres termes, Linkerd a résolu pour eux non seulement un problème technique mais aussi un problème organisationnel.
En bref, le service mesh est davantage une solution à un problème socio-technique. (Merci Cindy Sridharan Le service mesh résoudra-t-il tous mes problèmes ?
Un service mesh résoudra-t-il tous mes problèmes ?
Oui. En fait, non !
Si l'on considère les trois classes de fonctionnalités énoncées ci-dessus : la fiabilité, la sécurité et l'observabilité, il devient clair que le service mesh n'est pas une solution complète à aucun de ces problèmes. Bien que Linkerd puisse renvoyer des requêtes (s'il sait qu'elles sont idempotentes), il ne peut pas prendre de décisions sur ce qu'il faut retourner à l'utilisateur si le service est complètement tombé — ces décisions doivent être prises par l'application. Linkerd peut suivre les statistiques des requêtes réussies, mais il ne peut pas plonger dans le service et fournir ses métriques internes — de tels outils doivent être intégrés dans l'application. Et bien que Linkerd soit capable de gérer mTLS, des solutions complètes pour garantir la sécurité nécessitent beaucoup plus.
Un sous-ensemble de fonctions dans ces domaines, proposé par le service mesh, concerne les fonctionnalités de la plateforme. Par cela, j'entends des fonctionnalités qui :
- Sont indépendantes de la logique métier. La manière dont les histogrammes des appels entre Foo et Bar sont construits ne dépend absolument pas de ce que pourquoi Foo appelle Bar.
- Il est difficile de bien implémenter. Dans Linkerd, les tentatives de répétition sont paramétrées par toutes sortes de mécanismes sophistiqués comme les budgets de répétition (retry budgets), car une approche simple pour mettre en œuvre de telles choses entraînerait inévitablement ce qu'on appelle "l'avalanche de requêtes" (retry storm) et d'autres problèmes communs dans les systèmes distribués.
- Elles sont les plus efficaces lorsqu'elles sont appliquées de manière cohérente. Le mécanisme TLS n'a de sens que s'il est appliqué partout.
Étant donné que ces fonctions sont mises en œuvre au niveau du proxy (et non au niveau de l'application), le service mesh les fournit au niveau la plateforme, et non au niveau de l'application. Ainsi, peu importe dans quel langage les services sont écrits, quel cadre ils utilisent, qui les a écrits et pourquoi. Les proxies fonctionnent en dehors de tous ces détails, et la base fondamentale de cette fonctionnalité, y compris les tâches de configuration, de mise à jour, d'exploitation, de maintenance, etc., repose exclusivement au niveau de la plateforme.
Exemples de capacités du service mesh
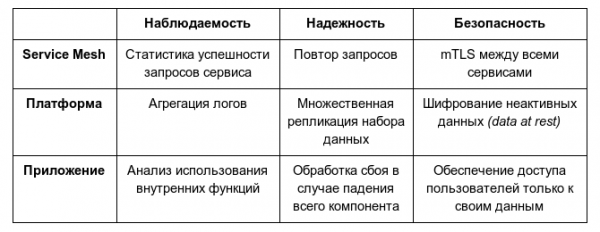
Pour conclure, je tiens à dire que le service mesh n'est pas une solution complète pour garantir la fiabilité, l'observabilité ou la sécurité. L'ampleur de ces domaines implique une participation indispensable des propriétaires de services, des équipes Ops/SRE et d'autres parties prenantes de l'entreprise. Le service mesh ne fournit qu'un 'coup' au niveau de la plateforme pour chacun de ces domaines.
Pourquoi le service mesh est-il devenu populaire précisément maintenant ?
Vous vous demandez probablement en ce moment : d'accord, si le service mesh est si bon, pourquoi n'avons-nous pas commencé à déployer des millions de proxies dans nos architectures il y a dix ans ?
Il y a une réponse évidente à cette question : il y a dix ans, tout le monde construisait des monolithes, et personne n'avait besoin de service mesh. C'est vrai, mais à mon avis, cette réponse passe à côté du fond. Même il y a dix ans, le concept de microservices comme une manière prometteuse de construire des systèmes à grande échelle était largement discuté et appliqué dans des entreprises telles que Twitter, Facebook, Google et Netflix. La perception générale – du moins dans les secteurs de l'industrie avec lesquels j'ai été en contact – était que les microservices étaient la 'bonne façon' de créer de grands systèmes, même si cela était terriblement difficile.
Bien sûr, même si des entreprises utilisaient des microservices il y a dix ans, elles n'injectaient pas systématiquement des proxies partout pour former un service mesh. Cependant, si l'on regarde de près, elles faisaient quelque chose de similaire : dans beaucoup de ces entreprises, il était prescrit d'utiliser une bibliothèque interne spécifique pour les communications réseau (parfois appelée bibliothèque de client lourd, fat client library).
Netflix avait Hysterix, Google avait Stubby, Twitter avait la bibliothèque Finagle. Par exemple, Finagle était obligatoire pour chaque nouveau service chez Twitter. Elle gérait à la fois la partie client et la partie serveur des connexions, permettait de faire des requêtes répétitives, supportait le routage des requêtes, la répartition de charge et la surveillance. Elle fournissait une couche cohérente de fiabilité et d'observabilité pour toute la pile Twitter, peu importe ce que faisait le service. Bien sûr, elle ne fonctionnait que pour les langages JVM et reposait sur le modèle de programmation à utiliser pour l'ensemble de l'application. Cependant, ses fonctionnalités étaient presque identiques à celles du service mesh. (En réalité, la première version de Linkerd était simplement Finagle, enveloppé sous la forme d'un proxy.)
Ainsi, il y a dix ans, il existait non seulement des microservices, mais aussi des bibliothèques proto-service-mesh spécialisées, qui résolvaient les mêmes problèmes que le service mesh d'aujourd'hui. Toutefois, le service mesh lui-même n'existait pas à l'époque. Un autre changement devait se produire avant son apparition.
Et c'est ici que réside une réponse plus profonde, dissimulée dans une autre transformation survenue au cours des dix dernières années : une forte baisse des coûts de déploiement des microservices. Les entreprises mentionnées ci-dessus, qui utilisaient des microservices il y a dix ans : Twitter, Netflix, Facebook, Google, étaient des entreprises de très grande taille et disposant de ressources énormes. Elles avaient non seulement le besoin, mais également les moyens de créer, déployer et exploiter de grandes applications basées sur des microservices. L'énergie et les efforts déployés par les ingénieurs de Twitter pour passer d'une approche monolithique à une approche microservices sont tout simplement impressionnants. (Honnêtement, tout comme le fait que cela a réussi.) De tels manœuvres d'infrastructure étaient alors impossibles pour des entreprises de taille plus petite.
Transportons-nous dans le présent. Aujourd'hui, il existe des startups où le ratio microservices à développeurs est de 5:1 (ou même ), et de plus, elles s'en sortent avec succès ! Si une startup de 5 personnes peut, sans effort, exploiter 50 microservices, cela signifie que quelque chose a clairement réduit le coût de leur mise en œuvre.
1500 microservices chez Monzo ; chaque ligne est une règle réseau prescrite, autorisant le trafic
La forte baisse du coût d'exploitation des microservices résulte d'un unique processus : la montée en popularité des conteneurs et et des orchestrateurs. C'est là qu'est la réponse profonde à la question de ce qui a favorisé l'émergence du service mesh. La même technologie a rendu à la fois le service mesh et les microservices attrayants : Kubernetes et Docker.
Pourquoi ? Eh bien, Docker résout un grand problème – le problème de l'emballage. En encapsulant une application et ses dépendances d'exécution (non réseau) dans un conteneur, Docker transforme l'application en une unité interchangeable, pouvant être placée et exécutée n'importe où. En même temps, cela simplifie considérablement l'exploitation multilingue. Piles : puisque le conteneur est une unité atomique d'exécution, pour les besoins du déploiement et de l'exploitation, peu importe ce qu'il contient, que ce soit une application sur JVM, Node, Go, Python ou Ruby. Vous le démarrez, et c'est tout.
Kubernetes élève tout à un nouveau niveau. Maintenant qu'il y a une multitude de « choses exécutables » et de nombreuses machines sur lesquelles les exécuter, il existe un besoin d'un outil capable de les associer. En termes généraux, vous donnez à Kubernetes de nombreux conteneurs et de nombreuses machines, et il les associe (bien sûr, c'est un processus dynamique et en constante évolution : de nouveaux conteneurs se déplacent à travers le système, des machines sont mises sous tension et arrêtées, etc. Cependant, Kubernetes prend tout cela en compte).
Après la configuration de Kubernetes, le temps nécessaire pour déployer et exploiter un service est peu différent de celui requis pour déployer et exploiter dix services (en réalité, ils sont quasiment identiques, même pour 100 services). Ajoutez à cela des conteneurs comme mécanisme d'emballage qui encourage une mise en œuvre multilingue, et vous obtenez de nombreuses nouvelles applications mises en œuvre sous forme de microservices, écrites dans divers langages – précisément le type d'environnement pour lequel le service mesh est si bien adapté.
Ainsi, nous avons la réponse à la question de savoir pourquoi l'idée de service mesh a gagné en popularité précisément maintenant : l'homogénéité que Kubernetes offre pour les services s'applique directement aux défis opérationnels auxquels le service mesh est confronté. Vous empaquetez un proxy dans des conteneurs, vous demandez à Kubernetes de les coller où vous le souhaitez, et voilà ! Vous obtenez un service mesh, avec toutes les mécaniques de son déploiement gérées par Kubernetes. (Du moins, à vol d'oiseau. Bien sûr, ce processus présente de nombreuses nuances.)
En résumé : la raison pour laquelle le service mesh est devenu populaire précisément maintenant, et non il y a dix ans, est que Kubernetes et Docker ont non seulement considérablement augmenté la demande pour cela, simplifiant la mise en œuvre d'applications sous forme de lots de microservices multilingues, mais ils ont également considérablement réduit les coûts de son exploitation, en fournissant des mécanismes de déploiement et de support pour les parcs de proxies sidecar.
Pourquoi y a-t-il tant de discussion autour du service mesh ?
Avertissement: dans cette section, je vais recourir à toutes sortes d'hypothèses, de conjectures, de spéculations et d'informations internes.
En recherchant le terme « service mesh », vous tomberez sur un tas de contenu remanié à faible valeur ajoutée, des projets étranges et un kaléidoscope de distorsions, digne d'une chambre d'écho. Toute nouvelle technologie tendance est sujette à cela, mais dans le cas du service mesh, le problème est particulièrement aigu. Pourquoi ?
Eh bien, en partie c'est de ma faute. J'ai fait tout mon possible pour promouvoir Linkerd et le service mesh à chaque occasion, à travers d'innombrables publications de blog et d'articles comme celui-ci. Mais je ne suis pas si puissant. Pour vraiment répondre à cette question, il faut parler un peu de la situation générale. Et on ne peut pas en parler sans mentionner un projet : — service mesh open source, développé conjointement par Google, IBM et Lyft.
(Ces trois entreprises ont des rôles complètement différents : la participation de Lyft semble se limiter à son nom ; ils sont les auteurs d'Envoy, mais n'utilisent pas Istio ni ne participent à son développement. IBM participe au développement d'Istio et l'utilise. Google est activement impliqué dans le développement d'Istio, mais, autant que je peux en juger, ne l'utilise pas réellement.)
Le projet Istio se distingue par deux caractéristiques. Premièrement, ce sont les énormes efforts marketing qu'Google, en particulier, déploie pour sa promotion. À mon avis, la majorité des personnes au courant du concept de service mesh aujourd'hui en ont probablement entendu parler pour la première fois grâce à Istio. La deuxième caractéristique réside dans la manière dont Istio a été mal accueilli. Sur cette question, je suis évidemment un parti intéressé, mais en essayant de rester aussi objectif que possible, je ne peux que , pas très caractéristique (bien que pas unique : je pense à systemd, …) pour un projet open source.
(En pratique, Istio semble avoir des problèmes non seulement avec la complexité et l'expérience utilisateur, mais aussi avec la performance. Par exemple, lors d'une , réalisée par un tiers, les experts ont découvert des situations dans lesquelles les latences de queue d'Istio étaient 100 fois supérieures à celles de Linkerd, ainsi que des situations de manque de ressources où Linkerd continuait à fonctionner efficacement, tandis qu'Istio cessait complètement de fonctionner.)
En mettant de côté mes théories sur les raisons pour lesquelles cela s'est produit, je pense que l'engouement démesuré autour de service mesh s'explique par la participation de Google. Plus précisément, par la combinaison des trois facteurs suivants :
- la promotion insistante d'Istio par Google ;
- une attitude critique et désapprobatrice envers le projet ;
- la récente montée en flèche de la popularité de Kubernetes, dont les souvenirs sont encore frais.
Ensemble, ces facteurs créent un environnement suffocant et enivrant, où la capacité de jugement rationnel s'affaiblit, ne laissant place qu'à une variante merveilleuse de .
Du point de vue de Linkerd, je décrirais cela comme un bien ambigu. Je veux dire, c'est formidable que le service mesh soit devenu mainstream — ce qui n'était pas le cas en 2016, lorsque Linkerd a fait ses débuts, et qu'il était vraiment difficile d'attirer l'attention sur le projet. Maintenant, ce problème n'existe plus ! Mais il est regrettable que la situation actuelle du service mesh soit si confuse qu'il est pratiquement impossible de comprendre quels projets relèvent vraiment de cette catégorie (sans parler de savoir lequel est le mieux adapté à un cas d'utilisation spécifique). Cela, sans aucun doute, pénalise tout le monde (et il est clair que dans certains cas, Istio ou un autre projet convient mieux que Linkerd, car ce dernier n'est pas une solution universelle).
Du côté de Linkerd, notre stratégie a été d'ignorer le bruit, de continuer à nous concentrer sur la résolution des problèmes concrets de la communauté et, en gros, d'attendre que l'engouement retombe. En fin de compte, le hype diminuera, et nous pourrons continuer à travailler sereinement.
Pour l'heure, nous devons tous faire preuve de patience.
Un service mesh me sera-t-il utile, moi, humble ingénieur logiciel ?
La réponse à cette question peut être clarifiée par le questionnaire suivant :
Êtes-vous uniquement impliqué dans la mise en œuvre de la logique métier ? Dans ce cas, un service mesh ne vous sera pas utile. Bien sûr, vous pouvez vous y intéresser, mais idéalement, un service mesh ne devrait pas avoir d'impact direct sur quoi que ce soit dans votre environnement. Continuez à travailler sur ce pour quoi vous êtes payé.
Soutenez-vous une plateforme dans une entreprise qui utilise Kubernetes ? Oui, dans ce cas, un service mesh vous est nécessaire (bien sûr, si vous n'utilisez pas K8s juste pour exécuter un monolithe ou pour le traitement par lot — mais alors j'aimerais savoir pourquoi vous avez besoin de K8s). Vous vous retrouverez probablement dans une situation avec de nombreux microservices écrits par différentes personnes. Tous interagissent les uns avec les autres et forment un enchevêtrement de dépendances d'exécution, et vous devez trouver un moyen de gérer tout cela. L'application de Kubernetes vous permet de choisir un service mesh qui vous convient. Pour cela, consultez leurs fonctionnalités et spécificités et répondez à la question de savoir si un des projets existants vous convient (je vous recommande de commencer votre exploration avec Linkerd).
Vous travaillez sur une plateforme dans une entreprise qui N'UTILISE PAS Kubernetes mais utilise des microservices ? Dans ce cas, un service mesh vous sera utile, mais son utilisation ne sera pas triviale. Bien sûr, vous pouvez simuler le fonctionnement d'un service mesh en déployant une multitude de proxies, mais un des principaux avantages de Kubernetes est justement le modèle de déploiement : gérer ces proxies manuellement demandera beaucoup plus de temps, d'efforts et de coûts.
Vous êtes responsable d'une plateforme dans une entreprise qui travaille avec des monolithes ? Dans ce cas, un service mesh ne vous sera probablement pas nécessaire. Si vous travaillez avec des monolithes (ou même avec des ensembles de monolithes) ayant des schémas d'interaction clairement définis et rarement modifiés, un service mesh ne pourra pas vraiment vous apporter grand-chose. Vous pouvez donc simplement l'ignorer et espérer qu'elle disparaisse comme un mauvais rêve...
Conclusion
Probablement, il ne faut pas vraiment qualifier le service mesh de « technologie la plus tendance du monde » — cet honneur discutable appartient probablement au bitcoin ou à l'IA. Peut-être que cela fait partie des cinq premières. Mais si l'on parvient à percer à travers les couches de bruit et d'agitation, il devient clair que le service mesh apporte de réels avantages à ceux qui créent des applications dans Kubernetes.
Je voudrais que vous essayiez Linkerd — son installation dans un cluster Kubernetes (ou même dans Minikube sur un ordinateur portable) , et vous pourrez vous-même voir de quoi je parle.
FAQ
— Si j'ignore le service mesh, va-t-elle disparaître ?
— Je dois vous décevoir : le service mesh est là pour durer.
— Mais je NE VEUX PAS utiliser le service mesh !
— Eh bien, pas de problème ! Mais lisez tout de même mon questionnaire ci-dessus pour savoir si vous devriez au moins en connaître les bases.
— N'est-ce pas le bon vieux ESB/middleware sous un nouveau jour ?
— Le maillage de services gère la logique opérationnelle, et non sémantique. du bus de services d'entreprise (). Préserver cette séparation aide le maillage de services à éviter le même sort.
— En quoi le maillage de services diffère-t-il des passerelles API?
— Il existe des millions d'articles sur ce sujet. Il suffit de googler.
— Envoy est-il un maillage de services?
— Non, Envoy n'est pas un maillage de services, c'est un serveur proxy. Il peut être utilisé pour organiser un maillage de services (et beaucoup d'autres choses – c'est un proxy à usage général). Mais en lui-même, ce n'est pas un maillage de services.
— Network Service Mesh est-il un maillage de services?
— Non. Malgré son nom, ce n'est pas un maillage de services (comme le marketing peut le faire croire).
— Un maillage de services aidera-t-il mon système asynchrone réactif basé sur des files d'attente de messages?
— Non, le maillage de services ne vous aidera pas.
— Quel maillage de services devrais-je utiliser?
— , c'est évident.
— L'article est nul! / L'auteur à la poubelle!
— S'il vous plaît, partagez le lien avec tous vos amis pour qu'ils puissent s'en rendre compte!
Remerciements
Comme vous pouvez le deviner par le titre, cet article a été inspiré par le fantastique traité de Jay Kreps «». J'ai rencontré Jay il y a dix ans, lorsque je faisais des entrevues chez LinkedIn, et depuis il m'inspire.
Bien que j'aime me considérer comme « développeur de Linkerd », la réalité est que je suis plutôt mainteneur du fichier README.md dans le projet. Actuellement, Linkerd est développé par , , de personnes, et ce projet n'aurait pas été possible sans l'extraordinaire communauté de contributeurs et d'utilisateurs.
Et pour finir, un remerciement spécial au créateur de Linkerd, (primus inter pares), qui s'est plongé avec moi il y a plusieurs années dans tout ce fouillis autour du maillage de services.
P.S. de l'auteur
Lisez aussi dans notre blog :
- «»;
- «»;
- «»;
- «»;
- «».
Source : habr.com
