

Dans la deuxième partie de l'article sur les simulateurs de systèmes informatiques, je vais continuer à parler de manière simple et informative des simulateurs informatiques, en particulier de la simulation de plateforme complète, à laquelle l'utilisateur ordinaire est le plus souvent confronté, ainsi que du modèle de cycle et des pistes qui sont plus répandues parmi les développeurs.
Dans J'ai expliqué ce que sont les simulateurs en général, ainsi que les niveaux de modélisation. Maintenant, sur la base de ces connaissances, je propose d'approfondir un peu plus et de parler de la simulation de plateforme complète, de la façon de construire des pistes, de ce qu'il faut en faire ensuite, ainsi que de l'émulation microarchitecturale en cycle.
Un simulateur de plateforme complète (full platform simulator), ou “Un homme dans le champ — n'est pas un soldat”
S'il est nécessaire d'étudier le fonctionnement d'un appareil spécifique, par exemple, une carte réseau, ou d'écrire un firmware ou un pilote pour cet appareil, alors cet appareil peut être modélisé séparément. Cependant, l'utiliser en dehors de l'infrastructure restante n'est pas très pratique. Pour démarrer le pilote correspondant, un processeur central, de la mémoire, un accès au bus de transmission de données, etc., seront nécessaires. De plus, pour le fonctionnement du pilote, un système d'exploitation (OS) et une pile réseau sont requis. En complément, un générateur de paquets séparé et un serveur de réception de réponses peuvent être nécessaires.
Le simulateur de plateforme complète crée un environnement pour exécuter l'ensemble de la pile logicielle, qui comprend tout, depuis le BIOS et le chargeur jusqu'à l'OS elle-même et divers sous-systèmes, tels que la pile réseau, les pilotes, et les applications de niveau utilisateur. Pour cela, il implémente des modèles logiciels de la plupart des dispositifs informatiques : processeur et mémoire, disque, dispositifs d'entrée/sortie (clavier, souris, écran), ainsi que cette fameuse carte réseau.
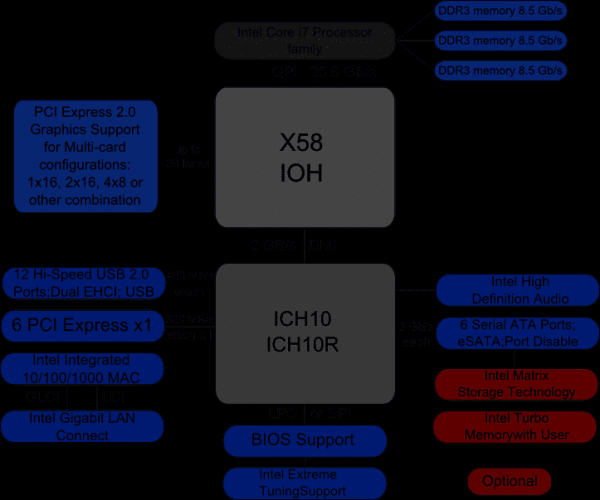
Ci-dessous se trouve un diagramme bloc du chipset x58 de la société Intel. Dans un simulateur informatique plateforme complète basé sur ce chipset, il est nécessaire de mettre en œuvre la plupart des dispositifs mentionnés, y compris ceux qui se trouvent à l'intérieur de l'IOH (Input/Output Hub) et de l'ICH (Input/Output Controller Hub), qui ne sont pas dessinés en détail sur le diagramme bloc. Cependant, comme le montre la pratique, il existe de nombreux dispositifs qui ne sont pas utilisés par le logiciel que nous prévoyons d'exécuter. Les modèles de ces dispositifs peuvent ne pas être créés.
Le plus souvent, les simulateurs plateforme complète sont réalisés au niveau des instructions du processeur (ISA, voir ). Cela permet de créer relativement rapidement et à moindre coût le simulateur lui-même. Le niveau ISA est également bon en ce qu'il reste plus ou moins constant, contrairement, par exemple, au niveau API/ABI, qui change plus souvent. De plus, la mise en œuvre au niveau des instructions permet d'exécuter ce que l'on appelle des binaires non modifiés, c'est-à-dire d'exécuter du code déjà compilé sans aucun changement, exactement de la manière dont il est utilisé sur un véritable matériel. En d'autres termes, on peut faire une copie (« dump ») du disque dur, la spécifier comme image pour le modèle dans le simulateur plateforme complète et – voilà ! – le système d'exploitation et les autres programmes se chargent dans le simulateur sans aucune action supplémentaire.
Performance des simulateurs
Comme mentionné précédemment, le processus de simulation de l'ensemble du système, c'est-à-dire de tous ses dispositifs, est un événement plutôt lent. Si cela est réalisé à un niveau très détaillé, par exemple, au niveau micro-architectural ou logique, l'exécution deviendra extrêmement lente. Cependant, le niveau d'instructions est un choix approprié et permet au système d'exploitation et aux programmes de s'exécuter à des vitesses suffisantes pour un usage confortable.
Il est ici pertinent d'aborder la question de la performance des simulateurs. Elle est généralement mesurée en IPS (instructions par seconde), plus précisément en MIPS (millions d'IPS), c'est-à-dire le nombre d'instructions processeur exécutées par le simulateur en une seconde. En même temps, la vitesse de simulation dépend également de la performance du système sur lequel la simulation elle-même fonctionne. Par conséquent, il peut être plus juste de parler de « ralentissement » (slowdown) du simulateur par rapport au système d'origine.
Les simulateurs full-platform les plus répandus sur le marché, tels que QEMU, VirtualBox ou VmWare Workstation, offrent de bonnes performances. L'utilisateur peut même ne pas remarquer que le travail se déroule dans un simulateur. Cela s'explique par la fonctionnalité de virtualisation intégrée dans les processeurs, les algorithmes de translation binaire et d'autres éléments intéressants. C'est un sujet pour un article à part entière, mais pour faire court, la virtualisation est une capacité matérielle des processeurs modernes qui permet aux simulateurs de ne pas simuler des instructions, mais de les soumettre directement au processeur réel, à condition que les architectures du simulateur et du processeur soient similaires. La translation binaire consiste à convertir le code machine de l'invité en code hôte et à l'exécuter sur le processeur réel. En conséquence, la simulation est seulement légèrement plus lente, de 5 à 10 fois, et fonctionne souvent même à la même vitesse que le système réel. Bien sûr, cela dépend de nombreux facteurs. Par exemple, si nous voulons simuler un système avec plusieurs dizaines de processeurs, la vitesse va alors chuter de plusieurs dizaines de fois. D'un autre côté, des simulateurs comme Simics dans leurs dernières versions prennent en charge l'hardware hôte multiprocesseur et parallélisent efficacement les cœurs simulés sur les cœurs du processeur réel.
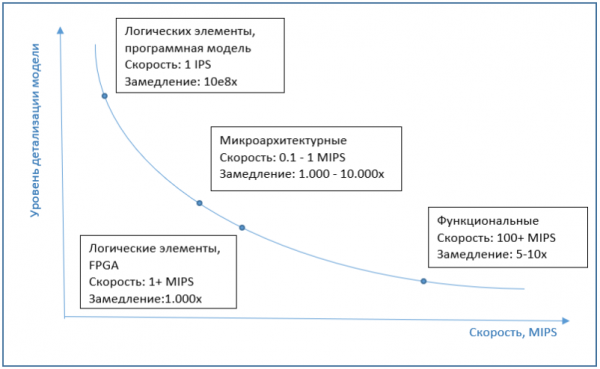
En ce qui concerne la vitesse de simulation microarchitecturale, elle est généralement plusieurs ordres de grandeur, environ 1000 à 10000 fois, plus lente que l'exécution sur un ordinateur normal, sans simulation. Les implémentations au niveau des éléments logiques sont encore plus lentes de plusieurs ordres. C'est pourquoi des FPGA sont utilisés comme émulateurs à ce niveau, ce qui permet d'augmenter considérablement les performances.
Le graphique ci-dessous montre la dépendance approximative de la vitesse de simulation en fonction de la granularité du modèle.
Simulation par cycles
Bien que la vitesse d'exécution soit relativement faible, les simulateurs microarchitecturaux sont assez répandus. La modélisation des blocs internes du processeur est nécessaire pour simuler avec précision le temps d'exécution de chaque instruction. Une confusion peut surgir ici : pourquoi ne pas simplement programmer le temps d'exécution pour chaque instruction ? Mais un tel simulateur fonctionnerait de manière très inexacte, car le temps d'exécution de la même instruction peut varier d'un appel à l'autre.
Un exemple simple est l'instruction d'accès à la mémoire. Si la cellule de mémoire demandée est disponible dans le cache, le temps d'exécution sera minimal. Si cette information n'est pas dans le cache (un « cache miss »), cela augmentera considérablement le temps d'exécution de l'instruction. Ainsi, pour une simulation précise, un modèle de cache est nécessaire. Cependant, cela ne se limite pas à un modèle de cache. Le processeur n'attendra pas simplement la réception des données de la mémoire lorsque celles-ci sont absentes du cache. Au lieu de cela, il commencera à exécuter les instructions suivantes, en choisissant celles qui ne dépendent pas du résultat de la lecture en mémoire. Il s'agit de l'exécution "hors ordre" (OOO, out of order execution), nécessaire pour minimiser le temps d'inactivité du processeur. Prendre tout cela en compte lors du calcul du temps d'exécution des instructions aidera à modéliser les blocs appropriés du processeur. Parmi ces instructions exécutées en attendant le résultat de la lecture en mémoire, il peut y avoir une opération de saut conditionnel. Si le résultat de la condition est inconnu à ce moment-là, le processeur ne stoppe pas l'exécution, mais fait une "hypothèse", exécute le saut correspondant et continue à exécuter préventivement les instructions depuis le point de saut. Ce bloc, appelé prédicteur de branche, doit également être implémenté dans le simulateur microarchitectural.
L'image ci-dessous montre les principaux blocs du processeur ; il n'est pas nécessaire de la connaître, elle est donnée simplement pour illustrer la complexité de la réalisation microarchitecturale.
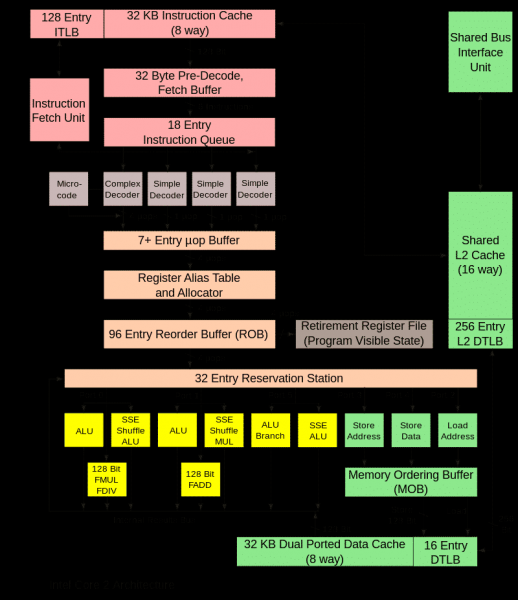
Le fonctionnement de tous ces blocs dans un processeur réel est synchronisé par des signaux d'horloge spéciaux, un processus similaire se produit également dans le modèle. On appelle ce simulateur d'architecture micro-architecturale un simulateur basé sur les cycles (cycle accurate). Son principal but est de prévoir avec précision les performances du processeur en cours de développement et/ou de calculer le temps d'exécution d'un certain programme, par exemple, d'un benchmark. Si les valeurs sont inférieures aux exigences, il sera nécessaire d'améliorer les algorithmes et les blocs du processeur ou d'optimiser le programme.
Comme indiqué ci-dessus, la simulation basée sur les cycles est très lente, c'est pourquoi elle n'est utilisée que pour étudier certains aspects du fonctionnement du programme, où il est essentiel de connaître la vitesse réelle d'exécution des programmes et d'évaluer les performances futures de l'appareil, dont le prototype est modélisé.
Pour simuler le reste du temps de fonctionnement du programme, un simulateur fonctionnel est utilisé. Comment cette utilisation combinée se produit-elle réellement ? Tout d'abord, un simulateur fonctionnel est lancé, sur lequel le système d'exploitation et tout le nécessaire pour faire fonctionner le programme étudié sont chargés. En effet, nous ne sommes intéressés ni par le système d'exploitation lui-même, ni par les premières étapes de lancement du programme, sa configuration, etc. Toutefois, nous ne pouvons pas non plus ignorer ces parties et passer directement à l'exécution du programme en milieu de processus. Ainsi, toutes ces étapes préliminaires sont exécutées sur le simulateur fonctionnel. Une fois que le programme a été exécuté jusqu'au moment qui nous intéresse, deux options sont possibles. On peut remplacer le modèle par un simulateur basé sur les cycles et continuer l'exécution. Le mode de simulation utilisant le code exécutable (c'est-à-dire des fichiers de programme compilés ordinaires) est appelé simulation basée sur l'exécution (execution driven simulation). C'est la variante de simulation la plus courante. Il est également possible d'envisager une autre approche – la simulation basée sur des traces (trace driven simulation).
Simulation basée sur des traces
Cela se compose de deux étapes. À l'aide d'un simulateur fonctionnel ou d'un système réel, un log des actions du programme est collecté et enregistré dans un fichier. Ce log est appelé une trace (trace). Selon ce qui est étudié, la trace peut inclure des instructions exécutables, des adresses mémoire, des numéros de ports, des informations sur les interruptions.
L'étape suivante consiste à « exécuter » la trace, lorsque le simulateur par étapes lit la trace et exécute toutes les instructions qui y sont enregistrées. À la fin, nous obtenons le temps d'exécution de ce morceau de programme, ainsi que diverses caractéristiques de ce processus, comme le pourcentage de hits dans le cache.
Une caractéristique importante du travail avec les traces est la déterminisme, c'est-à-dire qu'en lançant la simulation de la manière décrite ci-dessus, nous reproduisons la même séquence d'actions encore et encore. Cela permet, en modifiant les paramètres du modèle (tailles de cache, tampons et files d'attente) et en utilisant différents algorithmes internes ou en les ajustant, d'explorer comment tel ou tel paramètre affecte la performance du système et quelle variante donne les meilleurs résultats. Tout cela peut être fait avec le modèle prototype de l'appareil avant de créer un véritable prototype matériel.
La complexité de cette approche réside dans la nécessité d'exécuter préalablement l'application et de collecter la trace, ainsi que dans l'énorme taille du fichier de trace. Parmi les avantages, on peut noter qu'il suffit de modéliser seulement la partie de l'appareil ou de la plateforme qui nous intéresse, tandis que la simulation d'exécution nécessite, en règle générale, un modèle complet.
Ainsi, dans cet article, nous avons examiné les spécificités de la simulation à plateforme complète, discuté de la vitesse d'implémentation à différents niveaux, de la simulation par étapes et des traces. Dans le prochain article, je décrirai les principaux scénarios d'utilisation des simulateurs, tant à des fins personnelles qu'en termes de développement dans de grandes entreprises.
Source : habr.com
