

Objectif du système
Support d'accès à distance aux fichiers sur les ordinateurs du réseau. Le système prend en charge virtuellement toutes les opérations de fichiers essentielles (création, suppression, lecture, écriture, etc.) via des échanges de transactions (messages) par le protocole TCP.
Domaines d'application
Les fonctionnalités du système sont efficaces dans les cas suivants :
- dans les applications natives pour appareils mobiles et embarqués (smartphones, systèmes de contrôle embarqués, etc.) nécessitant un accès rapide aux fichiers sur des serveurs distants en cas de interruptions temporaires dans la connexion (déconnexion) ;
- dans des SGBD fortement chargés, si le traitement des requêtes se fait sur un serveur, tandis que le stockage des données se fait sur un autre ;
- dans des réseaux d'entreprise distribués de collecte et de traitement d'informations, nécessitant une vitesse d'échange de données élevée, de la redondance et de la fiabilité ;
- dans des systèmes complexes avec une architecture microservices, où les latences dans l'échange d'informations entre les modules sont critiques.
Structure
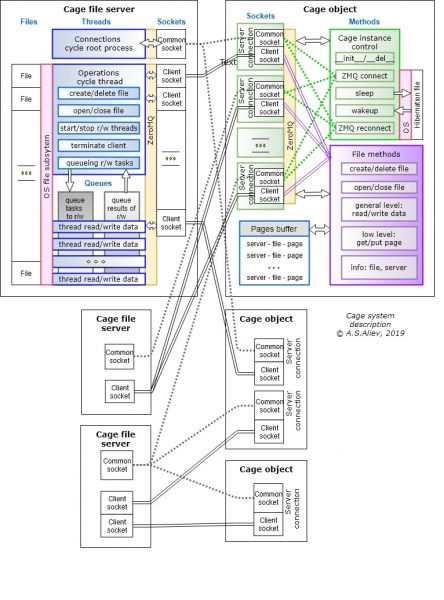
Le système Cage (une version bêta est disponible en Python 3.7 sur Windows) comprend deux parties principales :
- Cageserver — un programme de serveur de fichiers (ensemble de fonctions) qui s'exécute sur les ordinateurs du réseau auxquels un accès distant aux fichiers est nécessaire ;
- classe Cage avec une bibliothèque de méthodes pour le logiciel client, facilitant le codage de l'interaction avec les serveurs.
Utilisation du système côté client
Les méthodes de la classe Cage remplacent les opérations « routinières » classiques du système de fichiers : création, ouverture, fermeture, suppression de fichiers, ainsi que la lecture/écriture de données en format binaire (en précisant la position et la taille des données). Conceptuellement, ces méthodes sont proches des fonctions de fichiers du langage C, où l'ouverture/fermeture de fichiers se fait « sur des canaux » d'entrée/sortie.
En d'autres termes, le programmeur travaille non pas avec les méthodes des objets « fichiers » (classe _io en Python), mais avec les méthodes de la classe Cage.
Lors de la création d'une instance de l'objet Cage, il établit un lien initial avec le serveur (ou plusieurs serveurs), passe l'authentification via l'ID client et reçoit confirmation avec le numéro du port réservé pour effectuer toutes les opérations de fichiers. Lors de la suppression de l'objet Cage, il envoie une commande au serveur pour interrompre la connexion et fermer les fichiers. L'interruption de la connexion peut également être initiée par les serveurs eux-mêmes.
Le système améliore la vitesse de lecture/écriture en se basant sur la mise en cache des fragments de fichiers fréquemment utilisés par les programmes clients dans la mémoire vive.
Le logiciel client peut utiliser un nombre quelconque d'objets Cage avec différentes configurations (taille de la mémoire tampon, taille des blocs lors des échanges avec le serveur, etc.).
Un objet Cage peut échanger des données avec plusieurs fichiers sur plusieurs serveurs. Les paramètres de connexion (adresse IP ou DNS du serveur, port principal pour l'authentification, chemin et nom du fichier) sont définis lors de la création de l'objet.
Étant donné que chaque objet Cage peut travailler simultanément avec plusieurs fichiers, un espace mémoire commun est utilisé pour la mise en cache. La taille du cache – le nombre de pages et leur taille – est définie dynamiquement lors de la création de l'objet Cage. Par exemple, un cache de 1 Go correspond à 1000 pages de 1 Mo, ou 10 000 pages de 100 Ko, ou 1 million de pages de 1 Ko. Le choix de la taille et du nombre de pages est une tâche spécifique pour chaque cas d'application.
Il est possible d'utiliser plusieurs objets Cage simultanément pour définir différentes configurations de mémoire tampon en fonction des caractéristiques d'accès à l'information dans différents fichiers. Comme base, l'algorithme de mise en cache le plus simple est appliqué : une fois que le volume de mémoire spécifié est épuisé, les nouvelles pages remplacent les anciennes selon un principe de sortie avec un nombre minimal d'accès. La mise en cache est particulièrement efficace en cas d'accès conjoint inégal (au sens statistique), d'une part, à différents fichiers, et, d'autre part, à des fragments de chaque fichier.
La classe Cage prend en charge l'entrée/sortie non seulement par adresses de données (en précisant la position et la longueur du tableau, « remplaçant » les opérations du système de fichiers), mais aussi à un niveau plus bas, « physique » — par numéros de pages dans la mémoire tampon.
Une fonction originale est prise en charge pour les objets Cage « d'hibernation » («sommeiller») – elles peuvent être «réduites» (par exemple, en cas de rupture de la connexion avec les serveurs, ou lors de l'arrêt de l'application, etc.) dans un fichier de vidage local côté client et rapidement restaurées à partir de ce fichier (après le rétablissement de la connexion, lors du redémarrage de l'application). Cela permet une réduction significative du trafic lors de la réactivation de l'application cliente après un retrait temporaire «hors ligne», car les fragments de fichiers fréquemment utilisés seront déjà en cache.
Cage — c'est environ 3600 lignes de code.
Principes de construction des serveurs
Les fichiers serveurs de Cage peuvent être lancés avec un nombre arbitraire de ports, dont un («principal») est uniquement utilisé pour l'authentification de tous les clients, les autres pour l'échange de données. Le programme du serveur Cage nécessite uniquement Python. Parallèlement, l'ordinateur avec le serveur de fichiers peut effectuer tout autre travail.
Le serveur démarre initialement comme un ensemble de deux processus principaux :
- «Connexions» – processus pour établir et terminer la connexion avec les clients à l'initiative du serveur ;
- «Opérations» – processus pour exécuter les tâches (opérations) des clients relatives aux fichiers, ainsi que pour fermer les sessions de connexion sur commande des clients.
Les deux processus ne sont pas synchronisés et organisés comme des boucles infinies de réception et d'envoi de messages sur la base de files d'attente multiprocessus, d'objets proxy, de verrous et de sockets.
Le processus «Connexions» attribue à chaque client un port pour la transmission de données. Le nombre de ports est défini lors du démarrage du serveur. La correspondance entre les ports et les clients est stockée dans une mémoire proxy partagée entre les processus.
Le processus «Opérations» maintient une séparation des ressources de fichiers, permettant ainsi à plusieurs clients différents de lire conjointement (quasi-parallèle, car l'accès est géré par des verrous) des données d'un même fichier, si cela a été autorisé lors de son ouverture initiale par le «premier» client.
Le traitement des commandes pour créer/supprimer/ouvrir/fermer des fichiers sur le serveur est effectué dans le processus «Opérations» de manière strictement séquentielle en utilisant le système de fichiers du serveur OS.
Pour accélérer la lecture/écriture en général, ces opérations sont effectuées dans des threads générés par le processus « Opérations ». Le nombre de threads est généralement égal au nombre de fichiers ouverts. Les tâches de lecture/écriture des clients sont soumises à une file d'attente commune et le premier thread disponible prend la tâche à son sommet. Une logique spéciale permet d'exclure les opérations de réécriture des données dans la mémoire vive du serveur.
Le processus « Opérations » surveille l'activité des clients et interrompt leur service soit à leurs commandes, soit en cas de dépassement des délais d'inactivité.
Pour garantir la fiabilité, Cageserver tient des journaux de toutes les transactions. Un journal général contient des copies des messages des clients avec des tâches de création/ouverture/renommage/suppression de fichiers. Pour chaque fichier de travail, un journal séparé est créé, dans lequel sont enregistrées des copies des messages avec des tâches de lecture et d'écriture de données dans ce fichier de travail, ainsi que des tableaux de données écrites (nouvelles) et des tableaux de données qui ont été détruites lors de la réécriture (écriture de nouvelles données « par-dessus » les anciennes).
Ces journaux permettent à la fois de restaurer de nouveaux changements à partir des sauvegardes et de « revenir » du contenu actuel à un moment voulu dans le passé.
Cageserver contient environ 3100 lignes de code.
Démarrage du programme serveur de fichiers Cageserver
Lors du démarrage, il faut définir :
— le port principal pour l'authentification ;
— le nombre de ports pour l'échange de transactions avec les clients autorisés (à partir de 1 et plus, la piscine de numéros commence juste après le numéro du port principal).
Utilisation de la classe Cage
class cage.Cage( cage_name=», pagesize=0, numpages=0, maxstrlen=0, server_ip={}, wait=0, awake=False, cache_file=» )
Des objets sont créés à partir de cette classe, qui interagissent avec les serveurs de fichiers et contiennent de la mémoire tampon.
Paramètres
- cage_name(str) — nom conditionnel de l'objet, utilisé lors de l'identification des clients côté serveur
- pagesize(int) — taille d'une page de mémoire tampon (en octets)
- numpages(int) — nombre de pages en mémoire tampon
- maxstrlen(int) — longueur maximale d'une chaîne d'octets dans les opérations d'écriture et de lecture
- server_ip(dict) — dictionnaire avec les adresses utilisées serveurs, où la clé est le nom conditionnel du serveur (id du serveur dans l'application), et la valeur est une chaîne avec l'adresse : « adresse_ip:port » ou « DNS:port » (la correspondance entre les noms et les adresses réelles est temporaire, elle peut être modifiée)
- wait(int) — temps d'attente de réponse du serveur lors de la réception des ports (en sec.)
- éveillé(boolean) — indicateur de la méthode de création de l'objet (False — si un nouvel objet est créé, Vrai — si l'objet est créé à partir d'un « objet précédemment « suspendu » — par l'utilisation de l'opération « hibernation », par défaut False)
- fichier_cache(str) — nom du fichier pour l'hibernation
Méthodes
Cage.creer_fichier( serveur, chemin ) – créer un nouveau fichier
Cage.renommer_fichier( serveur, chemin, nouveau_nom ) – renommer le fichier
Cage.supprimer_fichier( serveur, chemin) – supprimer le fichier
Cage.open( serveur, chemin, mod ) – ouvrir le fichier
Retourne fchannel numéro de canal. Le paramètre mod — est le mode d'ouverture du fichier : « wm » — monopolistique (lecture/écriture), « rs » — seulement lecture, et partagé uniquement pour lecture par d'autres clients, « ws » — lecture/écriture, et partagé uniquement pour lecture par d'autres clients.
Cage.close (fchannel) – fermer le fichier
Cage.write (fchannel, debut, donnees ) – écrire une chaîne de bytes dans le fichier
Cage.read (fchannel, debut, len_donnees ) – lire une chaîne de bytes depuis le fichier
Cage.mettre_pages ( fchannel ) – « expulse » du tampon sur le serveur toutes les pages du canal spécifié qui ont été modifiées. Utilisé à des points de l'algorithme où il faut s'assurer que toutes les opérations sur le canal sont physiquement enregistrées dans le fichier sur le serveur.
Cage.push_all () – « expulse » du tampon sur le serveur toutes les pages de tous les canaux pour l'instance de la classe Cage qui ont été modifiées. Utilisé lorsque l'on veut s'assurer que toutes les opérations sur tous les canaux sont enregistrées sur le serveur.
Source : habr.com
