

style de code ansible devops
Salut ! Je m'appelle Je travaille comme ingénieur dans le département d'automatisation des processus de développement. Chaque jour, de nouvelles versions des applications sont déployées sur des centaines de serveurs de l'entreprise. Dans cet article, je partage mon expérience sur l'utilisation d'Ansible à ces fins.
Ce guide propose une méthode pour organiser les variables dans le déploiement. Ce guide est destiné à ceux qui utilisent déjà des rôles dans leurs playbooks et ont lu , mais rencontrent des problèmes similaires :
- Trouver une variable dans le code, il est impossible de comprendre immédiatement à quoi elle correspond ;
- Il y a plusieurs rôles, et les variables doivent être liées à une seule valeur, mais cela s'avère difficile ;
- Il est difficile d'expliquer aux autres comment la logique des variables est organisée dans vos playbooks.
Nous avons rencontré ces problèmes dans nos projets au sein de notre entreprise, ce qui nous a conduits à établir des règles pour la formulation des variables dans nos playbooks, qui ont en quelque sorte résolu ces questions.
Variables dans les rôles
Un rôle est un objet distinct dans le système de déploiement. Comme tout objet du système, il doit avoir une interface d'interaction avec le reste du système. Cette interface est constituée par les variables du rôle.
Prenons, par exemple, un rôle api, qui installe une application Java sur un serveur. Quelles variables peut-elle avoir ?
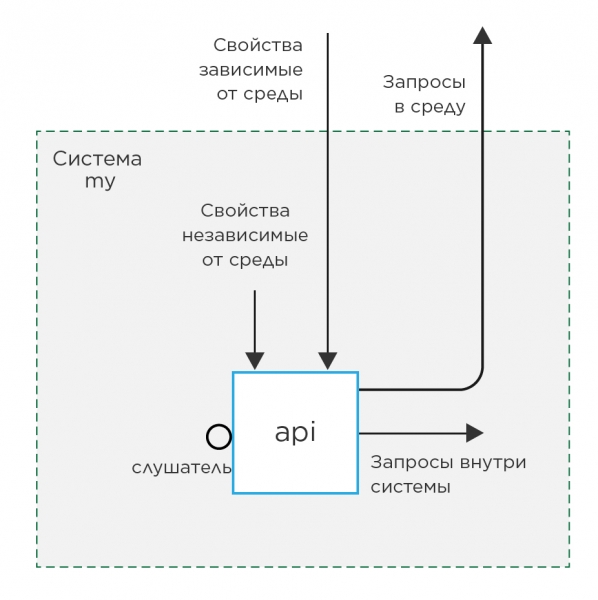
Les variables d'un rôle peuvent être classées en 2 catégories selon le type :
1. Propriétés
    a) indépendantes de l'environnement
    b) dépendantes de l'environnement
2. Liens
    a) écouteurs
    b) requêtes internes au système
    c) requêtes à l'environnement
Variables de propriété — Ce sont des variables qui déterminent le comportement du rôle.
Variables de requête — Ce sont des variables dont les valeurs sont utilisées pour désigner des ressources externes, par rapport au rôle.
Variables écouteurs — Ce sont des variables dont la valeur est utilisée pour former des variables de requête.
D'autre part, 1a, 2a, 2b — ce sont des variables qui ne dépendent pas de l'environnement (matériel, ressources externes, etc.) et peuvent être remplies avec des valeurs par défaut dans les paramètres du rôle. Cependant, les variables de type 1b et 2c ne peuvent, en plus de « exemple », être remplies avec d'autres valeurs, car elles varieront d'un environnement à l'autre en fonction du contexte.
Style de code
- Le nom de la variable doit nécessairement commencer par le nom du rôle. Cela permettra par la suite de comprendre facilement de quel rôle vient la variable et à quoi elle se rapporte.
- Lors de l'utilisation de variables dans des rôles, vous devez impérativement suivre le principe d'encapsulation et utiliser les variables définies soit dans le rôle lui-même, soit dans les rôles dont dépend le rôle actuel.
Essayez de ne pas utiliser de dictionnaires pour les variables. Ansible ne permet pas de redéfinir facilement des valeurs individuelles dans un dictionnaire.
Exemple de mauvaise variable :
myrole_user:
    login: admin
    password: admin
Ici, login est une variable indépendante du milieu, tandis que password est dépendante. Cependant,
comme elles sont regroupées dans un dictionnaire, vous devrez toujours spécifier la variable complètement
ce qui est très peu pratique. Mieux vaut faire ainsi :myrole_user_login: admin myrole_user_password: admin
Variables dans les playbooks de déploiement
Lors de l'élaboration d'un playbook de déploiement (ci-après playbook), nous nous conformons à la règle selon laquelle il doit être stocké dans un dépôt séparé. Tout comme les rôles : chacun dans son propre dépôt git. Cela permet de comprendre que les rôles et le playbook sont des objets indépendants du système de déploiement, et que les modifications d'un objet ne doivent pas affecter le fonctionnement de l'autre. Cela est réalisé en modifiant les valeurs par défaut des variables.
Lors de l'élaboration d'un playbook, pour résumer, il est possible de redéfinir les valeurs par défaut des variables de rôle à deux endroits : dans les variables de playbook et dans les variables d'inventaire.
mydeploy                        # Répertoire de déploiement
├── deploy.yml                  # Playbook de déploiement
├── group_vars                  # Répertoire des variables du playbook
│   ├── all.yml                 # Fichier pour les variables de toute la système
│   └── myapi.yml               # Fichier des variables des propriétés du groupe myapi
└── inventories                 #
    └── prod                    # Répertoire de l'environnement prod
      ├── prod.ini              # Fichier d'inventaire
      └── group_vars            # Répertoire pour les variables d'inventaire
          └── myapi             #
              ├── vars.yml      # Variables indépendantes du milieu du groupe myapi
              └── vault.yml     # Secrets (toujours indépendants du milieu) *
* —
La différence est que les variables de playbook sont toujours utilisées lors de l'appel de playbooks situés au même niveau. Par conséquent, ces variables conviennent parfaitement pour modifier les valeurs par défaut des variables indépendantes du milieu. Et, inversement, les variables d'inventaire ne seront utilisées que pour un environnement spécifique, ce qui est idéal pour les variables dépendantes du milieu.
Il est important de noter que la priorité des variables ne vous permettra pas de redéfinir les variables d'abord dans les variables du playbook, puis séparément dans un inventaire.
Cela signifie qu'à ce stade, vous devez décider si la variable est dépendante du contexte ou non et la placer au bon endroit.
Par exemple, dans un projet, une variable qui active SSL était longtemps dépendante du contexte, car nous ne pouvions pas activer SSL pour des raisons indépendantes de notre volonté sur l'un des environnements. Une fois ce problème résolu, elle est devenue indépendante du contexte et a été déplacée dans les variables du playbook.
Variables des propriétés pour les groupes
Étendons notre modèle sur la figure 1 en ajoutant 2 groupes de serveurs avec une autre application Java, mais avec des configurations différentes.
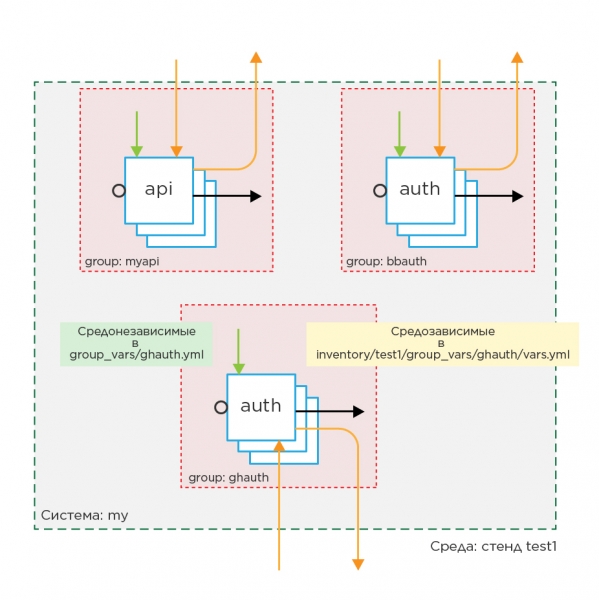
Voyons à quoi ressemblerait le playbook dans ce cas :
- hosts: myapi
  roles:
    - api

- hosts: bbauth
  roles:
    - auth

- hosts: ghauth
  roles:
    - auth
Nous avons trois groupes dans le playbook, il est donc recommandé de créer autant de fichiers de groupe dans les group_vars des variables d'inventaire et des variables du playbook. Un fichier de groupe dans ce cas décrit un composant de votre application dans le playbook. En ouvrant le fichier de groupe dans les variables du playbook, vous voyez immédiatement toutes les différences par rapport au comportement par défaut des rôles installés sur le groupe. Dans les variables d'inventaire : différences de comportement du groupe d'un environnement à l'autre.
Style de Code
- Essayez de ne pas utiliser du tout des variables host_vars, car elles ne décrivent pas le système, mais uniquement un cas particulier, ce qui entraînera des questions : "Pourquoi cet hôte est-il différent des autres ?", auquel il n'est pas toujours facile de répondre.
Variables de liaison
Cependant, cela concerne les variables de propriétés, mais qu'en est-il des variables de liaison ?
La différence est qu'elles doivent avoir la même valeur dans différents groupes.
Au début, il y avait utiliser une construction monstrueuse du type :
hostvars[groups['bbauth'][0]]['auth_bind_port'], mais cela a été immédiatement abandonné
car elle présente des inconvénients. Premièrement, elle est encombrante. Deuxièmement, elle dépend d'un hôte spécifique dans le groupe. Troisièmement, il est nécessaire de collecter les faits auprès de tous les hôtes avant de commencer le déploiement, si nous ne voulons pas obtenir une erreur de variable indéfinie.
Il a donc été décidé d'utiliser des variables de liaison.
Variables de liaison — ce sont des variables appartenant à un playbook, nécessaires pour relier les objets du système.
Les variables de lien sont remplies dans les variables générales du système. group_vars/all/vars et se forment en extrayant toutes les variables des écouteurs de chaque groupe, et en ajoutant le nom du groupe d'où l'écouteur a été extrait au début de la variable.
Ainsi, l'uniformité et l'absence de chevauchement des noms sont assurées.
Essayons de relier les variables de l'exemple ci-dessus :
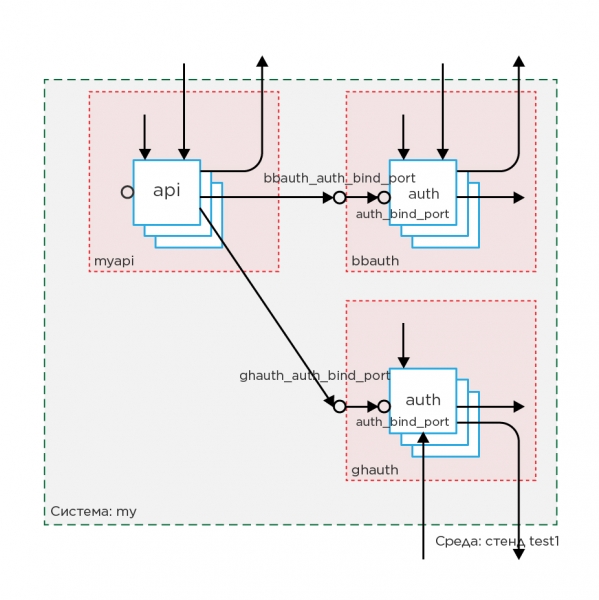
Imaginons que nous avons des variables qui dépendent les unes des autres :
# roles/api/defaults:
# Переменная запроса
api_auth1_address: "http://example.com:80"
api_auth2_address: "http://example2.com:80"

# roles/auth/defaults:
# Переменная слушатель
auth_bind_port: "20000"
Extrayons dans les variables générales group_vars/all/vars tous les écouteurs, et ajoutons dans le nom le nom du groupe :
# group_vars/all/vars
bbauth_auth_bind_port: "20000"
ghauth_auth_bind_port: "30000"

# group_vars/bbauth/vars
auth_bind_port: "{{ bbauth_auth_bind_port }}"

# group_vars/ghauth/vars
auth_bind_port: "{{ ghauth_auth_bind_port }}"

# group_vars/myapi/vars
api_auth1_address: "http://{{ bbauth_auth_service_name }}:{{ bbauth_auth_bind_port }}"
api_auth2_address: "http://{{ ghauth_auth_service_name }}:{{ ghauth_auth_bind_port }}"
Ainsi, en changeant la valeur du connecteur, nous serons certains que la requête se dirigera vers l'endroit où le port est situé.
Style de Code
- Puisque les rôles et les groupes sont des objets différents du système, il est nécessaire qu'ils aient des noms différents, alors les variables de lien montreront clairement qu'elles appartiennent à un groupe spécifique de serveurs, et non à un rôle dans le système.
Fichiers dépendant de l'environnement
Dans les rôles, des fichiers peuvent être utilisés, qui diffèrent d'un environnement à l'autre.
Un exemple de tels fichiers pourrait être les certificats SSL. Les stocker en texte brut
dans une variable n'est pas très pratique. Cependant, il est pratique de conserver leur chemin à l'intérieur de la variable.
Par exemple, nous utilisons la variable api_ssl_key_file: "/path/to/file".
Puisqu'il est évident que le certificat clé changera d'un environnement à l'autre, c'est donc une variable dépendante de l'environnement, et elle doit donc se trouver dans le fichier
group_vars/myapi/vars d'inventaire des variables, et contenir la valeur 'à titre d'exemple'.
Il est plus pratique dans ce cas de placer le fichier clé dans le dépôt du playbook au chemin
files/prod/certs/myapi.key, alors la valeur de la variable sera :
api_ssl_key_file: "prod/certs/myapi.key". L'avantage est que les personnes responsables de déployer le système sur un stand spécifique ont également leur propre espace attribué dans le dépôt pour stocker leurs fichiers. En même temps, il reste possible d'indiquer le chemin absolu vers le certificat sur le serveur, au cas où les certificats seraient fournis par un autre système.
Plusieurs stands dans un même environnement
Il est souvent nécessaire de déployer plusieurs environnements pratiquement identiques dans un même cadre avec des différences minimales. Dans ce cas, nous divisons les variables dépendantes de l'environnement en celles qui demeurent constantes dans cet environnement et celles qui changent. Nous plaçons directement ces dernières dans les fichiers d'inventaire. Après cette manipulation, il devient possible de créer un autre inventaire directement dans le répertoire de l'environnement.
Il va réutiliser les group_vars d'inventaire, tout en ayant la possibilité de redéfinir certaines variables selon ses besoins.
Structure finale des répertoires pour le déploiement du projet :
mydeploy                        # Répertoire du déploiement
├── deploy.yml                  # Playbook de déploiement
├── files                       # Répertoire pour les fichiers de déploiement
│   ├── prod                    # Répertoire pour les fichiers dépendants de l'environnement prod
│   │   └── certs               #
│   │       └── myapi.key       #
│   └── test1                   # Répertoire pour les fichiers dépendants de l'environnement test1
├── group_vars                  # Répertoire des variables du playbook
│   ├── all.yml                 # Fichier pour les variables de l'ensemble du système
│   ├── myapi.yml               # Fichier des variables spécifiques au groupe myapi
│   ├── bbauth.yml              #
│   └── ghauth.yml              #
└── inventories                 #
    ├── prod                    # Répertoire de l'environnement prod
    │   ├── group_vars          # Répertoire pour les variables d'inventaire
    │   │   ├── myapi           #
    │   │   │   ├── vars.yml    # Variables dépendantes du groupe myapi
    │   │   │   └── vault.yml   # Secrets (toujours dépendants)
    │   │   ├── bbauth          #
    │   │   │   ├── vars.yml    #
    │   │   │   └── vault.yml   #
    │   │   └── ghauth          #
    │   │       ├── vars.yml    #
    │   │       └── vault.yml   #
    │   └── prod.ini            # Inventaire de l'environnement prod
    └── test                    # Répertoire de l'environnement test
        ├── group_vars          #
        │   ├── myapi           #
        │   │   ├── vars.yml    #
        │   │   └── vault.yml   #
        │   ├── bbauth          #
        │   │   ├── vars.yml    #
        │   │   └── vault.yml   #
        │   └── ghauth          #
        │       ├── vars.yml    #
        │       └── vault.yml   #
        ├── test1.ini           # Inventaire de l'environnement test1
        └── test2.ini           # Inventaire de l'environnement test2
Résumé
Après avoir organisé les variables conformément à l'article : chaque fichier de variables est responsable d'une tâche spécifique. Et comme chaque fichier a des tâches définies, il est donc possible de désigner une personne responsable de l'exactitude de chaque fichier. Par exemple, le développeur du déploiement du système est responsable de l'exactitude du remplissage des variables du playbook, tandis que l'administrateur, dont l'environnement est décrit dans l'inventaire, est directement responsable du remplissage des variables d'inventaire.
Les rôles sont devenus une unité de développement autonome avec une interface propre, permettant au développeur de rôle de développer des fonctionnalités plutôt que d'adapter le rôle au système. Ce problème concernait particulièrement les rôles communs à tous les systèmes de la campagne.
Les administrateurs système n'ont plus besoin de comprendre le code de déploiement. Tout ce qui leur est demandé pour un déploiement réussi est de remplir les fichiers de variables dépendantes de l'environnement.
Littérature
Auteur
Kaljužny Denis Alexandrovich
Source : habr.com
