

Cet article est le deuxième d'une série sur la compression rapide des données. Le premier article décrivait un compresseur qui fonctionne à une vitesse de 10 Go/s par cœur de processeur (compression minimale, RTT-Min).
Ce compresseur est déjà intégré dans les équipements des duplicateurs criminologiques pour la compression rapide des dumps des supports d'information et pour renforcer la résistance à la cryptographie. Il peut également être utilisé pour compresser les images des machines virtuelles et les fichiers d'échange de la mémoire vive lors de leur sauvegarde sur des disques SSD rapides.
Le premier article annonçait également le développement d'un algorithme de compression pour la compression des sauvegardes des disques durs et des disques SSD (compression moyenne, RTT-Mid) avec des paramètres de compression des données nettement améliorés. À l'heure actuelle, ce compresseur est entièrement prêt et cet article lui est consacré.
Le compresseur réalisant l'algorithme RTT-Mid offre un taux de compression comparable à celui des archiveurs standards comme WinRar et 7-Zip, fonctionnant en mode rapide. Sa vitesse de fonctionnement est au moins d'un ordre de grandeur supérieure.
La vitesse d'emballage/dépackaging des données est un paramètre critique qui détermine le domaine d'application des technologies de compression. Il est peu probable que quiconque pense à compresser un téraoctet de données à une vitesse de 10-15 Mégaoctets par seconde (c'est précisément la vitesse des archiveurs en mode de compression standard), car cela prendrait presque vingt heures avec le processeur à charge maximale…
D'autre part, le même téraoctet peut être copié à des vitesses d'environ 2-3 Go par seconde en dix minutes.
Par conséquent, la compression d'informations de grande taille est pertinente si elle est effectuée à une vitesse d'au moins celle des entrées/sorties réelles. Pour les systèmes modernes, cela représente au moins 100 Mégaoctets par seconde.
De telles vitesses ne peuvent être atteintes par les compresseurs modernes qu'en mode « fast ». C'est dans ce mode pertinent que nous allons comparer l'algorithme RTT-Mid avec les compresseurs traditionnels.
Test comparatif du nouvel algorithme de compression
Le compresseur RTT-Mid a fonctionné dans le cadre d'un programme de test. Dans une application « réelle », il fonctionne significativement plus vite, avec une utilisation efficace du multithreading et avec un « compilateur normal », et non en C#.
Comme les compresseurs utilisés dans le test comparatif reposent sur des principes différents et compressent divers types de données de manières distinctes, une méthode d'évaluation dite « température moyenne de l'hôpital » a été employée pour assurer l'objectivité du test…
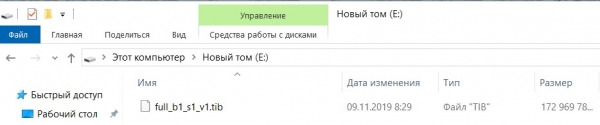
Un fichier de dump sectoriel du disque logique contenant le système d'exploitation Windows 10 a été créé, représentant ainsi un mélange naturel de structures de données variées que l'on trouve sur chaque ordinateur. La compression de ce fichier permettra de comparer la vitesse et le taux de compression du nouvel algorithme avec les compresseurs les plus avancés utilisés dans les outils d'archivage modernes.
Voici ce fichier de dump :
Le fichier de dump a été compressé par les compresseurs RTT-Mid, 7-zip, WinRar. Les compresseurs WinRar et 7-zip ont été réglés pour fonctionner à la vitesse maximale.
Le compresseur fonctionne 7-zip:
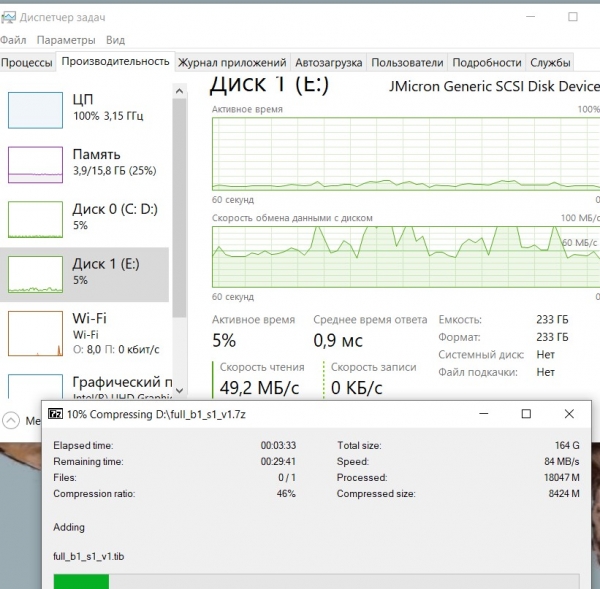
Il charge le processeur à 100%, avec une vitesse moyenne de lecture du dump d'environ 60 MégaOctets/sec.
Le compresseur fonctionne WinRar:
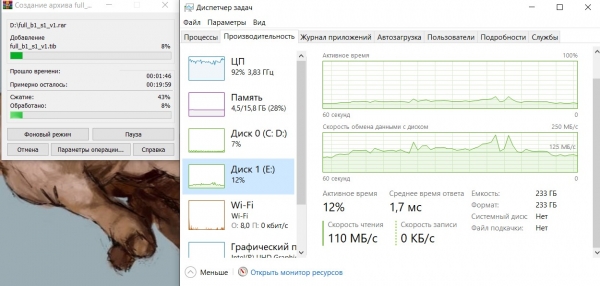
La situation est similaire, charge du processeur presque à 100%, vitesse moyenne de lecture du dump d'environ 125 MégaOctets/sec.
Comme dans le cas précédent, la vitesse de l'archiveur est limitée par les capacités du processeur.
La programme de test du compresseur fonctionne maintenant RTT-Mid:
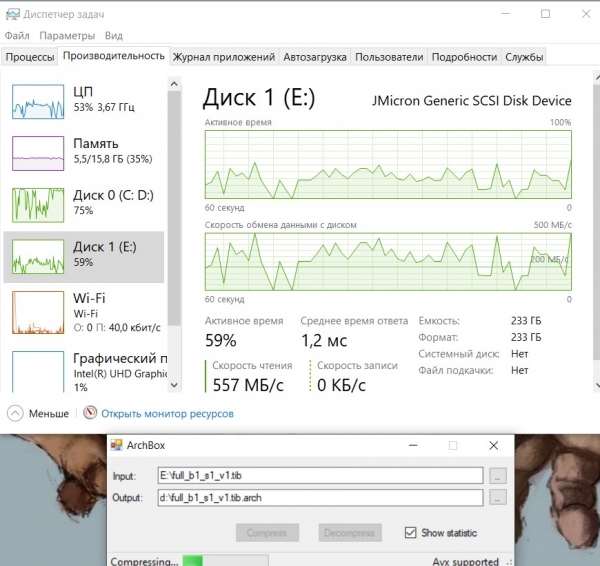
La capture d'écran montre que le processeur est chargé à 50% et reste inoccupé le reste du temps, car il n'y a nulle part où décharger les données compressées. Le disque de déchargement (Disque 0) est presque totalement chargé. La vitesse de lecture des données (Disque 1) fluctue considérablement, mais dépasse en moyenne les 200 MégaOctets/sec.
La vitesse de fonctionnement du compresseur est ici limitée par la capacité d'écriture des données compressées sur le Disque 0.
Maintenant, le taux de compression des archives résultantes :
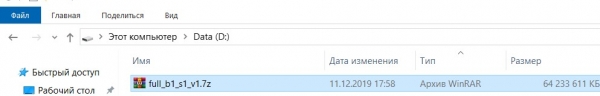
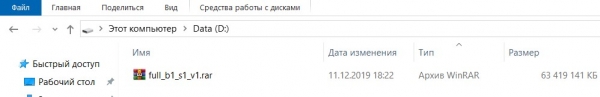
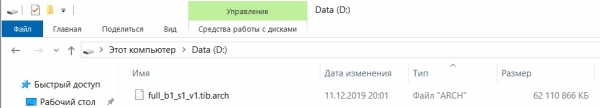
On constate que le compresseur RTT-Mid a réalisé la meilleure compression, l'archive qu'il a créée étant de 1,3 GigaOctet plus petite que l'archive WinRar et de 2,1 GigaOctets plus petite que l'archive 7z.
Temps consacré à la création de l'archive :
- 7-zip – 26 minutes 10 secondes ;
- WinRar – 17 minutes 40 secondes ;
- RTT-Mid – 7 minutes 30 secondes.
Ainsi, même un programme de test non optimisé, utilisant l'algorithme RTT-Mid, a pu créer une archive plus de deux fois et demie plus rapidement, tout en étant significativement plus petite que celles des concurrents…
Ceux qui ne croient pas aux captures d'écran peuvent vérifier leur véracité par eux-mêmes. Le programme de test est disponible à , téléchargez et vérifiez.
Mais cela ne fonctionne que sur les processeurs prenant en charge AVX-2 ; sans cette prise en charge, le compresseur ne fonctionne pas, et ne testez pas l'algorithme sur les anciens processeurs AMD, car ils sont lents dans l'exécution des commandes AVX…
Méthode de compression utilisée
L'algorithme utilise une méthode d'indexation des fragments de texte répétitifs à l'échelle des octets. Cette méthode de compression est connue depuis longtemps, mais n'a pas été utilisée car l'opération de recherche de correspondances était très coûteuse en ressources nécessaires et nécessitait beaucoup plus de temps que la construction d'un dictionnaire. Ainsi, l'algorithme RTT-Mid est un exemple classique du mouvement "retour vers le futur"…
Le compresseur RTT utilise un scanner de recherche de correspondances à haute vitesse unique, qui a précisément permis d'accélérer le processus de compression. Ce scanner est fait maison, c'est « mon précieux... », « son prix est considérable car il est entièrement fait main » (écrit en assembleur).
Le scanner de recherche de correspondances est basé sur un schéma probabiliste à deux niveaux : tout d'abord, la présence d'un « indice » de correspondance est scannée, et ce n'est qu'après avoir identifié cet « indice » à cet endroit que la procédure de détection de la correspondance réelle est lancée.
La fenêtre de recherche de correspondances a une taille imprévisible, dépendant du degré d'entropie dans le bloc de données traité. Pour les données complètement aléatoires (non compressibles), elle a une taille de plusieurs mégaoctets, tandis que pour les données avec des répétitions, elle a toujours une taille supérieure à un mégaoctet.
Cependant, de nombreux formats de données modernes sont non compressibles et « faire fonctionner » un scanner gourmand en ressources sur eux est inutile et gaspilleux, c'est pourquoi le scanner utilise deux modes de fonctionnement. D'abord, des sections du texte source avec des répétitions potentielles sont recherchées, cette opération est également effectuée par méthode probabiliste et se fait très rapidement (à une vitesse de 4-6 Go/s). Ensuite, les sections avec des correspondances potentielles sont traitées par le scanner principal.
La compression par index n'est pas très efficace, car il faut remplacer les fragments répétitifs par des indices, et le tableau d'index réduit considérablement le taux de compression.
Pour augmenter le taux de compression, non seulement les correspondances complètes des chaînes d'octets sont indexées, mais aussi les correspondances partielles, lorsque la chaîne contient des octets correspondants et non correspondants. À cette fin, un champ de masque de correspondance est inclus dans le format d'index indiquant les octets correspondants de deux blocs. Pour une compression encore plus élevée, l'indexation utilise le chevauchement de plusieurs blocs partiellement correspondants avec le bloc actuel.
Tout cela a permis d'obtenir dans le compresseur RTT-Mid un taux de compression comparable à celui des compresseurs fonctionnant par méthode lexicale, mais qui fonctionnent beaucoup plus rapidement.
La vitesse de fonctionnement du nouvel algorithme de compression
Si le compresseur fonctionne avec une utilisation monopolistique du cache mémoire (4 mégabytes requis par flux), la vitesse de fonctionnement oscille entre 700 et 2000 mégabytes/sec par cœur de processeur en fonction du type de données compressées et dépend peu de la fréquence de travail du processeur.
Dans la mise en œuvre multithread du compresseur, l'évolutivité effective est déterminée par le volume de la mémoire cache de niveau trois. Par exemple, avoir 9 mégabytes de mémoire cache rend inutile le lancement de plus de deux flux de compression, la vitesse ne augmentera pas à cause de cela. Mais avec 20 mégabytes de cache, il est possible de lancer cinq flux de compression.
Un paramètre significatif déterminant également la vitesse de fonctionnement du compresseur est la latence de la mémoire vive. L'algorithme utilise des accès aléatoires à la RAM, dont une partie n'entre pas dans le cache mémoire (environ 10 %) et il doit attendre les données de la RAM, ce qui réduit la vitesse de fonctionnement.
La vitesse du compresseur est également considérablement influencée par le fonctionnement du système d'entrée/sortie de données. Les requêtes à la RAM provenant de l'entrée/sortie bloquent les accès aux données du côté du CPU, ce qui réduit également la vitesse de compression. Ce problème est significatif pour les ordinateurs portables et de bureau, serveurs il est moins significatif grâce à un bloc de contrôle d'accès à la bus système plus avancé et à une mémoire vive multicanale.
Tout au long de l'article, il est question de compression, la décompression étant hors du sujet car « tout va bien ». La décompression se fait beaucoup plus rapidement et est limitée par la vitesse d'entrée/sortie. Un seul cœur physique dans un flux peut facilement atteindre des vitesses de décompression de 3 à 4 Go/s.
Cela est dû à l'absence, lors de la décompression, de l'opération de recherche de correspondances, qui « consomme » les principales ressources du processeur et de la mémoire cache lors de la compression.
Fiabilité de la conservation des données compressées
Comme le suggère le nom même de toute la catégorie de logiciels utilisant la compression des données (les archiveurs), ceux-ci sont destinés à une conservation à long terme des informations, non pas pendant des années, mais des siècles et des millénaires...
Au fil du temps, les supports d'information perdent une partie des données, en voici un exemple :
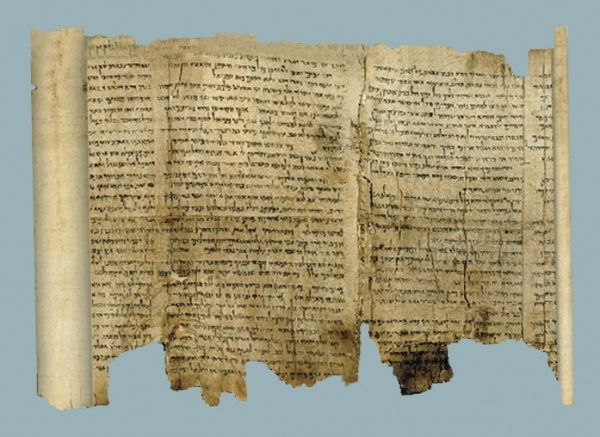
Ce support d'information « analogique » a mille ans, certains fragments sont perdus, mais globalement l'information est « lisible »...
Aucun des producteurs responsables de systèmes de stockage de données numériques modernes et des supports numériques associés ne garantit la conservation complète des données au-delà de 75 ans.
Et c'est un problème, mais un problème différé, nos descendants s'en chargeront...
Les systèmes de stockage de données numériques peuvent perdre des données non seulement après 75 ans, des erreurs dans les données peuvent survenir à tout moment, même lors de leur enregistrement, ces distorsions tentent d'être minimisées en utilisant de la redondance et en corrigeant avec des systèmes de correction d'erreurs. La redondance et les systèmes de correction peuvent restaurer les informations perdues, mais ce n'est pas toujours le cas, et même lorsqu'ils le font, il n'y a aucune garantie que l'opération de restauration se soit bien déroulée.
Et c'est aussi un grand problème, mais pas différé, c'est un problème actuel.
Les compresseurs modernes utilisés pour l'archivage des données numériques sont basés sur diverses modifications de la méthode de dictionnaire, et pour de tels archives, la perte d'un fragment d'information serait un événement fatal, il existe même un terme bien établi pour cette situation — « archive corrompue »...
La faible fiabilité du stockage d'informations dans des archives avec compression dictionnaire est liée à la structure des données compressées. Les informations dans une telle archive ne contiennent pas le texte d'origine, mais des numéros d'enregistrement dans le dictionnaire, ce dernier étant modifié dynamiquement par le texte compressible actuel. En cas de perte ou de déformation d'un fragment de l'archive, toutes les entrées suivantes ne peuvent être identifiées ni par leur contenu, ni par la longueur de l'enregistrement dans le dictionnaire, car il n'est pas clair à quoi correspond le numéro de l'enregistrement du dictionnaire.
Il est impossible de récupérer des informations à partir d'une telle archive "endommagée".
L'algorithme RTT est basé sur une méthode de stockage de données compressées plus fiable. Il utilise une méthode d'indexation pour suivre les fragments répétitifs. Cette approche de compression permet de minimiser les conséquences de la distorsion d'informations sur le support et, dans de nombreux cas, de corriger automatiquement les distorsions survenues lors du stockage des informations.
Cela est dû au fait que le fichier d'archive, dans le cas de la compression par index, contient deux champs :
- le champ du texte d'origine avec les segments répétitifs supprimés ;
- le champ des indices.
Le champ des indices, critique pour la récupération des informations, n'est pas très volumineux et peut être dupliqué pour une fiabilité accrue du stockage des données. Par conséquent, même si un fragment du texte d'origine ou de la matrice d'indices est perdu, toutes les autres informations peuvent être récupérées sans problème, tout comme sur une image d'un support d'informations "analogique".
Inconvénients de l'algorithme
Il n'y a pas d'avantages sans inconvénients. La méthode d'indexation de la compression ne compresse pas les séquences répétitives de courte longueur. Cela est dû aux limitations de la méthode d'indexation. Les indices ont une taille minimale de 3 octets et peuvent aller jusqu'à 12 octets. Si une répétition de taille inférieure à celle de l'indice qui la décrit apparaît, elle n'est pas prise en compte, peu importe la fréquence des répétitions dans le fichier compressé.
La méthode de compression traditionnelle basée sur un dictionnaire compresse efficacement de multiples répétitions de faible longueur et atteint ainsi un meilleur taux de compression que la compression par index. Toutefois, cela nécessite une charge processeur élevée, ce qui oblige la méthode basée sur un dictionnaire à réduire sa vitesse de traitement à environ 10 à 20 mégaoctets par seconde sur des installations de calcul réelles avec le processeur complètement chargé pour compresser les données plus efficacement que la méthode par index.
Ces vitesses très faibles sont inacceptables pour les systèmes de stockage modernes et présentent davantage un intérêt « académique » qu'une utilité pratique.
Le taux de compression de l'information sera considérablement amélioré dans la prochaine version de l'algorithme RTT (RTT-Max), qui est déjà en cours de développement.
Donc, comme toujours, la suite suivra…
Source : habr.com
