

Des meetups pour les administrateurs systèmes, Sysadminka, ont lieu à Tcheliabinsk, et lors du dernier, j'ai présenté notre solution pour exécuter des applications sur 1C-Bitrix dans Kubernetes.
Bitrix, Kubernetes, Ceph — un excellent mélange ?
Je vais expliquer comment nous avons assemblé une solution fonctionnelle à partir de tout cela.
Allons-y !
Le meetup a eu lieu le 18 avril à Tcheliabinsk. Vous pouvez lire sur nos meetups dans et les voir sur .
Si vous souhaitez venir nous parler ou simplement écouter — bienvenue, écrivez à vadim.isakanov@gmail.com et sur Telegram t.me/vadimisakanov.
Ma présentation
Solution « Bitrix dans Kubernetes, version Southbridge 1.0 »
Je parlerai de notre solution dans un format « pour les débutants en Kubernetes », comme cela a été fait lors du meetup. Mais je suppose que vous êtes au moins familier avec les mots Bitrix, Docker, Kubernetes, Ceph à un niveau d'articles sur Wikipédia.
Qu'est-ce qui existe déjà sur Bitrix dans Kubernetes ?
Il y a très peu d'informations sur le fonctionnement des applications Bitrix dans Kubernetes sur Internet.
Je n'ai trouvé que les matériaux suivants :
Présentation d'Alexandre Serbul, 1C-Bitrix, et Anton Tuzlukov de Qsoft :
Je recommande de l'écouter.
Développement de notre propre solution par un utilisateur .
J'ai trouvé encore .
Et euh... c'est tout.
Je préviens, nous n'avons pas vérifié la qualité des solutions aux liens ci-dessus 🙂
À propos, lors de la préparation de notre solution, j'ai parlé avec Alexandre Serbul, à l'époque sa présentation n'était pas encore disponible, donc mes diapositives contiennent le point « Bitrix n'utilise pas Kubernetes ».
Mais il y a déjà beaucoup d'images Docker prêtes à l'emploi pour faire fonctionner Bitrix dans Docker :
Cela suffit-il pour créer une solution complète pour Bitrix dans Kubernetes ?
Non. Il y a de nombreux problèmes à résoudre.
Quels sont les problèmes liés à Bitrix dans Kubernetes ?
Le premier — les images prêtes sur Dockerhub ne conviennent pas à Kubernetes.
Si nous voulons construire une architecture de microservices (ce que nous souhaitons généralement dans Kubernetes), il est nécessaire de diviser l'application dans Kubernetes en conteneurs et de s'assurer que chaque conteneur exécute une petite fonction (et le fait bien). Pourquoi seulement une ? En résumé — plus c'est simple, plus c'est fiable.
Pour plus de détails — veuillez consulter cet article et cette vidéo :
Les images Docker sur Dockerhub sont principalement construites selon le principe « tout-en-un », donc nous avons dû créer notre propre solution et même construire des images à partir de zéro.
Deuxième — le code du site est modifié depuis le panneau d'administration.
Nous avons créé une nouvelle section sur le site - le code a été mis à jour (un répertoire avec le nom de la nouvelle section a été ajouté).
Les propriétés du composant ont été modifiées depuis le panneau d'administration - le code a changé.
Kubernetes ne sait pas travailler avec cela par défaut, les conteneurs doivent être immuables (Stateless).
La raison : chaque conteneur (pod) dans le cluster traite seulement une partie du trafic. Si vous modifiez le code dans un seul conteneur (pod), alors le code sera différent dans les différents pods, le site fonctionnera de manière variée, et différents utilisateurs verront différentes versions du site. Ce n'est pas viable.
Troisième étape : il faut résoudre la question du déploiement.
Si nous avons un monolithe et un serveur « classique », tout est assez simple : nous déployons la nouvelle base de code, effectuons la migration de la base de données, et redirigeons le trafic vers la nouvelle version du code. Le basculement se produit instantanément.
Si nous avons un site sur Kubernetes, découpé en microservices, avec de nombreux conteneurs de code - cela devient complexe. Il faut construire des conteneurs avec la nouvelle version du code, les déployer à la place des anciens, effectuer correctement la migration de la base de données, et idéalement le faire de manière invisible pour les visiteurs. Heureusement, Kubernetes nous aide en supportant toute une variété de types de déploiement.
Quatrième étape : il faut résoudre la question du stockage des fichiers statiques.
Si votre site pèse « seulement » 10 gigaoctets et que vous le déployez entièrement dans des conteneurs, vous obtiendrez des conteneurs pesant 10 gigaoctets qui seront déployés indéfiniment.
Il est nécessaire de stocker les parties les plus « lourdes » du site en dehors des conteneurs, et se pose la question de la manière de le faire correctement.
Ce qui manque dans notre solution.
Tout le code de Bitrix n'est pas découpé en micro-fonctions / microservices (par exemple, l'inscription séparément, le module de boutique en ligne séparément, etc.). Nous stockons l'intégralité de la base de code dans chaque conteneur.
Nous ne stockons pas la base de données dans Kubernetes (j'ai cependant réalisé des solutions avec une base de données dans Kubernetes pour des environnements de développeurs, mais pas pour la production).
Les administrateurs du site verront tout de même que le site fonctionne sur Kubernetes. La fonction « vérification du système » ne fonctionne pas correctement, pour modifier le code du site depuis le panneau d'administration, il faut d'abord cliquer sur le bouton « je veux modifier le code ».
Nous avons identifié les problèmes, et clarifié la nécessité de réaliser une microservices architecture ; l'objectif est clair : obtenir un système fonctionnel pour faire tourner des applications sur Bitrix dans Kubernetes, tout en conservant les capacités de Bitrix et les avantages de Kubernetes. Nous commençons la mise en œuvre.
Architecture
Beaucoup de pods « actifs » avec un serveur web (workers).
Un pod avec des tâches cron (obligatoirement un seul).
Un pod de mise à niveau pour modifier le code du site depuis le panneau d'administration (également obligatoirement un seul).
Nous résolvons les questions :
- Où stocker les sessions ?
- Où stocker le cache ?
- Où stocker les fichiers statiques, il n'est pas question de placer des gigaoctets de fichiers statiques dans une multitude de conteneurs ?
- Comment fonctionnera la base de données ?
Image Docker
Nous commençons par la construction de l'image Docker.
L'option idéale est d'avoir une unique image universelle, à partir de laquelle nous obtenons les pods workers, les pods avec tâches cron, et les pods de mise à niveau.
.
Elle inclut nginx, apache/php-fpm (choisissable lors de la construction), msmtp pour l'envoi d'e-mails, et cron.
Lors de la construction de l'image, l'intégralité de la base de code du site est copiée dans le répertoire /app (sauf les parties que nous déplacerons dans un stockage partagé séparé).
Microservices, services
Pods workers :
- Conteneur avec nginx + conteneur apache/php-fpm + msmtp
- msmtp n'a pas pu être séparé en un microservice distinct, Bitrix commence à s'agiter car il ne peut pas envoyer des e-mails directement.
- Chaque conteneur contient l'intégralité de la base de code.
- Interdiction de modifier le code dans les conteneurs.
Pod cron :
- Conteneur avec apache, php, cron
- Contient l'intégralité de la base de code
- Interdiction de modifier le code dans les conteneurs
Pod de mise à niveau :
- Conteneur avec nginx + conteneur apache/php-fpm + msmtp
- Pas d'interdiction de modifier le code dans les conteneurs
Stockage des sessions
Stockage du cache Bitrix
Encore important : les mots de passe pour se connecter à tout, de la base de données jusqu'à l'email, sont stockés dans les secrets Kubernetes. Nous bénéficions d'un avantage : seulement ceux à qui nous donnons accès aux secrets peuvent voir les mots de passe, et non tous ceux qui ont accès à la base de code du projet.
Stockage pour les fichiers statiques
On peut utiliser n'importe quoi : ceph, nfs (mais nous ne recommandons pas nfs pour la production), stockage réseau de fournisseurs ‘cloud’, etc.
Le stockage doit être monté dans les conteneurs dans le répertoire /upload/ du site et d'autres répertoires contenant des fichiers statiques.
Base de données
Pour simplifier, nous recommandons de déplacer la base de données en dehors de Kubernetes. Avoir une base de données dans Kubernetes est une tâche complexe, elle rendra l'architecture beaucoup plus compliquée.
Stockage des sessions
Nous utilisons memcached 🙂
Il gère bien le stockage des sessions, se clusterise, et est pris en charge «nativement» comme session.save_path dans php. Ce système a été éprouvé à plusieurs reprises dans l'architecture monolithique classique, lorsque nous construisions des clusters avec un grand nombre de serveurs web. Pour le déploiement, nous utilisons helm.
$ helm install stable/memcached --name sessionphp.ini — ici, dans l'image, les paramètres pour le stockage des sessions dans memcached sont définis
Nous avons utilisé des variables d'environnement pour transmettre les données des hôtes avec memcached .
Cela permet d'utiliser le même code dans les environnements dev, stage, test, prod (les noms des hôtes memcached y seront différents, donc pour chaque environnement, nous devons transmettre un nom d'hôte unique pour les sessions).
Stockage du cache Bitrix
Nous avons besoin d'un stockage résilient, dans lequel tous les pods pourraient écrire et à partir duquel ils pourraient lire.
Nous utilisons également memcached.
Cette solution est recommandée par Bitrix lui-même.
$ helm install stable/memcached --name cachebitrix/.settings_extra.php — ici, dans Bitrix, nous définissons où notre cache est stocké
Nous utilisons également des variables d'environnement.
Les cronjobs
Il existe plusieurs approches pour exécuter des cronjobs dans Kubernetes.
- un déploiement séparé avec un pod pour l'exécution des cronjobs
- cronjob pour exécuter des cronjobs (si c'est une application web — avec wget , ou kubectl exec à l'intérieur d'un des pods de travail, etc.)
- etc.
On peut débattre de la meilleure méthode, mais dans ce cas, nous avons choisi l'option «déploiement séparé avec des pods pour les cronjobs»
Comment cela est fait :
- nous ajoutons les cron-tâches via ConfigMap ou via le fichier config/addcron
- nous exécutons un conteneur identique au pod de travail + autorisons l'exécution des cron-tâches en son sein
- la même base de code est utilisée, grâce à l'unification le processus de construction du conteneur est simple
Ce que nous obtenons de bon :
- nous avons des cron-tâches fonctionnant dans un environnement identique à celui des développeurs (docker)
- les cron-tâches n'ont pas besoin d'être «réécrites» pour Kubernetes, elles fonctionnent de la même manière et avec la même base de code qu'auparavant
- tous les membres de l'équipe ayant des droits de commit dans la branche de production peuvent ajouter des cron-tâches, pas seulement les administrateurs
Le module Southbridge K8SDeploy et l'édition du code depuis le panneau d'administration
Nous parions sur l'upgrade des pods ?
Comment diriger le trafic là-bas ?
Youpi, nous avons écrit un module pour cela en php 🙂 C'est un petit module classique pour Bitrix. Il n'est pas encore disponible publiquement, mais nous prévoyons de le rendre accessible.
Le module s'installe comme un module classique dans Bitrix :
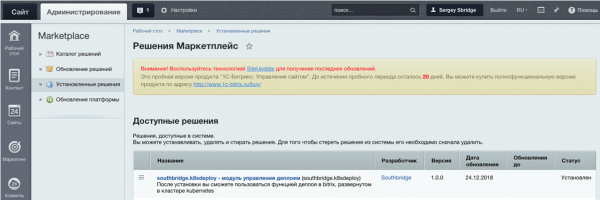
Et il ressemble à ceci :
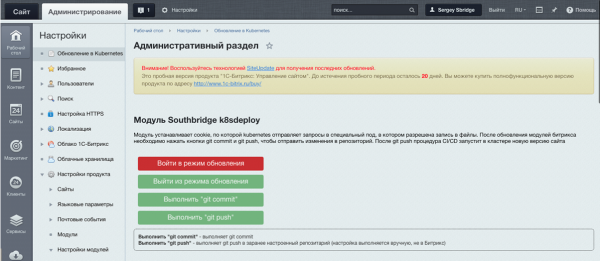
Il permet de définir un cookie qui identifie l'administrateur du site et permet à Kubernetes d'envoyer le trafic vers le pod de mise à niveau.
Une fois les modifications terminées, il faut appuyer sur git push, les modifications du code seront envoyées dans git, puis le système générera une image avec la nouvelle version du code et la « déploiera » dans le cluster, remplaçant les anciens pods.
Oui, c'est un peu bricolé, mais cela nous permet de conserver l'architecture microservices et de ne pas retirer aux utilisateurs de Bitrix leur fonctionnalité préférée de modification du code depuis l'interface d'administration. Après tout, c'est une option, la tâche de modification du code peut être résolue différemment.
Chart Helm
Pour assembler des applications dans Kubernetes, nous utilisons généralement le gestionnaire de paquets Helm.
Pour notre solution Bitrix dans Kubernetes, Sergey Bondarev, notre administrateur système principal, a écrit un chart Helm spécial.
Il assemble les workers, les pods de mise à niveau, les pods cron, configure les ingress, les services, et transmet les variables des secrets Kubernetes aux pods.
Nous stockons le code dans Gitlab, et nous lançons également l'assemblage Helm depuis Gitlab.
En bref, cela ressemble à ceci
$ helm upgrade --install project .helm --set image=registrygitlab.local/k8s/bitrix -f .helm/values.yaml --wait --timeout 300 --debug --tiller-namespace=productionHelm permet également de faire un retour « sans couture », si quelque chose ne va pas lors du déploiement. C'est agréable de voir que Kubernetes le fait automatiquement, sans temps d'arrêt, plutôt que vous soyez en panique à « réparer le code par FTP parce que la production est tombée ».
Déployer
Oui, nous sommes fans de Gitlab & Gitlab CI, nous l'utilisons 🙂
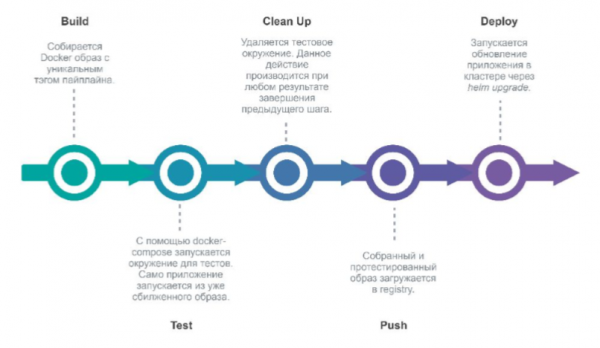
Lors d'un commit dans Gitlab dans le répertoire du projet, Gitlab lance un pipeline qui déploie la nouvelle version de l'environnement.
Étapes :
- build (assemblons une nouvelle image Docker)
- test (testons)
- clean up (supprimons l'environnement de test)
- push (envoyons-le dans le registre Docker)
- deploy (déployons l'application dans Kubernetes via Helm).
Hourra, c'est prêt, nous déployons !
Ou nous posons des questions, s'il y en a.
Alors, qu'avons-nous fait
D'un point de vue technique :
- nous avons dockerisé Bitrix;
- nous avons « découpé » Bitrix en conteneurs, chacun remplissant un minimum de fonctions;
- nous avons atteint un état sans état des conteneurs;
- nous avons résolu le problème de mise à jour de Bitrix dans Kubernetes;
- toutes les fonctionnalités de Bitrix ont continué à fonctionner (presque toutes);
- nous avons bien géré le déploiement dans Kubernetes et le retour entre les versions.
D'un point de vue commercial :
- haute disponibilité;
- outils Kubernetes (intégration simple avec Gitlab CI, déploiement sans couture, etc);
- mots de passe dans des secrets (visibles uniquement pour ceux à qui l'accès aux mots de passe est directement accordé);
- Il est pratique de créer des environnements supplémentaires (pour le développement, les tests, etc.) au sein d'une seule infrastructure.
Source : habr.com
