

Bonjour à tous. Amis, nous partageons avec vous la traduction d'un article, préparée spécialement pour les étudiants du cours . Allons-y !
Apache Beam et DataFlow pour des pipelines en temps réel
Le post d'aujourd'hui est basé sur une tâche sur laquelle j'ai récemment travaillé. J'étais vraiment heureux de la réaliser et de décrire le travail effectué sous forme de billet de blog, car cela m'a donné l'occasion de m'exercer au data engineering et aussi de faire quelque chose qui serait très utile pour mon équipe. Il n'y a pas si longtemps, j'ai découvert que nos systèmes contenaient un nombre assez important de journaux d'utilisateurs liés à l'un de nos produits de traitement de données. Il s'est avéré que personne n'utilisait ces données, donc je me suis tout de suite intéressé à ce que nous pourrions apprendre si nous commencions à les analyser régulièrement. Cependant, il y avait quelques problèmes en chemin. Le premier problème était que les données étaient stockées dans plusieurs fichiers texte différents, qui n'étaient pas accessibles pour une analyse instantanée. Le deuxième problème était qu'elles étaient enregistrées dans un système fermé, donc je ne pouvais pas utiliser aucun de mes outils préférés pour l'analyse de données.
Je devais déterminer comment faciliter l'accès pour nous et apporter une certaine valeur en intégrant cette source de données dans certaines de nos solutions d'interaction avec les utilisateurs. Après avoir réfléchi un moment, j'ai décidé de construire un pipeline pour transférer ces données dans une base de données cloud, afin que mon équipe et moi puissions y accéder et commencer à générer des conclusions. Après avoir terminé ma spécialisation en Data Engineering sur Coursera il y a quelque temps, j'étais impatient d'utiliser certains outils du cours dans le projet.
Ainsi, le stockage des données dans une base de données cloud semblait être une solution raisonnable à mon premier problème, mais que pouvais-je faire avec le problème numéro 2 ? Heureusement, il y avait un moyen de transférer ces données dans un environnement où je pouvais accéder à des outils comme Python et Google Cloud Platform (GCP). Cependant, c'était un processus long, donc je devais faire quelque chose qui me permettrait de continuer le développement pendant que j'attendais que le transfert de données soit terminé. La solution à laquelle je suis parvenu consistait à créer des données fictives à l'aide de la bibliothèque Faker en Python. Je n'avais jamais utilisé cette bibliothèque auparavant, mais j'ai rapidement compris à quel point elle était utile. L'utilisation de cette approche m'a permis de commencer à écrire du code et à tester le pipeline sans données réelles.
Ceci dit, dans ce post, je vais expliquer comment j'ai construit le pipeline décrit ci-dessus en utilisant certaines des technologies disponibles dans GCP. En particulier, je vais utiliser Apache Beam (version Python), Dataflow, Pub/Sub et BigQuery pour collecter des journaux utilisateur, transformer les données et les transférer dans une base de données pour une analyse ultérieure. Dans mon cas, j'avais uniquement besoin de la fonctionnalité par lots de Beam, car mes données ne provenaient pas en temps réel, donc Pub/Sub n'était pas nécessaire. Cependant, je vais m'arrêter sur la version en streaming, car c'est quelque chose que vous pourriez rencontrer dans la pratique.
Introduction à GCP et Apache Beam
Google Cloud Platform fournit un ensemble d'outils vraiment utiles pour le traitement des Big Data. Voici quelques-uns des outils que je vais utiliser :
- est un service de messagerie utilisant le modèle Éditeur-Abonné (Publisher-Subscriber), qui nous permet de recevoir des données en temps réel.
- est un service qui simplifie la création de pipelines de données et résout automatiquement des tâches telles que la mise à l'échelle de l'infrastructure, ce qui signifie que nous pouvons nous concentrer uniquement sur l'écriture du code pour notre pipeline.
- est un stockage de données cloud. Si vous êtes familier avec d'autres bases de données SQL, vous ne mettrez pas longtemps à comprendre BigQuery.
- Et enfin, nous utiliserons Apache Beam, en nous concentrant spécifiquement sur la version Python pour créer notre pipeline. Cet outil nous permettra de créer un pipeline de traitement en temps réel ou par lots, qui s'intègre à GCP. Il est particulièrement utile pour le traitement parallèle et convient aux tâches de type extraction, transformation et chargement (ETL), donc si nous avons besoin de déplacer des données d'un endroit à un autre tout en effectuant des transformations ou des calculs, Beam est un bon choix.
Il existe une grande variété d'outils disponibles sur GCP, il peut donc être difficile de tous les retracer et de comprendre leur but, mais voici un résumé à titre de référence.
Il y a un grand nombre d'outils disponibles sur GCP, donc il peut être complexe de les couvrir tous, y compris leur usage, néanmoins un résumé pour référence.
Visualisation de notre pipeline
Visualisons les composants de notre pipeline dans l'illustration 1. Dans l'ensemble, nous souhaitons collecter les données des utilisateurs en temps réel, les traiter et les envoyer dans BigQuery. Des journaux sont créés lorsque les utilisateurs interagissent avec le produit, en envoyant des requêtes au serveur qui sont alors enregistrées. Ces données peuvent être particulièrement utiles pour comprendre comment les utilisateurs interagissent avec notre produit et s'il fonctionne comme prévu. En général, le pipeline comprendra les étapes suivantes :
Beam facilite énormément ce processus, que nous ayons une source de données en streaming ou un fichier CSV, et que nous souhaitions effectuer un traitement par lots. Vous verrez plus tard que le code nécessite seulement des modifications minimales pour passer d'un mode à l'autre. C'est l'un des avantages de l'utilisation de Beam.
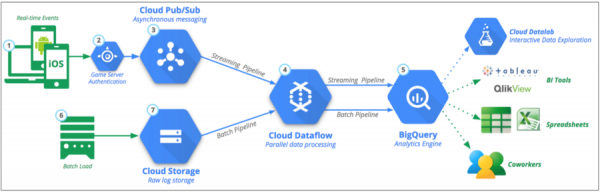
Illustration 1 : Pipeline des données principal : Source :
Génération de données fictives avec Faker
Comme je l'ai mentionné précédemment, en raison d'un accès limité aux données, j'ai décidé de créer des données fictives dans le même format que les réelles. C'était un exercice vraiment utile, car je pouvais écrire du code et tester le pipeline pendant que j'attendais les données. Je vous propose de jeter un œil à Faker, si vous souhaitez découvrir ce que cette bibliothèque peut encore offrir. Nos données utilisateurs seront généralement similaires à l'exemple ci-dessous. Sur la base de ce format, nous pouvons générer des données ligne par ligne pour simuler des données en temps réel. Ces journaux nous fournissent des informations telles que la date, le type de demande, la réponse du serveur, l'adresse IP, etc.
192.52.197.161 - - [30/Apr/2019:21:11:42] "PUT /tag/category/tag HTTP/1.1" [401] 155 "https://harris-lopez.com/categories/about/" "Mozilla/5.0 (Macintosh; PPC Mac OS X 10_11_2) AppleWebKit/5312 (KHTML, like Gecko) Chrome/34.0.855.0 Safari/5312"
En nous basant sur la ligne ci-dessus, nous souhaitons créer notre variable LIGNE, en utilisant 7 variables dans les accolades ci-dessous. Nous allons également les utiliser comme noms de variables dans notre schéma de table un peu plus tard.
LIGNE = """
 {remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
 """
Si nous effectuions un traitement par lots, le code serait très similaire, bien que nous devrions créer un ensemble d'échantillons dans une certaine plage de temps. Pour utiliser Faker, nous créons simplement un objet et appelons les méthodes dont nous avons besoin. En particulier, Faker a été utile pour créer des adresses IP ainsi que des sites Web. J'ai utilisé les méthodes suivantes :
fake.ipv4()
 fake.uri_path()
 fake.uri()
 fake.user_agent()
from faker import Faker
import time
import random
import os
import numpy as np
from datetime import datetime, timedelta


LIGNE = """
{remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
"""


def generate_log_line():
    fake = Faker()
    now = datetime.now()
    remote_addr = fake.ipv4()
    time_local = now.strftime('%d/%b/%Y:%H:%M:%S')
    request_type = random.choice(["GET", "POST", "PUT"])
    request_path = "/" + fake.uri_path()

    status = np.random.choice([200, 401, 404], p=[0.9, 0.05, 0.05])
    body_bytes_sent = random.choice(range(5, 1000, 1))
    http_referer = fake.uri()
    http_user_agent = fake.user_agent()

    log_line = LIGNE.format(
        remote_addr=remote_addr,
        time_local=time_local,
        request_type=request_type,
        request_path=request_path,
        status=status,
        body_bytes_sent=body_bytes_sent,
        http_referer=http_referer,
        http_user_agent=http_user_agent
    )

    return log_line
Fin de la première partie.
Nous partagerons avec vous la suite de l'article dans les prochains jours, et en attendant, nous attendons vos commentaires ;-).
Source : habr.com
