

Bonjour, je m'appelle Evgueni, je suis le responsable de l'équipe B2B chez Ситимобил. L'une des tâches de notre équipe consiste à soutenir les intégrations des commandes de taxi de nos partenaires, et pour assurer un service stable, nous devons toujours comprendre ce qui se passe dans nos microservices. Pour cela, nous devons surveiller en permanence les logs.
Chez Ситимобил, nous utilisons la pile ELK (ElasticSearch, Logstash, Kibana) pour travailler avec les logs, et le volume des données qui y arrivent est énorme. Trouver dans cette masse de requêtes les problèmes pouvant survenir après le déploiement d'un nouveau code est assez complexe. Pour les mettre en évidence visuellement, il existe une section Dashboard dans Kibana.
Il y a beaucoup d'articles sur Habr avec des exemples de configuration de la pile ELK pour recevoir et stocker des données, mais il n'existe pas de matériel actuel sur la création de Dashboard. C'est pourquoi je souhaite montrer comment créer une représentation visuelle des données dans Kibana à partir des logs entrants.
Configuration
Pour plus de clarté, j'ai créé une image Docker avec ELK et Filebeat. J'ai placé dans le conteneur un petit en Go, qui générera des logs de test pour notre exemple. Je ne vais pas détailler la configuration d'ELK, il y a déjà suffisamment d'informations à ce sujet sur Habr.
Nous clonons le référentiel avec la configuration docker-compose et les paramètres d'ELK, et nous le lançons avec la commande docker-compose up. J'ajoute intentionnellement la clé -d, afin de voir le processus de fonctionnement de la pile ELK.
git clone https://github.com/et-soft/habr-elk
cd habr-elk
docker-compose up
Si tout est correctement configuré, nous devrions voir dans les logs l'enregistrement (peut-être pas immédiatement, car le processus de démarrage du conteneur avec toute la pile peut prendre plusieurs minutes) :
{"type":"log","@timestamp":"2020-09-20T05:55:14Z","tags":["info","http","server","Kibana"],"pid":6,"message":"http server running at http://0:5601"}
À l'adresse localhost:5061 Kibana devrait s'ouvrir.
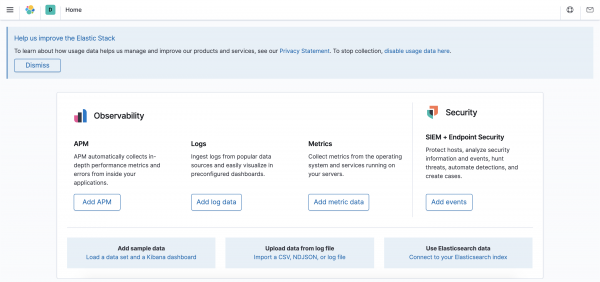
La seule chose que nous devons configurer est de créer un Index Pattern pour Kibana contenant des informations sur les données à afficher. Pour cela, nous effectuerons une requête curl ou entreprendrons une série d'actions dans l'interface graphique.
$ curl -XPOST -D- 'http://localhost:5601/api/saved_objects/index-pattern'
     -H 'Content-Type: application/json'
     -H 'kbn-xsrf: true'
     -d '{"attributes":{"title":"logstash-*","timeFieldName":"@timestamp"}}'
Création d'un Index Pattern via l'interface graphique
Pour la configuration, nous choisissons dans le menu de gauche la section Discover, et nous accédons à la page de création de l'Index Pattern.
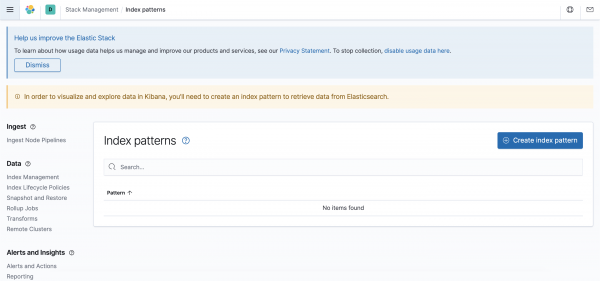
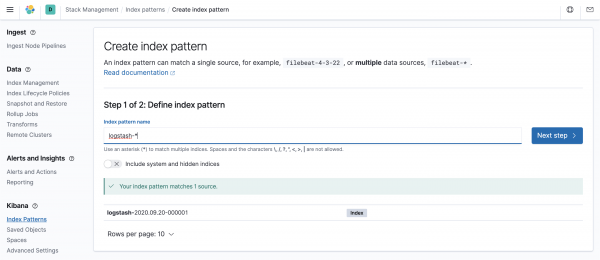
En cliquant sur le bouton « Create index pattern », nous accédons à la page de création de l'index. Dans le champ « Index pattern name », nous entrons « logstash-* ». Si tout est correctement configuré, Kibana affichera ci-dessous les index concernés par la règle.
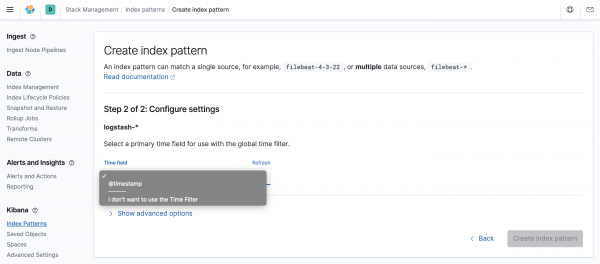
À la page suivante, nous choisissons le champ clé avec l'horodatage, dans notre cas c'est @timestamp.
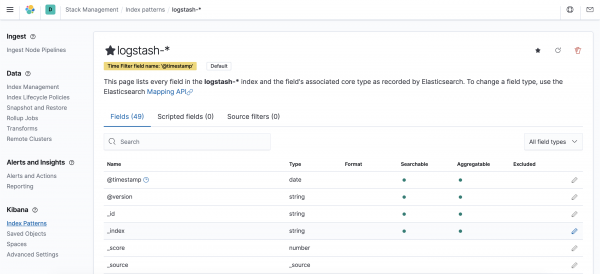
Cela nous amène à la page des paramètres d'index, mais pour l'instant, aucune action supplémentaire de notre part n'est requise.
Nous pouvons maintenant retourner dans la section Discover, où nous verrons les enregistrements des journaux.
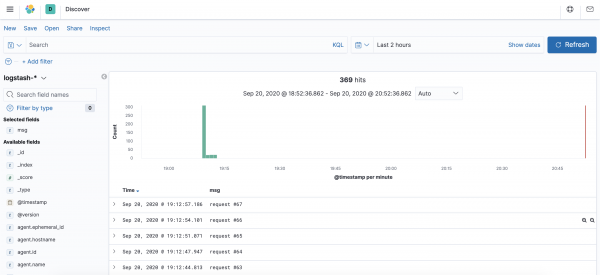
Tableau de bord
Dans le menu de gauche, cliquez sur la section de création du tableau de bord et accédez à la page correspondante.
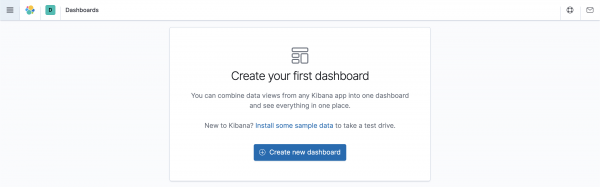
Cliquez sur «Créer un nouveau tableau de bord» et accédez à la page d'ajout d'objets au tableau de bord.
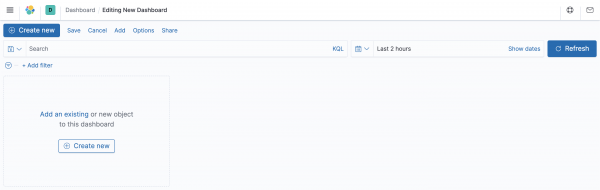
Cliquez sur le bouton «Créer nouveau», et le système proposera de choisir le type d'affichage des données. Il y en a beaucoup dans Kibana, mais nous allons examiner la création d'une représentation graphique «Barre verticale» et d'un tableau «Table de données». Les autres types de représentations se configurent de manière similaire.
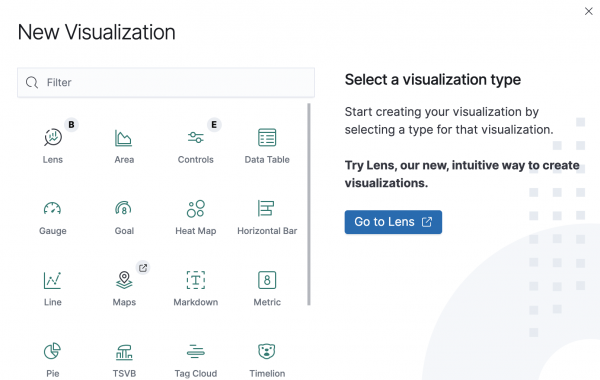
Certains objets disponibles portent des étiquettes B et E — cela signifie que le format est expérimental ou en phase de bêta-test. Avec le temps, le format peut changer ou disparaître complètement de Kibana.
Barre verticale
Pour l'exemple «Barre verticale», nous allons créer un histogramme montrant le rapport entre les statuts de réponse réussis et non réussis de notre service. À la fin des réglages, nous obtiendrons le graphique suivant :
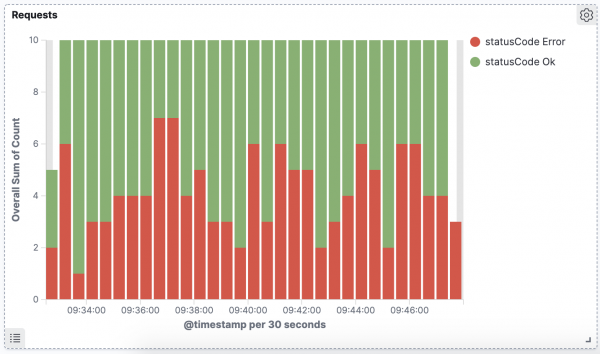
Nous considérerons comme réussis toutes les requêtes avec un statut de réponse = 400.
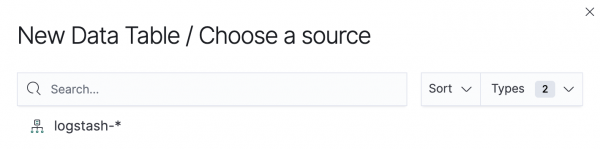
Pour créer le graphique «Barre verticale», nous devons choisir la source de données. Sélectionnez le modèle d'index que nous avons créé précédemment.
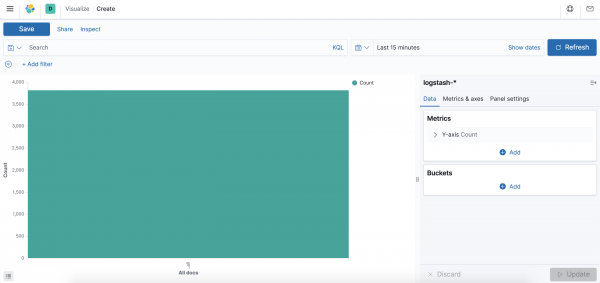
Par défaut, après avoir sélectionné la source de données, un graphique continu apparaîtra. Configurons-le.
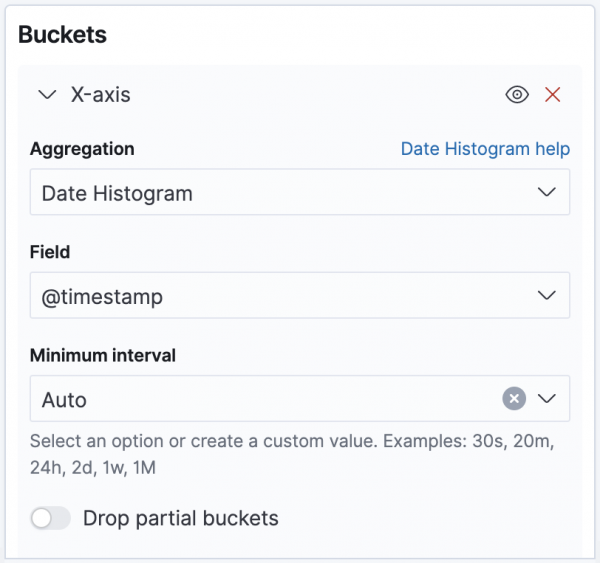
Dans le bloc «Buckets», cliquez sur le bouton «Ajouter», sélectionnez «Axe X» et configurez l'axe X. Nous allons y indiquer les timestamps des enregistrements dans le journal. Dans le champ «Aggregation», choisissez «Histogramme de dates», et dans «Field», sélectionnez «@timestamp», indiquant le champ temporel. L'intervalle minimum sera laissé sur «Auto», et il s'ajustera automatiquement à notre affichage.
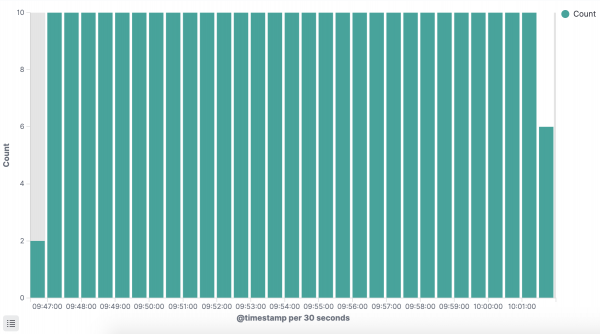
En cliquant sur le bouton «Mettre à jour», nous verrons le graphique avec le nombre de requêtes toutes les 30 secondes.
Configurons maintenant les colonnes sur l'axe Y. Actuellement, nous affichons le nombre total de requêtes dans l'intervalle de temps sélectionné.
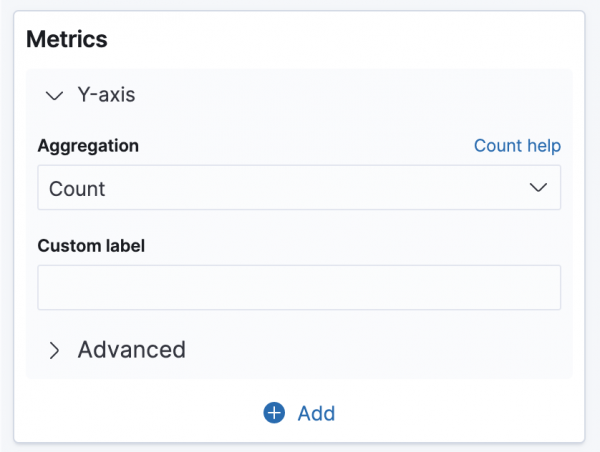
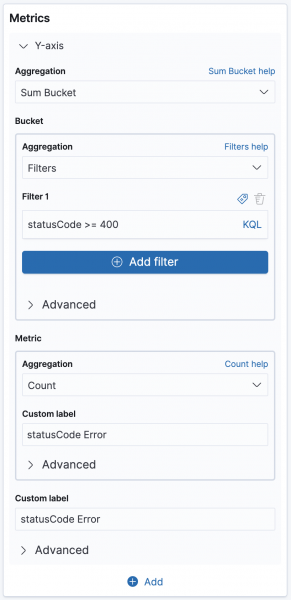
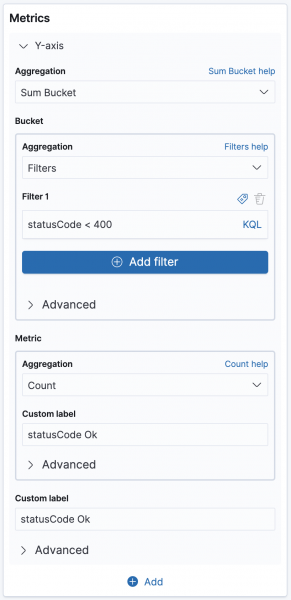
Changeons la valeur «Aggregation» en «Somme des buckets», ce qui nous permettra de combiner les données des requêtes réussies et non réussies. Dans le bloc Bucket -> Aggregation, choisissons l'agrégation par «Filtres» et définissons un filtre selon «statusCode >= 400». Dans le champ «Étiquette personnalisée», indiquons le nom de notre indicateur pour un affichage plus compréhensible dans la légende sur le graphique et dans la liste générale.
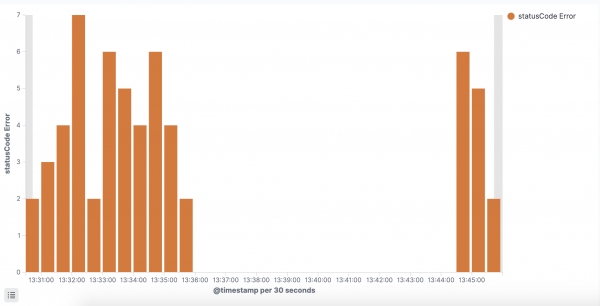
En cliquant sur le bouton «Mettre à jour» sous le bloc de réglages, nous obtiendrons un graphique avec les requêtes problématiques.
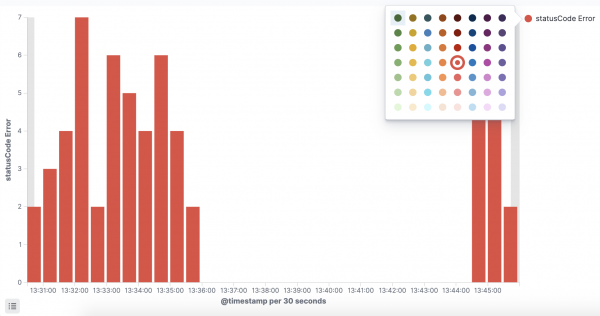
Si vous cliquez sur le cercle près de la légende, une fenêtre apparaîtra où vous pourrez changer la couleur des colonnes.
Ajoutons maintenant des données sur les requêtes réussies au graphique. Dans la section « Metrics », cliquez sur le bouton « Add » et sélectionnez « Y-axis ».
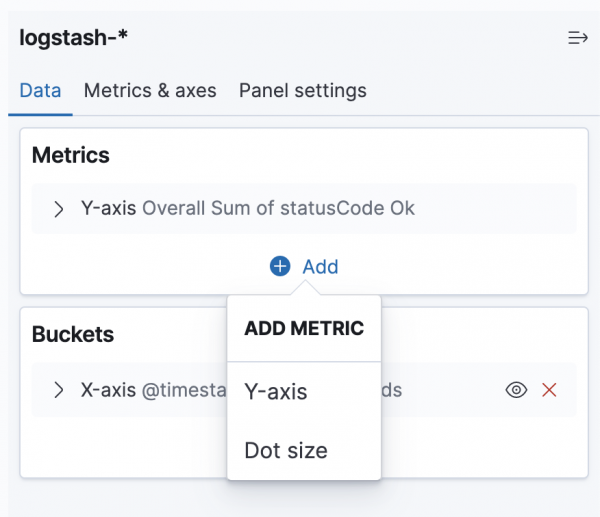
Pour la métrique créée, configurez les mêmes paramètres que pour les requêtes erronées. Dans le filtre, indiquez simplement « statusCode < 400 ».
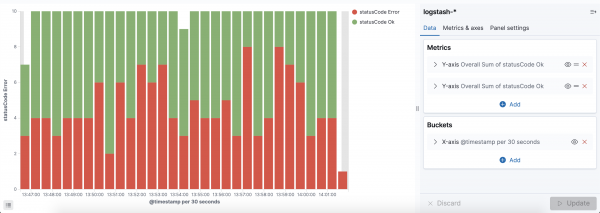
En changeant la couleur de la nouvelle colonne, nous obtiendrons un affichage du rapport entre les requêtes problématiques et réussies.
En cliquant sur le bouton « Save » en haut de l'écran et en indiquant un nom, nous verrons le premier graphique sur le Dashboard.
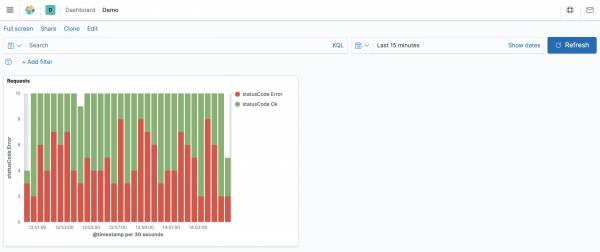
Tableau de données
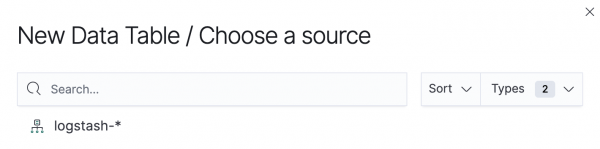
Examinons maintenant la représentation tabulaire « Data Table ». Créons un tableau avec la liste de toutes les URL auxquelles il y a eu des requêtes et le nombre de ces requêtes. Comme dans l'exemple du Vertical Bar, sélectionnez d'abord la source de données.
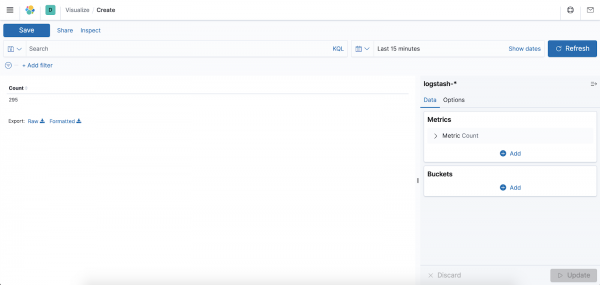
Après cela, un tableau avec une seule colonne s'affichera à l'écran, montrant le nombre total de requêtes pour l'intervalle de temps choisi.
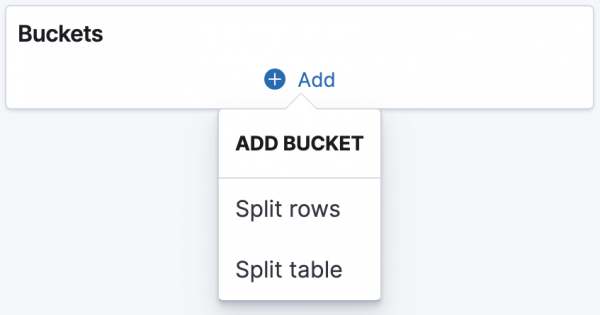
Nous allons modifier uniquement le bloc « Buckets ». Cliquez sur le bouton « Add » et choisissez « Split rows ».
Dans le champ « Aggregation », sélectionnez « Terms ». Dans le champ qui apparaît, choisissez « url.keyword ».
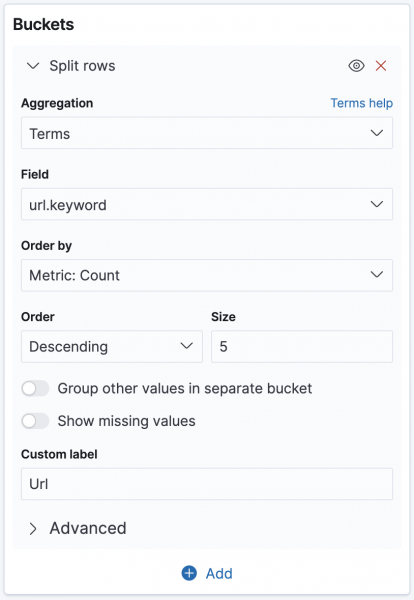
En indiquant dans le champ « Custom label » la valeur « Url » et en cliquant sur « Update », nous obtiendrons le tableau désiré avec le nombre de requêtes pour chaque URL sur la période choisie.
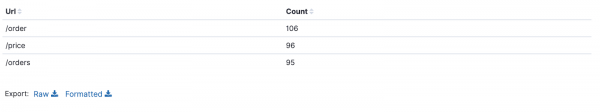
En haut de l'écran, cliquez à nouveau sur le bouton « Save » et indiquez le nom du tableau, par exemple Urls. Revenons ensuite au Dashboard et nous verrons les deux visualisations créées.
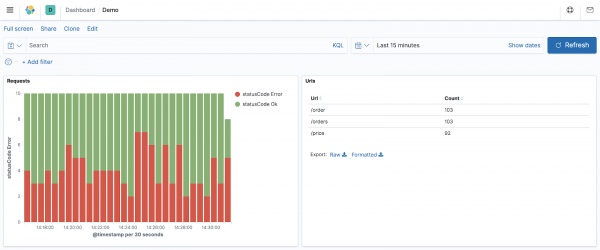
Travail avec le Dashboard
En créant un Dashboard, dans les paramètres des objets de visualisation, nous n'avons défini que les paramètres principaux de l'affichage. Il n'est pas nécessaire d'indiquer dans les objets les données pour les filtres, par exemple, « plage de dates », « filtrage par useragent », « filtrage par pays de requête », etc. Il est beaucoup plus pratique de préciser l'intervalle de temps souhaité ou d'appliquer le filtrage nécessaire dans le panneau de requêtes, situé au-dessus des objets.

Les filtres ajoutés sur ce panneau seront appliqués à l'ensemble du Dashboard et tous les objets de visualisation seront réorganisés en fonction des données filtrées actuelles.
Conclusion
Kibana est un puissant outil permettant de visualiser n'importe quelles données de manière pratique. J'ai essayé de montrer la configuration de deux types d'affichage principaux. Mais d'autres types peuvent être configurés de manière similaire. Les nombreuses options que j'ai laissées « hors caméra » vous permettront de configurer les graphiques de manière très flexible selon vos besoins.
Source : habr.com
