

Le kube-scheduler est un composant essentiel de Kubernetes, chargé de la planification des pods sur les nœuds selon des politiques définies. Souvent, lors de l'exploitation d'un cluster Kubernetes, nous n'avons pas à nous soucier des politiques selon lesquelles les pods sont planifiés, car l'ensemble des politiques par défaut du kube-scheduler est adapté à la plupart des tâches quotidiennes. Cependant, il existe des situations où il est essentiel de gérer finement le processus de répartition des pods, et il y a deux approches pour cela :
- Créer un kube-scheduler avec un ensemble de règles personnalisé
- Écrire notre propre scheduler et lui apprendre à fonctionner avec les requêtes du serveur API
Dans cet article, je vais décrire la mise en œuvre du premier point pour résoudre le problème de la planification inégale des pods sur l'un de nos projets.
Introduction brève au fonctionnement du kube-scheduler
Il est important de noter que le kube-scheduler ne se charge pas de la planification directe des pods — il se contente de déterminer le nœud sur lequel le pod doit être déployé. En d'autres termes, le résultat du travail du kube-scheduler est le nom du nœud, qu'il renvoie au serveur API lors de la demande de planification, et c'est ainsi que s'arrête son travail.
D'abord, le kube-scheduler élabore une liste de nœuds sur lesquels le pod peut être planifié en fonction des politiques de predicates. Ensuite, chaque nœud de cette liste reçoit un certain nombre de points selon les politiques de priorites. À la suite de cela, le nœud ayant le maximum de points est sélectionné. Si plusieurs nœuds obtiennent le même score maximum, l'un d'eux est choisi au hasard. Vous pouvez consulter la liste et la description des politiques de predicates (filtrage) et de priorites (notation) dans .
Description du problème
Malgré le grand nombre de clusters Kubernetes gérés par Nixys, nous avons rencontré pour la première fois le problème de la planification des pods récemment, lorsque nous avons eu besoin de lancer un grand nombre de tâches périodiques (~100 entités CronJob) pour l'un de nos projets. Pour simplifier au maximum la description du problème, prenons l'exemple d'un microservice dans lequel une tâche cron est exécutée chaque minute, générant une certaine charge sur le CPU. Trois nœuds totalement identiques en termes de caractéristiques (24 vCPU chacun) ont été alloués pour faire fonctionner cette tâche cron.
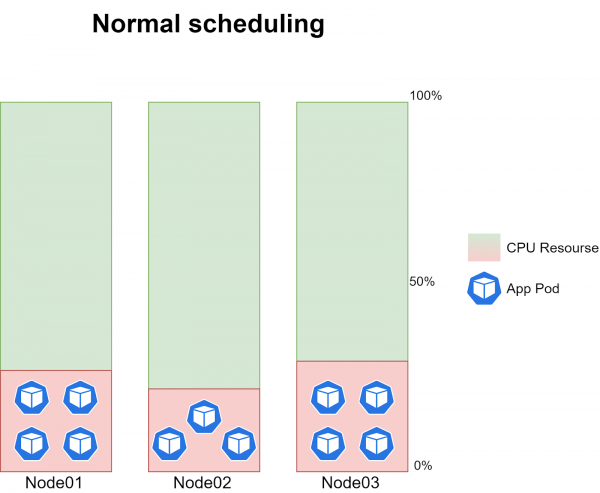
Cependant, il est impossible de dire avec précision combien de temps un CronJob prendra pour s'exécuter, car le volume des données d'entrée change constamment. En moyenne, lorsque le kube-scheduler fonctionne normalement, 3 à 4 instances de tâche s'exécutent sur chaque nœud, générant environ 20 à 30 % de la charge CPU de chaque nœud :
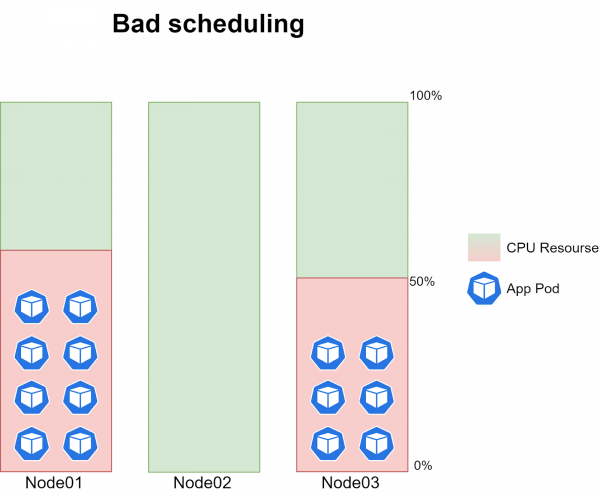
Le problème réside dans le fait que parfois, les pods des tâches cron ne se planifiaient plus sur l'un des trois nœuds. C'est-à-dire qu'à un moment donné, aucun pod n'était planifié sur un des nœuds, tandis que 6 à 8 instances de tâches fonctionnaient sur les deux autres nœuds, créant environ 40 à 60 % de la charge CPU :
Le problème se reproduisait avec une périodicité absolument aléatoire et corrélait parfois avec le moment où une nouvelle version du code était déployée.
En augmentant le niveau de journalisation du kube-scheduler à 10 (-v=10), nous avons commencé à enregistrer combien de points chaque nœud accumule au cours de l'évaluation. Lors d'une planification normale, les journaux permettaient de voir les informations suivantes :
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03 : BalancedResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 1387 millicores 4161694720 octets de mémoire, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02 : BalancedResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 1347 millicores 4444810240 octets de mémoire, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03 : LeastResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 1387 millicores 4161694720 octets de mémoire, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01 : BalancedResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 1687 millicores 4790840320 octets de mémoire, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02 : LeastResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 1347 millicores 4444810240 octets de mémoire, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01 : LeastResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 1687 millicores 4790840320 octets de mémoire, score 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01 : NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02 : NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03 : NodeAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01 : InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01 : TaintTolerationPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02 : InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02 : TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01 : SelectorSpreadPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03 : InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03 : TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02 : SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03 : SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01 : SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02 : SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03 : SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node01 -> Score 100043
generic_scheduler.go:781] Host Node02 -> Score 100043
generic_scheduler.go:781] Host Node03 -> Score 100043
C'est-à-dire qu'en selon les informations obtenues à partir des journaux, chaque nœud accumulait un nombre égal de points finaux et un choix aléatoire était fait pour la planification. Au moment de la planification problématique, les journaux ressemblaient à ceci :
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 1587 millicores 4581125120 octets de mémoire, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 1087 millicores 3532549120 octets de mémoire, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 1587 millicores 4581125120 octets de mémoire, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 987 millicores 3322833920 octets de mémoire, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 987 millicores 3322833920 octets de mémoire, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, capacité 23900 millicores 67167186944 octets de mémoire, demande totale 1087 millicores 3532549120 octets de mémoire, score 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node03 => Score 100041
generic_scheduler.go:781] Host Node02 => Score 100041
generic_scheduler.go:781] Host Node01 => Score 100038
Il ressort que l'un des nœuds a obtenu moins de points au total que les autres, et c'est pourquoi la planification s'est faite uniquement sur les deux nœuds ayant obtenu le maximum de points. Ainsi, nous avons pu nous assurer que le problème réside précisément dans la planification des pods.
L'algorithme suivant pour résoudre le problème était évident pour nous : analyser les journaux, comprendre selon quel critère le nœud n'a pas obtenu suffisamment de points et, si nécessaire, ajuster les politiques par défaut du kube-scheduler. Cependant, nous avons été confrontés à deux difficultés majeures :
- Au niveau de journalisation maximal (10), un ensemble de points est reflété uniquement pour certains critères. Dans l'extrait de journaux ci-dessus, on peut remarquer que pour tous les critères reflétés dans les journaux, les nœuds obtiennent le même nombre de points tant en planification normale qu'en planification problématique, cependant le résultat final en cas de planification problématique est différent. Ainsi, nous pouvons conclure que pour certains critères, le comptage des points se fait “hors caméra”, et nous n'avons aucun moyen de comprendre selon quel critère le nœud n'a pas obtenu de points. Nous avons décrit ce problème en détail dans le dépôt Kubernetes sur Github. Au moment de la rédaction de cet article, une réponse a été reçue des développeurs, indiquant que le support de la journalisation sera ajouté dans les mises à jour de Kubernetes v1.15, 1.16 et 1.17.
- Il n'y a pas de moyen simple de comprendre avec quel jeu de politiques le kube-scheduler travaille actuellement. Oui, dans cette liste il est mentionné, mais il n'y a pas d'informations sur les poids attribués à chacune des politiques prioritaires. Voir les poids ou modifier les politiques du kube-scheduler par défaut n'est possible que dans .
Il convient de noter qu'une fois, nous avons réussi à constater qu'un nœud n'avait pas obtenu de points selon la politique ImageLocalityPriority, qui attribue des points au nœud s'il a déjà l'image nécessaire au démarrage de l'application. Autrement dit, au moment du déploiement d'une nouvelle version de l'application, la tâche cron réussissait à se lancer sur deux nœuds, téléchargeant sur eux la nouvelle image depuis le docker registry, et ainsi, les deux nœuds obtenaient un score final supérieur par rapport au troisième.
Comme je l'ai mentionné plus haut, nous ne voyons pas d'informations dans les journaux concernant l'évaluation de la politique ImageLocalityPriority. Pour vérifier notre hypothèse, nous avons déployé une image avec la nouvelle version de l'application sur le troisième nœud, après quoi la planification a fonctionné correctement. C'est précisément à cause de la politique ImageLocalityPriority que le problème de planification se produisait assez rarement, il était souvent lié à autre chose. Étant donné que nous ne pouvions pas déboguer pleinement chacune des politiques de la liste des priorités par défaut du kube-scheduler, nous avons eu besoin d'une gestion flexible des politiques de planification des pods.
Définition du problème
Nous voulions que la solution du problème soit aussi ciblée que possible, c'est-à-dire que les entités principales de Kubernetes (nous faisons ici référence au kube-scheduler par défaut) doivent rester inchangées. Nous ne voulions pas résoudre le problème à un endroit et en créer un ailleurs. Ainsi, nous sommes arrivés à deux options de solution au problème, qui ont été mentionnées dans l'introduction de l'article — la création d'un scheduler supplémentaire ou l'écriture du nôtre. La principale exigence pour la planification des tâches cron est une répartition uniforme de la charge sur les trois nœuds. Cette exigence peut être satisfaite par des politiques existantes du kube-scheduler, il n'est donc pas nécessaire de rédiger notre propre scheduler pour résoudre notre problème.
Les instructions pour créer et déployer un kube-scheduler supplémentaire sont décrites dans . Cependant, il nous a semblé que les entités de déploiement ne suffisent pas à garantir la disponibilité d'un service aussi critique que le kube-scheduler, c'est pourquoi nous avons décidé de déployer un nouveau kube-scheduler en tant que pod statique, que Kubelet surveillera directement. Ainsi, nous avons établi les exigences suivantes pour le nouveau kube-scheduler :
- Le service doit être déployé en tant que pod statique sur tous les maîtres du cluster.
- Une tolérance aux pannes doit être prévue en cas d'indisponibilité du pod actif avec le kube-scheduler.
- La priorité principale lors de la planification doit être le nombre de ressources disponibles sur le nœud (LeastRequestedPriority).
Mise en œuvre de la solution
Il convient de noter tout de suite que tous les travaux seront réalisés dans Kubernetes v1.14.7, car c'est exactement cette version qui était utilisée dans le projet. Commençons par écrire le manifeste pour notre nouveau kube-scheduler. Prenons pour base le manifeste par défaut (\/etc\/kubernetes\/manifests\/kube-scheduler.yaml) et modifions-le comme suit :
kind: Pod
metadata:
  labels:
    component: scheduler
    tier: control-plane
  name: kube-scheduler-cron
  namespace: kube-system
spec:
      containers:
      - command:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        image: gcr.io/google-containers/kube-scheduler:v1.14.7
        imagePullPolicy: IfNotPresent
        livenessProbe:
          failureThreshold: 8
          httpGet:
            host: 127.0.0.1
            path: /healthz
            port: 10151
            scheme: HTTP
          initialDelaySeconds: 15
          timeoutSeconds: 15
        name: kube-scheduler-cron-container
        resources:
          requests:
            cpu: '0.1'
        volumeMounts:
        - mountPath: /etc/kubernetes/scheduler.conf
          name: kube-config
          readOnly: true
        - mountPath: /etc/localtime
          name: localtime
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom.conf
          name: scheduler-config
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom-policy-config.json
          name: policy-config
          readOnly: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volumes:
      - hostPath:
          path: /etc/kubernetes/scheduler.conf
          type: FileOrCreate
        name: kube-config
      - hostPath:
          path: /etc/localtime
        name: localtime
      - hostPath:
          path: /etc/kubernetes/scheduler-custom.conf
          type: FileOrCreate
        name: scheduler-config
      - hostPath:
          path: /etc/kubernetes/scheduler-custom-policy-config.json
          type: FileOrCreate
        name: policy-config
Résumé des principales modifications :
- Nous avons changé le nom du pod et du conteneur en kube-scheduler-cron
- Nous avons spécifié l'utilisation des ports 10151 et 10159 car l'option est définie
hostNetwork: trueet nous ne pouvons pas utiliser les mêmes ports que le kube-scheduler par défaut (10251 et 10259) - Avec le paramètre --config, nous avons spécifié le fichier de configuration à partir duquel le service doit démarrer
- Nous avons configuré le montage du fichier de configuration (scheduler-custom.conf) et du fichier de politiques de planification (scheduler-custom-policy-config.json) depuis l'hôte
N'oublions pas que notre kube-scheduler aura besoin de droits similaires à ceux du par défaut. Nous modifions son rôle de cluster :
kubectl edit clusterrole system:kube-scheduler...
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Maintenant, parlons de ce qui doit être contenu dans le fichier de configuration et le fichier des politiques de planification :
- Fichier de configuration (scheduler-custom.conf)
Pour obtenir la configuration du kube-scheduler par défaut, il faut utiliser le paramètre--write-config-tode . La configuration obtenue sera placée dans le fichier /etc/kubernetes/scheduler-custom.conf et prendra la forme suivante :
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Résumé des principales modifications :
- Nous avons défini dans schedulerName le nom de notre service kube-scheduler-cron.
- Dans le paramètre
lockObjectNameil faut aussi définir le nom de notre service et s'assurer que le paramètreleaderElectest réglé sur true (dans le cas où vous avez un seul nœud maître, vous pouvez le régler sur false). - Nous avons indiqué le chemin du fichier décrivant les politiques d'ordonnancement dans le paramètre
algorithmSource.
Il convient de s'arrêter plus en détail sur le deuxième point, où nous modifions les paramètres pour la clé leaderElection. Pour garantir la haute disponibilité, nous avons activé (leaderElect) le processus d'élection du leader (maître) entre les pods de notre kube-scheduler en utilisant un seul endpoint pour eux (resourceLock) nommé kube-scheduler-cron (lockObjectName) dans l'espace de noms kube-system (lockObjectNamespace). Pour en savoir plus sur la manière dont la haute disponibilité des composants principaux (y compris kube-scheduler) est assurée dans Kubernetes, vous pouvez consulter .
- Le fichier des politiques d'ordonnancement (scheduler-custom-policy-config.json)
Comme je l'ai mentionné précédemment, pour savoir avec quelles politiques spécifiques fonctionne le kube-scheduler par défaut, nous ne pouvons le faire qu'en analysant son code. Autrement dit, nous ne pouvons pas obtenir un fichier avec les politiques d'ordonnancement du kube-scheduler par défaut, à la manière d'un fichier de configuration. Nous allons décrire les politiques d'ordonnancement qui nous intéressent dans le fichier /etc/kubernetes/scheduler-custom-policy-config.json comme suit :
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Ainsi, le kube-scheduler établit d'abord une liste de nœuds sur lesquels un pod peut être programmé selon la politique GeneralPredicates (qui inclut un ensemble de politiques telles que PodFitsResources, PodFitsHostPorts, HostName et MatchNodeSelector). Ensuite, chaque nœud est évalué en fonction d'un ensemble de politiques dans le tableau des priorités. Pour répondre à notre besoin, nous avons estimé que cet ensemble de politiques serait la meilleure solution. Je rappelle que l'ensemble des politiques avec leur description détaillée est disponible dans . Pour accomplir votre tâche, vous pouvez simplement modifier l'ensemble des politiques utilisées et leur attribuer des poids correspondants.
Le manifeste de notre nouveau kube-scheduler, que nous avons créé au début du chapitre, sera nommé kube-scheduler-custom.yaml et sera placé au chemin suivant /etc/kubernetes/manifests sur les trois nœuds maîtres. Si tout est fait correctement, Kubelet sur chaque nœud lancera le pod, et dans les logs de notre nouveau kube-scheduler, nous verrons des informations indiquant que notre fichier de politiques a été appliqué avec succès :
Création du planificateur à partir de la configuration : {{ } [{GeneralPredicates }] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } }] [] 10 false}
Enregistrement du prédicat : GeneralPredicates
Le type de prédicat GeneralPredicates est déjà enregistré, réutilisation.
Enregistrement de la priorité : ServiceSpreadingPriority
Le type de priorité ServiceSpreadingPriority est déjà enregistré, réutilisation.
Enregistrement de la priorité : EqualPriority
Le type de priorité EqualPriority est déjà enregistré, réutilisation.
Enregistrement de la priorité : LeastRequestedPriority
Le type de priorité LeastRequestedPriority est déjà enregistré, réutilisation.
Enregistrement de la priorité : NodePreferAvoidPodsPriority
Le type de priorité NodePreferAvoidPodsPriority est déjà enregistré, réutilisation.
Enregistrement de la priorité : NodeAffinityPriority
Le type de priorité NodeAffinityPriority est déjà enregistré, réutilisation.
Création du planificateur avec des prédicats de compatibilité 'map[GeneralPredicates:{}]' et des fonctions de priorité 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Il ne reste plus qu'à indiquer dans le spec de notre CronJob que toutes les demandes de planification de ses pods doivent être traitées par notre nouveau kube-scheduler :
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Conclusion
En fin de compte, nous avons obtenu un kube-scheduler supplémentaire avec un ensemble unique de politiques de planification, dont le fonctionnement est surveillé directement par kubelet. De plus, nous avons configuré les élections d'un nouveau leader parmi les pods de notre kube-scheduler en cas d'indisponibilité de l'ancien leader pour une raison quelconque.
Les applications et services réguliers continuent à être planifiés via le kube-scheduler par défaut, tandis que toutes les tâches cron ont été entièrement transférées vers le nouveau. La charge générée par les tâches cron est maintenant répartie uniformément sur tous les nœuds. Étant donné que la majorité des tâches cron s'exécutent sur les mêmes nœuds que les applications principales du projet, cela a considérablement réduit le risque de migration des pods en raison d'un manque de ressources. Après l'implémentation d'un kube-scheduler supplémentaire, les problèmes de planification inégale des tâches cron ne se sont plus produit.
Lisez aussi d'autres articles sur notre blog :
Source : habr.com
