

Bonjour à tous ! Je m'appelle Kirill, je suis CTO chez Adapty. La majeure partie de notre architecture se trouve sur AWS, et aujourd'hui, je vais vous expliquer comment nous avons réduit nos coûts de serveur par trois grâce à l'utilisation d'instances Spot dans notre environnement de production, ainsi que comment configurer leur auto-scaling. D'abord, je donnerai un aperçu de son fonctionnement, puis une instruction détaillée pour le lancer.
Qu'est-ce que les instances Spot ?
instances Spot sont des serveurs d'autres utilisateurs d'AWS qui sont actuellement inoccupés, et ils les vendent avec une grande remise (Amazon affirme jusqu'à 90%, selon notre expérience environ 3x, cela varie en fonction de la région, de l'AZ et du type d'instance). Leur principale différence avec les instances classiques est qu'elles peuvent s'arrêter à tout moment. Nous avons longtemps pensé qu'elles étaient adaptées pour les environnements de développement ou pour des tâches de calcul avec des résultats intermédiaires sauvegardés sur S3 ou dans une base de données, mais pas pour la production. Il existe des solutions tierces qui permettent d'utiliser les Spot en production, mais elles nécessitent beaucoup de bricolage pour notre cas d'utilisation, c'est pourquoi nous ne les avons pas mises en œuvre. L'approche décrite dans cet article fonctionne entièrement dans le cadre des fonctionnalités standard d'AWS, sans scripts supplémentaires, cron jobs, etc.
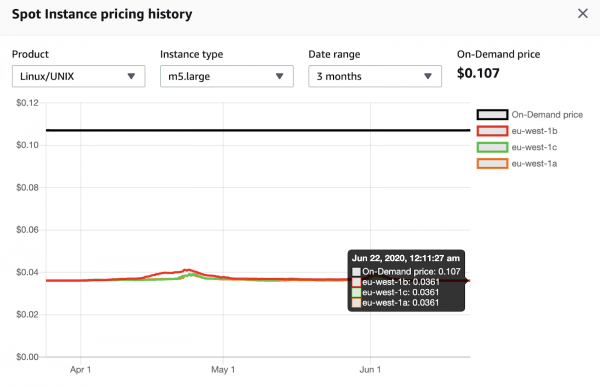
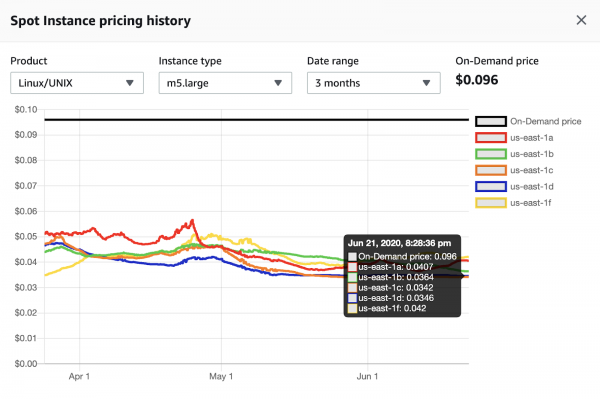
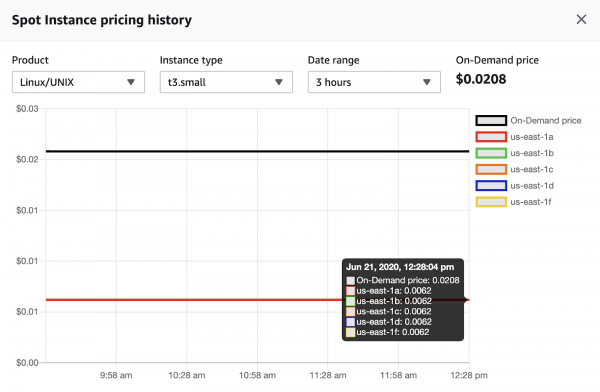
Voici quelques captures d'écran qui montrent l'historique des prix des instances Spot.
m5.large dans la région eu-west-1 (Irlande). Le prix est principalement stable depuis 3 mois, actuellement l'économie est de 2.9x.
m5.large dans la région us-east-1 (Virginie du Nord). Le prix change constamment pendant 3 mois, actuellement l'économie varie de 2.3x à 2.8x selon la zone de disponibilité.
t3.small dans la région us-east-1 (Virginie du Nord). Le prix est stable depuis 3 mois, actuellement l'économie est de 3.4x.
Architecture du service
L'architecture de base du service dont nous allons parler dans cet article est illustrée dans le diagramme ci-dessous.
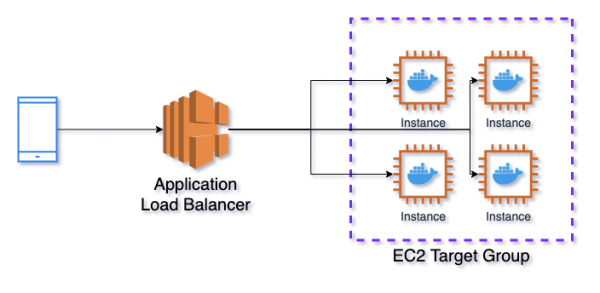
Application Load Balancer → EC2 Target Group → Elastic Container Service
Un Application Load Balancer (ALB) est utilisé comme équilibrage de charge, qui envoie des requêtes au EC2 Target Group (TG). Le TG est responsable de l'ouverture des ports sur les instances pour l'ALB et de leur liaison avec les ports des conteneurs Elastic Container Service (ECS). L'ECS est l'équivalent de Kubernetes sur AWS, qui gère les conteneurs Docker.
Un même instance peut exécuter plusieurs conteneurs fonctionnant sur les mêmes ports, c'est pourquoi nous ne pouvons pas les définir de manière fixe. ECS informe le TG qu'il lance une nouvelle tâche (appelée pod dans le jargon Kubernetes), il vérifie les ports disponibles sur l'instance et en attribue un à la tâche en cours. De plus, le TG vérifie régulièrement si l'instance fonctionne et si l'API y est opérationnelle grâce à un contrôle de santé, et s'il détecte des problèmes, il cesse d'y envoyer des requêtes.
Groupes de mise à l'échelle EC2 + Fournisseurs de capacité ECS
Le service EC2 Auto Scaling Groups (ASG) n'est pas représenté dans le diagramme ci-dessus. Comme son nom l'indique, il est responsable de la mise à l'échelle des instances. Cependant, jusqu'à récemment, AWS n'avait pas de fonctionnalité intégrée permettant de gérer le nombre de machines lancées depuis ECS. ECS permettait de faire évoluer le nombre de tâches, par exemple, en fonction de l'utilisation de CPU, de RAM ou du nombre de requêtes. Mais si les tâches prenaient toutes les instances disponibles, de nouvelles machines n'étaient pas automatiquement lancées.
Cela a changé avec l'introduction des Fournisseurs de capacité ECS (ECS CP). Maintenant, chaque service dans ECS peut être lié à un ASG, et si les tâches ne tiennent pas sur les instances en cours, de nouvelles instances seront créées (dans les limites définies par l'ASG). Cela fonctionne aussi dans l'autre sens, si ECS CP détecte des instances inactives sans tâches, il commandera à l'ASG de les éteindre. ECS CP a la possibilité de spécifier un pourcentage cible d'utilisation des instances, de sorte qu'un certain nombre de machines restent toujours disponibles pour un déploiement rapide des tâches, j'en parlerai un peu plus tard.
Modèles de lancement EC2
Le dernier service dont je vais parler avant de passer à une description détaillée de la création de cette infrastructure est les Modèles de lancement EC2. Il permet de créer un modèle selon lequel toutes les machines seront lancées, afin de ne pas répéter ce processus à chaque fois depuis le début. Ici, vous pouvez choisir le type de machine à lancer, le groupe de sécurité, l'image disque et beaucoup d'autres paramètres. Vous pouvez également spécifier des données utilisateur qui seront appliquées à toutes les instances lancées. Dans ces données utilisateur, vous pouvez exécuter des scripts, par exemple, il est possible de modifier le contenu du fichier .
Un des paramètres de configuration les plus importants dans le cadre de cet article est =true. Si ce paramètre est activé, dès qu'ECS reçoit le signal qu'une instance spot est retirée, il change le statut de toutes les tâches qui fonctionnent dessus à Draining. Aucune nouvelle tâche ne sera affectée à cette instance ; si des tâches souhaitent immédiatement être déployées sur celle-ci, elles seront annulées. Les requêtes du répartiteur de charge cessent également d'arriver. La notification de suppression de l'instance arrive 2 minutes avant l'événement réel. Donc, si votre service n'exécute pas des tâches pendant plus de 2 minutes et ne sauvegarde rien sur le disque, vous pouvez utiliser des instances spot sans perte de données.
Concernant le disque — AWS a récemment possible l'utilisation du Elastic File System (EFS) avec ECS, avec ce schéma même le disque ne représente pas un obstacle, mais nous ne l'avons pas essayé, car en principe, nous n'avons pas besoin de disque pour stocker l'état. Par défaut, après avoir reçu un SIGINT (envoyé au moment du changement de statut de la tâche à Draining), toutes les tâches en cours seront arrêtées après 30 secondes, même si elles n'ont pas eu le temps de s'exécuter ; ce temps peut être modifié avec le paramètre . L'essentiel est de ne pas le régler à plus de 2 minutes pour les machines spot.
Création du service
Passons directement à la création du service décrit. Au cours du processus, je vais décrire quelques points utiles supplémentaires qui n'ont pas été abordés précédemment. Dans l'ensemble, il s'agit d'un guide étape par étape, mais je ne vais pas aborder des cas très basiques ou très spécifiques. Toutes les actions s'effectuent dans la console visuelle AWS, mais elles peuvent être reproduites de manière programmatique avec CloudFormation ou Terraform. Chez Adapty, nous utilisons Terraform.
Template de lancement EC2
Dans ce service, une configuration des machines qui seront utilisées est créée. La gestion des modèles se déroule dans la section EC2 -> Instances -> Templates de lancement.
Image machine Amazon (AMI) — nous indiquons l'image de disque avec laquelle toutes les instances seront lancées. Pour ECS, dans la plupart des cas, il est conseillé d'utiliser l'image optimisée par Amazon. Elle est régulièrement mise à jour et contient tout le nécessaire pour le fonctionnement d'ECS. Pour connaître l'ID de l'image actuel, nous visitons la page , choisissons la région utilisée et copions l'ID AMI pour celle-ci. Par exemple, pour la région us-east-1, l'ID actuel au moment de la rédaction de cet article est ami-00c7c1cf5bdc913ed. Cet ID doit être inséré dans le champ Spécifier une valeur personnalisée.
Type d'instance — indiquez le type d'instance. Choisissez celui qui convient le mieux à votre tâche.
Clé de paire (connexion) — indiquez le certificat permettant de se connecter à l'instance via SSH, si nécessaire.
Paramètres réseau — indiquez les paramètres de réseau. Plateforme réseau dans la plupart des cas, cela devrait être un Virtual Private Cloud (VPC). Groupes de sécurité — groupes de sécurité pour vos instances. Comme nous allons utiliser un équilibreur de charge devant les instances, je recommande d'indiquer ici un groupe qui autorise les connexions entrantes uniquement depuis l'équilibreur de charge. Cela signifie que vous aurez 2 groupes de sécurité, un pour l'équilibreur de charge qui autorise les connexions entrantes (inbound) de partout sur les ports 80 (http) et 443 (https), et un deuxième pour les machines, qui autorise les connexions entrantes sur n'importe quel port depuis le groupe de l'équilibreur de charge. Les connexions sortantes (outbound) dans les deux groupes doivent être ouvertes selon le protocole TCP sur tous les ports vers toutes les adresses. Il est possible de restreindre les ports et adresses pour les connexions sortantes, mais il faudra alors surveiller en permanence que vous ne tentez pas d'accéder à un port fermé.
Stockage (volumes) — indiquez les paramètres des disques pour les machines. Le volume du disque ne peut pas être inférieur à celui spécifié dans l'AMI, pour ECS Optimized — 30 GiB.
Détails avancés — indiquez des paramètres supplémentaires.
Option d'achat — voulons-nous acheter des instances spot. Nous voulons, mais nous ne cocherons pas cette case ici, nous le configurerons dans le groupe d'auto-scaling, où il y a plus d'options.
Profil d'instance IAM — indiquez le rôle sous lequel les instances seront lancées. Pour que les instances fonctionnent dans ECS, elles ont besoin de droits qui sont généralement associés au rôle ecsInstanceRole. Dans certains cas, celui-ci peut être créé, s'il n'existe pas, alors ici des instructions sur la façon de le faire. Après sa création, nous l'indiquerons dans le modèle.
Ensuite, il y a beaucoup de paramètres, dans l'ensemble, il est possible de laisser les valeurs par défaut, mais chacun d'eux possède une description claire. J'active toujours les paramètres d'instance optimisée EBS et T2/T3 Unlimited, si des Données utilisateur
Données utilisateur — indiquez les données utilisateur. Nous allons modifier le fichier /etc/ecs/ecs.config, qui contient la configuration de l'agent ECS.
Voici un exemple de ce à quoi pourraient ressembler les données utilisateur :
#!/bin/bash
echo ECS_CLUSTER=DemoApiClusterProd >> /etc/ecs/ecs.config
echo ECS_ENABLE_SPOT_INSTANCE_DRAINING=true >> /etc/ecs/ecs.config
echo ECS_CONTAINER_STOP_TIMEOUT=1m >> /etc/ecs/ecs.config
echo ECS_ENGINE_AUTH_TYPE=docker >> /etc/ecs/ecs.config
echo "ECS_ENGINE_AUTH_DATA={"registry.gitlab.com":{"username":"username","password":"password"}}" >> /etc/ecs/ecs.config
ECS_CLUSTER=DemoApiClusterProd — ce paramètre indique que l'instance appartient à un cluster avec le nom spécifié, c'est-à-dire que ce cluster pourra exécuter ses tâches sur ce serveur. Nous n'avons pas encore créé de cluster, mais lors de sa création, nous utiliserons ce nom.
ECS_ENABLE_SPOT_INSTANCE_DRAINING=true — ce paramètre indique que lors de la réception d'un signal d'arrêt d'une instance spot, toutes les tâches sur celle-ci doivent passer au statut Draining.
ECS_CONTAINER_STOP_TIMEOUT=1m — ce paramètre indique qu'après réception du signal SIGINT, toutes les tâches ont 1 minute avant d'être arrêtées.
ECS_ENGINE_AUTH_TYPE=docker — ce paramètre indique que le mécanisme d'authentification utilise le schéma docker.
ECS_ENGINE_AUTH_DATA=... — paramètres de connexion à un registre de conteneur privé, où sont stockées vos images Docker. S'il est public, il n'est pas nécessaire d'indiquer quoi que ce soit.
Dans cet article, j'utiliserai une image publique de Docker Hub, donc il n'est pas nécessaire d'indiquer les paramètres. ECS_ENGINE_AUTH_TYPE et ECS_ENGINE_AUTH_DATA aucun besoin.
Bon à savoir: il est recommandé de mettre à jour régulièrement l'AMI, car dans les nouvelles versions, les versions de Docker, Linux, de l'agent ECS, etc. sont mises à jour. Pour ne pas l'oublier, vous pouvez sur la sortie de nouvelles versions. Vous pouvez recevoir des notifications par email et mettre à jour manuellement, ou vous pouvez écrire une fonction Lambda qui créera automatiquement une nouvelle version de la Launch Template avec l'AMI mis à jour.
Groupe de mise à l'échelle EC2
Le groupe de mise à l'échelle est responsable du lancement et de la mise à l'échelle des instances. La gestion des groupes se fait dans la section EC2 -> Auto Scaling -> Groupes de mise à l'échelle.
Template de lancement — on choisit le modèle créé lors de l'étape précédente. Nous laissons la version par défaut.
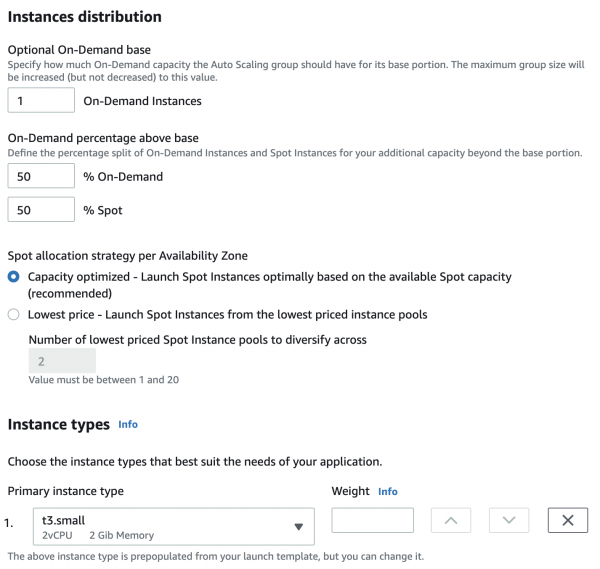
Options d'achat et types d'instance — on spécifie les types d'instances pour le cluster. Adhere to launch template utilise le type d'instance du modèle de lancement. Combine purchase options and instance types permet de configurer les types d'instances de manière flexible. Nous allons l'utiliser.
Base on-demand optionnelle — le nombre d'instances normales, non-spot, qui seront toujours en cours d'exécution.
Pourcentage on-demand au-dessus de la base — le rapport entre les instances normales et spot, 50-50 les répartit également, 20-80 signifiera qu'il y aura 4 instances spot pour chaque instance normale. Dans cet exemple, je vais spécifier 50-50, mais dans la réalité, nous faisons souvent 20-80, et parfois 0-100.
Types d'instance — ici, vous pouvez spécifier des types supplémentaires d'instances qui seront utilisés dans le cluster. Nous ne l'avons jamais utilisé, car je ne comprends pas très bien le sens de cette histoire. Peut-être est-ce lié aux limites sur des types spécifiques d'instances, mais elles peuvent être facilement augmentées grâce au support. Si vous connaissez une application, je serais ravi de lire vos commentaires)
Réseau — paramètres réseau, vous choisissez le VPC et les sous-réseaux pour les machines, dans la plupart des cas, il convient de choisir tous les sous-réseaux disponibles.
Équilibrage de charge — paramètres de l'équilibreur, mais nous le ferons séparément, ici nous ne touchons à rien. Contrôles de santé seront également configurés plus tard.
Taille du groupe — nous spécifions les limites pour le nombre de machines dans le cluster et le nombre souhaité de machines au démarrage. Le nombre de machines dans le cluster ne sera jamais inférieur au minimum spécifié ni supérieur au maximum, même si les métriques indiquent qu'une mise à l'échelle devrait se produire.
Politiques de mise à l'échelle — paramètres de mise à l'échelle, mais nous allons nous baser sur les tâches ECS en cours, donc nous configurerons la mise à l'échelle plus tard.
Protection contre la réduction d'instance — protection des instances contre la suppression lors de la mise à l'échelle vers le bas. Nous l'activons pour que l'ASG ne supprime pas la machine sur laquelle des tâches fonctionnent. La protection pour les instances sans tâches sera désactivée par le fournisseur de capacité ECS.
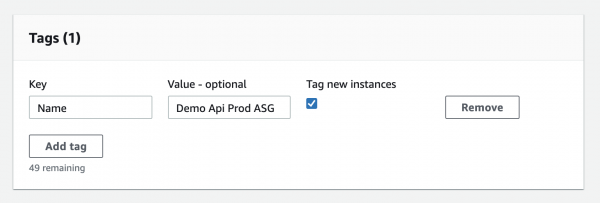
Ajouter des balises — vous pouvez spécifier des balises pour les instances (pour cela, la case à cocher Tag new instances doit être activée). Je recommande d'indiquer la balise Name, alors toutes les instances lancées dans le groupe auront le même nom, ce qui les rendra faciles à visualiser dans la console.
Après la création du groupe, ouvrez-le et allez dans la section Configurations avancées, car lors de la création, toutes les options ne sont pas visibles dans la console.
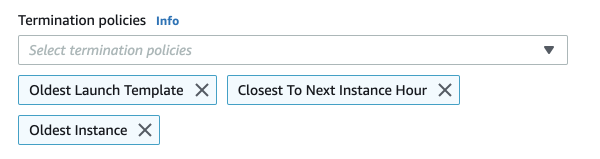
Politiques de termination — règles pris en compte lors de la suppression d'instances. Elles s'appliquent dans l'ordre. Nous utilisons généralement celles montrées sur l'image ci-dessous. D'abord, les instances avec le modèle de lancement le plus ancien sont supprimées (par exemple, si nous avons mis à jour l'AMI, une nouvelle version a été créée, mais toutes les instances ont réussi à y passer). Ensuite, les instances les plus proches du prochain moment de facturation sont choisies. Puis, les plus anciennes en date de lancement sont sélectionnées.
Bon à savoir: pour la mise à jour de toutes les machines dans le cluster, il est pratique d'utiliser . Si vous combinez cela avec une fonction Lambda de l'étape précédente, vous disposerez d'un système de mise à jour des instances entièrement automatisé. Avant de mettre à jour toutes les machines, il est nécessaire de désactiver la protection contre la réduction de l'échelle des instances pour toutes les instances du groupe. Ce n'est pas la configuration du groupe, mais plutôt la protection des machines elles-mêmes, qui se fait dans l'onglet Gestion des instances.
Application Load Balancer et EC2 Target Group
Le répartiteur est créé dans la section EC2 → Load Balancing → Load Balancers. Nous allons utiliser un Application Load Balancer, pour comparer les différents types de répartiteurs, vous pouvez consulter la .
Listeners — il est logique de créer les ports 80 et 443, et de rediriger le port 80 vers le 443 à l'aide de règles du répartiteur.
Zones de disponibilité — dans la plupart des cas, nous choisissons toutes les zones de disponibilité.
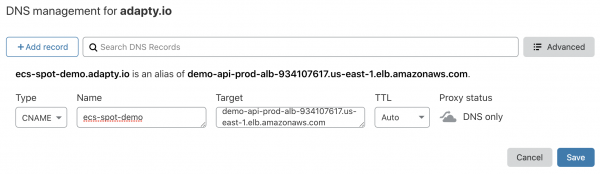
Configurer les paramètres de sécurité — ici, le certificat SSL pour le répartiteur est spécifié, la solution la plus pratique est de dans ACM. Vous pouvez lire sur les différences de Politique de sécurité dans , vous pouvez laisser le choix par défaut ELBSecurityPolicy-2016-08. Après la création du répartiteur, vous verrez son nom DNS, pour lequel vous devez configurer un CNAME pour votre domaine. Par exemple, c'est ainsi que cela apparaît dans Cloudflare.
Groupe de Sécurité — nous créons ou choisissons un groupe de sécurité pour le répartiteur, dont j'ai parlé plus haut dans la section Modèle de lancement EC2 → Paramètres réseau.
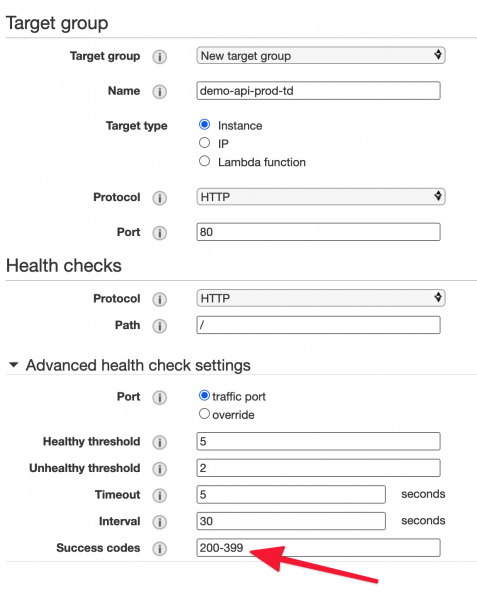
Groupe cible — nous créons un groupe qui se charge de router les requêtes du répartiteur vers les machines et vérifie leur disponibilité afin de remplacer en cas de problème. Le type de cible doit être Instance, Protocole et Port tous, si vous utilisez HTTPS pour communiquer entre le répartiteur et les instances, vous devez y télécharger le certificat. Dans cet exemple, nous ne le ferons pas, nous laisserons simplement le port 80.
Contrôles de santé — paramètres de vérification de la disponibilité du service. Dans un vrai service, cela devrait être une requête distincte, qui implémente les parties importantes de la logique métier, dans cet exemple, je laisserai les paramètres par défaut. Ensuite, vous pouvez choisir l'intervalle des requêtes, le délai d'attente, les codes de réponses réussies, etc. Dans notre exemple, indiquons les codes de succès 200-399, car l'image Docker qui sera utilisée renvoie le code 304.
Enregistrer les cibles — ici, nous sélectionnons les machines pour le groupe, mais dans notre cas, cela sera géré par ECS, donc nous passons simplement cette étape.
Bon à savoir: au niveau du répartiteur, nous pouvons activer les journaux, qui seront enregistrés dans S3 à un emplacement spécifique. . Vous pouvez les exporter vers des services externes pour l'analyse, ou effectuer des requêtes SQL directement sur les données dans S3 avec . C'est pratique et cela fonctionne sans code supplémentaire. Je recommande également de configurer la suppression des logs du bucket S3 après une période de temps déterminée.
Définition de la tâche ECS
Lors des étapes précédentes, nous avons créé tout ce qui concerne l'infrastructure du service, maintenant nous allons décrire les conteneurs que nous allons exécuter. Cela se fait dans la section ECS → Dédefinitions des tâches.
Compatibilité du type de lancement — nous choisissons EC2.
Rôle IAM d'exécution de la tâche — nous choisissons ecsTaskExecutionRole. Il permet d'écrire des logs, d'accéder aux variables secrètes, etc.
Dans la section Définitions du conteneur, cliquez sur Ajouter un conteneur.
Image — l'URL de l'image avec le code du projet, dans cet exemple je vais utiliser une image publique de Docker Hub .
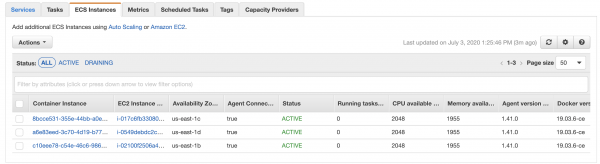
Limites de mémoire — limites de mémoire pour le conteneur. Limite stricte — limite stricte, si le conteneur dépasse cette valeur, la commande docker kill sera exécutée, le conteneur mourra immédiatement. Limite souple — limite souple, le conteneur peut dépasser cette valeur, mais lors du placement des tâches sur les machines, ce paramètre sera pris en compte. Par exemple, si une machine dispose de 4 GiB de RAM, et que la limite souple du conteneur est de 2048 MiB, alors un maximum de 2 tâches avec ce conteneur peut être exécuté sur cette machine. En réalité, 4 GiB de RAM c'est légèrement moins que 4096 MiB, ce que vous pouvez voir dans l'onglet Instances ECS du cluster. La limite souple ne peut pas être supérieure à la limite stricte. Il est important de comprendre que si une tâche a plusieurs conteneurs, leurs limites s'additionnent.
Mapping des ports — dans Port hôte nous indiquons 0, cela signifie que le port sera attribué dynamiquement et sera suivi par le groupe cible. Port du conteneur — le port sur lequel votre application fonctionne, souvent spécifié dans la commande d'exécution, ou attribué dans le code de votre application, Dockerfile, etc. Pour notre exemple, nous utilisons 3000, car il est mentionné dans l'image utilisée.
Vérification de l'état — paramètres de vérification de la disponibilité du conteneur, à ne pas confondre avec celui configuré dans le groupe cible.
Environnement — paramètres d'environnement. Unités CPU — ressemble à Memory limits, mais pour le processeur. Chaque cœur de processeur équivaut à 1024 unités, donc si le serveur a un processeur dual-core et que le conteneur a une valeur de 512, alors quatre tâches avec ce conteneur peuvent être exécutées sur un serveur. Les unités CPU correspondent toujours au nombre de cœurs, il ne peut pas y en avoir un peu moins comme c'est le cas avec la mémoire.
Commande — commande pour lancer un service à l'intérieur du conteneur, tous les paramètres sont indiqués par virgule. Cela peut être gunicorn, npm, etc. Si non spécifié, la directive CMD du Dockerfile sera utilisée. Nous indiquons npm,start.
Variables d'environnement — variables d'environnement du conteneur. Cela peut être à la fois des données textuelles simples et des variables secrètes de ou .
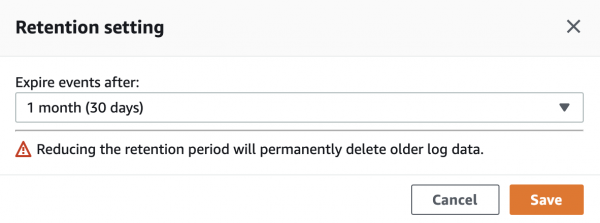
Stockage et journalisation — ici nous configurerons la journalisation dans CloudWatch Logs (service de logs d'AWS). Pour cela, il suffit de cocher la case Auto-configure CloudWatch Logs. Après la création de la définition de tâche, un groupe de logs sera automatiquement créé dans CloudWatch. Par défaut, les logs y sont conservés indéfiniment, je recommande de modifier la période de conservation de Never Expire à la durée requise. Cela se fait dans les groupes de logs CloudWatch, il faut cliquer sur la période actuelle et choisir une nouvelle.
ECS Cluster et ECS Capacity Provider
Allons dans la section ECS → Clusters pour créer un cluster. En tant que modèle, choisissons EC2 Linux + Networking.
Nom du cluster — très important, donnez ici le même nom que celui indiqué dans le Launch Template dans le paramètre ECS_CLUSTER, dans notre cas — DemoApiClusterProd. Cochez la case Create an empty cluster. Optionnellement, vous pouvez activer Container Insights pour voir les métriques des services dans CloudWatch. Si vous avez tout fait correctement, vous verrez dans la section ECS Instances les machines qui ont été créées dans le groupe Auto Scaling.
Accédez à l'onglet Capacity Providers et créons un nouveau. Rappelons que cela est nécessaire pour gérer la création et l'arrêt des machines en fonction du nombre de tâches ECS en cours. Il est important de noter que le fournisseur ne peut être lié qu'à un seul groupe.
Auto Scaling group — choisissons le groupe créé précédemment.
Mise à l'échelle gérée — activez-le pour que le fournisseur puisse mettre à l'échelle le service.
Capacité ciblée % — quel pourcentage d'occupation des machines par des tâches est nécessaire. Si vous spécifiez 100%, toutes les machines seront toujours occupées par des tâches en cours. Si vous spécifiez 50%, la moitié des machines seront toujours libres. Dans ce cas, si un pic de charge se produit, les nouvelles tâches iront immédiatement vers les machines libres, sans attendre le déploiement d'instances.
Protection de terminaison gérée — si activé, ce paramètre permet au fournisseur de supprimer la protection des instances contre la suppression. Cela se produit lorsque la machine n'a pas de tâches actives et permet de gérer la capacité cible %.
Service ECS et configuration de la mise à l'échelle
Dernière étape :) Pour créer un service, il faut accéder au cluster créé précédemment dans l'onglet Services.
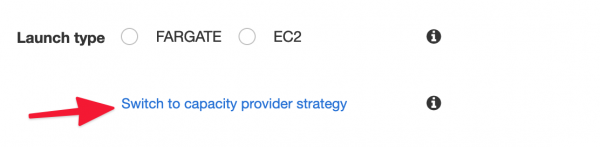
Type de lancement — il suffit de cliquer sur Passer à la stratégie de fournisseur de capacité et de sélectionner le fournisseur créé précédemment.
Définition de la tâche — sélectionnez la définition de tâche créée précédemment et sa révision.
Nom du service — pour éviter toute confusion, nous indiquons toujours le même nom que la définition de tâche.
Type de service — toujours Réplica.
Nombre de tâches — nombre souhaité de tâches actives dans le service. Ce paramètre est géré par la mise à l'échelle, mais doit quand même être indiqué.
Pourcentage minimum de santé et Pourcentage maximum — définissent le comportement des tâches lors du déploiement. Les valeurs par défaut sont 100 et 200, ce qui signifie qu'au moment du déploiement, le nombre de tâches augmentera plusieurs fois, puis retournera au souhaité. Si vous avez 1 tâche, min=0 et max=100, alors lors du déploiement, elle sera tuée, et ensuite une nouvelle sera lancée, ce qui entraînera un temps d'arrêt. Si une tâche est en cours d'exécution, min=50 et max=150, le déploiement ne se produira pas du tout, car une tâche ne peut pas être partagée ou augmentée par un facteur de 1,5.
Type de déploiement — nous choisissons Mise à jour progressive.
Modèles de placement — règles de placement des tâches sur les machines. Par défaut, la stratégie est AZ Balanced Spread, ce qui signifie que chaque nouvelle tâche sera placée sur une nouvelle instance jusqu'à ce que des machines soient créées dans toutes les zones de disponibilité. Nous préférons généralement BinPack — CPU et Spread — AZ, avec cette politique, les tâches sont optimisées pour occuper autant que possible une seule machine par rapport au CPU. Si une nouvelle machine doit être créée, elle est créée dans une nouvelle zone de disponibilité.
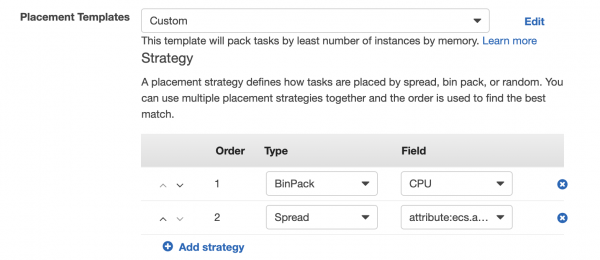
Type de charge balancée — nous choisissons le Load Balancer d'application.
Rôle IAM du service — nous choisissons ecsServiceRole.
Nom du chargeur d'équilibre — nous choisissons le chargeur d'équilibre créé précédemment.
Période de grâce de vérification de santé — pause avant l'exécution des vérifications de viabilité après le déploiement d'une nouvelle tâche, nous mettons généralement 60 secondes.
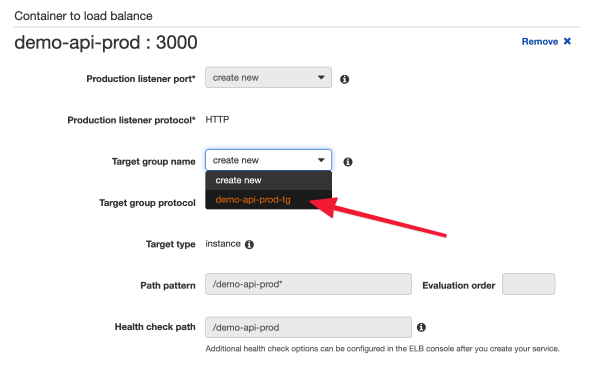
Conteneur à équilibrer — dans le champ Nom du groupe cible, sélectionnez le groupe créé précédemment, et tout se remplira automatiquement.
Mise à l'échelle automatique du service — paramètres de mise à l'échelle du service. Nous choisissons Configurer la mise à l'échelle automatique du service pour ajuster le nombre souhaité du service. Définissons le nombre minimum et maximum de tâches lors de la mise à l'échelle.
Rôle IAM pour la mise à l'échelle automatique du service — nous choisissons AWSServiceRoleForApplicationAutoScaling_ECSService.
Politiques de mise à l'échelle automatique des tâches — règles de mise à l'échelle. Il existe 2 types :
- Suivi de cible — suivi d'une métrique cible (utilisation du CPU/RAM ou nombre de requêtes pour chaque tâche). Par exemple, nous souhaitons que la charge moyenne du processeur soit de 85 %, lorsqu'elle dépasse ce seuil, de nouvelles tâches seront ajoutées jusqu'à ce qu'elle atteigne la valeur cible. Si la charge est inférieure, les tâches seront réduites, sauf si la protection contre la mise à l’échelle descendante est activée (Désactiver la mise à l'échelle descendante).
- Mise à l'échelle par étape — réaction à un événement arbitraire. Ici, il est possible de configurer la réponse à tout événement (Alarme CloudWatch) lorsqu'il se produit, vous pouvez ajouter ou retirer un certain nombre de tâches, ou indiquer un nombre exact de tâches.
Le service peut avoir plusieurs règles de mise à l'échelle, ce qui peut être utile, il est important de s'assurer qu'elles ne se contredisent pas.
Conclusion
Si vous avez suivi les instructions et utilisé la même image Docker, votre service devrait renvoyer cette page.

- Nous avons créé un modèle selon lequel toutes les machines dans le service sont lancées. Nous avons également appris à mettre à jour les machines lors de la modification du modèle.
- Nous avons configuré le traitement du signal d'arrêt d'une instance spot, donc dans la minute suivant sa réception, toutes les tâches en cours sont supprimées de la machine, ainsi rien n'est perdu et aucune interruption ne se produit.
- Nous avons mis en place un équilibreur pour répartir uniformément la charge entre les machines.
- Nous avons créé un service qui fonctionne sur des instances spot, ce qui réduit les coûts des machines d'environ 3 fois.
- Nous avons configuré l'auto-scaling dans les deux sens, afin de gérer l'augmentation des charges, tout en évitant de payer pour des temps d'inactivité.
- Nous utilisons le Capacity Provider pour que l'application gère l'infrastructure (machines), et non l'inverse.
- Nous avons bien travaillé.
Si vous avez des pics de charge prévisibles, par exemple, si vous faites de la publicité dans une grande campagne email, vous pouvez configurer la mise à l'échelle selon .
Il est également possible de faire de la mise à l'échelle basée sur des données provenant de différentes parties de votre système. Par exemple, nous avons une fonctionnalité aux utilisateurs de l'application mobile. Parfois, une campagne est envoyée à plus de 1 million de personnes. Après un tel envoi, nous constatons toujours une forte augmentation des requêtes à l'API, car de nombreux utilisateurs se connectent simultanément à l'application. Donc, si nous voyons que la file d'attente pour l'envoi de notifications promotionnelles a augmenté de manière significative par rapport aux indicateurs standards, nous pouvons immédiatement lancer plusieurs machines supplémentaires et tâches pour être prêts à faire face à la charge.
Je serais ravi si vous partagiez dans les commentaires des cas intéressants d'utilisation des instances spot et de l'ECS, ou des éléments sur le dimensionnement.
Bientôt, nous publierons des articles sur comment nous traitons des milliers d'événements analytiques par seconde sur une architecture majoritairement serverless (avec des fonds) et sur la manière dont nous déployons des services à l'aide de GitLab CI et Terraform Cloud.
Suivez-nous, ce sera intéressant !
Seuls les utilisateurs enregistrés peuvent participer au sondage. , s'il vous plaît.
Utilisez-vous des instances spot en production ?
22,2%Oui6
66,7%Non18
11,1%J'ai entendu parler d'eux à travers un article, je prévois de les utiliser3
27 utilisateurs ont voté. 5 utilisateurs se sont abstenus.
Source : habr.com
