

Au fil des ans, 300 millions d'utilisateurs de Pinterest ont créé plus de 200 milliards de pins sur plus de 4 milliards de tableaux. Pour gérer cette armée d'utilisateurs et cette vaste base de contenu, le portail a développé des milliers de services, allant des microservices capables de fonctionner avec quelques CPU à d'énormes monolithes fonctionnant sur un parc entier de machines virtuelles. Et c'est à ce moment-là que l'attention de l'entreprise s'est tournée vers k8s. Qu'est-ce qui a attiré Pinterest vers le 'cube' ? Vous le découvrirez dans notre traduction d'un récent article de .
Ainsi, des centaines de millions d'utilisateurs et des centaines de milliards de pins. Pour gérer cette armée d'utilisateurs et cette vaste base de contenu, nous avons développé des milliers de services, allant des microservices capables de fonctionner avec quelques CPU à d'énormes monolithes fonctionnant sur un parc entier de machines virtuelles. De plus, nous avons divers frameworks qui peuvent également exiger des ressources CPU, de la mémoire ou un accès aux opérations d'entrée-sortie.
Dans le cadre du soutien à cet éventail d'outils, l'équipe de développement est confrontée à plusieurs problèmes :
- Les ingénieurs n'ont pas de méthode unifiée pour lancer un environnement de travail. Les services sans état, les services avec état et les projets en cours de développement reposent sur des stacks technologiques totalement différents. Cela a conduit à la création d'un cours de formation complet pour les ingénieurs, tout en compliquant gravement le travail de notre équipe d'infrastructure.
- Les développeurs, disposant de leur propre parc de machines virtuelles, imposent une charge énorme sur les administrateurs internes. Ainsi, des opérations aussi simples que la mise à jour du système d'exploitation ou de l'AMI peuvent s'étendre sur des semaines et des mois. Cela conduit à une charge accrue dans des situations qui, par ailleurs, devraient être banales.
- Difficultés à créer des outils de gestion d'infrastructure globaux au-dessus des solutions existantes. La situation est encore compliquée par le fait qu'il n'est pas facile de trouver les propriétaires des machines virtuelles, c'est-à-dire que nous ne savons pas si nous pouvons récupérer ces ressources pour les utiliser dans d'autres parties de notre infrastructure.
Les systèmes d'orchestration de conteneurs sont un moyen d'unifier la gestion des charges de travail. Ils vous permettent d'accélérer le développement et simplifient la gestion de l'infrastructure, car toutes les ressources impliquées dans le projet sont gérées par un système centralisé.
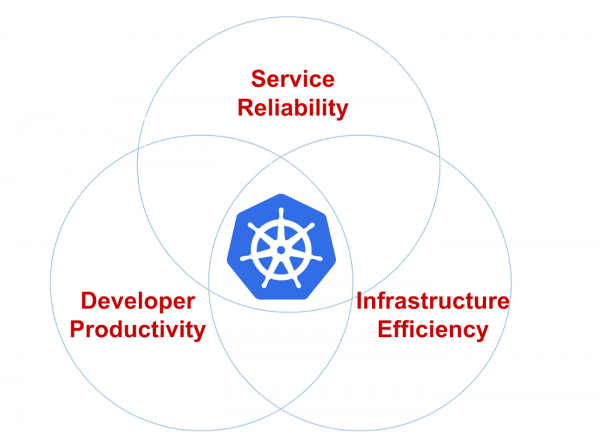
Figure 1 : Priorités de l'infrastructure (fiabilité, performance des développeurs et efficacité).
L'équipe Cloud Management Platform chez Pinterest a découvert K8s en 2017. Au début de l’année 2017, nous avons documenté la majeure partie de nos capacités de production, notamment, l'API et tous nos serveurs web. Ensuite, nous avons procédé à une évaluation minutieuse de différents systèmes d'orchestration de solutions contenues, de la construction de clusters et de leur fonctionnement. À la fin de 2017, nous avons décidé d'adopter Kubernetes. Il était assez flexible et largement soutenu par la communauté des développeurs.
À ce jour, nous avons créé nos propres outils de déploiement initial du cluster basé sur Kops et migré vers Kubernetes les composants existants de l'infrastructure, tels que le réseau, la sécurité, la mesure, la journalisation, la gestion des identités et le trafic. Nous avons également mis en place un système de modélisation des charges de travail pour notre ressource, dont la complexité est cachée aux développeurs. Nous nous concentrons maintenant sur la garantie de la stabilité du cluster, son évolutivité et l'intégration de nouveaux clients.
Kubernetes : le parcours de Pinterest
Le démarrage de Kubernetes à l'échelle de Pinterest en tant que plateforme appréciée par nos ingénieurs a entraîné de nombreuses difficultés.
En tant que grande entreprise, nous avons investi des ressources considérables dans les outils d'infrastructure. On peut citer les outils de sécurité qui traitent les certificats et distribuent les clés, les composants de contrôle du trafic, les systèmes de détection des services, les composants de visibilité et d'envoi de journaux et de métriques. Tout cela n’a pas été assemblé par hasard : nous avons suivi un parcours normal d'essais et d'erreurs, et nous avons donc voulu intégrer tout cela dans la nouvelle infrastructure sur Kubernetes au lieu de réinventer la roue sur une nouvelle plateforme. Cette approche a globalement simplifié la migration, car tout le soutien des applications existe déjà et n’a pas besoin d’être créé de toutes pièces.
D'un autre côté, les modèles de prévision de charge dans Kubernetes lui-même (comme les déploiements, les jobs et les ensembles Daemon) sont insuffisants pour notre projet. Ces problèmes d'ergonomie représentent d'énormes obstacles à la transition vers Kubernetes. Par exemple, nous avons entendu des développeurs de services se plaindre de l'absence ou de la mauvaise configuration des entrées. Nous avons également rencontré des problèmes d'utilisation inappropriée des générateurs de modèles, créant des centaines de copies avec des spécifications et des tâche identiques, ce qui a entraîné des problèmes de débogage considérables.
Il était également très difficile de prendre en charge différentes versions dans un même cluster. Imaginez la complexité du support client si vous devez travailler simultanément avec plusieurs versions du même environnement d'exécution, avec tous leurs problèmes, bugs et mises à jour.
Ressources et contrôleurs personnalisés de Pinterest
Pour faciliter le processus d'implémentation de Kubernetes pour nos ingénieurs, ainsi que pour simplifier l'infrastructure et accélérer son fonctionnement, nous avons développé nos propres définitions de ressources personnalisées (CRD).
Les CRD offrent les fonctionnalités suivantes :
- L'unification de diverses ressources natives Kubernetes pour qu'elles fonctionnent comme une seule charge. Par exemple, la ressource PinterestService inclut un déploiement, un service d'entrée et une carte de configuration. Cela permet aux développeurs de ne pas se soucier de la configuration DNS.
- L'implémentation du support d'application nécessaire. L'utilisateur doit se concentrer uniquement sur la spécification du conteneur selon sa logique métier, tandis que le contrôleur CRD implémente tous les conteneurs init nécessaires, les variables d'environnement et les spécifications du pod. Cela offre un niveau de confort fondamentalement différent pour les développeurs.
- Les contrôleurs CRD gèrent également le cycle de vie des ressources propriétaires et améliorent la disponibilité du débogage. Cela inclut l'harmonisation des spécifications souhaitées et réelles, la mise à jour du statut CRD et la gestion des journaux d'événements et plus encore. Sans CRD, les développeurs devraient gérer un grand nombre de ressources, augmentant ainsi les risques d’erreurs.
Voici un exemple de PinterestService et d'une ressource interne gérée par notre contrôleur :
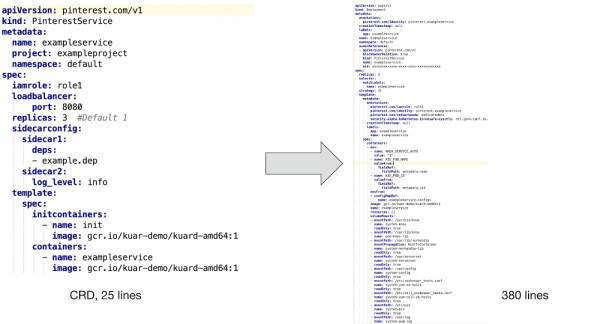
Comme mentionné ci-dessus, pour supporter le conteneur utilisateur, nous devons intégrer un conteneur d'initialisation et plusieurs extensions afin d'assurer la sécurité, la visibilité et la gestion du trafic réseau. De plus, nous avons créé des modèles de cartes de configuration et mis en œuvre un support pour les modèles PVC pour les tâches en lot, ainsi qu'un suivi de nombreuses variables d'environnement pour surveiller l'identification, la consommation de ressources et la collecte de "déchets".
Il est difficile d'imaginer que les développeurs souhaitent rédiger ces fichiers de configuration manuellement sans support CRD, sans parler du maintien et du débogage ultérieurs des configurations.
Flux de déploiement des applications
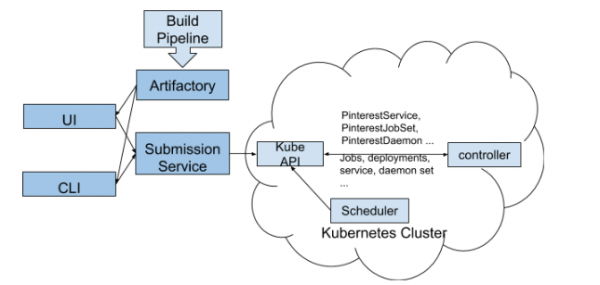
L'illustration ci-dessus montre comment déployer une ressource personnalisée Pinterest dans un cluster Kubernetes :
- Les développeurs interagissent avec notre cluster Kubernetes via CLI et interface utilisateur.
- Les outils CLI / UI extraient les fichiers YAML de configuration du flux de travail et d'autres propriétés de construction (le même identifiant de version) à partir d'Artifactory, puis les envoient au Job Submission Service. Cette étape garantit que seules les versions fonctionnelles seront mises en place dans le cluster.
- JSS sert de passerelle pour diverses plateformes, y compris Kubernetes. C'est ici que s'effectue l'authentification de l'utilisateur, l'attribution de quotas et une vérification partielle de la configuration de notre CRD.
- Après vérification du CRD côté JSS, les informations sont envoyées à l'API de la plateforme k8s.
- Notre contrôleur CRD surveille les événements sur toutes les ressources personnalisées. Il convertit le CR en ressources natives k8s, ajoute les modules nécessaires, définit les variables d'environnement appropriées et effectue d'autres tâches auxiliaires, garantissant ainsi un soutien infrastructurel suffisant pour les applications conteneurisées personnalisées.
- Ensuite, le contrôleur CRD transmet les données reçues à l'API Kubernetes afin qu'elles soient traitées par le planificateur et mises en œuvre.
Remarque: ce workflow de déploiement en préversion a été créé pour les premiers utilisateurs de la nouvelle plateforme k8s. Nous sommes actuellement en train d'affiner ce processus afin de l'intégrer entièrement à notre nouveau CI/CD. Cela signifie que nous ne pouvons pas tout partager sur Kubernetes. Nous sommes impatients de pouvoir partager notre expérience et de parler des progrès de l'équipe dans ce domaine dans notre prochain billet de blog « Building a CI/CD platform for Pinterest ».
Types de ressources spéciales
En fonction des besoins spécifiques de Pinterest, nous avons développé les CRD suivants, adaptés à divers workflows :
- PinterestService est un service stateless qui fonctionne depuis longtemps. De nombreux systèmes de base reposent sur un ensemble de ces services.
- PinterestJobSet modélise des tâches par lots de cycle complet. Chez Pinterest, un scénario courant consiste à lancer plusieurs tâches avec les mêmes conteneurs en parallèle, indépendamment d'autres processus similaires.
- PinterestCronJob est largement utilisé avec de petites charges de travail périodiques. C'est une enveloppe pour le traitement natif cron avec des mécanismes de support spécifiques à Pinterest, responsables de la sécurité, du trafic, des journaux et des métriques.
- PinterestDaemon inclut des Daemons d'infrastructure. Cette famille continue de croître alors que nous ajoutons de plus en plus de support pour nos clusters.
- PinterestTrainingJob couvre les processus Tensorflow et Pytorch, offrant le même niveau de support en phase d'exécution que tous les autres CRD. Étant donné que Pinterest utilise activement Tensorflow et d'autres systèmes de machine learning, il était logique de créer une CRD distincte autour d'eux.
Nous travaillons également sur PinterestStatefulSet, qui sera bientôt adapté pour les systèmes de stockage de données et d'autres systèmes stateful.
Support de l'environnement d'exécution
Lorsque le module d'application est lancé dans Kubernetes, il obtient automatiquement un certificat pour s'identifier. Ce certificat est utilisé pour accéder au stockage secret ou pour communiquer avec d'autres services via mTLS. Parallèlement, le configurateur d'initialisation des conteneurs et le Daemon chargent toutes les dépendances nécessaires avant de lancer l'application de conteneur. Lorsque tout est prêt, le sidecar du trafic et le Daemon enregistrent l'adresse IP du module dans notre Zookeeper, afin que les clients puissent le découvrir. Tout cela fonctionnera, car le module réseau a été configuré avant le lancement de l'application.
Les exemples ci-dessus illustrent des cas typiques de support des charges de travail pendant l'exécution. D'autres types de charges de travail peuvent nécessiter un soutien légèrement différent, mais tous sont présentés sous forme de sidecar au niveau du pod, de nœuds ou de Daemons au niveau de machines virtuelles. Nous veillons à ce que tout cela soit déployé au sein de l'infrastructure de gestion et harmonisé entre les applications, ce qui réduit considérablement la charge en termes de travaux techniques et de support client.
Tests et QA
Nous avons constitué un pipeline de tests end-to-end sur l'infrastructure de test Kubernetes existante. Ces tests s'étendent à tous nos clusters. Notre pipeline a subi de nombreuses refontes avant de devenir partie intégrante du cluster produit.
En plus des systèmes de test, nous avons des systèmes de surveillance et d'alerte qui suivent en permanence l'état des composants du système, la consommation des ressources et d'autres indicateurs importants, nous alertant uniquement en cas de besoin d'intervention humaine.
Alternatives
Nous avons examiné certaines alternatives aux ressources personnalisées, telles que les contrôleurs d'accès mutationnels et les systèmes de modèles. Cependant, toutes sont lourdes en termes de gestion, c'est pourquoi nous avons opté pour la voie des CRD.
Le contrôleur d'accès mutationnel a été utilisé pour introduire des sidecars, des variables d'environnement et d'autres supports pendant l'exécution. Cependant, il a rencontré divers problèmes, tels que le couplage des ressources et la gestion de leur cycle de vie, ce qui n'est pas un problème rencontré avec les CRD.
Remarque : Les systèmes de modèles, tels que les diagrammes Helm, sont également largement utilisés pour déployer des applications avec des configurations similaires. Cependant, nos applications fonctionnelles sont trop variées pour être gérées par des modèles. De plus, lors du déploiement continu utilisant des modèles, trop d'erreurs se produiront.
Travail à venir
Nous faisons face à une charge mixte sur tous nos clusters. Pour supporter de tels processus de différentes types et tailles, nous travaillons dans les domaines suivants :
- L'ensemble de clusters répartit de grandes applications sur différents clusters pour garantir l'évolutivité et la stabilité.
- Assurer la stabilité, l'évolutivité et la visibilité du cluster pour établir le lien entre l'application et son SLA.
- Gestion des ressources et des quotas, afin que les applications ne rentrent pas en conflit entre elles et que l'échelle du cluster soit contrôlée de notre côté.
- Nouvelle plateforme CI/CD pour le soutien et le déploiement d'applications dans Kubernetes.
Source : habr.com
