

Il arrive parfois que nous devions rechercher des données associées à un ensemble de clés, jusqu'à ce que nous atteignions le nombre total d'enregistrements souhaité..
Un exemple très « vivant » serait de sortir les 20 tâches les plus anciennes, figurant dans la liste des employés (par exemple, au sein d'un même département). Ce type de demande est assez fréquent pour divers tableaux de bord de gestion présentant des résumés des domaines de travail.
Dans cet article, nous examinerons l'implémentation sur PostgreSQL d'une solution « naïve » à ce type de problème, d'un algorithme « plus intelligent » et d'un algorithme complexe « en boucle » en SQL avec une condition de sortie basée sur les données trouvées,qui peut être utile tant pour le développement personnel que pour l'application dans d'autres cas similaires.
Prenons un jeu de données d'exemple provenant de . Afin que les enregistrements affichés ne « sautent » pas d'une fois à l'autre en cas de valeurs de tri identiques, nous allons étendre l'index thématique par l'ajout de la clé primaire,. Cela lui conférera immédiatement son unicité et garantira l'unité de l'ordre de tri :
CREATE INDEX ON task(owner_id, task_date, id);
-- et nous allons supprimer l'ancien
DROP INDEX task_owner_id_task_date_idx;
Tel qu'on l'entend, tel qu'on l'écrit.
Pour commencer, esquissons la variante de requête la plus simple, en passant les ID des exécutants :
SELECT
  *
FROM
  task
WHERE
  owner_id = ANY('{1,2,4,8,16,32,64,128,256,512}'::integer[])
ORDER BY
  task_date, id
LIMIT 20; 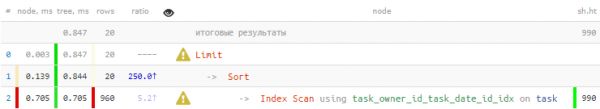
C'est un peu triste — nous avons demandé seulement 20 enregistrements, mais l'Index Scan nous a renvoyé 960 lignes, qui ont ensuite dû être triées… Essayons de lire un peu moins.
unnest + ARRAY
La première réflexion qui nous aidera — si nous avons besoin de juste 20 enregistrements triés, alors il suffit de lire pas plus de 20 triés dans le même ordre pour chaque clé. Heureusement, nous disposons d'un index approprié (owner_id, task_date, id). Nous utiliserons le même mécanisme d'extraction et de « déploiement en colonnes »
de l'enregistrement complet de la table , comme dans. Nous appliquerons également le repli en tableau en utilisant la fonction ARRAY() WITH T AS ( SELECT unnest(ARRAY( SELECT t FROM task t WHERE owner_id = unnest ORDER BY task_date, id LIMIT 20 -- nous limitons ici... )) r FROM unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[]) ) SELECT (r).* FROM T ORDER BY (r).task_date, (r).id LIMIT 20; -- ... et ici - aussi:
Oh, c'est déjà beaucoup mieux ! 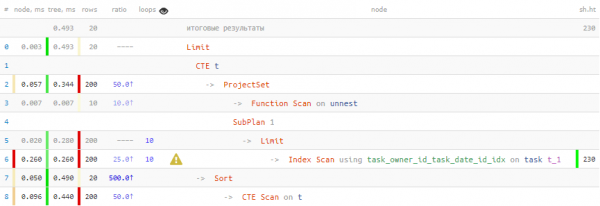
40 % plus rapide, et 4,5 fois moins de données ont dû être lues. La matérialisation des enregistrements de table via CTE
Je souligne quedans certains cas dans certains cas essayer de travailler directement avec les champs d'enregistrement après leur recherche dans une sous-requête, sans les « envelopper » dans un CTE peut conduire à une « multiplication » de l'InitPlan proportionnellement au nombre de ces champs :
SELECT
  ((
    SELECT
      t
    FROM
      task t
    WHERE
      owner_id = 1
    ORDER BY
      task_date, id
    LIMIT 1
  ).*);
Résultat (coût=4.77..4.78 lignes=1 largeur=16) (temps réel=0.063..0.063 lignes=1 boucles=1)
Tampons : coup partagé=16
InitPlan 1 (retourne $0)
-> Limite (coût=0.42..1.19 lignes=1 largeur=48) (temps réel=0.031..0.032 lignes=1 boucles=1)
Tampons : coup partagé=4
-> Recherche d'index utilisant task_owner_id_task_date_id_idx sur la tâche t (coût=0.42..387.57 lignes=500 largeur=48) (temps réel=0.030..0.030 lignes=1 boucles=1)
Condition d'index : (owner_id = 1)
Tampons : coup partagé=4
InitPlan 2 (retourne $1)
-> Limite (coût=0.42..1.19 lignes=1 largeur=48) (temps réel=0.008..0.009 lignes=1 boucles=1)
Tampons : coup partagé=4
-> Recherche d'index utilisant task_owner_id_task_date_id_idx sur la tâche t_1 (coût=0.42..387.57 lignes=500 largeur=48) (temps réel=0.008..0.008 lignes=1 boucles=1)
Condition d'index : (owner_id = 1)
Tampons : coup partagé=4
InitPlan 3 (retourne $2)
-> Limite (coût=0.42..1.19 lignes=1 largeur=48) (temps réel=0.008..0.008 lignes=1 boucles=1)
Tampons : coup partagé=4
-> Recherche d'index utilisant task_owner_id_task_date_id_idx sur la tâche t_2 (coût=0.42..387.57 lignes=500 largeur=48) (temps réel=0.008..0.008 lignes=1 boucles=1)
Condition d'index : (owner_id = 1)
Tampons : coup partagé=4
InitPlan 4 (retourne $3)
-> Limite (coût=0.42..1.19 lignes=1 largeur=48) (temps réel=0.009..0.009 lignes=1 boucles=1)
Tampons : coup partagé=4
-> Recherche d'index utilisant task_owner_id_task_date_id_idx sur la tâche t_3 (coût=0.42..387.57 lignes=500 largeur=48) (temps réel=0.009..0.009 lignes=1 boucles=1)
Condition d'index : (owner_id = 1)
Tampons : coup partagé=4
Le même enregistrement a été « recherché » 4 fois… Jusqu'à PostgreSQL 11, ce comportement se produisait régulièrement, et la solution consistait à « envelopper » dans un CTE, ce qui est une limite claire pour l'optimiseur dans ces versions.
Accumulateur récursif
Dans la version précédente, nous avons lu au total 200 lignes pour obtenir les 20 nécessaires. Ce n'est plus 960, mais encore moins — est-ce possible ?
Essayons de profiter de notre connaissance selon laquelle nous avons seulement besoin de 20 enregistrements. Autrement dit, nous allons itérer la lecture des données uniquement jusqu'à atteindre le nombre dont nous avons besoin.
Étape 1 : liste de départ
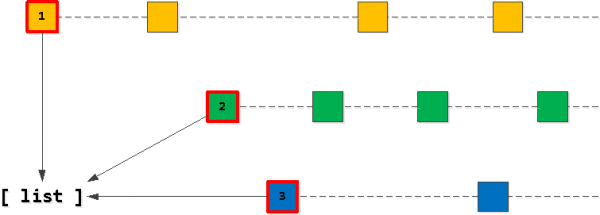
Il est évident que notre liste « cible » de 20 enregistrements doit commencer par les « premiers » enregistrements selon l'un de nos clés owner_id. Donc, trouvons d'abord ces « tout premiers » selon chacune des clés et ajoutons-les à la liste, en les triant dans l'ordre que nous souhaitons — (task_date, id).
Étape 2 : trouver les « enregistrements suivants »
Maintenant, si nous prenons le premier enregistrement de notre liste et commençons à « avancer » dans l'index en conservant la clé owner_id, tous les enregistrements trouvés seront précisément les suivants dans le résultat de la sélection. Bien sûr, seulement tant que nous n'avons pas franchi la clé d'application deuxième enregistrement dans la liste.
Si nous avons franchi le deuxième enregistrement, alors le dernier enregistrement lu doit être ajouté à la liste à la place du premier (avec le même owner_id), après quoi la liste est à nouveau triée.
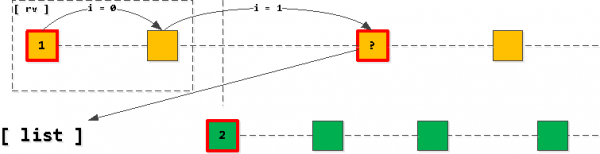
C'est-à-dire que nous avons toujours une seule entrée par clé dans la liste (si les enregistrements sont épuisés et que nous n'avons pas franchi, le premier enregistrement de la liste disparaît simplement et rien n'est ajouté), et ils sont toujours triés dans l'ordre croissant de la clé d'application (task_date, id).
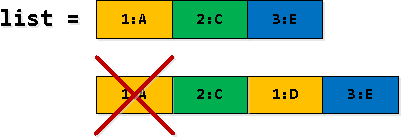
Étape 3 : filtrer et « déplier » les enregistrements
Dans certaines lignes de notre sélection récursive, certains enregistrements rv sont dupliqués — d'abord nous trouvons ceux qui « franchissent la frontière du 2e enregistrement de la liste », puis les plaçons comme 1er de la liste. Donc, la première apparition doit être filtrée.
La terrible requête finale
AVEC RÉCURSIF T COMME (
  -- #1 : nous insérons les "premiers" enregistrements par rapport à chaque clé de l'ensemble
  AVEC wrap COMME ( -- "matérialisons" les enregistrements pour éviter que l'accès aux champs provoque une multiplicité d'InitPlan/SubPlan
    AVEC T COMME (
      SÉLECTIONNER
        (
          SÉLECTIONNER
            r
          DE
            task r
          OÙ
            owner_id = unnest
          COMMANDER PAR
            task_date, id
          LIMIT 1
        ) r
      DE
        unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
    )
    SÉLECTIONNER
      array_agg(r ORDER BY (r).task_date, (r).id) liste -- nous trions la liste dans l'ordre souhaité
    DE
      T
  )
  SÉLECTIONNER
    liste
  , liste[1] rv
  , FAUX not_cross
  , 0 taille
  DE
    wrap
UNION ALL
  -- #2 : nous lisons les enregistrements du 1er ordre de la clé jusqu'à ce que nous dépassions l'enregistrement du 2ème
  SÉLECTIONNER
    CAS
      -- si rien n'est trouvé pour la clé du 1er enregistrement
      QUAND X._r EST NON DISTINCT DE NULL ALORS
        T.liste[2:] -- nous l'éliminons de la liste
      -- si nous N'AVONS PAS croisé la clé appliquée du 2ème enregistrement
      QUAND X.not_cross ALORS
        T.liste -- simplement nous continuons la même liste sans modifications
      -- si le 2ème enregistrement n'est déjà plus dans la liste
      QUAND T.liste[2] EST NULL ALORS
        -- simplement renvoyer une liste vide
        '{}'
      -- nous re-trions le dictionnaire en supprimant le 1er enregistrement et en ajoutant le dernier trouvé
      SINON (
        SÉLECTIONNER
          coalesce(T.liste[2] || array_agg(r ORDER BY (r).task_date, (r).id), '{}')
        DE
          unnest(T.liste[3:] || X._r) r
      )
    FIN
  , X._r
  , X.not_cross
  , T.taille + X.not_cross::integer
  DE
    T
  , LATERAL(
      AVEC wrap COMME ( -- "matérialisons" l'enregistrement
        SÉLECTIONNER
          CAS
            -- si nous avons en fait "dépassé" le 2ème enregistrement
            QUAND PAS T.not_cross
              -- alors l'enregistrement nécessaire est le premier de la liste
              ALORS T.liste[1]
            SINON ( -- si nous n'avons pas croisé, alors la clé est restée comme dans l'enregistrement précédent - elle s'en inspire
              SÉLECTIONNER
                _r
              DE
                task _r
              OÙ
                owner_id = (rv).owner_id ET
                (task_date, id) > ((rv).task_date, (rv).id)
              COMMANDER PAR
                task_date, id
              LIMIT 1
            )
          FIN _r
      )
      SÉLECTIONNER
        _r
      , CAS
          -- si le 2ème enregistrement n'est déjà plus dans la liste, mais que nous avons trouvé quelque chose
          QUAND liste[2] EST NULL ET _r EST DISTINCT DE NULL ALORS
            VRAI
          SINON -- rien trouvé ou "dépassé"
            coalesce(((_r).task_date, (_r).id) < ((liste[2]).task_date, (liste[2]).id), FAUX)
        FIN not_cross
      DE
        wrap
    ) X
  OÙ
    T.taille < 20 ET -- nous limitons ici la quantité
    T.liste EST DISTINCT DE '{}' -- ou jusqu'à ce que la liste soit épuisée
)
-- #3 : "développons" les enregistrements - l'ordre est garanti par la construction
SÉLECTIONNER
  (rv).*
DE
  T
OÙ
not_cross; -- nous prenons uniquement les enregistrements "non croisés" 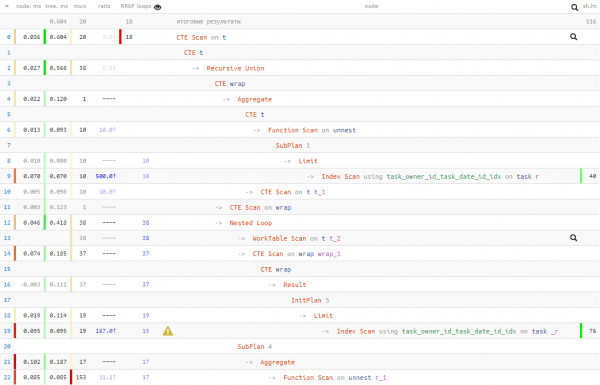
Ainsi, nous avons échangé 50 % des lectures de données contre 20 % du temps d'exécutionC'est-à-dire que si vous avez des raisons de penser que la lecture pourrait être longue (par exemple, les données ne sont souvent pas en cache et doivent être récupérées sur le disque), vous pouvez ainsi dépendre moins de la lecture.
Dans tous les cas, le temps d'exécution s'est avéré meilleur que dans la première version « naïve ». Mais lequel de ces 3 variantes utiliser — c'est à vous de choisir.
Source : habr.com
