

Dans le passé, Nous avons exploré les bases théoriques de l'architecture réactive. Il est temps de discuter des flux de données, des méthodes de mise en œuvre des systèmes Erlang/Elixir réactifs et des modèles d'échange de messages qui les sous-tendent :
- Request-response
- Request-Chunked Response
- Response with Request
- Publish-subscribe
- Inverted Publish-subscribe
- Task distribution
SOA, MSA et échange de messages
SOA et MSA sont des architectures systèmes qui définissent les règles de construction des systèmes, tandis que le messaging fournit les primitives pour leur mise en œuvre.
Je ne souhaite pas promouvoir une architecture système plutôt qu'une autre. Je prône l'utilisation de pratiques maximales et utiles pour un projet et une entreprise spécifiques. Quelle que soit la paradigme choisie, il est préférable de construire des blocs systèmes en gardant à l'esprit l'approche Unix : des composants avec un couplage minimal, responsables d'entités spécifiques. Les méthodes API effectuent des actions aussi simples que possible sur les entités.
Le messaging, comme son nom l'indique, est un courtier de messages. Son objectif principal est de recevoir et d'envoyer des messages. Il est responsable des interfaces de transmission d'informations, de la formation de canaux logiques de transmission au sein du système, du routage et de l'équilibrage, ainsi que du traitement des pannes au niveau système.
Le messaging en développement ne cherche pas à concurrencer rabbitmq ou à le remplacer. Ses principales caractéristiques sont :
- Distribution.
Les points d'échange peuvent être créés sur tous les nœuds du cluster, aussi près que possible du code qui les utilise. - Simplicité.
Orienté sur la minimisation du code standard et la facilité d'utilisation. - Meilleure performance.
Nous ne tentons pas de répliquer la fonctionnalité de rabbitmq, mais mettons en avant uniquement la couche architecturale et de transport, que nous intégrons simplement dans l'OTP, minimisant les coûts. - Flexibilité.
Chaque service peut combiner plusieurs modèles d'échange. - Résilience, intégrée dans le design.
- Scalabilité.
Le messaging évolue avec l'application. À mesure que la charge augmente, les points d'échange peuvent être déplacés sur des machines séparées.
Remarque. En termes d'organisation du code, les méta-projets conviennent bien pour les systèmes complexes en Erlang/Elixir. Tout le code du projet est situé dans un seul référentiel ‒ un projet umbrella. Dans ce cadre, les microservices sont maximement isolés et effectuent des opérations simples, responsables d'une entité distincte. Avec cette approche, il est facile de maintenir l'API de l'ensemble du système, d'apporter des modifications simplement et d'écrire facilement des tests unitaires et d'intégration.
Les composants du système interagissent directement ou via un courtier. Du point de vue du messaging, chaque service a plusieurs phases de vie :
- Initialisation du service.
À ce stade, la configuration et le démarrage du processus d'exécution du service et de ses dépendances ont lieu. - Création d'un point d'échange.
Le service peut utiliser un point d'échange statique défini dans la configuration du nœud, ou créer des points d'échange dynamiquement. - Enregistrement du service.
Pour que le service puisse traiter des requêtes, il doit être enregistré au point d'échange. - Fonctionnement normal.
Le service effectue un travail utile. - Fin de service.
Il existe 2 types de fin de service : ordinaire et exceptionnel. Dans le cas ordinaire, le service se déconnecte du point d'échange et s'arrête. En cas de situations d'urgence, le messaging exécute l'un des scénarios de traitement des pannes.
Cela peut sembler complexe, mais dans le code, ce n'est pas si effrayant. Des exemples de code avec des commentaires seront fournis dans l'analyse des modèles un peu plus tard.
Exchanges
Le point d'échange ‒ processus de messaging, réalisant la logique d'interaction avec les composants dans le cadre du modèle d'échange de messages. Dans tous les exemples présentés ci-dessous, les composants interagissent via des points d'échange, dont la combinaison forme le messaging.
Modèles d'échange de messages (MEPs)
Globalement, les modèles d'échange peuvent être classés en bidirectionnels et unidirectionnels. Les premiers impliquent une réponse au message reçu, tandis que les seconds non. Un exemple classique de modèle bidirectionnel dans l'architecture client-serveur est le modèle Request-response. Examinons le modèle et ses modifications.
Request-response ou RPC
Le RPC est utilisé lorsque nous avons besoin d'obtenir une réponse d'un autre processus. Ce processus peut être exécuté sur le même nœud ou se trouver sur un autre continent. Ci-dessous, un schéma d'interaction entre le client et de serveurs via messaging.
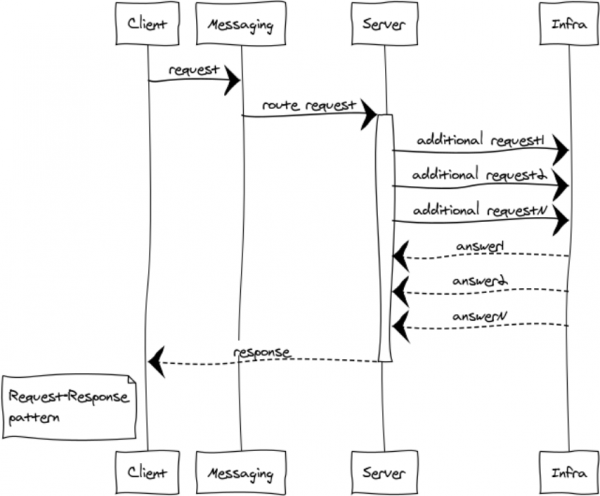
Puisque le messaging est entièrement asynchrone, pour le client, l'échange se divise en 2 phases :
Envoi de la requête
messaging:request(Exchange, ResponseMatchingTag, RequestDefinition, HandlerProcess).Échange ‒ nom unique du point d'échange
ResponseMatchingTag ‒ étiquette locale pour le traitement de la réponse. Par exemple, dans le cas de l'envoi de plusieurs requêtes identiques appartenant à différents utilisateurs.
RequestDefinition ‒ corps de la requête
HandlerProcess ‒ PID du gestionnaire. Ce processus recevra la réponse du serveur.Traitement de la réponse
handle_info(#'$msg'{exchange = EXCHANGE, tag = ResponseMatchingTag,message = ResponsePayload}, State)ResponsePayload ‒ réponse du serveur.
Pour le serveur, le processus se compose également de 2 phases :
- Initialisation du point d'échange
- Traitement des requêtes entrantes
Illustrons ce modèle par du code. Supposons que nous devions implémenter un service simple fournissant une méthode pour obtenir l'heure exacte.
Code du serveur
Déplaçons la définition de l'API du service dans api.hrl :
%% =====================================================
%%  entités
%% =====================================================
-record(time, {
  unixtime :: non_neg_integer(),
  datetime :: binary()
}).

-record(time_error, {
  code :: non_neg_integer(),
  error :: term()
}).

%% =====================================================
%%  méthodes
%% =====================================================
-record(time_req, {
  opts :: term()
}).
-record(time_resp, {
  result :: #time{} | #time_error{}
}).
Définissons le contrôleur du service dans time_controller.erl
%% L'exemple montre seulement le code significatif. En l'insérant dans le modèle gen_server, vous pouvez obtenir un service fonctionnel.

%% initialisation du gen_server
init(Args) ->
  %% connexion au point d'échange
  messaging:monitor_exchange(req_resp, ?EXCHANGE, default, self())
  {ok, #{}}.

%% traitement de l'événement de perte de connexion avec le point d'échange. Cet événement se produit également si le point d'échange n'a pas encore démarré.
handle_info(#exchange_die{exchange = ?EXCHANGE}, State) ->
  erlang:send(self(), monitor_exchange),
  {noreply, State};

%% traitement de l'API
handle_info(#time_req{opts = _Opts}, State) ->
  messaging:response_once(Client, #time_resp{
result = #time{ unixtime = time_utils:unixtime(now()), datetime = time_utils:iso8601_fmt(now())}
  });
  {noreply, State};

%% fin de travail du gen_server
terminate(_Reason, _State) ->
  messaging:demonitor_exchange(req_resp, ?EXCHANGE, default, self()),
  ok.
Code client
Pour envoyer une requête au service, vous pouvez appeler l'API de requête messaging de n'importe quel endroit du client :
case messaging:request(?EXCHANGE, tag, #time_req{opts = #{}}, self()) of
    ok -> ok;
    _ -> %% logique de répétition ou d'échec
end
Dans un système distribué, la configuration des composants peut être très variée et, au moment de la requête, messaging peut ne pas encore être en cours d'exécution, ou le contrôleur du service peut ne pas être prêt à traiter la requête. Il est donc nécessaire de vérifier la réponse de messaging et de gérer le cas d'échec.
Après l'envoi réussi, le service renverra une réponse ou une erreur au client.
Traitons les deux cas dans handle_info :
handle_info(#'$msg'{exchange = ?EXCHANGE, tag = tag, message = #time_resp{result = #time{unixtime = Utime}}}, State) ->
  ?debugVal(Utime),
  {noreply, State};

handle_info(#'$msg'{exchange = ?EXCHANGE, tag = tag, message = #time_resp{result = #time_error{code = ErrorCode}}}, State) ->
  ?debugVal({error, ErrorCode}),
  {noreply, State};
Request-Chunked Response
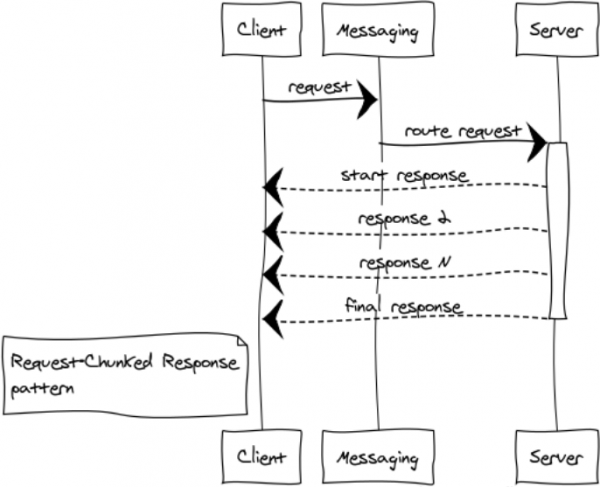
Il est préférable d'éviter de transmettre d'énormes messages. Cela affecte la réactivité et la stabilité de l'ensemble du système. Si la réponse à une demande occupe beaucoup de mémoire, il est nécessaire de la diviser en parties.
Je vais donner quelques exemples de ces cas:
- Les composants échangent des données binaires, comme des fichiers. Diviser la réponse en petites parties permet de traiter efficacement les fichiers de toute taille, sans provoquer de débordement de mémoire.
- Listages. Par exemple, nous devons sélectionner toutes les entrées d'une immense table dans la base de données et les transmettre à un autre composant.
J'appelle ces réponses des trains. En tout cas, 1024 messages de 1 Mo sont préférables à un seul message de 1 Go.
Dans un cluster Erlang, nous obtenons un avantage supplémentaire - une réduction de la charge sur le point d'échange et le réseau, car les réponses sont immédiatement envoyées au destinataire, contournant le point d'échange.
Response with Request
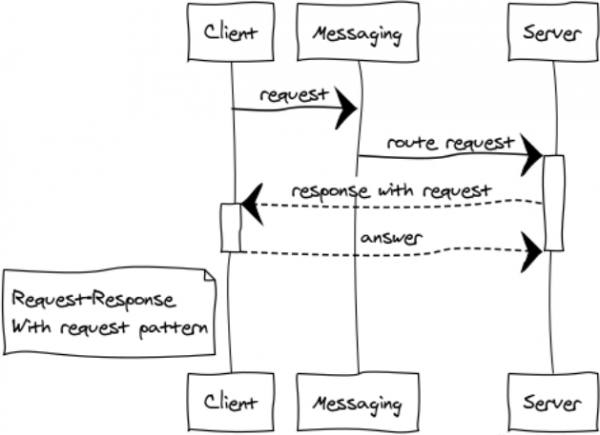
C'est une modification plutôt rare du modèle RPC pour construire des systèmes de dialogue.
Publication-abonnement (arbre de distribution de données)
Les systèmes orientés événements livrent les données aux consommateurs dès qu'elles sont prêtes. Ainsi, les systèmes sont plus enclins à un modèle de push qu'à un modèle de pull ou de poll. Cette caractéristique évite de gaspiller des ressources en interrogeant constamment et en attendant des données.
Le diagramme illustre le processus de diffusion d'un message aux consommateurs abonnés à un sujet particulier.
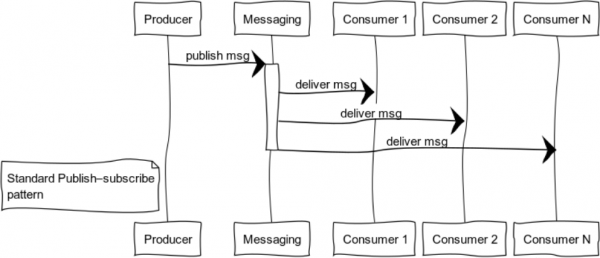
Des exemples classiques de l'utilisation de ce modèle incluent la diffusion de l'état : monde de jeu dans les jeux vidéo, données de marché sur les bourses, informations utiles dans les flux de données.
Examinons le code du souscripteur :
init(_Args) ->
  %% nous nous abonnissons à l'échange, clé = key
  messaging:subscribe(?SUBSCRIPTION, key, tag, self()),
  {ok, #{}}.

handle_info(#exchange_die{exchange = ?SUBSCRIPTION}, State) ->
  %% si le point d'échange n'est pas disponible, nous essayons de nous reconnecter
  messaging:subscribe(?SUBSCRIPTION, key, tag, self()),
  {noreply, State};

%% nous traitons les messages reçus
handle_info(#'$msg'{exchange = ?SUBSCRIPTION, message = Msg}, State) ->
  ?debugVal(Msg),
  {noreply, State};

%% lors de l'arrêt du consommateur - nous nous déconnectons du point d'échange
terminate(_Reason, _State) ->
  messaging:unsubscribe(?SUBSCRIPTION, key, tag, self()),
  ok.
La source peut appeler la fonction de publication de message à tout moment :
messaging:publish_message(Exchange, Key, Message).Échange ‒ nom du point d'échange,
Clé ‒ clé de routage
Message ‒ charge utile
Inverted Publish-subscribe
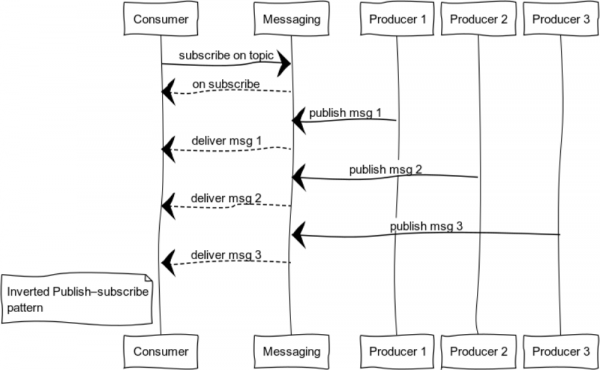
En déployant pub-sub, on peut obtenir un modèle pratique pour la journalisation. L'ensemble des sources et des consommateurs peut être complètement différent. L'illustration montre un cas avec un seul consommateur et plusieurs sources.
Modèle de distribution de tâches
Dans presque chaque projet, des tâches de traitement différé se présentent, telles que la génération de rapports, l'envoi de notifications, ou l'acquisition de données depuis des systèmes tiers. La capacité du système exécutant ces tâches peut être facilement évoluée en ajoutant des gestionnaires. Tout ce qu'il nous reste à faire, c'est de former un cluster de gestionnaires et de répartir équitablement les tâches entre eux.
Considérons les situations qui se présentent avec 3 gestionnaires. Dès la phase de répartition des tâches, la question de l'équité de la distribution et de la surcharge des gestionnaires se pose. L'équité sera gérée par une distribution round-robin, et pour éviter la saturation des gestionnaires, nous introduirons une limite prefetch_limit. En modes transitoires, prefetch_limit cela empêchera un gestionnaire de recevoir toutes les tâches.
Messaging gère les files d'attente et la priorité de traitement. Les gestionnaires reçoivent les tâches au fur et à mesure de leur arrivée. L'exécution d'une tâche peut se terminer par un succès ou un échec :
messaging:ack(Tack)‒ est appelé en cas de traitement réussi du messagemessaging:nack(Tack)‒ est appelé dans toutes les situations anormales. Après le retour d'une tâche, messaging la transmettra à un autre gestionnaire.
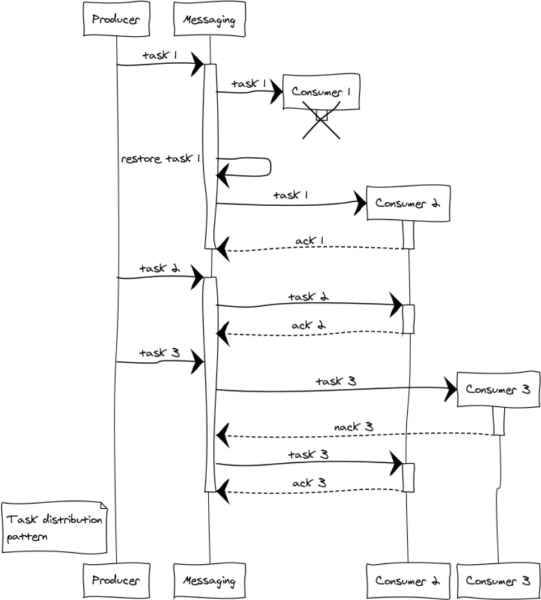
Supposons qu'en traitant trois tâches, une défaillance complexe se soit produite : le gestionnaire 1 est tombé après avoir reçu une tâche, sans avoir eu le temps de communiquer quoi que ce soit au point d'échange. Dans ce cas, le point d'échange, après le dépassement du délai d'ack, transmettra la tâche à un autre gestionnaire. Le gestionnaire 3 a refusé la tâche pour une raison quelconque et a envoyé un nack, en conséquence, la tâche a également été transférée à un autre gestionnaire qui l'a exécutée avec succès.
Bilan préliminaire
Nous avons passé en revue les principaux éléments des systèmes distribués et avons acquis une compréhension de base de leur application en Erlang/Elixir.
En combinant des modèles de base, on peut construire des paradigmes complexes pour résoudre les tâches émergentes.
Dans la dernière partie de la série, nous aborderons les questions générales sur l'organisation des services, le routage et l'équilibrage, ainsi que la partie pratique de la scalabilité et de la résilience des systèmes.
Fin de la deuxième partie.
Photo
Les illustrations ont été réalisées avec websequencediagrams.com
Source : habr.com
