

Introduction
Dans cet article, je vais vous parler d'un algorithme bien connu, celui de Huffman, ainsi que de son application dans la compression de données.
Nous allons donc écrire un petit outil de compression. Un article a déjà été , mais sans mise en œuvre pratique. Le contenu théorique du post actuel est tiré des cours d'informatique à l'école et du livre de Robert Lafore « Data Structures and Algorithms in Java ». Alors, tout est dans le texte !
Quelques réflexions
Dans un fichier texte ordinaire, un symbole est codé sur 8 bits (encodage ASCII) ou 16 (encodage Unicode). Nous allons examiner l'encodage ASCII. Prenons l'exemple de la chaîne s1 = « SUSIE SAYS IT IS EASYn ». Il y a 22 caractères dans cette chaîne, y compris les espaces et le retour à la ligne — ‘n’. Un fichier contenant cette chaîne pèsera 22*8 = 176 bits. La question se pose alors : est-il rationnel d'utiliser tous les 8 bits pour coder 1 symbole ? En effet, nous n'utilisons pas tous les symboles de l'encodage ASCII. Même si nous le faisions, il serait plus rationnel d'attribuer le code le plus court à la lettre la plus fréquente — S — et un code plus long à la lettre la plus rare — T (ou U, ou ‘n’). C'est là qu'intervient l'algorithme de Huffman : il s'agit de trouver la meilleure façon de coder, de sorte que le fichier ait le poids le plus léger possible. Il est tout à fait normal que différents symboles aient des longueurs de code différentes — c'est la base de l'algorithme.
Codage
Pourquoi ne pas donner par exemple au symbole ‘S’ un code d'une longueur d'1 bit : 0 ou 1 ? Prenons 1. Alors, au deuxième symbole se rencontrant le plus souvent — ‘ ‘ (espace) — nous donnerons 0. Imaginez : vous commencez à décoder votre message — la chaîne codée s1 — et vous voyez que le code commence par 1. Alors, que faire : est-ce le symbole S, ou un autre symbole, par exemple A ? C'est pourquoi une règle importante émerge :
Aucun code ne doit être le préfixe d'un autre
Cette règle est essentielle dans l'algorithme. C'est pourquoi la création de codes commence par une table de fréquences qui indique la fréquence (le nombre d'occurrences) de chaque symbole :
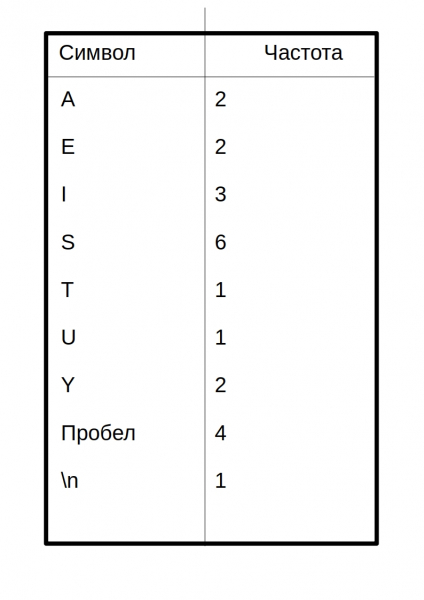 Les symboles avec le plus grand nombre d'occurrences doivent être codés avec le nombre minimal possible de bits. Voici un exemple d'une table de codes possible :
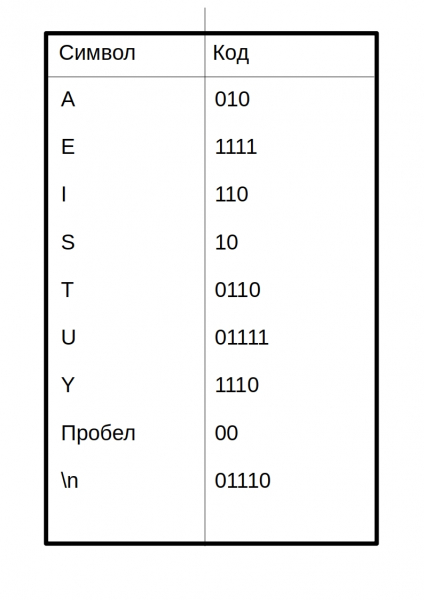 Ainsi, le message codé apparaîtra comme suit :
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 J'ai séparé chaque code de symbole par un espace. En réalité, dans le fichier compressé, cela ne sera pas le cas !
La question se pose : comment ce débutant a-t-il inventé le code pour créer une table de codes ? C'est ce dont nous allons parler ci-dessous.
Construction de l'arbre de Huffman
Les arbres binaires de recherche viennent à la rescousse ici. Ne vous inquiétez pas, aucune méthode de recherche, d'insertion ou de suppression ne sera nécessaire. Voici la structure de l'arbre en java :
public class Node {
    private int frequence;
    private char letter;
    private Node leftChild;
    private Node rightChild;
    ...
}
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }
    public BinaryTree(Node root) {
        this.root = root;
    }
    ...
}
Ce n'est pas le code complet, le code complet sera indiqué ci-dessous.
Voici l'algorithme de construction de l'arbre :
- Créer un objet Node pour chaque caractère du message (chaîne s1). Dans notre cas, il y aura 9 nœuds (objets Node). Chaque nœud se compose de deux champs de données : le caractère et la fréquence.
- Créer un objet Arbre (BinaryTree) pour chaque nœud Node. Le nœud devient la racine de l'arbre.
- Insérer ces arbres dans une file d'attente prioritaire. Moins la fréquence est élevée, plus la priorité est grande. Ainsi, lors de l'extraction, l'arbre de la plus faible fréquence est toujours choisi.
Ensuite, il faut faire ce qui suit en boucle :
- Extraire deux arbres de la file d'attente prioritaire et faire d'eux des descendants d'un nouveau nœud (le nœud qui vient d'être créé sans lettre). La fréquence du nouveau nœud est égale à la somme des fréquences des deux arbres descendants.
- Pour ce nœud, créer un arbre avec la racine dans ce nœud. Insérer cet arbre à nouveau dans la file d'attente prioritaire. (Étant donné que l'arbre a une nouvelle fréquence, il est probable qu'il prenne un nouvel emplacement dans la file d'attente.)
- Continuer à exécuter les étapes 1 et 2 jusqu'à ce qu'il ne reste qu'un seul arbre dans la file d'attente — l'arbre de Huffman.
Examinons cet algorithme sur la chaîne s1 :
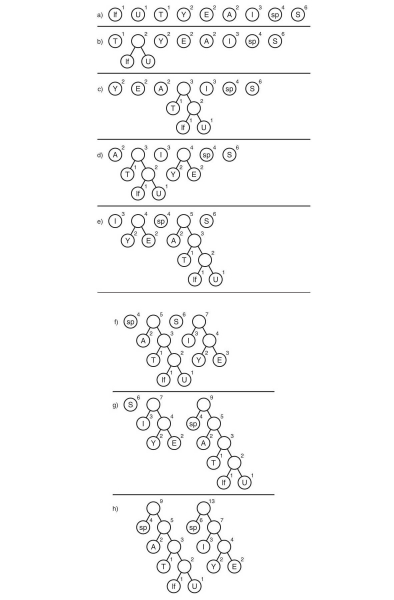
Ici, le symbole « lf » (linefeed) désigne un retour à la ligne, « sp » (space) — un espace.
Et ensuite ?
Nous avons obtenu l'arbre de Huffman. Eh bien d'accord. Que faire avec ça ? Même pas gratuit. Ensuite, il faut suivre tous les chemins possibles de la racine aux feuilles de l'arbre. Nous convenons de désigner une arête par 0 si elle mène au descendant gauche et par 1 — si elle mène au descendant droit. Strictement parlant, dans cette notation, le code d'un symbole — c'est le chemin de la racine de l'arbre à la feuille contenant ce symbole.
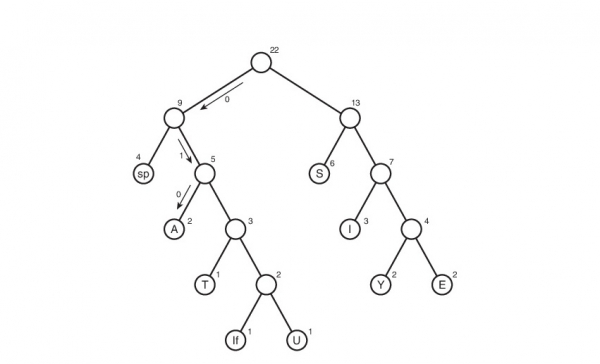
Ainsi, la table de codes a été créée. Notons que si nous examinons cette table, nous pouvons tirer des conclusions sur le « poids » de chaque symbole — c'est la longueur de son code. Ainsi, dans sa version compressée, le fichier original pèsera : 2 * 3 + 2*4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bits. Au début, il pesait 176 bits. Par conséquent, nous l'avons réduit d'un facteur de 176/65 = 2,7 fois ! Mais c'est une utopie. Un tel coefficient serait difficilement réalisable. Pourquoi ? Nous en parlerons un peu plus tard.
Décodage
Eh bien, il ne reste plus que la partie la plus simple — le décodage. Je pense que beaucoup d'entre vous ont deviné qu'il est impossible de créer un fichier compressé sans aucune indication de la manière dont il a été codé — nous ne pourrons pas le décoder ! Oui, j'ai eu du mal à l'accepter, mais il va falloir créer un fichier texte table.txt avec la table de compression :
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
Enregistrer la table sous la forme ‘symbole’ « code du symbole ». Pourquoi 01110 sans symbole ? En réalité, il y a un symbole, c'est juste que les outils Java que j'ai utilisés lors de l'écriture dans le fichier convertissent le caractère de retour à la ligne — ‘n’ — en un passage à la ligne (aussi absurde que cela puisse paraître). C'est pourquoi la ligne vide en haut représente le symbole pour le code 01110. Pour le code 00, le symbole est un espace en début de ligne. Je dirai tout de suite que notre coefficient est mort ; cette méthode de stockage de la table peut prétendre être la plus irrationnelle. Mais elle est facile à comprendre et à mettre en œuvre. Je suis heureux d'écouter vos recommandations dans les commentaires concernant l'optimisation.
Avec cette table, il est très simple de décoder. Rappelons-nous quelle règle nous avons suivie lors de la création de l'encodage :
Aucun code ne doit être le préfixe d'un autre
C'est ici qu'elle joue un rôle facilitateur. Nous lisons bit par bit et, dès que la chaîne d, composée des bits lus, correspond à l'encodage correspondant au symbole character, nous savons immédiatement que le symbole character a été encodé (et seulement lui !). Ensuite, nous écrivons character dans la chaîne de décodage (la chaîne contenant le message décodé), nous réinitialisons la chaîne d, et nous continuons à lire le fichier codé.
Mise en œuvre
Il est temps de rabaisser mon code et d'écrire un compresseur. Appelons-le Compressor.
Commençons par le début. Tout d'abord, écrivons la classe Node :
classe publique Node {
    private int frequence; // fréquence
    private char letter; // lettre
    private Node leftChild; // enfant gauche
    private Node rightChild; // enfant droit

    public Node(char letter, int frequence) { // constructeur
        this.letter = letter;
        this.frequence = frequence;
    }

    public Node() {} // surcharge du constructeur pour les nœuds anonymes (voir ci-dessus dans la section sur la construction de l'arbre de Huffman)
    public void addChild(Node newNode) { // ajouter un enfant
        if (leftChild == null) // si gauche est vide, alors droit aussi, ajoutons à gauche
            leftChild = newNode;
        else {
            if (leftChild.getFrequence() <= newNode.getFrequence()) // généralement, comme enfant gauche
                rightChild = newNode; // deviendra celui avec moins de fréquence
            else {
                rightChild = leftChild;
                leftChild = newNode;
            }
        }

        frequence += newNode.getFrequence(); // fréquence totale
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public int getFrequence() {
        return frequence;
    }

    public char getLetter() {
        return letter;
    }

    public boolean isLeaf() { // vérification si c'est une feuille
        return leftChild == null && rightChild == null;
    }
}
Maintenant l'arbre :
classe BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }

    public BinaryTree(Node root) {
        this.root = root;
    }

    public int getFrequence() {
        return root.getFrequence();
    }

    public Node getRoot() {
        return root;
    }
}
File de priorité :
import java.util.ArrayList; // oui, la file sera basée sur une liste

classe PriorityQueue {
    private ArrayList data; // liste de la file
    private int nElems; // nombre d'éléments dans la file

    public PriorityQueue() {
        data = new ArrayList();
        nElems = 0;
    }

    public void insert(BinaryTree newTree) { // insertion
        if (nElems == 0)
            data.add(newTree);
        else {
            for (int i = 0; i  newTree.getFrequence()) { // si la fréquence de l'arbre inséré est plus faible
                    data.add(i, newTree); // que la fr. actuelle, alors décalons tous les arbres à droite d'une case
                    break; // ensuite plaçons le nouvel arbre à la position de l'actuel
                }
                if (i == nElems - 1)
                    data.add(newTree);
            }
        }
        nElems++; // augmenter le nombre d'éléments de 1
    }

    public BinaryTree remove() { // suppression de la file
        BinaryTree tmp = data.get(0); // copie de l'élément à supprimer
        data.remove(0); // suppression proprement dite
        nElems--; // diminuer le nombre d'éléments de 1
        return tmp; // retourner l'élément supprimé (l'élément avec la plus petite fréquence)
    }
}
Classe créant un arbre de Huffman :
classe publique HuffmanTree {
    private final byte TAILLE_TABLEAU_ENCODING = 127; // longueur de la table d'encodage
    private String monString; // message
    private BinaryTree arbreHuffman; // arbre de Huffman
    private int[] tableauFreq; // tableau de fréquence
    private String[] tableauEncoding; // table d'encodage


    //----------------constructeur----------------------
    public HuffmanTree(String newString) {
        monString = newString;

        tableauFreq = new int[TAILLE_TABLEAU_ENCODING];
        remplirTableauFrequence();

        arbreHuffman = obtenirArbreHuffman();

        tableauEncoding = new String[TAILLE_TABLEAU_ENCODING];
        remplirTableauEncoding(arbreHuffman.getRoot(), "", "");
    }

    //--------------------tableau de fréquence------------------------
    private void remplirTableauFrequence() {
        for (int i = 0; i < monString.length(); i++) {
            tableauFreq[(int)monString.charAt(i)]++;
        }
    }

    public int[] getTableauFrequence() {
        return tableauFreq;
    }

    //------------------------création de l'arbre de Huffman------------------
    private BinaryTree obtenirArbreHuffman() {
        PriorityQueue pq = new PriorityQueue();
        // algorithme décrit ci-dessus
        for (int i = 0; i < TAILLE_TABLEAU_ENCODING; i++) {
            if (tableauFreq[i] != 0) { // si le symbole existe dans la chaîne
                Node nouveauNode = new Node((char) i, tableauFreq[i]); // alors créer un Node pour lui
                BinaryTree nouvelArbre = new BinaryTree(nouveauNode); // et créer un BinaryTree pour le Node
                pq.insert(nouvelArbre); // insérer dans la file d'attente
            }
        }

        while (true) {
            BinaryTree arbre1 = pq.remove(); // extraire le premier arbre de la file d'attente.

            try {
                BinaryTree arbre2 = pq.remove(); // extraire le deuxième arbre de la file d'attente

                Node nouveauNode = new Node(); // créer un nouveau Node
                nouveauNode.addChild(arbre1.getRoot()); // faire des deux arbres extraits ses enfants
                nouveauNode.addChild(arbre2.getRoot());

                pq.insert(new BinaryTree(nouveauNode);
            } catch (IndexOutOfBoundsException e) { // il reste un arbre dans la file d'attente
                return arbre1;
            }
        }
    }

    public BinaryTree getTree() {
        return arbreHuffman;
    }

    //-------------------tableau d'encodage------------------
    void remplirTableauEncoding(Node node, String codeAvant, String direction) { // remplir la table d'encodage
        if (node.isLeaf()) {
            tableauEncoding[(int)node.getLetter()] = codeAvant + direction;
        } else {
            remplirTableauEncoding(node.getLeftChild(), codeAvant + direction, "0");
            remplirTableauEncoding(node.getRightChild(), codeAvant + direction, "1");
        }
    }

    String[] getTableauEncoding() {
        return tableauEncoding;
    }

    public void displayTableauEncoding() { // pour le débogage
        remplirTableauEncoding(arbreHuffman.getRoot(), "", "");

        System.out.println("======================Tableau d'encodage====================");
        for (int i = 0; i < TAILLE_TABLEAU_ENCODING; i++) {
            if (tableauFreq[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(tableauEncoding[i]);
            }
        }
        System.out.println("========================================================");
    }
    //-----------------------------------------------------
    String getOriginalString() {
        return monString;
    }
}
Classe qui encode/décodent :
public class HuffmanOperator {
    private final byte TAILLE_TABLE_ENCODING = 127; // longueur de la table
    private HuffmanTree arbreHuffmanPrincipal; // arbre de Huffman (utilisé uniquement pour la compression)
    private String monString; // message original
    private int[] tableauFreq; // tableau de fréquence
    private String[] tableauEncoding; // tableau de codage
    private double ratio; // coefficient de compression


    public HuffmanOperator(HuffmanTree arbreHuffmanPrincipal) { // pour la compression
        this.arbreHuffmanPrincipal = arbreHuffmanPrincipal;

        monString = arbreHuffmanPrincipal.getOriginalString();

        tableauEncoding = arbreHuffmanPrincipal.getEncodingArray();

        tableauFreq = arbreHuffmanPrincipal.getFrequenceArray();
    }

    public HuffmanOperator() {} // pour extraire;

    // ---------------------------------------compression-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermediaire = ""; // chaîne intermédiaire (sans zéros ajoutés)
        // System.out.println("=============================Compression=======================");
        // displayEncodingArray();
        for (int i = 0; i
        // il faut ajouter des zéros à la fin (on peut en ajouter 1, peu importe)
        byte compteur = 0; // nombre de zéros ajoutés à la fin (un byte suffit : 0<=compteur<8<127)
        for (int longueur = intermediaire.length(), delta = 8 - longueur % 8;
                compteur < delta; compteur++) { // delta - nombre de zéros ajoutés
            intermediaire += "0";
        }

        // coller le nombre de zéros ajoutés dans la représentation binaire et la chaîne intermédiaire
        compressed = String.format("%8s", Integer.toBinaryString(compteur & 0xff)).replace(" ", "0") + intermediaire;

        // coefficient idéalisé
        setCompressionRatio();
        // System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() { // calculer le coefficient idéalisé
        double sommeA = 0, sommeB = 0; // A-la somme originale
        for (int i = 0; i < TAILLE_TABLE_ENCODING; i++) {
            if (tableauFreq[i] != 0) {
                sommeA += 8 * tableauFreq[i];
                sommeB += tableauEncoding[i].length() * tableauFreq[i];
            }
        }
        ratio = sommeA / sommeB;
    }

    public byte[] getBytedMsg() { // compression finale
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] bytesCompresse = new byte[compressedString.length() / 8];
        for (int i = 0; i < bytesCompresse.length; i++) {
            bytesCompresse[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return bytesCompresse;
    }
    // ---------------------------------------fin de la compression----------------------------------------------------------------
    // ------------------------------------------------------------extraction-----------------------------------------------------
    public String extract(String compressed, String[] nouveauTableauEncoding) {
        String decompressed = "";
        String courant = "";
        String delta = "";
        tableauEncoding = nouveauTableauEncoding;

        // displayEncodingArray();
        // obtenir le nombre de zéros insérés
        for (int i = 0; i < 8; i++)
            delta += compressed.charAt(i);
        int ZEROS_AJOUTES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ZEROS_AJOUTES; i < l; i++) {
            // i = 8, car le premier byte contient le nombre de zéros ajoutés
            courant += compressed.charAt(i);
            for (int j = 0; j < TAILLE_TABLE_ENCODING; j++) {
                if (courant.equals(tableauEncoding[j])) { // si ça correspond
                    decompressed += (char)j; // alors on ajoute l'élément
                    courant = ""; // et on réinitialise la chaîne actuelle
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < tableauEncoding.length; i++) {
            if (tableauFreq[i] != 0)
                enc += (char)i + tableauEncoding[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }


    public void displayEncodingArray() { // pour le débogage
        System.out.println("======================Table de codage====================");
        for (int i = 0; i < TAILLE_TABLE_ENCODING; i++) {
            // if (tableauFreq[i] != 0) {
            System.out.print((char)i + " ");
            System.out.println(tableauEncoding[i]);
            // }
        }
        System.out.println("========================================================");
    }
}
Classe facilitant l'écriture dans un fichier :
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
        try (PrintWriter pw = new PrintWriter(outputFile)) {
            pw.write(msg);
        } catch (FileNotFoundException e) {
            System.out.println("Chemin incorrect ou fichier inexistant !");
        }
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Classe facilitant la lecture depuis un fichier :
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
    private FileInputStream fileInputStream;
    private BufferedReader fileBufferedReader;

    public FileInputHelper(File file) throws IOException {
        fileInputStream = new FileInputStream(file);
        fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
    }

    public byte readByte() throws IOException {
        int cur = fileInputStream.read();
        if (cur == -1) // si le fichier est terminé
            throw new EOFException();
        return (byte)cur;
    }

    public String readLine() throws IOException {
        return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException {
        fileInputStream.close();
    }
}
Eh bien, la classe principale :
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try { // Spécifiez l'instruction à l'aide des arguments de la ligne de commande
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Format des arguments d'entrée incorrect");
            System.out.println("Veuillez lire Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Chemin incorrect, ou ce fichier n'existe pas !");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("L'encodage du fichier actuel n'est pas pris en charge");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        // Créer le fichier avec la table d'encodage :

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Chemin vers le fichier compressé : " + compressedFile.getAbsolutePath());
        System.out.println("Chemin vers la table d'encodage " + table.getAbsolutePath());
        System.out.println("Sans table, le fichier ne pourra pas être extrait !");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; // ratio idéalisé
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; // vrai ratio

        System.out.println("Le ratio de compression idéalisé est " + idealRatio);
        System.out.println("Le ratio de compression tenant compte de la table d'encodage " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        // lire le fichier compressé
        //!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!! vérifiez ici :
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte(); // la méthode retourne EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        //--------------------

        // lire la table d'encodage :
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine(); // sauter la première ligne vide
        	encodingArray[(byte)'n'] = fi.readLine(); // lire le code pour 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        // extraction :
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Chemin vers le fichier décompressé " + extractedFile.getAbsolutePath());
    }
}
Vous devez écrire vous-même le fichier d'instructions readme.txt 🙂
Conclusion
C'est probablement tout ce que je voulais dire. Si vous avez quelque chose à dire concernant mon incompétence à améliorer le code, l'algorithme, ou toute autre optimisation, n'hésitez pas à le faire. Si j'ai omis quelque chose, dites-le aussi. Je serais ravi de vous entendre dans les commentaires !
P.S.
Oui-oui, je suis toujours là, car je n'ai pas oublié le coefficient. Pour la chaîne s1, la table de codage pèse 48 octets — beaucoup plus que le fichier d'origine, et n'oublions pas les zéros supplémentaires (le nombre de zéros ajoutés est égal à 7) => le coefficient de compression sera inférieur à un : 176/(65 + 48*8 + 7)=0.38. Si vous l'avez remarqué aussi, alors vous avez fait un bon travail. Oui, cette implémentation sera très inefficace pour les petits fichiers. Mais que se passe-t-il avec les gros fichiers ? Les tailles de fichier dépassent de loin la taille de la table de codage. C'est ici que l'algorithme fonctionne comme il se doit ! Par exemple, pour le compresseur donne un véritable coefficient (non idéalisé) de 1,46 — presque une fois et demie ! Et oui, il était prévu que le fichier soit en anglais.
Source : habr.com
