

Bien que les données soient désormais omniprésentes, les bases de données analytiques restent encore relativement exotiques. Elles sont mal connues et encore moins bien exploitées. Beaucoup continuent à "manger des cactus" avec MySQL ou PostgreSQL, qui sont conçues pour d'autres scénarios, à lutter avec NoSQL ou à payer trop cher pour des solutions commerciales. ClickHouse change la donne et réduit considérablement la barrière à l'entrée dans le monde des SGBD analytiques.
Présentation de BackEnd Conf 2018, publiée avec l'autorisation de l'intervenant.
Qui suis-je et pourquoi parle-t-il de ClickHouse ? Je suis directeur du développement chez LifeStreet, une entreprise qui utilise ClickHouse. De plus, je suis le fondateur d'Altinity. C'est un partenaire de Yandex, qui promeut ClickHouse et aide Yandex à le rendre plus performant. Je suis également prêt à partager mes connaissances sur ClickHouse.
Et non, je ne suis pas le frère de Petya Zaytsev. On me pose souvent cette question. Non, nous ne sommes pas frères.
« Il est de notoriété publique » que ClickHouse :
- Très rapide,
- Très facile à utiliser,
- Utilisé chez Yandex.
Il est un peu moins connu dans quelles entreprises et comment il est utilisé.
Je vais vous expliquer pourquoi, où et comment ClickHouse est utilisé, au-delà de Yandex.
Je vais montrer comment des tâches spécifiques sont résolues avec ClickHouse dans différentes entreprises, quels outils ClickHouse vous pouvez utiliser pour vos besoins, et comment ils ont été employés dans diverses entreprises.
J'ai sélectionné trois exemples qui montrent ClickHouse sous différents angles. Je pense que cela sera intéressant.
Première question : « Pourquoi ClickHouse ? ». Cela semble assez évident, mais il y a plus d'une réponse.
- La première réponse est la performance. ClickHouse est très rapide. L'analyse avec ClickHouse est également très rapide. On peut souvent l'utiliser là où d'autres solutions fonctionnent très lentement ou très mal.
- La deuxième réponse est le coût. Et surtout le coût de l'évolutivité. Par exemple, Vertica est une base de données absolument excellente. Elle fonctionne très bien si vous avez moins de quelques téraoctets de données. Mais dès qu'il s'agit de centaines de téraoctets ou de pétaoctets, le coût de la licence et du support devient assez conséquent. Et cela devient cher. Alors que ClickHouse est gratuit.
- La troisième réponse concerne le coût opérationnel. C'est une approche un peu différente. RedShift est une excellente alternative. Avec RedShift, vous pouvez rapidement trouver une solution. Elle fonctionnera bien, mais chaque heure, chaque jour et chaque mois, vous paierez assez cher Amazon, car c'est un service considérablement coûteux. Google BigQuery aussi. Ceux qui l'ont utilisé savent qu'il est possible d'exécuter plusieurs requêtes et de recevoir soudainement une facture de plusieurs centaines de dollars.
Ces problèmes n'existent pas avec ClickHouse.
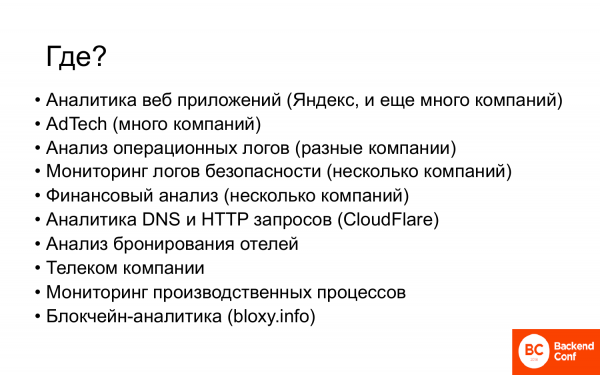
Où ClickHouse est-il utilisé actuellement ? En plus de Yandex, ClickHouse est utilisé par de nombreuses entreprises et sociétés.
- Avant tout, il s'agit d'analytique des applications web, c'est-à-dire un cas d'utilisation qui provient de Yandex.
- De nombreuses entreprises AdTech utilisent ClickHouse.
- De nombreuses sociétés qui ont besoin d'analyser des journaux opérationnels provenant de différentes sources.
- Quelques entreprises utilisent ClickHouse pour le monitoring des journaux de sécurité. Elles les chargent dans ClickHouse, réalisent des rapports et obtiennent les résultats dont elles ont besoin.
- Les entreprises commencent à l'utiliser dans l'analyse financière, c'est-à-dire que lentement, les grandes entreprises se tournent également vers ClickHouse.
- CloudFlare. Si quelqu'un suit ClickHouse, il a sans doute entendu le nom de cette entreprise. C'est l'un des contributeurs majeurs de la communauté. Et ils ont une installation ClickHouse très sérieuse. Par exemple, ils ont créé Kafka Engine pour ClickHouse.
- Les entreprises de télécommunications ont commencé à l'utiliser. Quelques entreprises utilisent ClickHouse soit comme preuve de concept, soit déjà en production.
- Une entreprise utilise ClickHouse pour surveiller les processus de production. Elles testent des puces, notent de nombreux paramètres, environ 2000 caractéristiques. Puis elles analysent – est-ce un bon lot ou un mauvais.
- Analyse blockchain. Il existe une entreprise russe, Bloxy.info. C'est une analyse du réseau Ethereum. C'est également ce qu'ils ont réalisé sur ClickHouse.
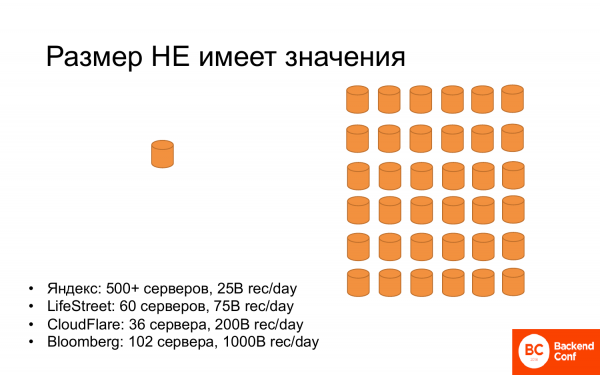
De plus, la taille n'a pas d'importance. De nombreuses entreprises utilisent un petit serveur. Et cela leur permet de résoudre leurs problèmes. Encore plus d'entreprises utilisent de grands clusters composés de nombreux serveurs ou de dizaines de serveurs.
Et si l'on regarde les records, voici :
- Yandex : plus de 500 serveurs, 25 milliards d'enregistrements par jour qu'ils y conservent.
- LifeStreet : 60 serveurs, environ 75 milliards d'enregistrements par jour. Moins de serveurs, plus d'enregistrements que chez Yandex.
- CloudFlare : 36 serveurs, 200 milliards d'enregistrements par jour qu'ils conservent. Ils ont encore moins de serveurs et encore plus de données qu'ils conservent.
- Bloomberg : 102 de serveurs, environ un trillion d'enregistrements par jour. Champion des enregistrements.
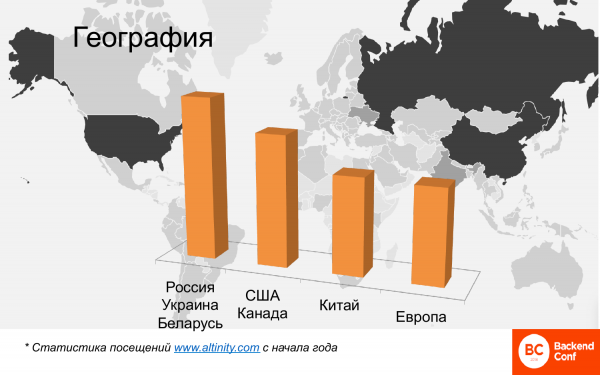
Géographiquement, c'est aussi beaucoup. Cette carte montre la heatmap où ClickHouse est utilisé dans le monde. La Russie, la Chine et l'Amérique y sont bien mises en évidence. Peu de pays européens. Et on peut distinguer 4 clusters.
Il s'agit d'une analyse comparative, il n'est pas nécessaire de chercher des chiffres absolus. C'est une analyse des visiteurs qui lisent des contenus en anglais sur le site d'Altinity, car il n'y a pas de contenus en russe. Et la Russie, l'Ukraine, la Biélorussie, c'est-à-dire la partie russophone de la communauté, ce sont les utilisateurs les plus nombreux. Ensuite viennent les États-Unis et le Canada. La Chine les rattrape très vite. Il y a six mois, la Chine était presque absente, maintenant la Chine a déjà dépassé l'Europe et continue de croître. La vieille Europe ne reste pas en arrière, et le leader de l'utilisation de ClickHouse est, curieusement, la France.
Pourquoi je vous raconte tout cela ? Pour montrer que ClickHouse devient une solution standard pour l'analyse de grandes données et est déjà utilisé dans de nombreux domaines. Si vous l'utilisez, vous êtes dans la bonne tendance. Si vous ne l'avez pas encore utilisé, n'ayez pas peur de vous retrouver seul et de ne pas avoir d'aide, car beaucoup s'y consacrent déjà.
Voici des exemples d'utilisation réelle de ClickHouse dans plusieurs entreprises.
- Le premier exemple est un réseau publicitaire : migration de Vertica vers ClickHouse. Et je connais plusieurs entreprises qui sont passées de Vertica ou qui sont en train de migrer.
- Le deuxième exemple est un entrepôt transactionnel sur ClickHouse. C'est un exemple construit sur des antipatterns. Tout ce qu'il ne faut pas faire dans ClickHouse selon les conseils des développeurs a été réalisé ici. Et en même temps, c'est fait de manière tellement efficace que cela fonctionne. Et cela fonctionne bien mieux qu'une solution transactionnelle typique.
- Le troisième exemple est le calcul distribué sur ClickHouse. Il y avait une question sur comment intégrer ClickHouse dans l'écosystème Hadoop. Je vais montrer un exemple de la manière dont une entreprise a fait sur ClickHouse quelque chose de similaire à un conteneur Map Reduce, en surveillant la localisation des données, etc., pour résoudre une tâche très non triviale.
- LifeStreet – C'est une entreprise Ad Tech qui possède toutes les technologies liées au réseau publicitaire.
- Elle se concentre sur l'optimisation des annonces et le programmatic bidding.
- Beaucoup de données : environ 10 milliards d'événements par jour. De plus, ces événements peuvent être divisés en plusieurs sous-événements.
- De nombreux clients utilisent ces données, et ce ne sont pas seulement des personnes, mais bien plus encore – ce sont divers algorithmes qui s'occupent des enchères programmatiques.
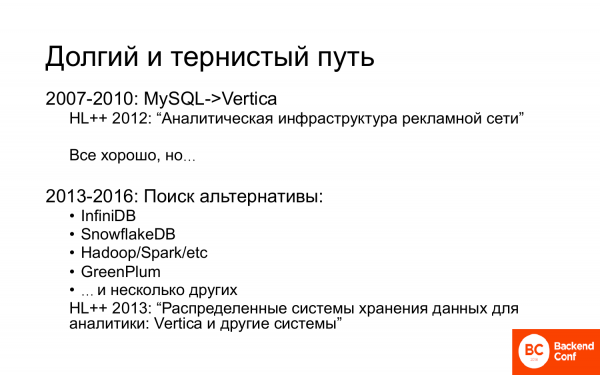
L'entreprise a parcouru un long et difficile chemin. J'en ai déjà parlé lors de HighLoad. Au début, LifeStreet est passée de MySQL (avec un bref arrêt sur Oracle) à Vertica. On peut trouver un récit à ce sujet.
Tout allait très bien, mais il est rapidement devenu évident que les données augmentaient et que Vertica devenait coûteux. Nous cherchions donc différentes alternatives. Certaines d'entre elles sont listées ici. En réalité, nous avons réalisé une preuve de concept ou parfois un test de performance pour presque toutes les bases de données qui étaient disponibles sur le marché entre 2013 et 2016 et qui correspondaient à nos besoins fonctionnels. J'en ai également parlé lors de HighLoad.
L'objectif était de migrer de Vertica en premier lieu, car les données croissaient. Et elles ont augmenté de manière exponentielle pendant plusieurs années. Ensuite, elles ont atteint un plateau, mais néanmoins. En prévoyant cette croissance, les exigences commerciales en matière de volume de données pour lesquelles une analyse était nécessaire laissaient entendre que dans peu de temps, nous parlerions de pétaoctets. Et payer pour des pétaoctets coûte très cher, nous cherchions donc une alternative vers laquelle nous diriger.
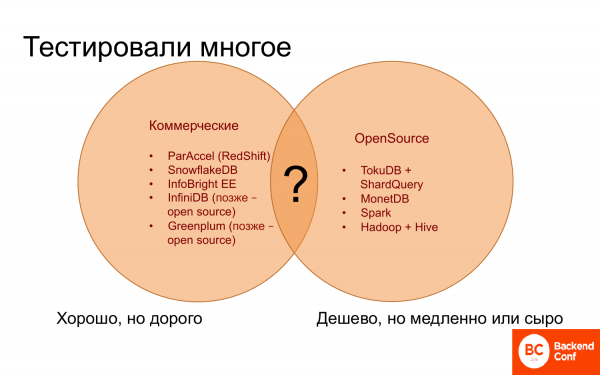
Où aller ? Pendant longtemps, il était totalement unclear où se diriger, car d'une part, il existe des bases de données commerciales qui semblent fonctionner assez bien. Certaines fonctionnent presque aussi bien que Vertica, d'autres un peu moins. Mais elles sont toutes chères, rien de moins cher et de meilleur ne semblait disponible.
D'autre part, il existe des solutions open source, qui ne sont pas très nombreuses, c'est-à-dire qu'on peut les compter sur les doigts d'une main pour l'analyse. Elles sont gratuites ou peu coûteuses, mais fonctionnent lentement. De plus, elles manquent souvent de la fonctionnalité nécessaire et utile.
En somme, rien ne combinait les avantages des bases de données commerciales et tout ce qui est gratuit dans l'open source – il n'y avait rien.
Il n'y avait rien jusqu'à ce qu'inattendu, Yandex sorte, comme un magicien tirant un lapin de son chapeau, ClickHouse. Et c'était une solution inattendue, la question reste posée : « Pourquoi ? », mais néanmoins.
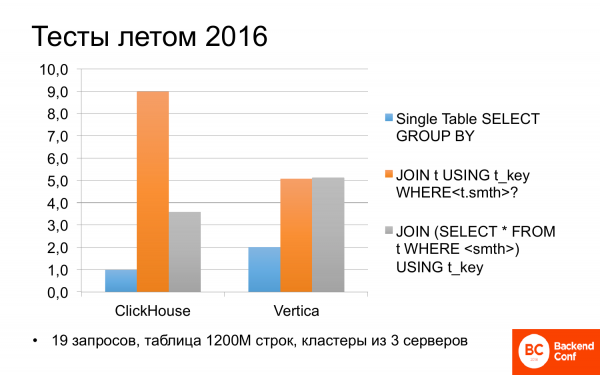
Et dès l'été 2016, nous avons commencé à nous intéresser à ClickHouse. Et il s'est avéré qu'il peut parfois être plus rapide que Vertica. Nous avons testé différents scénarios avec différentes requêtes. Et si la requête n'utilisait qu'une seule table, c'est-à-dire sans aucune jointure, alors ClickHouse était deux fois plus rapide que Vertica.
Je n'ai pas été paresseux et j'ai également regardé d'autres tests de Yandex récemment. Là, c'est la même chose : ClickHouse est deux fois plus rapide que Vertica, c'est pourquoi ils en parlent souvent.
Mais si les requêtes comportent des jointures, alors tout devient moins clair. Et ClickHouse peut être deux fois plus lent que Vertica. Si l'on modifie légèrement la requête et qu'on la réécrit, cela devient à peu près équivalent. Pas mal. Et c'est gratuit.
Et après avoir obtenu les résultats des tests et les avoir examinés sous différents angles, LifeStreet a adopté ClickHouse.
Nous sommes donc en 2016, je vous le rappelle. C'était comme dans l'anecdote sur les souris qui pleuraient et se piquaient, mais continuaient à manger le cactus. Cela a été expliqué en détail, il y a une vidéo à ce sujet, etc.
Je ne vais donc pas en parler en détail, je vais seulement vous parler des résultats et de quelques éléments intéressants que je n'avais pas mentionnés à l'époque.
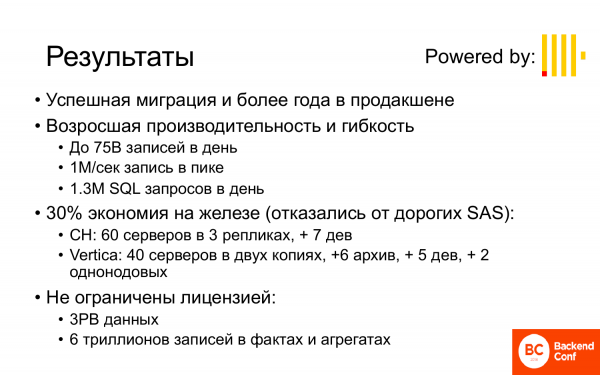
Les résultats sont :
- Migration réussie et le système fonctionne déjà en production depuis plus d'un an.
- La performance et la flexibilité ont augmenté. Des 10 milliards d'enregistrements que nous pouvions nous permettre de stocker par jour et pour une courte période, LifeStreet stocke maintenant 75 milliards d'enregistrements par jour et peut le faire pendant 3 mois et plus. Si l'on considère les pics, cela représente jusqu'à un million d'événements par seconde. Plus d'un million de requêtes SQL par jour arrivent dans ce système, principalement provenant de différents robots.
- Bien que ClickHouse utilise plus de serveurs que Vertica, il y a eu des économies sur le matériel, car Vertica utilisait des disques SAS relativement coûteux. En revanche, ClickHouse utilisait des disques SATA. Pourquoi ? Parce qu'avec Vertica, l'insertion est synchrone. Et la synchronisation nécessite que les disques ne ralentissent pas trop, ainsi que le réseau, c'est-à-dire que c'est une opération relativement coûteuse. En revanche, avec ClickHouse, l'insertion est asynchrone. De plus, on peut toujours écrire localement, sans coûts supplémentaires, ce qui permet d'insérer des données dans ClickHouse beaucoup plus rapidement que dans Vertica, même sur des disques pas forcément très rapides. La lecture est à peu près équivalente. La lecture sur SATA, si elles sont en RAID, est assez rapide.
- Pas de limitations de licence, c'est-à-dire 3 pétaoctets de données sur 60 serveurs (20 serveurs correspondent à une réplique) et 6 trillions d'enregistrements dans les faits et les agrégats. Rien de tel ne peut être envisagé sur Vertica.
Je vais maintenant passer aux aspects pratiques dans cet exemple.
- Le premier point est l'efficacité du schéma. Le schéma a un impact significatif sur beaucoup de choses.
- Le deuxième point est la génération d'un SQL efficace.
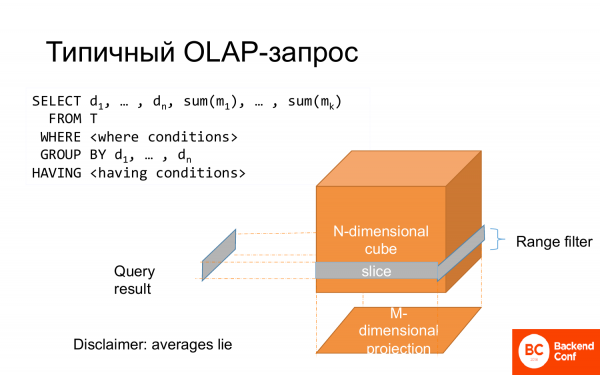
Une requête OLAP typique est un select. Certaines colonnes sont utilisées dans le group by, d'autres dans des fonctions d'agrégat. Il y a un where, que l'on peut considérer comme une tranche du cube. L'ensemble du group by peut être vu comme une projection. C'est ainsi que cela est appelé une analyse multidimensionnelle des données.
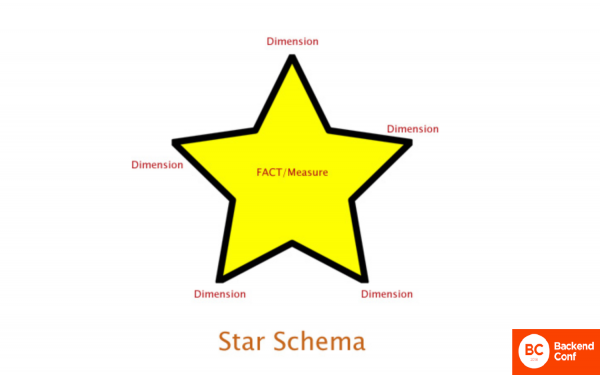
Et cela est souvent modélisé sous forme de schéma en étoile, où il y a un fait central et des caractéristiques de ce fait sur les côtés, comme des rayons.
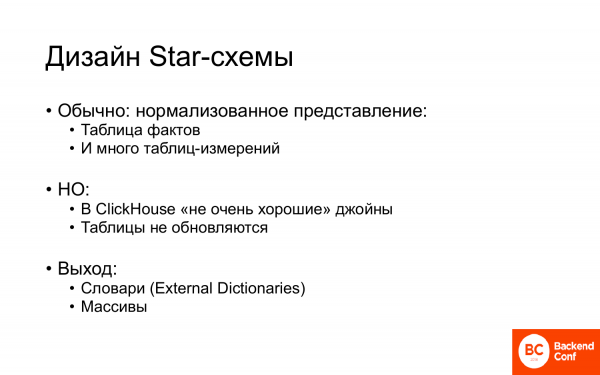
Et en termes de conception physique, c'est-à-dire de la façon dont cela est organisé dans une table, on fait généralement une représentation normalisée. Vous pouvez dénormaliser, mais cela coûte cher en disque et n'est pas très efficace pour les requêtes. C'est pourquoi on fait généralement une représentation normalisée, c'est-à-dire une table de faits et de nombreuses tables de dimensions.
Mais cela fonctionne mal dans ClickHouse. Il y a deux raisons :
- La première est que ClickHouse n'a pas de bonnes jointures (join), c'est-à-dire que les jointures (join) existent, mais elles sont mauvaises. Pour l'instant, elles sont mauvaises.
- La deuxième est que les tables ne sont pas mises à jour. En général, dans ces tables autour du schéma en étoile, il faut changer quelque chose. Par exemple, le nom du client, le nom de l'entreprise, etc. Et cela ne fonctionne pas.
Il existe une solution dans ClickHouse. En fait, deux :
- La première est l'utilisation de dictionnaires. Les Dictionnaires externes aident à résoudre à 99 % le problème du schéma en étoile, des mises à jour et d'autres choses.
- La deuxième est l'utilisation de tableaux. Les tableaux aident également à éviter les jointures (join) et les problèmes de normalisation.
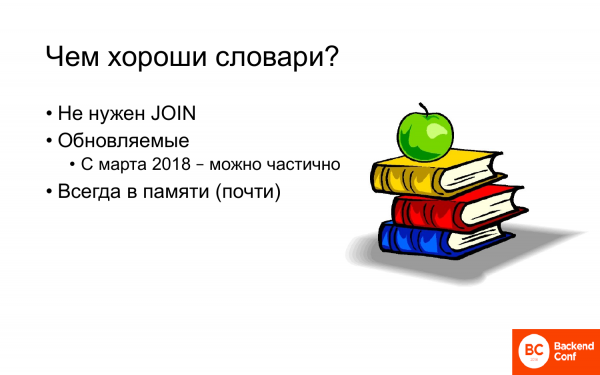
- Les jointures (join) ne sont pas nécessaires.
- Mises à jour. Depuis mars 2018, une possibilité non documentée (vous ne la trouverez pas dans la documentation) de mettre à jour partiellement les dictionnaires est disponible, c'est-à-dire les enregistrements qui ont changé. En pratique, c'est comme une table.
- Toujours en mémoire, donc les jointures (join) avec le dictionnaire fonctionnent plus rapidement que si c'était une table stockée sur disque et qui n'est pas forcément dans le cache, probablement pas.
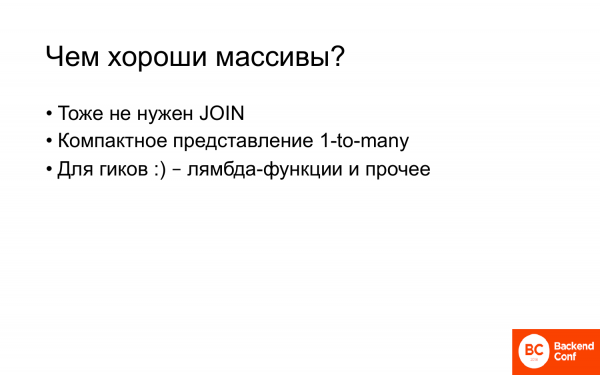
- Les jointures (join) ne sont également pas nécessaires.
- C'est une représentation compacte un à plusieurs.
- Et à mon avis, les tableaux sont faits pour les geeks. Ce sont des fonctions lambda et autres.
Ce n'est pas juste une belle phrase. C'est une fonctionnalité très puissante qui permet de faire beaucoup de choses de manière simple et élégante.
Des exemples typiques qui aident à gérer des tableaux. Ces exemples sont simples et assez explicites :
- Recherche par tags. Si vous avez des hashtags et que vous souhaitez trouver des enregistrements par hashtag.
- Recherche par paires clé-valeur. Il y a aussi des attributs avec des valeurs.
- Stockage de listes de clés que vous devez convertir en autre chose.
Toutes ces tâches peuvent être accomplies sans tableaux. Les tags peuvent être placés dans une chaîne et être extraits avec une expression régulière, ou dans une table séparée, mais dans ce cas, il faudra effectuer des jointures.
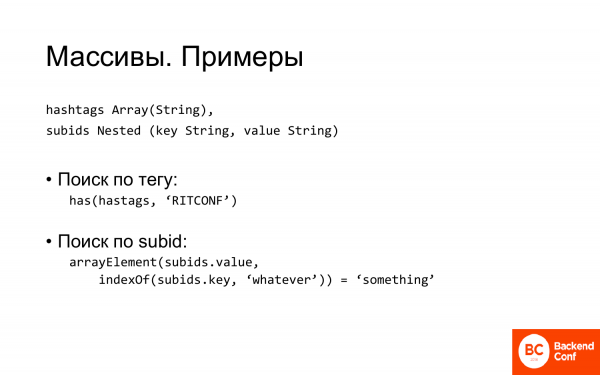
Dans ClickHouse, rien de tout cela n'est nécessaire, il suffit de décrire un tableau de chaînes pour les hashtags ou de créer une structure imbriquée pour des systèmes de type clé-valeur.
Une structure imbriquée n'est peut-être pas le meilleur nom. Ce sont deux tableaux qui ont une partie commune dans leur nom et certaines caractéristiques liées.
Et il est très facile de faire une recherche par tag. Il y a une fonction has, qui vérifie si un élément est présent dans le tableau. Voilà, nous avons trouvé tous les enregistrements qui concernent notre conférence.
La recherche par subid est un peu plus complexe. Nous devons d'abord trouver l'indice de la clé, puis prendre l'élément avec cet indice et vérifier si sa valeur correspond à ce dont nous avons besoin. Mais malgré tout, c'est très simple et compact.
L'expression régulière que vous voudriez écrire si vous stockiez tout cela dans une seule ligne serait, d'une part, maladroite. D'autre part, elle fonctionnerait beaucoup plus lentement que deux tableaux.
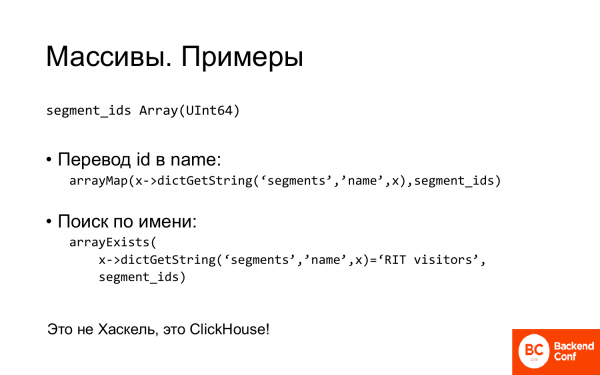
Un autre exemple. Vous avez un tableau dans lequel vous stockez des ID. Et vous pouvez les convertir en noms. La fonction arrayMap. C'est une fonction lambda typique. Vous y passez des expressions lambda. Et elle extrait la valeur du nom pour chaque ID du dictionnaire.
De même, la recherche peut être effectuée. Une fonction prédicative est passée, qui vérifie à quoi correspondent les éléments.
Ces éléments simplifient considérablement le schéma et résolvent de nombreux problèmes.
Mais le prochain problème auquel nous avons été confrontés, et que je voudrais mentionner, ce sont les requêtes efficaces.
- Dans ClickHouse, il n'y a pas de planificateur de requêtes. Absolument pas.
- Cependant, il est nécessaire de planifier les requêtes complexes. Dans quels cas ?
- Lorsqu'une requête comporte plusieurs jointures (join) que vous encapsulez dans des sous-requêtes. L'ordre dans lequel elles s'exécutent a son importance.
- Et deuxièmement – si la requête est distribuée. Parce que dans une requête distribuée, seule la sous-requête la plus interne s'exécute de manière distribuée, tandis que tout le reste est envoyé à un seul serveur, auquel vous êtes connecté et s'exécute là-bas. Donc, si vous avez des requêtes distribuées avec de nombreuses jointures (join), il est essentiel de choisir l'ordre.
Et même dans des cas plus simples, il est parfois judicieux d'effectuer un petit travail de réécriture des requêtes.
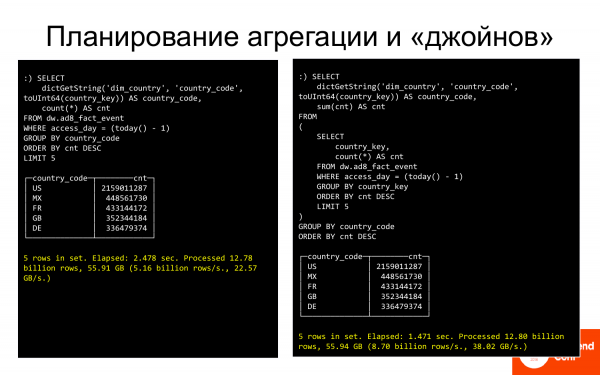
Voici un exemple. À gauche, une requête qui montre le top 5 des pays. Elle s'exécute en 2,5 secondes, je crois. À droite, la même requête, mais légèrement réécrite. Au lieu de grouper par chaîne, nous avons commencé à grouper par clé (int). Et c'est plus rapide. Ensuite, nous avons joint un dictionnaire au résultat. Au lieu de 2,5 secondes, la requête s'exécute en 1,5 seconde. C'est très bien.
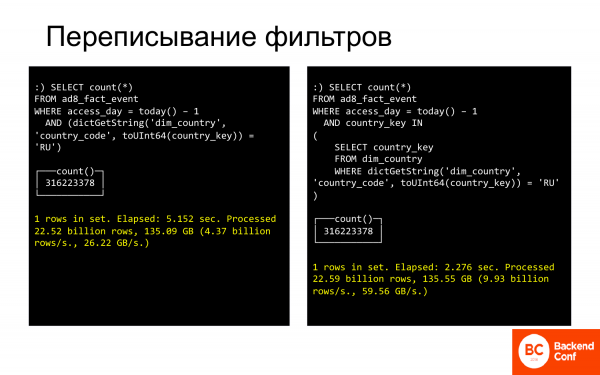
Un exemple similaire avec la réécriture des filtres. Ici, une requête sur la Russie. Elle s'exécute en 5 secondes. Si nous la réécrivons de manière à comparer à nouveau non pas des chaînes, mais des nombres avec un ensemble de clés qui concernent la Russie, ce sera beaucoup plus rapide.
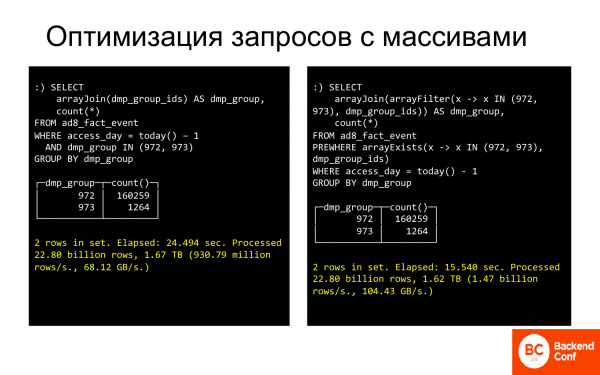
Il existe de nombreuses astuces. Elles permettent de considérablement accélérer des requêtes qui semblent déjà fonctionner rapidement, ou au contraire, qui fonctionnent lentement. Elles peuvent être rendues encore plus rapides.
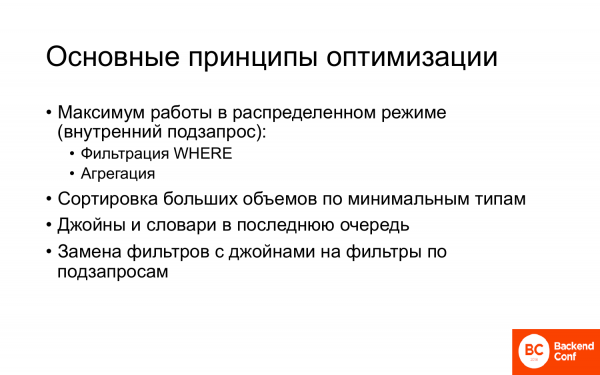
- Maximum de travail en mode distribué.
- Tri par types minimaux, comme je l'ai fait avec les ints.
- S'il y a des jointures (join) ou des dictionnaires, il est préférable de les effectuer en dernier, lorsque vous avez déjà des données au moins partiellement regroupées, alors l'opération de jointure (join) ou l'appel du dictionnaire sera moins fréquente et donc plus rapide.
- Remplacement des filtres.
Il existe d'autres techniques, et pas seulement celles que j'ai démontrées. Elles permettent parfois d'accélérer considérablement l'exécution des requêtes.
Passons à l'exemple suivant. L'entreprise X des États-Unis. Que fait-elle?
Il y avait une tâche :
- Liaison hors ligne des transactions publicitaires.
- Modélisation de différents types de liaison.
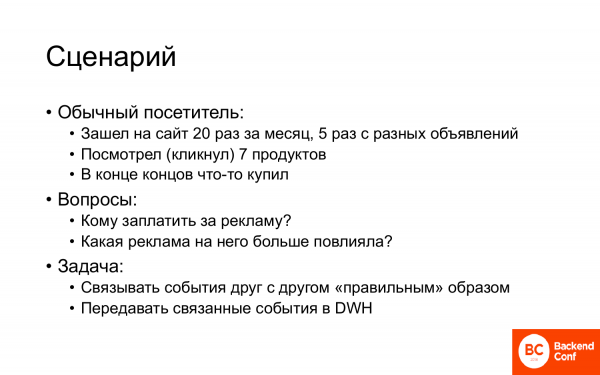
Quel est le scénario?
Un visiteur ordinaire accède à un site, par exemple, 20 fois par mois via différentes annonces ou se rend simplement sur le site sans aucune annonce, car il s'en souvient. Il regarde certains produits, les ajoute au panier, puis les retire de son panier. Et, finalement, il achète quelque chose.
Les questions raisonnables sont : « À qui doit-on payer pour la publicité, si nécessaire ? » et « Quelle publicité a pu l'influencer, si elle a eu un impact ? ». C'est-à-dire, pourquoi a-t-il acheté et comment faire pour que des personnes similaires achètent aussi ?
Pour résoudre cette tâche, il faut lier les événements qui se produisent sur le site web de manière appropriée, c'est-à-dire établir des connexions entre eux. Ensuite, il faut les transmettre pour analyse dans un DWH. Et sur la base de cette analyse, construire des modèles pour savoir à qui et quelle publicité montrer.
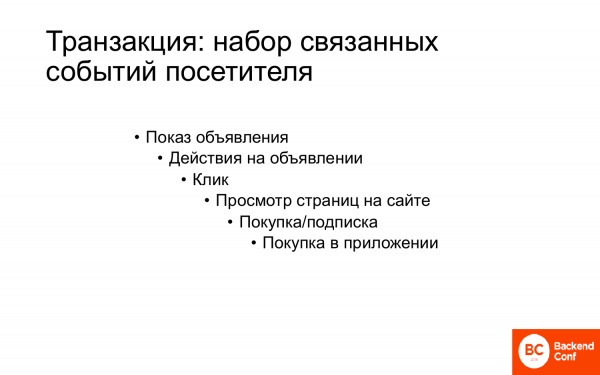
Une transaction publicitaire est un ensemble d'événements liés à un utilisateur, commençant par l'affichage d'une annonce, puis se poursuivant avec d'autres actions, suivi, éventuellement, d'un achat, et ensuite d'autres achats dans cet achat. Par exemple, dans le cas d'une application mobile ou d'un jeu mobile, l'installation de l'application est généralement gratuite, mais des paiements peuvent être nécessaires pour d'autres actions. Plus une personne dépense dans l'application, plus elle a de la valeur. Mais pour cela, il faut tout relier.
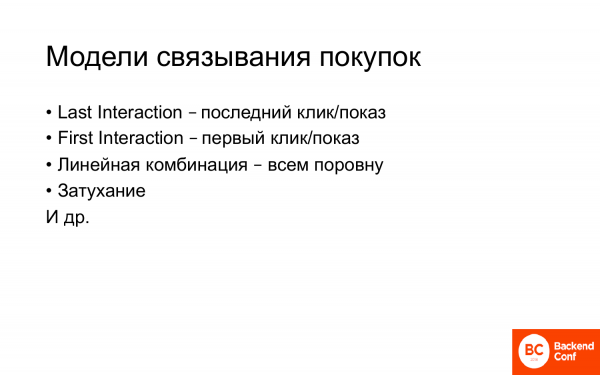
Il existe de nombreux modèles de liaison.
Les plus populaires sont :
- Dernière interaction, où l'interaction est soit un clic, soit une impression.
- Première interaction, c'est-à-dire la première action qui a amené la personne sur le site.
- Combinaison linéaire – tout le monde est traité de manière égale.
- Atténuation.
- Et autres.
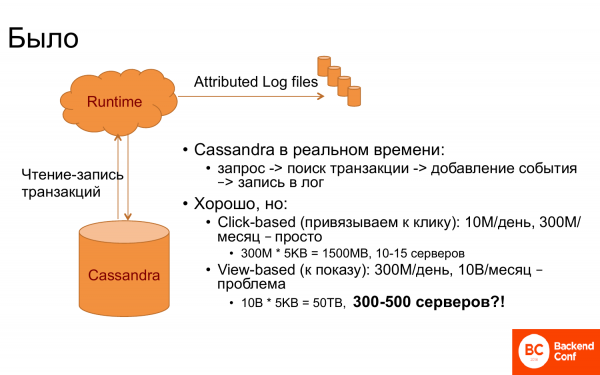
Et comment tout cela fonctionnait-il à l'origine ? Il y avait un Runtime et Cassandra. Cassandra était utilisée comme stockage de transactions, c'est-à-dire qu'elle conservait toutes les transactions liées. Et lorsque qu’un événement arrivait dans le Runtime, par exemple, l'affichage d'une certaine page ou autre, il y avait une requête dans Cassandra – existe-t-il cette personne ou non. Ensuite, les transactions qui lui étaient associées étaient récupérées. Et la liaison était effectuée.
Et s'il était chanceux et que la requête contenait un identifiant de transaction, cela devenait facile. Mais en général, ce n'est pas le cas. Il fallait donc trouver la dernière transaction ou la transaction avec le dernier clic, etc.
Et tout cela fonctionnait très bien tant que la liaison était effectuée sur le dernier clic. Car avec 10 millions de clics par jour, soit 300 millions par mois, si l'on prend une fenêtre d'un mois. Et puisque tout doit être en mémoire dans Cassandra pour que cela fonctionne rapidement, car le Runtime doit répondre rapidement, il fallait environ 10-15 serveurs.
Mais lorsque nous avons voulu lier la transaction à l'affichage, cela s'est tout de suite avéré moins amusant. Pourquoi ? Il est évident qu'il faut stocker 30 fois plus d'événements. Par conséquent, il faut 30 fois plus de serveurs. Ce qui donne un chiffre astronomique. Avoir jusqu'à 500 serveurs pour effectuer une liaison, alors qu'il y en a beaucoup moins en Runtime, c'est un chiffre absurde. Nous avons donc commencé à réfléchir à ce qu'il fallait faire.
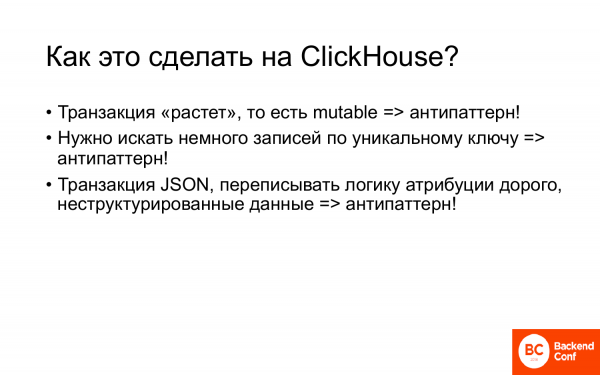
Nous avons donc découvert ClickHouse. Mais comment l'utiliser avec ClickHouse ? À première vue, cela semble être un ensemble d'antipatterns.
- La transaction grandit, nous y accrochons de plus en plus d'événements, c'est-à-dire qu'elle est mutable, alors que ClickHouse ne gère pas très bien les objets mutables.
- Lorsque nous recevons un visiteur, nous devons extraire ses transactions par clé, par son identifiant de visite. C'est aussi une requête point, ce qui n'est pas habituellement fait dans ClickHouse. En général, ClickHouse fonctionne avec de grands... scans, mais ici, nous avons besoin de récupérer plusieurs enregistrements. C'est encore un antipattern.
- De plus, la transaction était en json, mais nous ne voulions pas la réécrire, donc nous souhaitions stocker le json de manière non structurée et, si nécessaire, en extraire quelque chose. Et cela aussi constitue un antipattern.
C'est-à-dire un ensemble d'antipatterns.
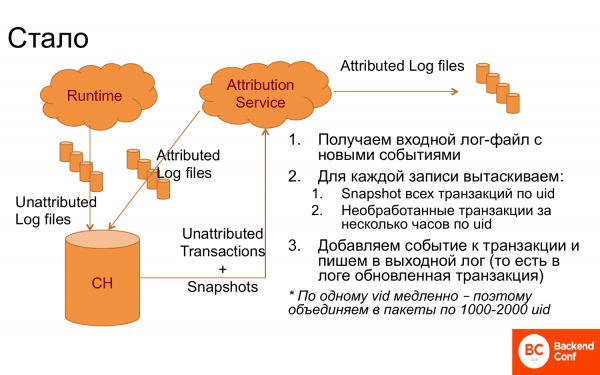
Néanmoins, nous avons réussi à créer un système qui fonctionnait très bien.
Qu'a-t-on fait ? ClickHouse a été mis en place, où les journaux, divisés en enregistrements, étaient envoyés. Un service attribué est apparu, qui récupérait les journaux à partir de ClickHouse. Après cela, pour chaque enregistrement par identifiant de visite, il obtenait des transactions qui pouvaient encore ne pas être traitées, ainsi que des instantanés, c'est-à-dire des transactions déjà liées, soit le résultat du travail précédent. À partir de là, nous avons déjà élaboré la logique, choisi la bonne transaction et connecté de nouveaux événements. Nous avons de nouveau enregistré dans le journal. Le journal était renvoyé dans ClickHouse, c'est-à-dire que c'était un système constamment cyclique. En outre, il était envoyé dans le DWH pour être analysé là-bas.
C'est dans cette forme que cela fonctionnait assez mal. Pour faciliter les choses pour ClickHouse lorsqu'une requête était faite par identifiant de visite, les requêtes étaient regroupées en blocs de 1 000 à 2 000 identifiants de visite, et toutes les transactions pour 1 000 à 2 000 personnes étaient extraites. Tout a alors fonctionné.
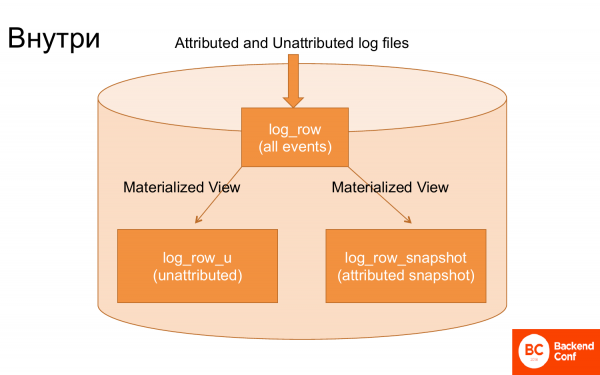
Si l'on regarde à l'intérieur de ClickHouse, il n'y a que 3 tables principales qui gèrent tout cela.
La première table dans laquelle les logs sont injectés, et ces logs sont en grande partie insérés sans traitement.
La deuxième table. Grâce à une vue matérialisée, les événements non attribués étaient extraits de ces logs, c'est-à-dire ceux qui n'étaient pas liés. Et à partir de ces logs, les transactions étaient extraites pour construire un instantané. En d'autres termes, une vue matérialisée spécifique construisait un instantané, c'est-à-dire l'état final accumulé des transactions.
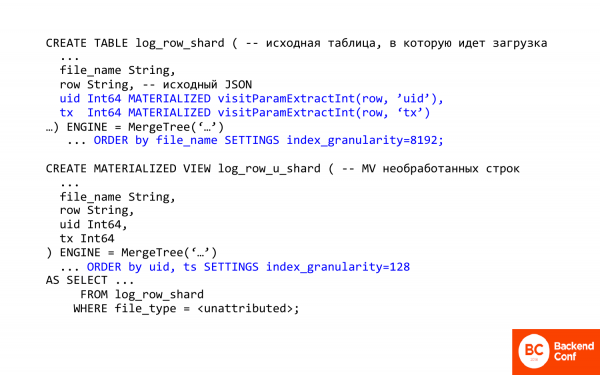
Ici, le texte SQL est écrit. Je voudrais commenter plusieurs choses importantes à ce sujet.
La première chose importante est la possibilité dans ClickHouse d'extraire des colonnes et des champs depuis un json. C'est-à-dire que ClickHouse dispose de certaines méthodes pour travailler avec json. Elles sont très, très primitives.
visitParamExtractInt permet d'extraire des attributs d'un json, c'est-à-dire que le premier match se déclenche. Ainsi, il est possible d'extraire l'identifiant de transaction ou l'identifiant de visite. C'est un point.
Deuxièmement, ici un champ matérialisé rusé a été utilisé. Qu'est-ce que cela signifie ? Cela signifie que vous ne pouvez pas l'insérer dans la table, c'est-à-dire qu'il n'est pas inséré, il est calculé et stocké lors de l'insertion. Lors de l'insertion, ClickHouse fait le travail pour vous. Et ce qui est extrait du json est ce dont vous aurez besoin ensuite.
Dans ce cas, la vue matérialisée concerne les lignes non traitées. Elle utilise justement la première table avec pratiquement des logs bruts. Et que fait-elle ? Tout d'abord, elle change le tri, c'est-à-dire que le tri est désormais effectué par identifiant de visite, car nous avons besoin d'extraire rapidement la transaction associée à une personne précise.
La deuxième chose importante est l'index_granularity. Si vous avez vu MergeTree, l'index_granularity est généralement par défaut de 8192. Qu'est-ce que cela signifie ? C'est un paramètre de densité de l'index. Dans ClickHouse, l'index est clairsemé, il n'indexe jamais chaque enregistrement. Cela se fait toutes les 8192 lignes. C'est bien lorsque de nombreuses données doivent être calculées, mais moins bon lorsqu'il s'agit d'une petite quantité en raison d'un overhead important. Si l'on réduit la granularité de l'index, on diminue donc l'overhead. Réduire à un est impossible car la mémoire pourrait manquer. L'index est toujours stocké en mémoire.
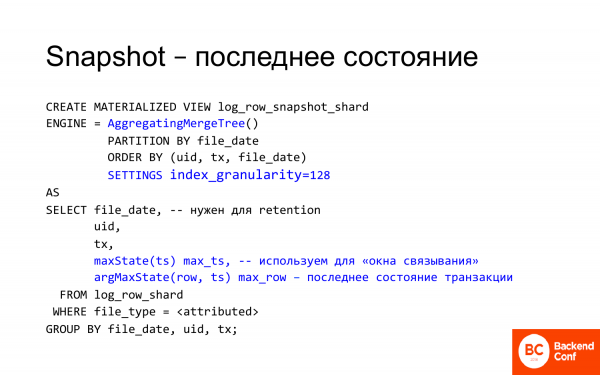
Un snapshot utilise encore certaines fonctionnalités intéressantes de ClickHouse.
Tout d'abord, il y a AggregatingMergeTree. Et dans AggregatingMergeTree, l'argMax est stocké, c'est-à-dire l'état de la transaction correspondant au dernier timestamp. De nouvelles transactions sont toujours générées pour ce visiteur. Et dans le dernier état de cette transaction, nous avons ajouté un événement et nous avons obtenu un nouvel état. Cela a de nouveau été intégré dans ClickHouse. Et grâce à argMax dans cette vue matérialisée, nous pouvons toujours obtenir l'état actuel.
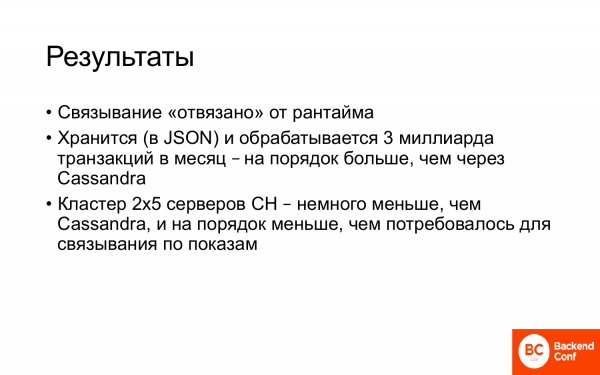
- La liaison est « déliée » du Runtime.
- Jusqu'à 3 milliards de transactions sont stockées et traitées par mois. C'est plusieurs fois plus que ce qu'il y avait dans Cassandra, c'est-à-dire dans un système transactionnel typique.
- Un cluster de 2x5 serveurs ClickHouse. 5 serveurs et chaque serveur a une réplique. C'est même moins que ce qu'il y avait dans Cassandra pour réaliser une attribution basée sur les clics, alors qu'ici nous avons une attribution basée sur les impressions. Cela signifie qu'au lieu de multiplier le nombre de serveurs par 30, nous avons réussi à le réduire.
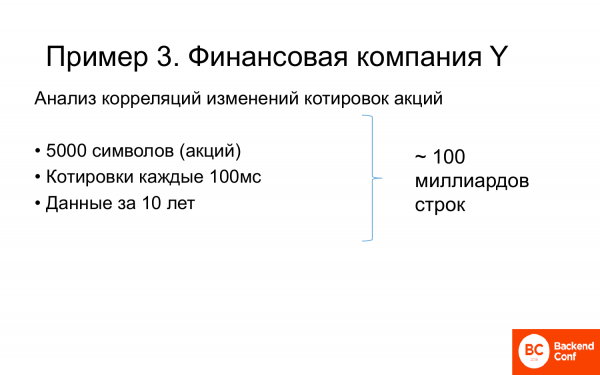
Et le dernier exemple est une société financière Y qui analysait les corrélations des variations des cotations boursières.
Et la tâche était la suivante :
- Il y a environ 5 000 actions.
- Les cotations sont connues toutes les 100 millisecondes.
- Les données ont été accumulées pendant 10 ans. Evidemment, pour certaines entreprises, il y en a plus, pour d'autres moins.
- Au total, environ 100 milliards de lignes.
Il fallait calculer la corrélation des variations.
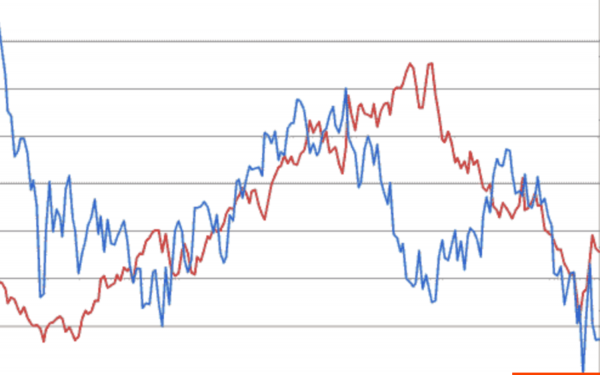
Ici, il y a deux actions et leurs cotations. Si l'une monte et que l'autre monte aussi, c'est une corrélation positive, c'est-à-dire que l'une augmente et l'autre aussi. Si l'une monte, comme à la fin du graphique, tandis que l'autre descend, c'est une corrélation négative, c'est-à-dire que lorsque l'une augmente, l'autre baisse.
En analysant ces variations mutuelles, on peut faire des prévisions sur le marché financier.
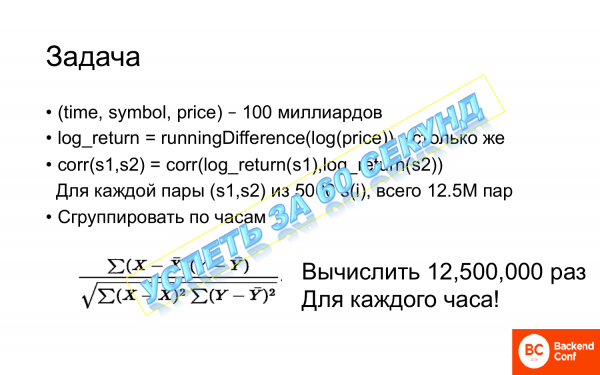
Mais la tâche est complexe. Que faire pour cela ? Nous avons 100 milliards d'enregistrements qui contiennent : le temps, l'action et le prix. Nous devons d'abord calculer les 100 milliards de fois la runningDifference de l'algorithme de prix. La runningDifference est une fonction dans ClickHouse qui calcule la différence entre deux lignes de manière séquentielle.
Après cela, il faut calculer la corrélation, et cette corrélation doit être calculée pour chaque paire. Pour 5 000 actions, cela fait 12,5 millions de paires. C'est beaucoup, c'est-à-dire qu'il faut calculer cette fonction de corrélation 12,5 fois.
Et si quelqu'un avait oublié, x et y sont les attentes mathématiques d'un échantillon. Cela signifie qu'il faut non seulement calculer les racines et les sommes, mais également effectuer des sommes à l'intérieur de ces sommes. Une quantité énorme de calculs doit être effectuée 12,5 millions de fois, et en plus, il faut les regrouper par heures. Et nous avons également beaucoup d'heures. Et il faut le faire en 60 secondes. C'est une blague.
Il fallait y parvenir d'une manière ou d'une autre, car tout cela fonctionnait très, très lentement avant l'arrivée de ClickHouse.
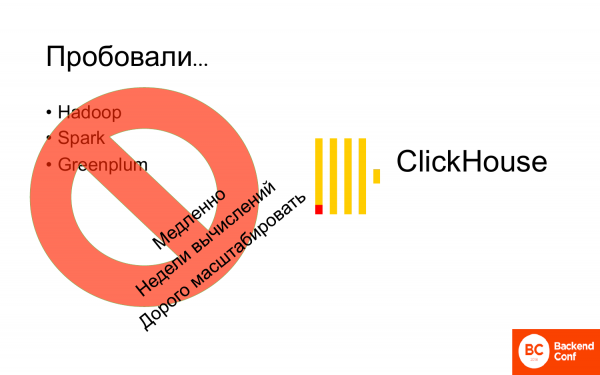
Ils ont essayé de le calculer sur Hadoop, sur Spark, sur Greenplum. Et tout cela était très lent ou coûteux. C'est-à-dire qu'il était possible de faire des calculs d'une certaine manière, mais cela revenait cher.
Puis ClickHouse est arrivé et tout est devenu beaucoup mieux.
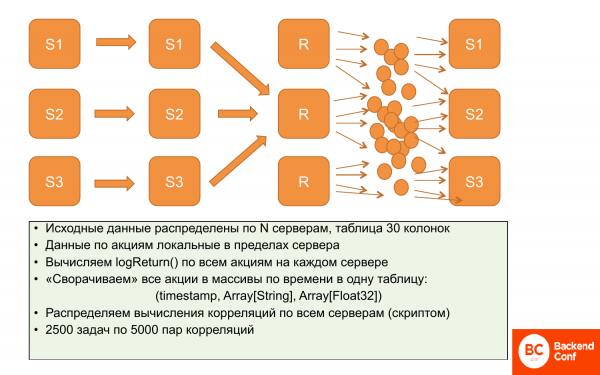
Je rappelle que nous avons un problème de localité des données, donc les corrélations ne peuvent pas être localisées. Nous ne pouvons pas agréger certaines données sur un serveur, d'autres sur un autre et faire le calcul ; nous devons avoir toutes les données partout.
Que ont-ils fait ? Initialement, les données sont localisées. Sur chacun des serveurs, les données relatives à la tarification d'un ensemble spécifique d'actions sont stockées. Et elles ne se chevauchent pas. Par conséquent, il est possible de calculer logReturn en parallèle et de manière indépendante, tout se passe donc simultanément et de manière distribuée.
Ensuite, ils ont décidé de réduire ces données tout en conservant leur expressivité. Réduire à l'aide de tableaux, c'est-à-dire pour chaque segment de temps créer un tableau d'actions et un tableau de prix. Ainsi, cela prend beaucoup moins d'espace pour les données. Et il est un peu plus facile de travailler avec eux. Ce sont presque des opérations parallèles, c'est-à-dire que nous calculons partiellement en parallèle, puis nous écrivons sur le serveur.
Après cela, ces données peuvent être répliquées. La lettre « r » signifie que ces données ont été répliquées. C'est-à-dire que nous avons les mêmes données sur les trois serveurs – ces tableaux.
Et ensuite, à l'aide d'un script spécial, à partir de cet ensemble de 12,5 millions de corrélations à calculer, il est possible de créer des paquets. C'est-à-dire 2 500 tâches de 5 000 paires de corrélations. Et cette tâche est calculée sur un serveur ClickHouse spécifique. Toutes les données sont présentes, car les données sont identiques et il peut les calculer successivement.
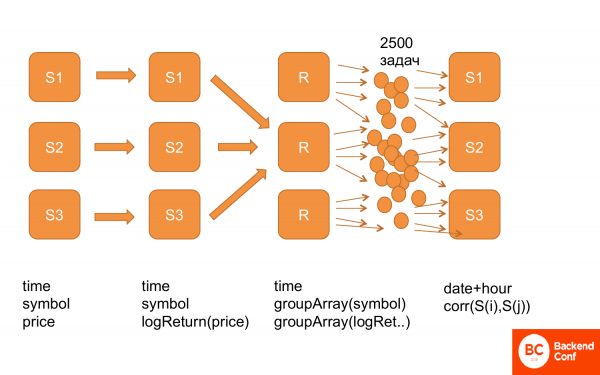
Encore une fois, voici à quoi cela ressemble. D'abord, nous avons toutes les données sous cette structure : temps, actions, prix. Ensuite, nous avons calculé le logReturn, c'est-à-dire les mêmes données, mais au lieu du prix, nous avons déjà le logReturn. Puis nous les avons retravaillées, c'est-à-dire que nous avons obtenu le temps et le groupArray par actions et par prix. Nous les avons répliquées. Et après cela, nous avons généré une multitude de tâches et les avons alimentées à ClickHouse pour qu'il les traite. Et cela fonctionne.
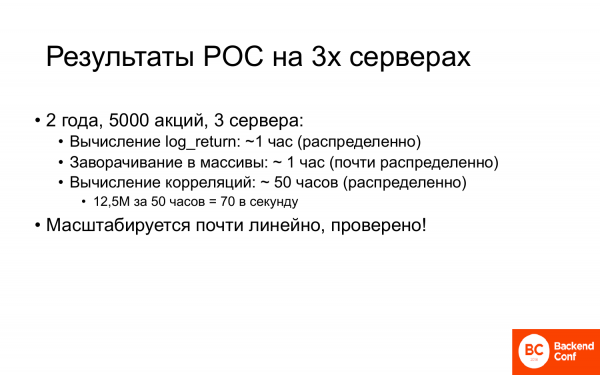
Pour le proof of concept, la tâche était une sous-tâche, c'est-à-dire qu'elle prenait moins de données. Et cela se déroulait sur seulement trois serveurs.
Les deux premières étapes : le calcul du Log_return et l'emballage dans des tableaux ont pris environ une heure chacune.
Le calcul de la corrélation a pris environ 50 heures. Mais 50 heures, c'est peu, car auparavant, cela prenait des semaines. C'était un grand succès. Et si l'on compte, cela se faisait 70 fois par seconde sur ce cluster.
Mais le plus important est que ce système est pratiquement sans goulets d'étranglement, c'est-à-dire qu'il se scalabilité presque de manière linéaire. Et ils l'ont vérifié. Ils l'ont réussi à faire évoluer.
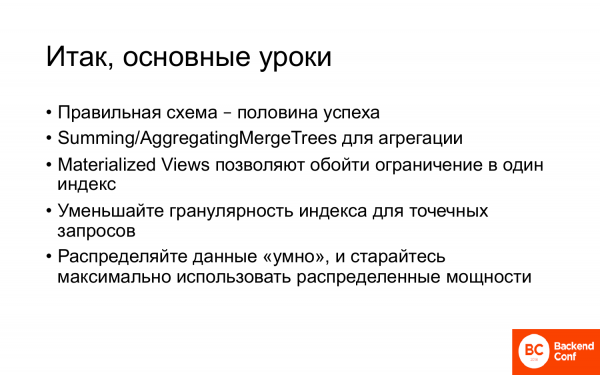
- Un schéma correct est la moitié du succès. Et un schéma correct repose sur l'utilisation de toutes les technologies nécessaires de ClickHouse.
- Les Summing/AggregatingMergeTrees sont des technologies qui permettent d'agréger ou de calculer des snapshots d'état comme un cas particulier. Cela simplifie considérablement beaucoup de choses.
- Les Materialized Views permettent de contourner la limitation d'un seul index. Peut-être que je ne l'ai pas très bien expliqué, mais quand nous avons chargé les logs, les logs bruts étaient dans une table avec un seul index, alors que les logs d'attributs étaient dans une autre table, c'est-à-dire les mêmes données, mais filtrées, mais l'index était complètement différent. Bien qu'il s'agisse des mêmes données, la tri était différente. Et les Materialized Views permettent, si vous en avez besoin, de contourner cette limitation de ClickHouse.
- Réduisez la granularité de l'index pour des requêtes ponctuelles.
- Et répartissez les données de manière intelligente, essayez de maximiser la localisation des données à l'intérieur du serveur. Et essayez de faire en sorte que les requêtes utilisent également la localisation là où cela est possible.
En résumé, on peut dire que ClickHouse a maintenant fermement établi son territoire tant dans les bases de données commerciales que dans les bases de données open source, c'est-à-dire pour l'analytique. Il s'intègre parfaitement dans ce paysage. De plus, il commence lentement à faire de l'ombre à d'autres, car quand on a ClickHouse, on n'a pas besoin d'InfiniDB. Vertica, peut-être, ne sera plus nécessaire bientôt s'ils offrent un bon support SQL. Profitez-en !
—Merci pour la présentation ! C'était très intéressant ! Y a-t-il eu des comparaisons avec Apache Phoenix ?
-Non, je n'ai pas entendu parler de comparaisons. Nous et Yandex essayons de suivre toutes les comparaisons de ClickHouse avec différentes bases de données. Parce que si jamais quelque chose se révèle plus rapide que ClickHouse, Alexeï Milovidov ne peut pas dormir la nuit et commence à optimiser rapidement. Je n'ai pas entendu parler d'une telle comparaison.
(Alexeï Milovidov) Apache Phoenix est un moteur SQL sur Hbase. Hbase est principalement conçu pour des scénarios de travail de type clé-valeur. Chaque ligne peut avoir un nombre arbitraire de colonnes avec des noms arbitraires. Cela peut être dit pour des systèmes tels que Hbase, Cassandra. Et pour eux, les requêtes analytiques lourdes ne fonctionneront pas correctement. Ou vous pouvez penser qu'elles fonctionnent correctement si vous n'avez pas d'expérience avec ClickHouse.
Merci
Bonjour ! Je m'intéresse beaucoup à ce sujet, car j'ai un sous-système analytique. Mais quand je regarde ClickHouse, j'ai l'impression qu'il est très adapté pour l'analyse d'événements, mutables. Et si j'ai besoin d'analyser beaucoup de données commerciales avec d'énormes tableaux, ClickHouse, autant que je le comprends, ne me conviendrait pas vraiment ? Surtout s'ils changent. Est-ce correct ou y a-t-il des exemples qui pourraient contredire cela ?
C'est exact. Et cela est vrai pour la plupart des bases de données analytiques spécialisées. Elles sont conçues pour gérer une ou plusieurs grandes tables qui sont mutables, et de nombreuses petites, qui changent lentement. C'est-à-dire que ClickHouse n'est pas comme Oracle, où l'on peut tout mettre et construire des requêtes très complexes. Pour utiliser ClickHouse de manière efficace, il faut structurer le schéma d'une manière qui fonctionne bien avec ClickHouse. Autrement dit, éviter une normalisation excessive, utiliser des dictionnaires et essayer de réduire les longues relations. Si le schéma est structuré de cette manière, alors des tâches commerciales similaires sur ClickHouse peuvent être résolues beaucoup plus efficacement que dans une base de données relationnelle traditionnelle.
Merci pour votre présentation ! J'ai une question sur le dernier cas financier. Ils avaient une analyse. Il fallait comparer comment ça monte et descend. Et je comprends que vous avez construit le système spécifiquement pour cette analyse ? Si demain, par exemple, ils ont besoin d'un autre rapport sur ces données, il faut reconstruire le schéma et recharger les données ? C'est-à-dire faire un prétraitement pour obtenir la requête ?
Bien sûr, il s'agit d'une utilisation de ClickHouse pour une tâche très précise. Cela aurait pu être résolu de manière plus traditionnelle dans le cadre de Hadoop. Pour Hadoop, c'est une tâche idéale. Mais avec Hadoop, c'est très lent. Mon objectif est de démontrer que sur ClickHouse, on peut résoudre des problèmes qui sont habituellement traités par d'autres moyens, mais de manière beaucoup plus efficace. C'est taillé pour une tâche spécifique. Bien sûr, s'il y a une tâche similaire, on peut la résoudre de manière similaire.
D'accord. Vous avez dit que 50 heures étaient nécessaires pour le traitement. Cela commence dès le début, lorsque les données sont chargées ou lorsque les résultats sont obtenus ?
Oui-oui.
Très bien, merci beaucoup.
C'est sur un cluster de 3 serveurs.
Bonjour ! Merci pour votre présentation ! C'était très intéressant. Je ne vais pas vraiment parler de la fonctionnalité, mais de l'utilisation de ClickHouse en termes de stabilité. Avez-vous rencontré des problèmes de récupération ? Comment ClickHouse réagit-il dans de tels cas ? Avez-vous déjà eu une instance qui plantait, y compris les répliques ? Nous, par exemple, avons rencontré un problème avec ClickHouse lorsqu'il dépasse ses limites et plante.
Bien sûr, il n'existe pas de systèmes parfaits. Et ClickHouse a aussi ses problèmes. Mais avez-vous entendu parler du fait que Yandex.Metrica ne fonctionne pas pendant longtemps ? Probablement pas. Elle fonctionne de manière fiable depuis environ 2012-2013 sur ClickHouse. Je peux également parler de ma propre expérience. Nous n'avons jamais eu de pannes totales. Certaines choses partielles pouvaient se produire, mais elles n'ont jamais été suffisamment critiques pour avoir un impact sérieux sur les affaires. Jamais cela ne s'est produit. ClickHouse est assez fiable et ne tombe pas de manière aléatoire. On peut s'en préoccuper. Ce n'est pas une chose brute. Cela a été prouvé par de nombreuses entreprises.
Bonjour ! Vous avez dit qu'il fallait bien réfléchir dès le début au schéma de données. Et si cela arrive ? Mes données s'écoulent sans cesse. Six mois passent, et je réalise que je ne peux pas continuer comme ça, il me faut recharger les données et faire quelque chose avec elles.
Cela dépend bien sûr de votre système. Il existe plusieurs façons de le faire presque sans interruption. Par exemple, vous pouvez créer une vue matérialisée, dans laquelle vous définissez une autre structure de données, si elle peut être mappée de manière univoque. C'est-à-dire que si elle permet de faire du mapping avec les fonctionnalités de ClickHouse, c'est-à-dire d'extraire certaines choses, de changer la clé primaire, de modifier le partitionnement, alors vous pouvez créer une vue matérialisée. Vous y réécrivez vos anciennes données, les nouvelles seront écrites automatiquement. Ensuite, il vous suffira de basculer vers l'utilisation de la vue matérialisée, puis de passer l'écriture à celle-ci et de supprimer l'ancienne table. C'est une méthode sans interruption.
Merci.
Source : habr.com
